Perché il web scraping ha bisogno di IP proxy: tipi e configurazione di IPFoxy
Gli IP proxy distribuiscono le richieste su molte uscite e ti permettono di caricare le pagine come un visitatore locale. Non eliminano i limiti di frequenza delle richieste. Questa guida confronta quattro tipi di proxy e mostra una configurazione Python testata con IPFoxy.
Il web scraping è un modo comune per raccogliere dati web pubblici per il monitoraggio dei prezzi, la SEO, le ricerche di mercato e l'analisi dei social media.
Un job può passare da poche pagine a migliaia di richieste. A quel punto nascono nuovi problemi: IP bloccati, errori HTTP 429, limiti di frequenza delle richieste e pagine che cambiano in base alla regione. Il codice dello scraper può essere corretto e il job può comunque fallire o restituire dati incompleti.
Gli IP proxy aiutano a risolvere questi problemi. Questa guida spiega perché gli scraper usano i proxy, in cosa differiscono i tipi di proxy e come configurare i proxy di IPFoxy per un job di raccolta dei dati.
1. Perché il web scraping ha bisogno di IP proxy?
Un server proxy inoltra la tua richiesta. Il sito di destinazione vede l'indirizzo IP dell'uscita del proxy, non l'IP pubblico della tua macchina.
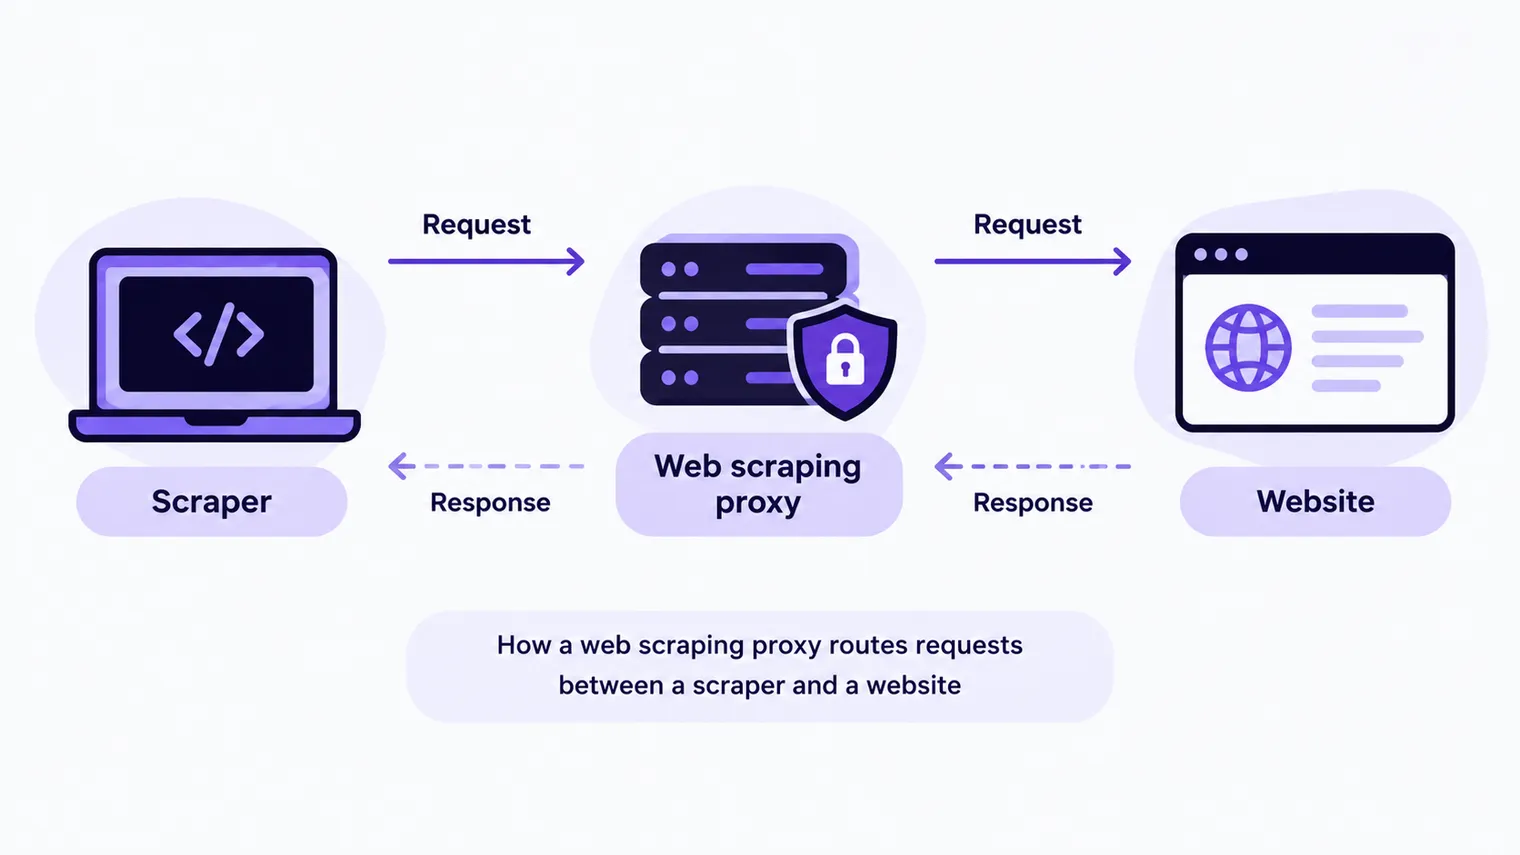
Chi naviga sul web usa una sola uscita di rete. Un job di raccolta dei dati che gira tutto il giorno con un solo IP può incontrare questi problemi:
Meno carico su un singolo IP
Uno scraper può inviare molte richieste allo stesso sito in poco tempo. Il server può quindi limitarlo in base all'indirizzo IP, alla frequenza delle richieste o al loro comportamento. Segnali tipici:
- HTTP 429 Too Many Requests: il server ritiene che tu abbia inviato troppe richieste. Lo standard consente al server di aggiungere un header
Retry-Afterche indica quando riprovare. - HTTP 403 Forbidden: il server ha compreso la richiesta ma si rifiuta di eseguirla.
- Timeout o connessioni rifiutate.
- Una pagina CAPTCHA o un avviso di accesso al posto del contenuto.
Un pool di proxy distribuisce un job conforme alle regole su molte uscite, così le richieste non arrivano tutte da un solo IP.
Un proxy non elimina i limiti di accesso. Devi comunque impostare una frequenza di richieste ragionevole e rispettare le regole del sito, ad esempio il robots.txt (RFC 9309). Quando ricevi un 429, rispetta innanzitutto il tempo di attesa indicato da Retry-After. Non cambiare IP per riprovare subito.
Dati da regioni diverse
Molti siti mostrano contenuti diversi in base alla posizione del visitatore: prezzi, risultati di ricerca, annunci e servizi locali. Se tutte le richieste arrivano da un solo paese, i tuoi dati non mostrano gli altri mercati.
Con il targeting per paese, stato e città, carichi ogni pagina pubblica da un'uscita in quella regione. Così puoi confrontare i mercati.
Job di lunga durata
Nei job lunghi, errori di rete, proxy non funzionanti e server lenti possono bloccare uno scraper. Una pipeline stabile usa la gestione dei proxy, nuovi tentativi, controlli sui timeout e log degli errori, così un singolo nodo difettoso non ferma l'intero job.
2. Quale tipo di proxy dovresti usare?
Non tutti i tipi di proxy vanno bene per ogni job. Questi sono i quattro tipi più comuni:
| Tipo di proxy | Caratteristiche principali | Adatto a |
|---|---|---|
| Residenziale con rotazione | Uscite su reti domestiche, rotazione degli IP | Grandi job di scraping pubblico, dati regionali |
| ISP statico | IP fisso, connessione stabile | Sessioni lunghe, job che richiedono un'uscita fissa |
| Proxy per data center | Veloce, costo inferiore | Pagine pubbliche, dati poco sensibili |
| Mobile | Uscite su reti di operatori mobili | Test di contenuti mobile, dati di rete mobile per regione |
Per la maggior parte dei job che coprono molte regioni e girano a lungo, parti dai proxy residenziali con rotazione. Un job ha bisogno della stessa sessione per molto tempo? Allora usa un proxy ISP statico oppure le sessioni sticky su un proxy residenziale con rotazione.
C'è un altro caso che richiede una scelta a parte: il sito di destinazione accetta solo IP di operatori mobili (4G/5G) e blocca gli IP di data center e quelli condivisi. Gli operatori mobili di solito mettono molti telefoni dietro un unico IP pubblico tramite carrier-grade NAT (RFC 6888). Un'uscita di questo tipo la ottieni solo con un proxy mobile, ad esempio i proxy mobili di Coronium. Secondo il sito di Coronium (verificato il 3 novembre 2026), ogni linea è un singolo dispositivo 4G/5G con la propria SIM, usato da un solo cliente. Supporta HTTP e SOCKS5 e puoi cambiare l'IP su richiesta o a intervalli programmati.
3. Cosa offre IPFoxy per i grandi job di scraping
In un progetto reale, un proxy deve fare più che cambiare il tuo IP di uscita. Deve darti risorse di rete stabili, flessibili e gestibili per job di dimensioni e tipi diversi, in regioni diverse.
Secondo il sito di IPFoxy (verificato il 26 ottobre 2026), IPFoxy copre oltre 200 paesi e regioni con un pool di circa 90 milioni di IP. Offre proxy residenziali con rotazione, ISP statici dedicati, proxy per data center IPv4 e IPv6 e proxy mobili 4G/5G.
IP residenziali in molte regioni
Monitoraggio dei prezzi, tracciamento del posizionamento, verifica degli annunci e ricerche di mercato coprono spesso più di un paese. IPFoxy supporta il targeting per paese, stato e città. Scegli un'uscita in ogni mercato di destinazione e raccogli la pagina pubblica che vedono i visitatori locali.
Ad esempio, un sistema globale di monitoraggio dei prezzi può usare proxy residenziali di Stati Uniti, Regno Unito e Giappone, e raccogliere così i prezzi, le promozioni e i risultati di ricerca di ciascun mercato.
Modalità di rotazione degli IP per job diversi
I proxy residenziali con rotazione di IPFoxy offrono diversi modi per cambiare IP. Non devi gestire un tuo pool di proxy:
- Rotazione a ogni richiesta: ogni richiesta riceve un nuovo IP residenziale. Usala per la raccolta in blocco di dati pubblici accessibili senza login, come pagine prodotto e risultati di ricerca.
- Sessione sticky: puoi impostare 30, 60, 90 o 120 minuti. L'IP di uscita resta lo stesso finché la sessione è valida e il nodo è attivo. Usala per job che richiedono cookie, più passaggi o un accesso continuo.
- Cambio manuale: un endpoint di refresh nella dashboard cambia l'uscita corrente quando un nodo ha problemi.
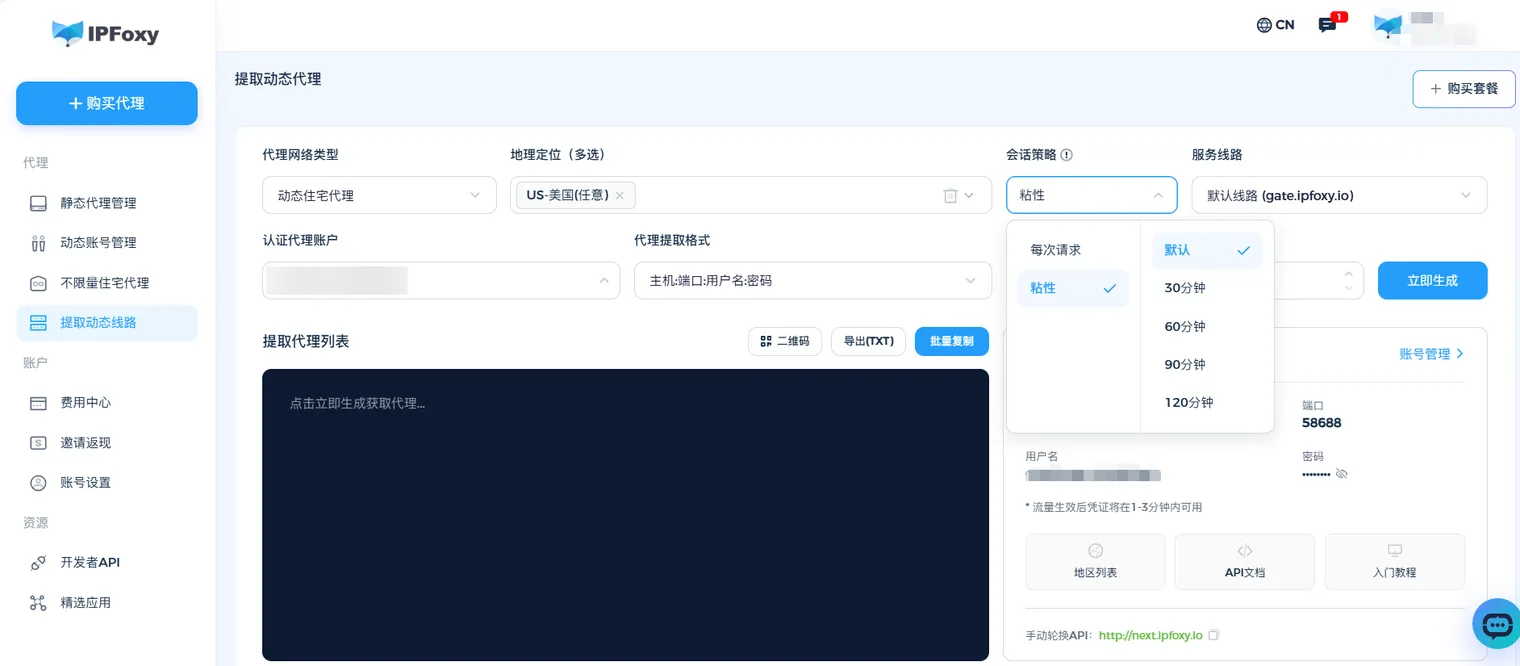
Con queste modalità scegli una strategia IP per ogni target, senza modificare il codice dello scraper né gestire a mano elenchi di IP.
Piani proxy per job di dimensioni diverse
| Caso d'uso | Tipo di proxy di IPFoxy | Vantaggio principale |
|---|---|---|
| Scraping pubblico su larga scala | Residenziale con rotazione | Ampio pool di IP, rotazione automatica |
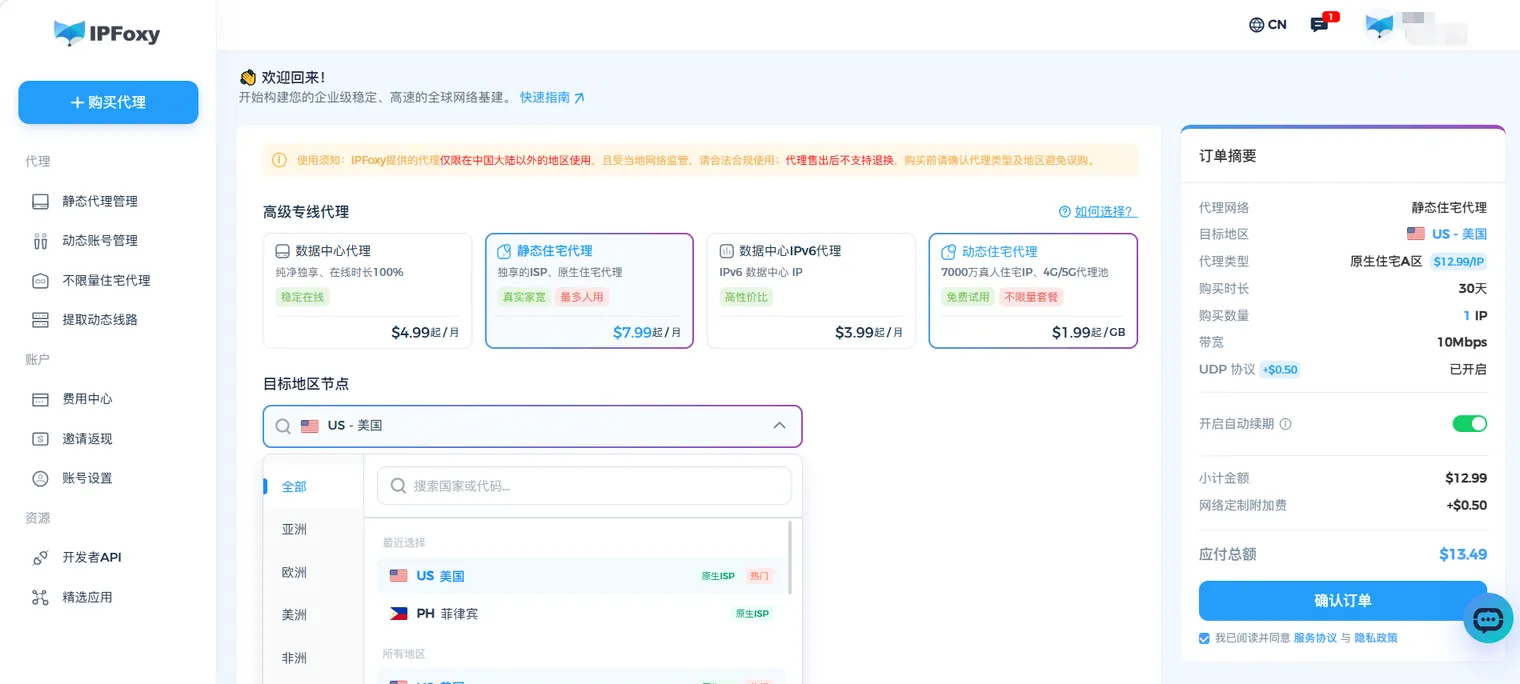
| Job continui ad alto traffico | Proxy residenziale illimitato | Prezzo in base alla banda, costi più facili da controllare |
| Sessioni lunghe | ISP statico dedicato | IP privato fisso, stabile nel tempo |
| Normali pagine pubbliche e API | Proxy per data center IPv4/IPv6 | Costo inferiore, adatto alle richieste in blocco |
| Contenuti mobile e test di rete | Mobile 4G/5G | Uscite su operatori mobili |
I proxy residenziali illimitati ti permettono di impostare la banda e una allowlist di domini in base al tuo caso d'uso. Configura i domini di destinazione, la banda e le regole del piano prima di iniziare.
Molte richieste simultanee e automazione
IPFoxy supporta HTTP(S) e SOCKS5, quindi funziona con Python Requests, Selenium, Playwright, Scrapy e altri strumenti di scraping diffusi. Puoi anche estrarre i proxy in blocco o tramite API ed esportare molte stringhe di connessione in una volta.
I team possono assegnare risorse proxy a sotto-account, controllare i permessi e verificare il traffico, il numero di richieste e le percentuali di connessioni riuscite. Dedichi più tempo al parsing, alla logica dello scraper e alla qualità dei dati, e meno alla gestione di una rete di proxy.
Controllo del traffico e dei costi
Su larga scala il costo dei proxy conta. I job di monitoraggio dei prezzi, di tracciamento dei risultati di ricerca e di market intelligence consumano più traffico man mano che crescono.
IPFoxy offre proxy residenziali con rotazione fatturati in base al traffico e piani residenziali illimitati per i job ad alto traffico. Dispone di gateway in Asia-Pacifico, nelle Americhe e altrove (ad esempio gate-sg.ipfoxy.io e gate-us.ipfoxy.io). Scegli il gateway più vicino a dove gira il tuo codice, poi ottimizza la configurazione con le statistiche di utilizzo e i tuoi test.
4. Come usare i proxy di IPFoxy per il web scraping
Questo esempio usa Requests di Python. Aggiungi il proxy di IPFoxy alle impostazioni della richiesta e la richiesta passa dal server proxy.
Passaggio 1: ottieni i dati del tuo proxy IPFoxy
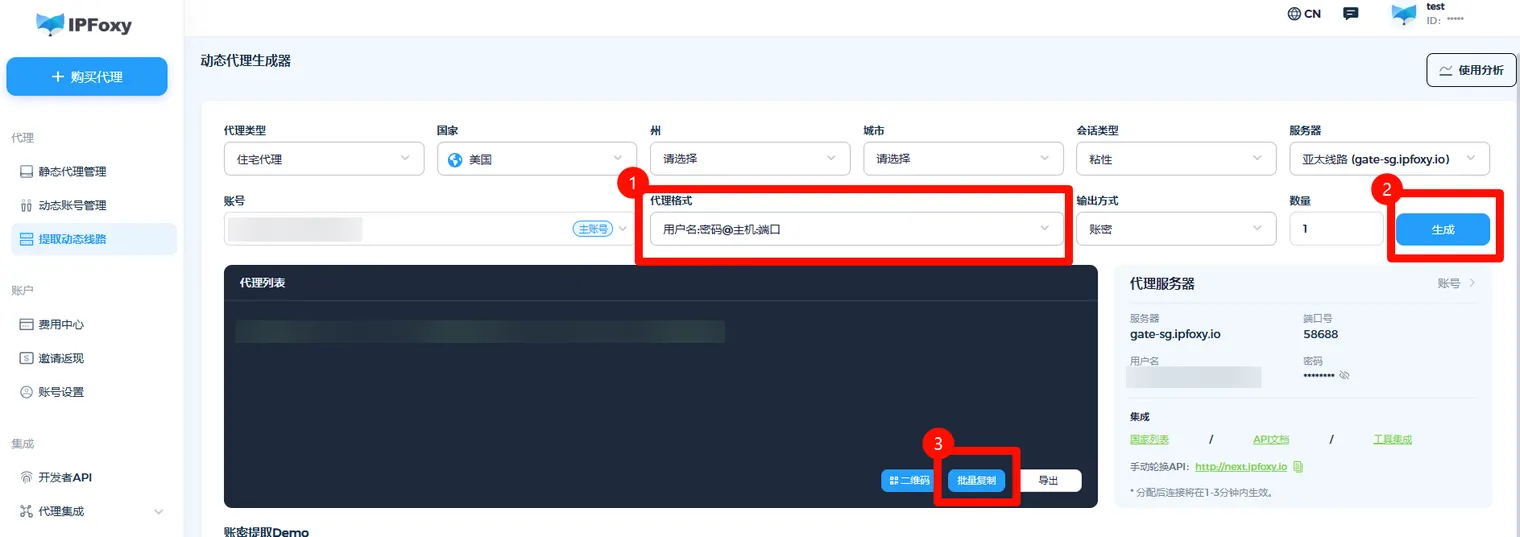
Vai sul sito di IPFoxy, crea un account e scegli un tipo di proxy. Dopo aver acquistato un piano o avviato una prova, apri la pagina di estrazione dei proxy nella dashboard. Seleziona paese, tipo di sessione e server, imposta il formato su «username:password@host:port», fai clic su Generate e poi su Copy All.
Passaggio 2: installa Requests
pip install requestsPassaggio 3: imposta il proxy e invia una richiesta
Incolla in PROXY la stringa di connessione che hai copiato. Il formato è username:password@gateway:port. Per il gateway USA ha questo aspetto: username:password.
import requests
# Replace with the connection string from your IPFoxy dashboard: username:password@gateway:port
PROXY = "http://username:passwordIl paese e la città nell'output devono essere quelli della regione proxy che hai selezionato, non quelli della tua posizione. Questo dimostra che l'IP di uscita è ora quello del proxy. Se la richiesta fallisce con 407 Proxy Authentication Required, il nome utente o la password sono errati. Copiali di nuovo dalla dashboard.

Come abbiamo testato: il 26 ottobre 2026 abbiamo eseguito questo codice su un proxy mock locale (Requests 2.34, Python 3.15). Con nome utente e password corretti ha stampato l'IP e la regione di uscita. Con una password errata, Requests ha sollevato
ProxyErrorcon causa407 Proxy Authentication Required. Copia il gateway esattamente come lo mostra la dashboard, ad esempiogate-us.ipfoxy.io(con un punto, non un trattino). Un host errato fallisce alla risoluzione DNS. L'endpoint gratuitoip-api.comsupporta solohttp://; la sua documentazione indica che per HTTPS serve il piano a pagamento.
Passaggio 4: aggiungi il proxy al tuo scraper
Dopo il test di connessione, usa le stesse impostazioni proxy per le richieste alle pagine pubbliche del sito di destinazione. Aggiungi ritardi ragionevoli, nuovi tentativi e log per rendere il job stabile. Per i job grandi, imposta la modalità di rotazione del proxy residenziale con rotazione in base al job.
5. Domande frequenti
Serve sempre un proxy per il web scraping? No. Per poche pagine pubbliche a bassa frequenza, di solito basta la tua rete. I proxy aiutano quando ti servono dati da molte regioni, job di lunga durata o molte uscite di rete.
Residenziale con rotazione o statico: qual è meglio per lo scraping? I proxy residenziali con rotazione sono adatti ai job con molte richieste su molte regioni. I proxy statici sono adatti ai job che richiedono un'uscita fissa e sessioni lunghe. La scelta giusta dipende dalla destinazione e dalle regole del sito.
Un proxy elimina i CAPTCHA? No. I siti valutano anche i cookie, la frequenza delle richieste e il comportamento del browser. Il proxy è solo il livello di rete. Non sostituisce una strategia sensata per la raccolta dei dati.
Posso usare proxy gratuiti? I proxy gratuiti vanno bene per test rapidi, ma spesso hanno connessioni instabili, uptime variabile e rischi per la sicurezza. Per job commerciali che girano di continuo, usa un servizio proxy con una provenienza degli IP chiara e una gestione delle connessioni.
6. Riepilogo
Non tutti i job di scraping hanno bisogno di proxy. Quando un job carica pagine da molte regioni, gira di continuo o elabora dati su larga scala, i proxy ti danno un controllo flessibile delle uscite di rete.
Per gli sviluppatori, il tipo di proxy giusto insieme al controllo della frequenza delle richieste, ai timeout e ai nuovi tentativi conta più del numero di IP. IPFoxy offre proxy residenziali con rotazione, proxy ISP statici, proxy per data center e proxy mobili, con targeting geografico e controllo delle sessioni. Con questi puoi costruire la configurazione di rete di cui il tuo job ha bisogno.
Quando non devi gestire tu i proxy
Questa guida tratta il caso in cui scrivi tu lo scraper e gestisci le uscite. Se ti servono dati strutturati dalle piattaforme, come prezzi dei prodotti, recensioni, post o profili, puoi invece chiamare un'API per i dati. EveryInfra riceve un link o una parola chiave e restituisce campi JSON. Le chiamate non riuscite o vuote sono gratuite. Non devi configurare proxy né fare il parsing delle pagine. Puoi anche usare entrambi: invia il traffico verso le tue pagine e i tuoi siti tramite le uscite di IPFoxy e ottieni i dati delle piattaforme dall'API.
- Come funzionano insieme: Uso con i proxy di IPFoxy nella nostra documentazione.
- Il nostro test sul traffico proxy di 40 pagine prodotto di Amazon: Quanto traffico proxy consuma una pagina di Amazon?
- Dati dei prodotti Amazon senza proxy: API per i dati di Amazon. Su IPFoxy: pagina partner di IPFoxy.
Riferimenti
- IETF, RFC 6585, sezione 4, «429 Too Many Requests», 2012: https://www.rfc-editor.org/rfc/rfc6585.html#section-4
- IETF, RFC 9110, «HTTP Semantics», 403 Forbidden, 2022: https://www.rfc-editor.org/rfc/rfc9110.html#name-403-forbidden
- IETF, RFC 9309, «Robots Exclusion Protocol», 2022: https://www.rfc-editor.org/rfc/rfc9309.html
- Documentazione di Requests, «Proxies»: https://requests.readthedocs.io/en/latest/user/advanced/#proxies
- ip-api.com, documentazione dell'endpoint JSON: https://ip-api.com/docs/api:json
- Sito di IPFoxy (tipi di proxy, dimensione del pool, copertura), verificato il 2026-10-26: https://www.ipfoxy.com/
- Coronium, pagina dei proxy mobili (linee, protocolli, rotazione degli IP), verificata il 2026-11-03: https://www.coronium.io/mobile-proxies
- IETF, RFC 6888, «Common Requirements for Carrier-Grade NATs (CGNs)», 2013: https://www.rfc-editor.org/rfc/rfc6888.html
Riferimenti BL-42