Proxies para web scraping: tipos y configuración de IPFoxy
Un proxy reparte las peticiones entre muchas salidas y permite ver cada página como un visitante local, pero no evita los límites de frecuencia. Comparamos cuatro tipos de proxy y mostramos una configuración probada en Python con IPFoxy.
El web scraping es una forma habitual de recoger datos públicos de la web para vigilar precios, hacer SEO, estudiar mercados o analizar redes sociales.
Cuando un trabajo pasa de unas pocas páginas a miles de peticiones, aparecen problemas nuevos: IP bloqueadas, errores HTTP 429, límites de frecuencia y páginas que cambian según la región. El código puede estar bien y aun así el trabajo puede fallar o devolver datos incompletos.
Ahí es donde ayudan los proxies. Esta guía explica por qué se usan en el scraping, en qué se diferencian los tipos de proxy y cómo configurar IPFoxy para un trabajo de recogida de datos.
1. ¿Por qué el web scraping necesita proxies?
Un servidor proxy reenvía tu petición. El sitio de destino ve la IP de salida del proxy, no la IP pública de tu propio equipo.
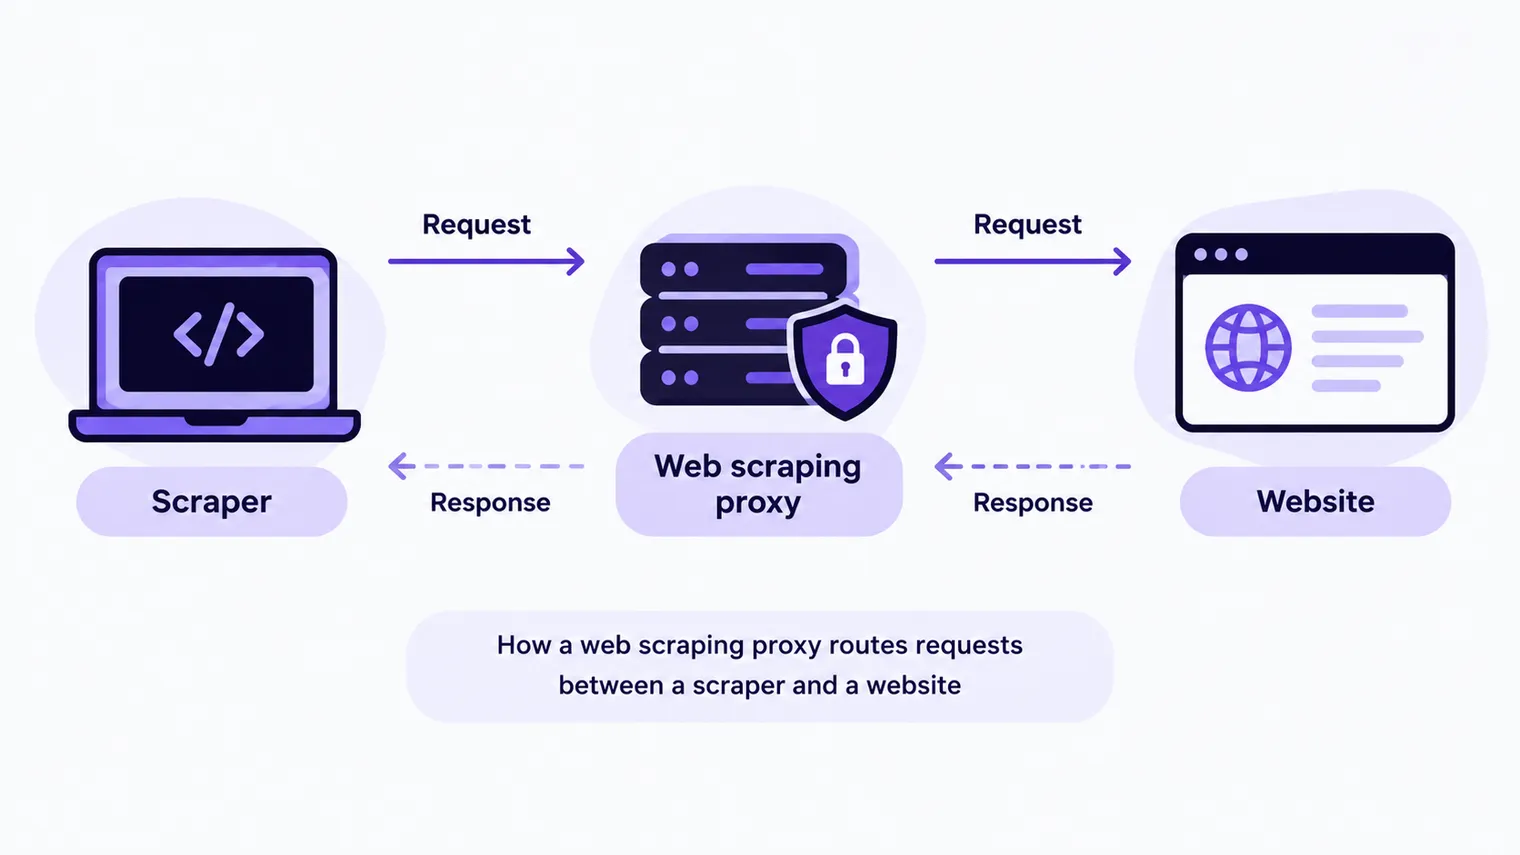
Quien navega por la web usa una sola salida de red. Un trabajo de recogida de datos que funciona todo el día puede tener estos problemas con una sola IP.
Menos carga sobre una sola IP
Si un scraper envía muchas peticiones al mismo sitio en poco tiempo, el servidor puede limitarlo por IP, por frecuencia o por comportamiento. Las señales habituales son:
- HTTP 429 Too Many Requests: el servidor considera que has enviado demasiadas peticiones. El estándar le permite añadir la cabecera
Retry-After, que indica cuándo volver a intentarlo. - HTTP 403 Forbidden: el servidor entiende la petición, pero se niega a atenderla.
- Tiempos de espera agotados o conexiones rechazadas.
- Una página de CAPTCHA o un aviso de acceso en lugar del contenido.
Un conjunto de proxies reparte un trabajo legítimo entre muchas salidas, de modo que no todas las peticiones salen de la misma IP.
Un proxy no elimina los límites de acceso. Tienes que fijar un ritmo razonable y respetar las normas del sitio, por ejemplo robots.txt (RFC 9309). Si recibes un 429, espera primero el tiempo de Retry-After; no cambies de IP para reintentar al momento.
Datos de distintas regiones
Muchos sitios muestran contenido distinto según la ubicación: precios, resultados de búsqueda, anuncios o servicios locales. Si todas las peticiones salen de un solo país, tus datos no reflejan los demás mercados.
Con un servicio de proxy que permita elegir país, estado y ciudad, puedes cargar cada página pública desde una salida en esa región y comparar mercados.
Trabajos de larga duración
En trabajos largos, los fallos de red, los proxies caídos y los servidores lentos pueden detener el scraper. Un proceso estable combina gestión de proxies, reintentos, control de tiempos de espera y registro de errores, para que un nodo con problemas no pare todo el trabajo.
2. ¿Qué tipo de proxy conviene usar?
No todos los tipos sirven para todo. Estos son los cuatro más comunes:
| Tipo de proxy | Características | Uso adecuado |
|---|---|---|
| Residencial rotativo | Salidas en redes domésticas, rotación de IP | Scraping público a gran escala, datos por región |
| ISP estático | IP fija, conexión estable | Sesiones largas, trabajos que necesitan una salida fija |
| Centro de datos | Rápido, coste más bajo | Páginas públicas, datos poco sensibles |
| Móvil | Salidas por redes de operadores móviles | Pruebas de contenido móvil, datos de redes móviles por región |
Para la mayoría de trabajos que abarcan varias regiones y funcionan durante mucho tiempo, empieza por los proxies residenciales rotativos. Si necesitas mantener la misma sesión durante mucho tiempo, usa un proxy ISP estático o la sesión fija de un proxy residencial rotativo.
3. Qué ofrece IPFoxy para trabajos de scraping grandes
En un proyecto real, un proxy no solo cambia tu IP de salida. Tiene que dar recursos de red estables, flexibles y fáciles de gestionar para trabajos de distinto tamaño, región y tipo.
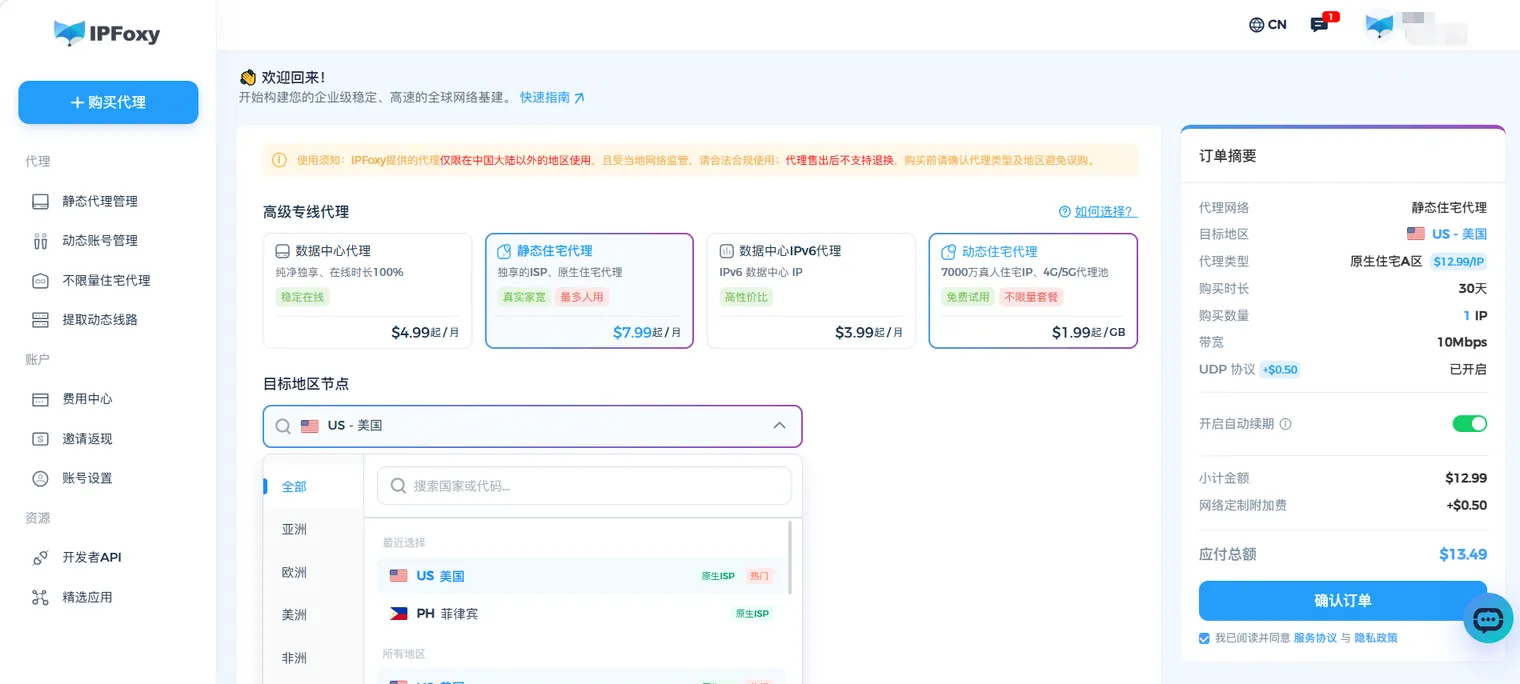
Según el sitio web de IPFoxy (consultado el 26 de octubre de 2026), IPFoxy cubre más de 200 países y regiones con unos 90 millones de IP. Ofrece proxies residenciales rotativos, ISP estáticos dedicados, de centro de datos IPv4 e IPv6, y móviles 4G/5G.
IP residenciales en muchas regiones
La vigilancia de precios, el seguimiento de posiciones, la verificación de anuncios y los estudios de mercado suelen abarcar más de un país. IPFoxy permite elegir país, estado y ciudad, así que puedes usar una salida en cada mercado y recoger la página pública que ven los visitantes locales.
Por ejemplo, un monitor de precios internacional puede usar proxies residenciales de EE. UU., Reino Unido y Japón para recoger los precios, las promociones y los resultados de búsqueda de cada mercado.
Modos de rotación para cada trabajo
Los proxies residenciales rotativos de IPFoxy ofrecen varias formas de cambiar de IP, sin que tengas que mantener tu propio conjunto de proxies:
- Rotación por petición: cada petición recibe una IP residencial nueva. Sirve para datos públicos en volumen que no requieren iniciar sesión, como fichas de producto o resultados de búsqueda.
- Sesión fija (sticky): puedes elegir 30, 60, 90 o 120 minutos. La misma IP de salida se mantiene mientras la sesión siga vigente y el nodo esté disponible. Sirve para trabajos con cookies, varios pasos o acceso continuo.
- Cambio manual: un enlace de actualización del panel cambia la salida actual cuando un nodo da problemas.
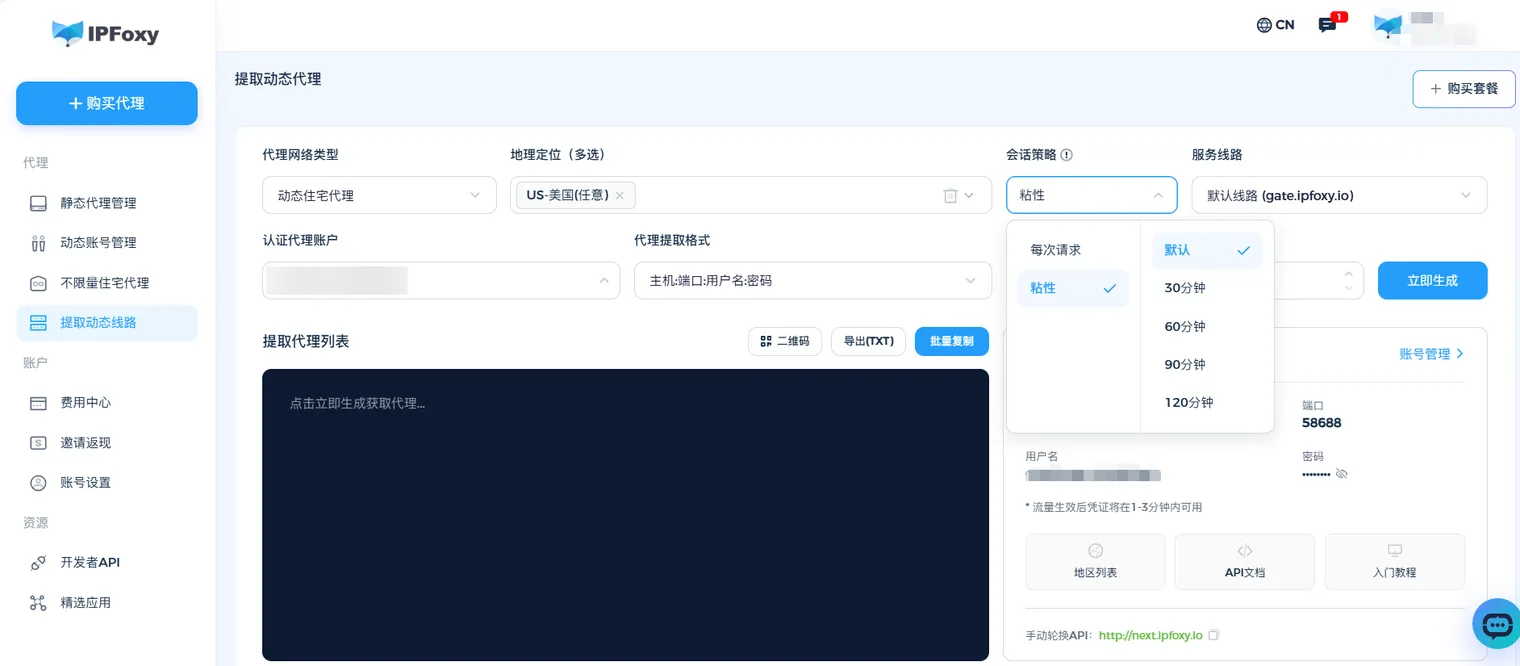
Con estos modos eliges la estrategia de IP para cada objetivo sin tocar el código del scraper ni mantener listas de IP a mano.
Planes para trabajos de distinto tamaño
| Trabajo | Tipo de proxy de IPFoxy | Ventaja principal |
|---|---|---|
| Scraping público a gran escala | Residencial rotativo | Gran conjunto de IP, rotación automática |
| Mucho tráfico, de forma continua | Residencial ilimitado | Se contrata por ancho de banda, coste más fácil de controlar |
| Sesiones largas | ISP estático dedicado | IP fija y exclusiva, estable en el tiempo |
| Páginas públicas y APIs | Centro de datos IPv4/IPv6 | Coste más bajo, bueno para peticiones en volumen |
| Contenido móvil y pruebas de red | Móvil 4G/5G | Salidas por operadores móviles |
Los proxies residenciales ilimitados permiten fijar el ancho de banda y una lista de dominios permitidos. Configura los dominios de destino, el ancho de banda y las reglas del plan antes de empezar.
Concurrencia alta y automatización
IPFoxy admite HTTP(S) y SOCKS5, así que funciona con Python Requests, Selenium, Playwright, Scrapy y otras herramientas habituales. También puedes extraer proxies en lote o por API y exportar muchas cadenas de conexión a la vez.
Los equipos pueden asignar recursos a subcuentas, controlar permisos y revisar el tráfico, el número de peticiones y la tasa de conexiones correctas. Así dedicas más tiempo al análisis de páginas, la lógica del scraper y la calidad de los datos, y menos a mantener una red de proxies.
Control del tráfico y del coste
El coste del proxy importa a escala. La vigilancia de precios, el seguimiento de resultados de búsqueda y la inteligencia de mercado consumen más tráfico a medida que crecen.
IPFoxy ofrece proxies residenciales rotativos que se cobran por tráfico y planes residenciales ilimitados para trabajos con mucho volumen. Tiene pasarelas en Asia-Pacífico, América y otras regiones (por ejemplo, gate-sg.ipfoxy.io y gate-us.ipfoxy.io). Elige la más cercana a donde se ejecuta tu código y ajusta la configuración con las estadísticas de uso y tus propias pruebas.
4. Cómo usar los proxies de IPFoxy para hacer scraping
El ejemplo usa Requests de Python. Añades el proxy de IPFoxy a la configuración de la petición y la petición pasa por el servidor proxy.
Paso 1: obtén los datos de tu proxy en IPFoxy
Entra en el sitio de IPFoxy, crea una cuenta y elige el tipo de proxy. Después de comprar un plan o activar la prueba, abre la página de extracción de proxies del panel. Elige país, tipo de sesión y servidor, pon el formato «usuario:contraseña@host:puerto», pulsa Generar y luego Copiar todo.
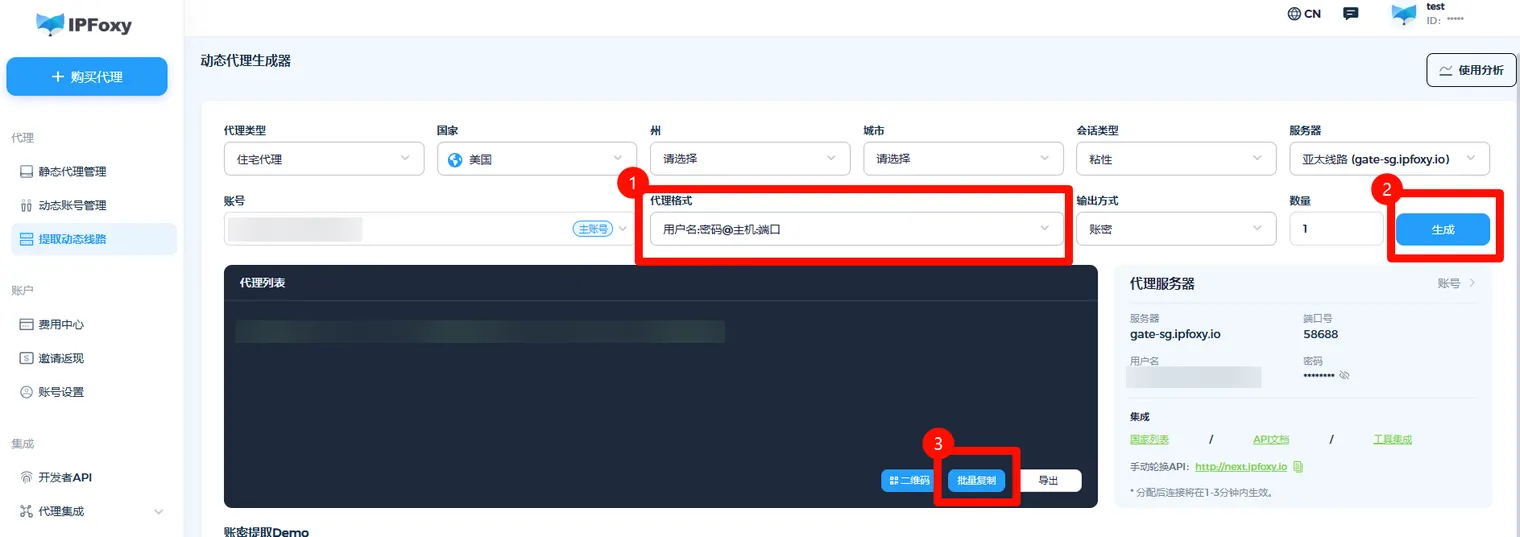
Paso 2: instala Requests
pip install requestsPaso 3: configura el proxy y envía una petición
Pega en PROXY la cadena de conexión que copiaste. El formato es usuario:contraseña@pasarela:puerto; para la pasarela de EE. UU. queda como username:password.
import requests

# Sustituye por la cadena de conexión de tu panel de IPFoxy: usuario:contraseña@pasarela:puerto
PROXY = "http://username:[email protected]:58688"
proxies = {"http": PROXY, "https": PROXY}

if __name__ == "__main__":
    resp = requests.get("http://ip-api.com/json", proxies=proxies, timeout=30)
    resp.raise_for_status()
    info = resp.json()
    print(info["query"], info["country"], info.get("city"))  # IP de salida, país, ciudad
El país y la ciudad que aparecen deben ser los de la región del proxy que elegiste, no tu propia ubicación. Eso confirma que la IP de salida ya es la del proxy. Si la petición falla con 407 Proxy Authentication Required, el usuario o la contraseña no son correctos: vuelve a copiarlos del panel.

Cómo lo probamos: el 26 de octubre de 2026 ejecutamos este código contra un proxy simulado en local (Requests 2.34, Python 3.15). Con el usuario y la contraseña correctos, mostró la IP y la región de salida. Con una contraseña errónea, Requests lanzó
ProxyErrorcon la causa407 Proxy Authentication Required. Copia la pasarela tal como aparece en el panel, por ejemplogate-us.ipfoxy.io(con punto, no con guion): un host mal escrito falla al resolver el DNS. El servicio gratuito deip-api.comsolo admitehttp://; su documentación indica que HTTPS requiere el plan de pago.
Paso 4: añade el proxy a tu scraper
Después de la prueba de conexión, usa la misma configuración en tus peticiones a las páginas públicas del sitio de destino. Añade pausas razonables, reintentos y registros para que el trabajo sea estable. En trabajos grandes, ajusta el modo de rotación del proxy residencial al tipo de trabajo.
5. Preguntas frecuentes
¿Siempre hace falta un proxy para hacer scraping? No. Para unas pocas páginas públicas a un ritmo bajo, tu propia red suele bastar. Los proxies ayudan cuando necesitas datos de varias regiones, trabajos de larga duración o muchas salidas de red.
¿Residencial rotativo o estático: cuál es mejor para scraping? Los residenciales rotativos sirven para trabajos con muchas peticiones en varias regiones. Los estáticos, para trabajos que necesitan una salida fija y sesiones largas. Depende del objetivo y de las normas del sitio.
¿Un proxy evita los CAPTCHA? No. Los sitios también miran las cookies, la frecuencia de peticiones y el comportamiento del navegador. El proxy es solo la capa de red; no sustituye a una estrategia de recogida razonable.
¿Se pueden usar proxies gratuitos? Sirven para pruebas rápidas, pero suelen tener conexiones inestables, disponibilidad irregular y riesgos de seguridad. Para trabajos comerciales que funcionan de forma continua, conviene un servicio con origen de IP claro y gestión de conexiones.
6. Resumen
No todos los trabajos de scraping necesitan proxies. Cuando un trabajo carga páginas de varias regiones, funciona sin parar o procesa datos a escala, los proxies dan un control flexible de las salidas de red.
Para un desarrollador, elegir el tipo de proxy adecuado y combinarlo con control de frecuencia, tiempos de espera y reintentos importa más que tener muchas IP. IPFoxy ofrece proxies residenciales rotativos, ISP estáticos, de centro de datos y móviles, con selección de ubicación y control de sesión, para montar la configuración de red que necesita cada trabajo.
Cuándo no necesitas gestionar proxies
Esta guía cubre el caso en que escribes el scraper y gestionas las salidas. Si lo que necesitas son datos estructurados de plataformas, como precios, reseñas, publicaciones o perfiles, puedes llamar a una API de datos. EveryInfra recibe un enlace o una palabra clave y devuelve campos JSON; las llamadas fallidas o vacías no se cobran, y no tienes que configurar proxies ni analizar páginas. También puedes usar las dos cosas: el tráfico hacia tus propias páginas y sitios sale por IPFoxy, y los datos de plataformas llegan por la API.
- Cómo funcionan juntos: Uso con proxies de IPFoxy en nuestra documentación.
- Nuestra prueba del tráfico de proxy en 40 fichas de Amazon: ¿Cuánto tráfico de proxy usa una página de Amazon?
- Datos de producto de Amazon sin proxy: API de datos de Amazon. Sobre IPFoxy: página de IPFoxy.
Referencias
- IETF, RFC 6585, sección 4, «429 Too Many Requests», 2012: https://www.rfc-editor.org/rfc/rfc6585.html#section-4
- IETF, RFC 9110, «HTTP Semantics», 403 Forbidden, 2022: https://www.rfc-editor.org/rfc/rfc9110.html#name-403-forbidden
- IETF, RFC 9309, «Robots Exclusion Protocol», 2022: https://www.rfc-editor.org/rfc/rfc9309.html
- Documentación de Requests, «Proxies»: https://requests.readthedocs.io/en/latest/user/advanced/#proxies
- ip-api.com, documentación del servicio JSON: https://ip-api.com/docs/api:json
- Sitio web de IPFoxy (tipos de proxy, tamaño del conjunto de IP, cobertura), consultado el 26-10-2026: https://www.ipfoxy.net/
Referencia BL-42