数据采集为什么需要代理IP?类型与IPFoxy配置
代理 IP 能分散请求、按地区取数,但不能保证不被限流。动态住宅、静态 ISP、数据中心、移动四类代理怎么选,IPFoxy 怎么配进 Python,附代码。
在电商价格监控、搜索引擎优化、市场调研和社交媒体分析等业务中,网页数据采集(Web Scraping)已经成为获取公开网络信息的重要方式。
然而,当数据采集任务从少量页面扩展到成千上万个请求时,开发者经常会遇到 IP 被限制、HTTP 429 错误、访问频率受限、地区内容差异等问题。即使爬虫代码没有错误,也可能出现抓取失败或数据不完整的情况。
这正是代理 IP 在数据采集场景中发挥作用的地方。那么,数据采集为什么需要代理 IP?不同类型的爬虫代理有什么区别?如何通过 IPFoxy 为数据采集任务配置合适的代理网络?本文逐一介绍。
一、数据采集为什么需要代理 IP?
代理 IP 是指通过代理服务器转发网络请求,使目标网站接收到的是代理服务器的出口 IP,而不是客户端直接连接时使用的公网 IP。
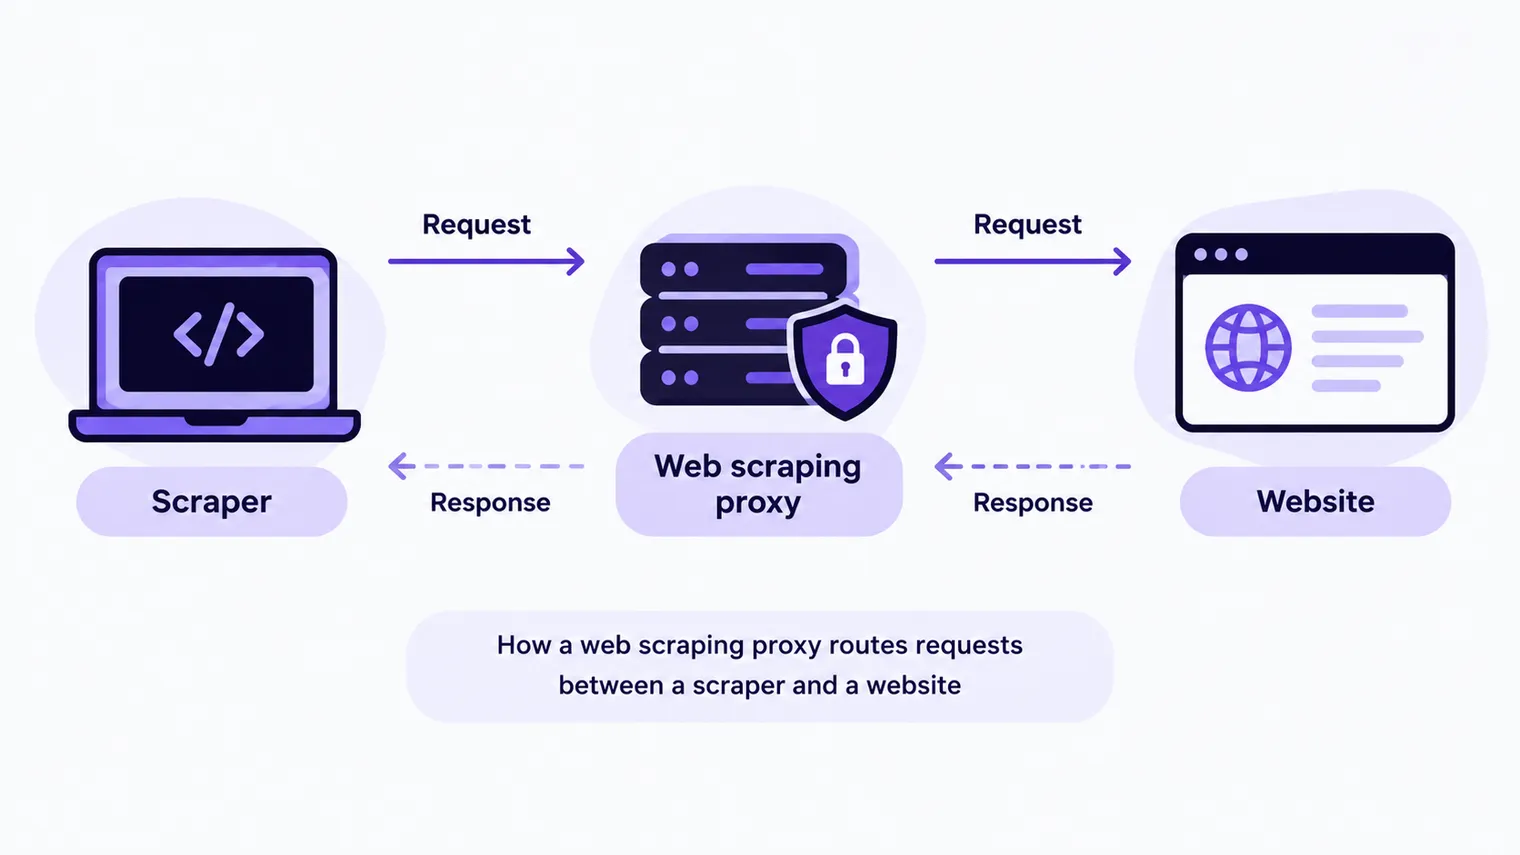
在普通网页访问中,用户通常只需要通过一个网络出口访问网站。但在持续运行的数据采集任务中,单一 IP 可能面临以下问题。
1. 降低单一 IP 的请求压力
当爬虫在短时间内向同一网站发送大量请求时,目标服务器可能根据 IP 地址、访问频率、请求行为等因素实施限速。常见表现包括:
- HTTP 429 Too Many Requests:服务器认为请求太多。标准允许服务器同时返回
Retry-After头,告诉你多久以后再试。 - HTTP 403 Forbidden:服务器理解请求,但拒绝执行。
- 请求超时或连接被拒绝。
- 页面返回验证码或访问限制提示。
通过代理 IP 池,可以将合规的数据采集任务分配到多个网络出口,避免所有请求都集中在同一个 IP 上。
需要注意的是,代理 IP 并不能保证消除访问限制。合理设置请求频率、遵守目标网站的访问规则(例如 robots.txt,标准见 RFC 9309)同样重要;收到 429 时,先按 Retry-After 等待,而不是马上换 IP 重试。
2. 获取不同地区的网页数据
同一个网站可能根据访问者所在地区展示不同内容,例如商品价格、搜索结果、广告素材或本地化服务信息。如果所有请求都来自同一个国家,采集到的数据可能无法完整反映其他地区的市场情况。
通过支持国家、州和城市定向的代理服务,开发者可以从不同地区的网络出口获取对应的公开页面内容,更方便地开展全球市场分析。
3. 支持持续运行的数据采集任务
在长期采集任务中,网络连接异常、代理失效、服务器响应缓慢等情况都可能导致爬虫中断。稳定的数据采集系统通常需要结合代理管理、请求重试、超时检测和错误日志等机制,减少单个网络节点异常对整体任务的影响。
二、数据采集应该选择哪种代理 IP?
并非所有代理 IP 都适合相同的数据采集任务。常见的爬虫代理主要包括以下四种类型。
| 代理类型 | 主要特点 | 适用数据采集场景 |
|---|---|---|
| 动态住宅代理 | 住宅网络出口,支持 IP 轮换 | 大规模公开网页抓取、地区数据采集 |
| 静态 ISP 代理 | IP 固定、连接稳定 | 长期会话、需要固定出口的采集任务 |
| 数据中心代理 | 速度快、成本相对较低 | 公开页面抓取、低敏感度数据采集 |
| 移动代理 | 通过移动运营商网络出口访问 | 移动端内容测试、地区移动网络数据分析 |
对于大多数需要多地区覆盖、持续运行的网页抓取任务,动态住宅代理通常是值得优先考虑的方案。如果采集任务要求长期保持同一会话,则可以考虑静态 ISP 代理,或者使用动态住宅代理的粘性会话功能。
三、IPFoxy 如何为大规模数据采集提供代理方案?
在实际的数据采集项目中,代理 IP 的价值不仅在于更换网络出口,还在于能否为不同规模、不同地区和不同类型的抓取任务提供稳定、灵活且可管理的网络资源。
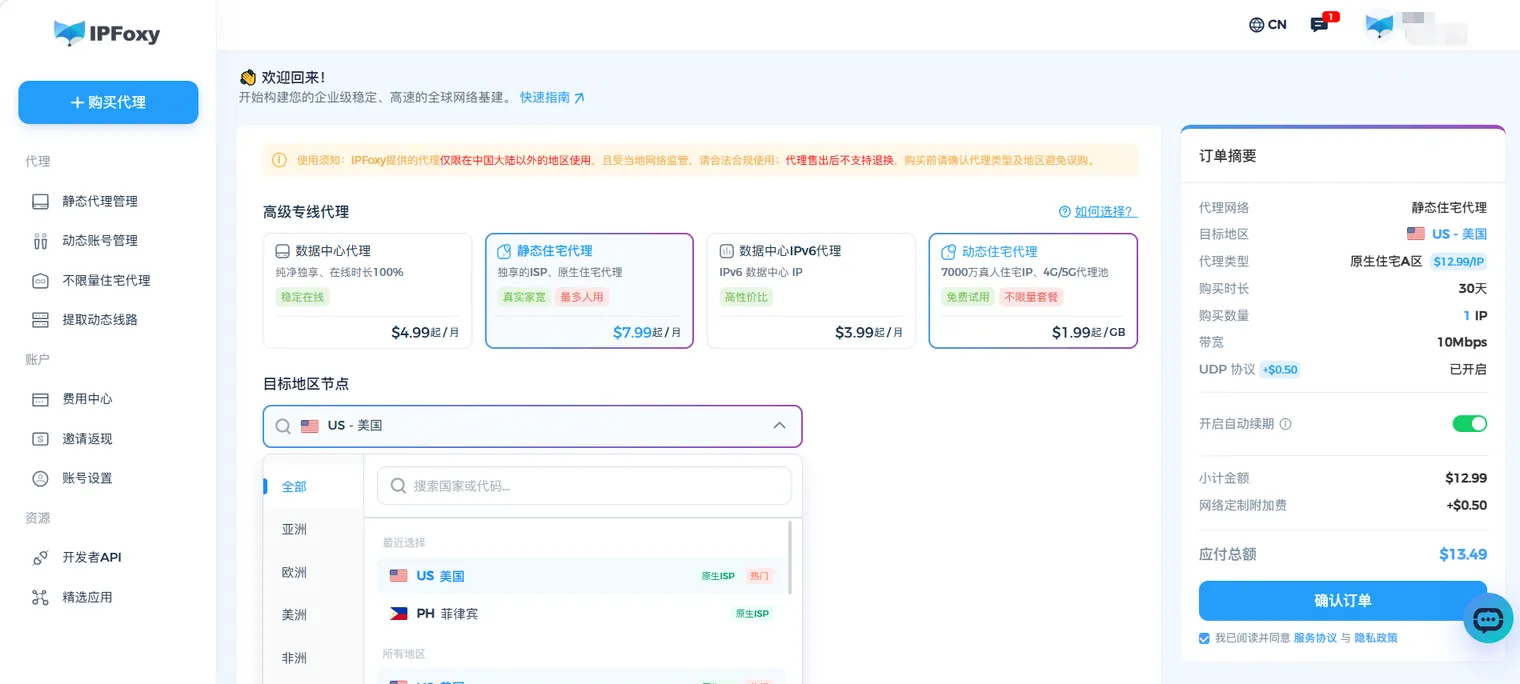
据 IPFoxy 官网(2026 年 10 月 26 日查看),IPFoxy 的代理网络覆盖 200 多个国家和地区,IP 池约 9000 万,支持动态住宅、专属静态 ISP、数据中心 IPv4/IPv6 及 4G/5G 移动代理,覆盖从基础网页抓取到大规模自动化数据采集的不同需求。
1. 全球住宅 IP,支持多地区数据采集
对于电商价格监控、搜索引擎排名分析、广告验证和市场调研等业务,数据采集往往不局限于单一国家。IPFoxy 支持国家、州、城市级别的定位,开发者可以根据目标市场选择相应地区的出口 IP,获取不同地理位置下的公开网页内容。
例如,进行全球电商价格监控时,可以分别配置美国、英国、日本等地区的住宅代理,采集不同市场展示的商品价格、促销活动和搜索结果,为跨地区市场分析提供数据支持。
2. 灵活的 IP 轮换机制,适配不同抓取任务
IPFoxy 动态住宅代理支持多种 IP 切换方式,开发者无需自行维护复杂的代理 IP 池,即可根据采集任务调整网络出口:
- 按请求轮换(Per-request Rotation):每次请求自动分配新的住宅 IP,适合电商商品信息、搜索结果等无需保持登录状态的批量公开数据采集。
- 粘性会话(Sticky Session):会话时长可选 30、60、90、120 分钟,在有效期内且节点可用时保持同一出口 IP,适合需要 Cookie、连续访问或多步骤操作的采集任务。
- 手动切换 IP:通过控制台给出的刷新接口切换当前代理出口,方便在节点异常时调整连接。
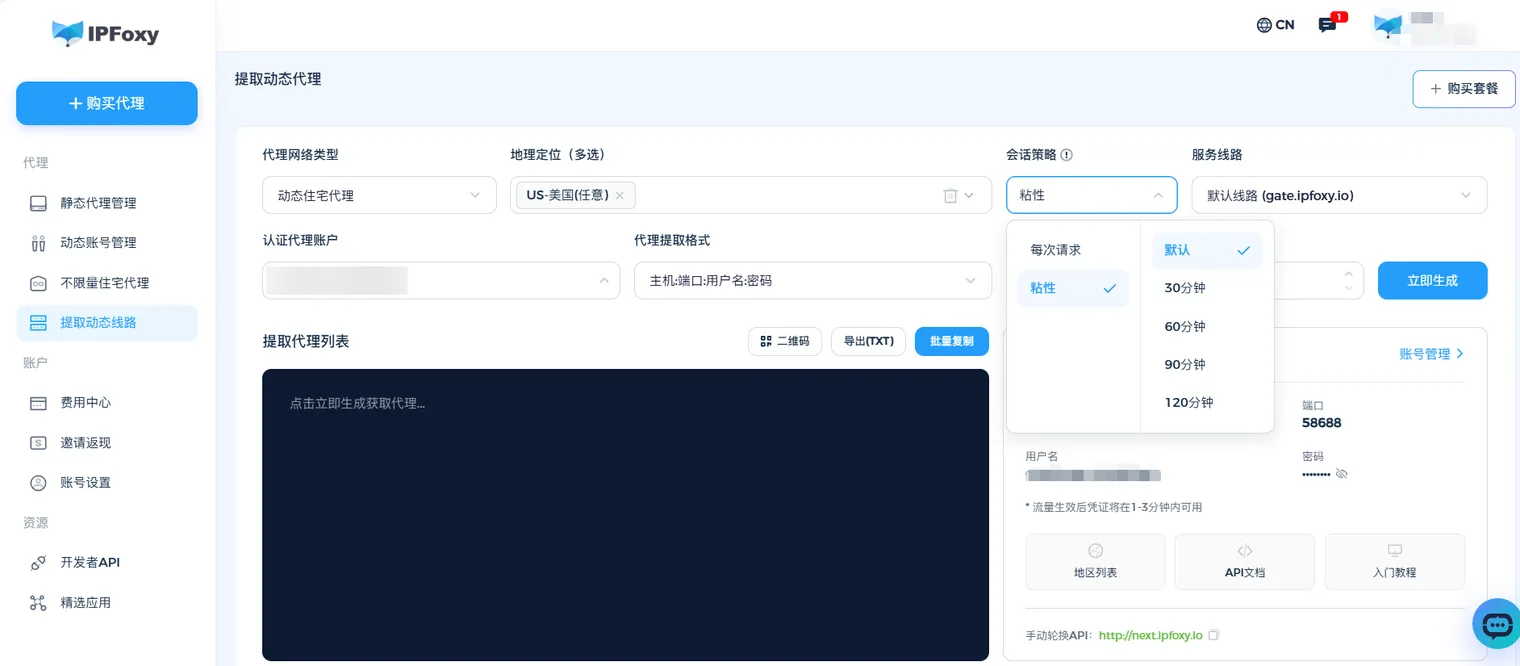
这种轮换机制让开发者可以根据采集目标选择合适的 IP 使用策略,而不是频繁修改爬虫代码或手动维护 IP 列表。
3. 多种代理方案,满足不同规模的数据采集需求
不同采集任务对代理网络的要求存在明显差异。IPFoxy 提供多种代理类型,帮助开发者在稳定性、灵活性和成本之间进行选择。
| 数据采集需求 | IPFoxy 代理类型 | 主要优势 |
|---|---|---|
| 大规模公开网页抓取 | 动态住宅代理 | 大 IP 池、自动轮换 |
| 高流量、持续性采集 | 不限量住宅代理 | 按带宽配置,便于控制流量成本 |
| 长期会话与连续采集 | 专属静态 ISP 代理 | 固定独享 IP、长期稳定 |
| 普通公开网页及 API 数据采集 | 数据中心 IPv4/IPv6 代理 | 成本相对较低、适合批量请求 |
| 移动端内容与网络测试 | 4G/5G 移动代理 | 移动运营商网络出口 |
其中,不限量住宅代理支持按业务需求配置带宽和域名白名单,适合高流量、高并发的持续性采集场景。实际使用前需要根据目标域名、带宽和套餐规则进行配置。
4. 支持高并发与自动化集成,减少代理维护成本
对于需要持续运行的数据采集系统,代理服务不仅要提供 IP 资源,还需要方便地接入现有的自动化工具和采集程序。
IPFoxy 支持 HTTP(S) 和 SOCKS5 协议,可集成到 Python Requests、Selenium、Playwright、Scrapy 等常见爬虫框架中。同时,IPFoxy 提供批量代理提取与 API 获取方式,支持生成和导出多条代理连接信息,方便开发者统一管理不同采集任务的网络出口。
对于团队或多项目采集场景,还可以通过子账号分配代理资源、管理使用权限,并通过流量统计、请求量及连接成功率等数据了解代理使用情况。这样开发者可以把更多精力放在数据解析、采集逻辑和数据质量上,而不必从零搭建和维护整个代理网络。
5. 灵活的流量与网络管理,适应长期采集需求
在大规模数据采集中,代理成本同样是需要考虑的重要因素。尤其是持续运行的价格监控、搜索结果分析和市场情报采集任务,代理流量消耗可能随着请求规模快速增长。
IPFoxy 提供按流量计费的动态住宅代理,以及面向高流量场景的不限量住宅代理方案,方便开发者根据采集规模和预算选择。此外,IPFoxy 有亚太、美洲等不同代理网关线路(例如 gate-sg.ipfoxy.io、gate-us.ipfoxy.io),开发者可以根据程序部署位置选择连接线路,结合使用统计与实际测试结果优化网络配置。
四、如何使用 IPFoxy 代理进行网页数据采集?
以 Python Requests 为例,只需要把 IPFoxy 的代理信息写进请求参数,即可通过代理服务器访问目标网页。
第一步:获取 IPFoxy 代理信息
前往 IPFoxy 官网注册账号,选择适合数据采集需求的代理类型。购买或开通试用后,在控制台「提取动态线路」页选择国家、会话类型和服务器,代理格式选「用户名:密码@主机:端口」,点「生成」,再点「批量复制」。
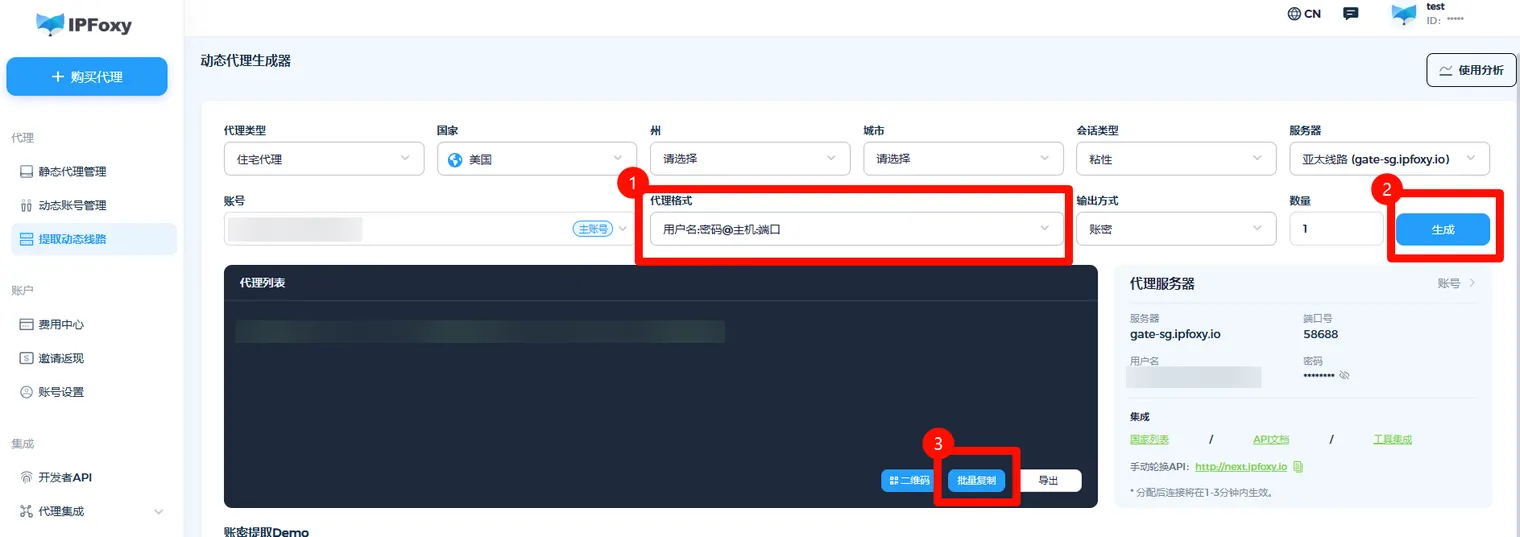
第二步:安装 Python Requests
pip install requests第三步:配置代理并发送请求
把刚才复制的连接信息填进 PROXY。连接信息的格式是 用户名:密码@网关:端口,例如美国线路是 username:password。
import requests

# 换成你在 IPFoxy 控制台复制的连接信息,格式是 用户名:密码@网关:端口
PROXY = "http://username:[email protected]:58688"
proxies = {"http": PROXY, "https": PROXY}

if __name__ == "__main__":
    resp = requests.get("http://ip-api.com/json", proxies=proxies, timeout=30)
    resp.raise_for_status()
    info = resp.json()
    print(info["query"], info["country"], info.get("city"))  # 出口 IP、国家、城市
运行后,输出里的国家和城市应该是你选的代理地区,而不是你本机所在地,这就说明出口 IP 已经换成了代理。如果连接失败并提示 407 Proxy Authentication Required,说明用户名或密码不对,回到控制台重新复制。

实测说明:这段代码在 2026 年 10 月 26 日用本地模拟代理跑过(requests 2.34,Python 3.15):用户名和密码正确时返回出口 IP 和地区;故意写错密码时,requests 抛出
ProxyError,原因是407 Proxy Authentication Required。网关地址要照控制台写,例如gate-us.ipfoxy.io(中间是点,不是短横线),写错会直接报域名解析失败。ip-api.com的免费接口只能用http://,它的文档写明 HTTPS 要付费版。
第四步:集成到数据采集程序
完成连接测试后,可以把相同的代理配置用到目标网站的公开页面请求中,并结合合理的请求间隔、错误重试和日志记录,建立更稳定的采集流程。对于大规模任务,还可以根据需求配置动态住宅代理的轮换模式。
五、数据采集使用代理 IP 的常见问题
1. 数据采集一定要使用代理 IP 吗? 不一定。如果只是低频率抓取少量公开页面,通常可以直接使用本地网络。代理 IP 更适合需要多地区数据、持续运行或多个网络出口的采集任务。
2. 动态住宅代理和静态代理哪个更适合爬虫? 动态住宅代理适合多请求、多地区的采集任务;静态代理适合需要固定网络出口、长期保持会话的场景。具体选择取决于采集目标和网站访问要求。
3. 使用代理 IP 就不会遇到验证码了吗? 不是。网站还可能结合 Cookie、请求频率、浏览器行为等因素判断访问请求。代理只是网络层的一部分,不能代替合理的采集策略。
4. 免费代理 IP 可以用于数据采集吗? 免费代理可以用于简单测试,但通常存在连接不稳定、可用率波动和安全风险。对于需要持续运行的商业数据采集任务,更建议选择来源清晰、支持连接管理的代理服务。
六、总结
代理 IP 并不是所有数据采集任务的必需品,但当业务涉及多地区网页访问、持续性抓取和规模化数据处理时,它能提供更灵活的网络出口管理能力。
对于开发者而言,选择合适的代理类型,并配合请求频率控制、超时处理和重试机制,往往比单纯增加 IP 数量更重要。IPFoxy 提供动态住宅、静态 ISP、数据中心及移动代理资源,支持地区定向和代理会话管理,帮助开发者按实际需求搭建数据采集的网络环境。
什么时候可以不自己配代理
上面讲的是「自己写爬虫、自己管出口」的做法。如果你要的是平台上的结构化数据(商品价格、评论、帖子、账号主页等),也可以直接调数据接口:EveryInfra 按链接或关键词返回 JSON 字段,失败或空结果不扣费,不需要自己配代理和处理页面结构。两种方式也能一起用:自己的页面和站点走 IPFoxy 出口,平台数据走接口。
- 两者怎么配合,见文档「配合 IPFoxy 代理使用」一节。
- 我们实测过 40 个 Amazon 商品页的代理流量:代理流量怎么算钱。
- 想直接拿 Amazon 商品数据,见 Amazon 数据接口;合作介绍见 IPFoxy 合作页。
参考资料
- RFC 6585 第 4 节,429 Too Many Requests,IETF,2012:https://www.rfc-editor.org/rfc/rfc6585.html#section-4
- RFC 9110,HTTP Semantics,403 Forbidden,IETF,2022:https://www.rfc-editor.org/rfc/rfc9110.html#name-403-forbidden
- RFC 9309,Robots Exclusion Protocol,IETF,2022:https://www.rfc-editor.org/rfc/rfc9309.html
- Requests 文档,Proxies:https://requests.readthedocs.io/en/latest/user/advanced/#proxies
- ip-api.com JSON 接口文档:https://ip-api.com/docs/api:json
- IPFoxy 官网(产品类型、IP 池规模、覆盖地区,2026-10-26 查看):https://www.ipfoxy.net/
引用编号 BL-42