Quanto traffico proxy consuma una pagina Amazon?
Abbiamo misurato i byte di 40 richieste di pagine prodotto Amazon e di 6 caricamenti completi nel browser, li abbiamo valorizzati ai prezzi di listino per GB di IPFoxy e abbiamo confrontato il costo per 1.000 pagine con quello di un'API per i dati. Il risultato dipende da come scarichi le pagine, dal piano che acquisti e dalla frequenza con cui le richieste vanno a buon fine.
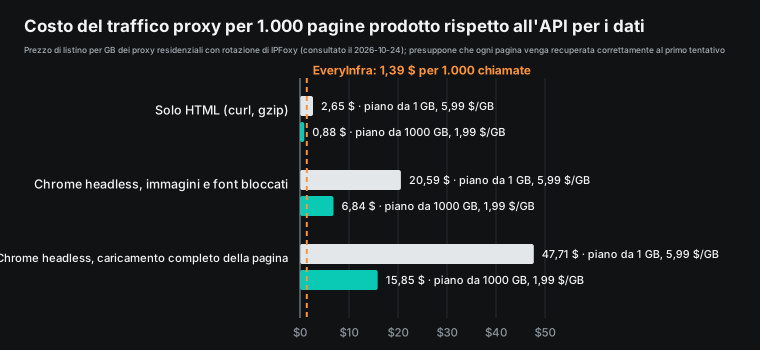
I proxy residenziali con rotazione vengono venduti in base ai GB di traffico consumati. Quindi il numero di byte scaricati da una pagina determina il costo del proxy per quella pagina. Il 24 ottobre 2026, dalle 18:30 alle 18:41 ora di Singapore, abbiamo misurato 40 richieste di pagine prodotto di Amazon US e 6 caricamenti completi nel browser. Con il solo HTML, la pagina mediana pesava 0,44 MB. Con un caricamento completo in un browser headless, la mediana era di 7,96 MB, 18 volte tanto. Ai prezzi di listino dei proxy residenziali con rotazione di IPFoxy, il traffico per 1.000 pagine costa da $0,88 a $47,71. La stessa pagina tramite un'API per i dati costa $1,39 per 1.000 chiamate.
Questo articolo mette sulla stessa scala il costo del traffico proxy e quello di un'API per i dati. Quale dei due costi meno dipende da come scarichi le pagine, dal piano che acquisti e dalla frequenza con cui le tue richieste vanno a buon fine. Ogni numero qui sotto ha una fonte e puoi scaricare i dati grezzi.
Perché misurare prima i byte
IPFoxy vende i proxy residenziali con rotazione in base al traffico consumato. Il 24 ottobre la sua pagina dei prezzi elencava sei piani: 1GB, 10GB, 50GB, 100GB, 500GB e 1000GB. Il prezzo per GB scende da $5,99 a $1,99 e i piani sono validi da 30 a 180 giorni. Oltre i 1000GB c'è un piano personalizzato “a partire da $0,60/GB” (prezzi dei proxy residenziali con rotazione di IPFoxy). Il pool di IP copre oltre 200 paesi e regioni (località di IPFoxy). Per un prodotto addebitato in base al traffico, costo = byte scaricati × prezzo. Il prezzo è sul sito. I byte devi misurarli tu.
Non esiste una risposta unica a “quanto pesa una pagina”. Il Web Almanac 2025 di HTTP Archive definisce il peso della pagina come l'insieme dei byte che un browser scarica per mostrarla. Riporta anche che sono le immagini a occupare più byte (Web Almanac 2025: Page Weight). Ma uno script di raccolta dei dati non sempre scarica le immagini. Tra il solo HTML e un'esecuzione completa nel browser c'è un ordine di grandezza di differenza. Per questo abbiamo misurato tre metodi comuni.
Criteri di successo e insuccesso, definiti prima del test
Prima del test abbiamo fissato tre regole:
- L'unità di confronto è “i dati di una pagina prodotto”. Esito positivo: ogni metodo ottiene almeno 3 pagine prodotto reali (il titolo è il nome di un prodotto, non una pagina di blocco).
- Contiamo i byte trasmessi in rete, non la dimensione decompressa, perché i proxy addebitano il traffico trasferito. Per l'HTML sommiamo
size_downloadesize_headerdi curl (curl manual, --write-out; Everything curl: write-out variables). Per il browser sommiamoNetwork.loadingFinished.encodedDataLengthdi ogni richiesta dal Chrome DevTools Protocol (CDP Network domain). - Usiamo 1 GB = 10⁹ byte (NIST prefixes for binary multiples). Se un provider conta 1 GB come 2³⁰ byte, ogni costo qui sotto è più basso di circa il 7%.
Risultato: tutti e tre i metodi superano la regola 1 (16 pagine HTML, 3 pagine per ciascun metodo con browser). Le regole 2 e 3 sono applicate più avanti.
Test 1: byte per metodo
Abbiamo eseguito il test da una linea a banda larga domestica a Singapore, senza proxy. I prodotti provengono da un'unica ricerca: l'API di ricerca per parole chiave di Amazon per air fryer, primi 20 ASIN (18:30, 31,6 secondi, addebito di $0,001389).
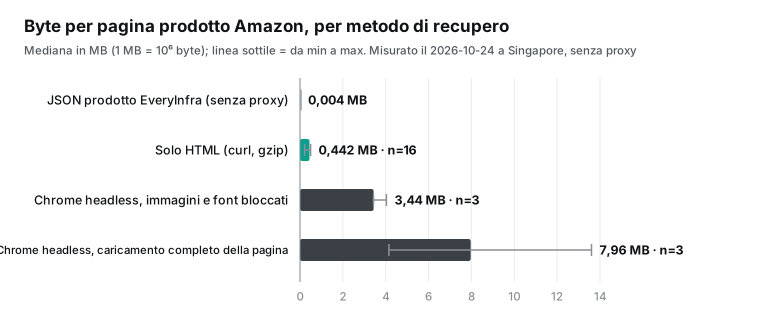
Solo HTML. Abbiamo richiesto /dp/<ASIN> con curl, normali header da browser e Accept-Encoding: gzip, deflate, br (MDN: Accept-Encoding), a intervalli di 4 secondi, in due serie da 20 richieste. Amazon ha inviato gzip (RFC 1952), non Brotli (RFC 7932). Per le 16 pagine prodotto reali, il trasferimento mediano è stato di 441.688 byte, il minimo di 213.178 e il massimo di 496.482. Decompresse, le pagine pesavano da 1,08 a 2,68 MB.
Browser headless, caricamento completo. Abbiamo aperto 3 pagine prodotto nella nuova modalità headless di Chrome (Chrome headless docs), con la cache disattivata, attendendo 15 secondi per pagina. Le tre pagine hanno usato 13,60, 4,15 e 7,96 MB, con un numero di richieste compreso tra 224 e 270 per pagina. Nella prima pagina le immagini hanno occupato 7,03 MB (52%) e gli script 3,02 MB. In DevTools, “transferred size” e “resource size” sono valori diversi; noi usiamo il primo (Chrome DevTools network reference).
Browser headless, immagini e font bloccati. Molti script bloccano il caricamento delle immagini. Sia Playwright sia Puppeteer documentano come farlo (Playwright: Network; Puppeteer: request interception). Con immagini e font bloccati tramite Network.setBlockedURLs di CDP, le tre pagine hanno usato 4,03, 3,44 e 3,43 MB. Gli script costituivano la maggior parte dei byte restanti: circa 3,0 MB, ovvero l'87%.
| Metodo | Campione | Trasferimento mediano per pagina | Intervallo |
|---|---|---|---|
| Solo HTML (curl, gzip) | 16 pagine | 0,442 MB | 0,213–0,496 MB |
| Chrome headless, immagini e font bloccati | 3 pagine | 3,44 MB | 3,43–4,03 MB |
| Chrome headless, caricamento completo della pagina | 3 pagine | 7,96 MB | 4,15–13,60 MB |
| JSON del prodotto di EveryInfra (senza proxy) | 1 chiamata | 0,004 MB | — |
Le due righe relative ai metodi con browser hanno solo 3 pagine ciascuna. In due pagine CDP ha registrato il documento principale come 0 byte. Quindi queste due righe sono limiti inferiori, non valori esatti.
Test 2: senza proxy, quale store vedi?
Le stesse richieste mostrano anche un'altra cosa: è l'IP di uscita a decidere cosa mostra la pagina.
- Serie 1, senza cookie: 19 pagine prodotto su 20 hanno restituito HTTP 200, ma il corpo era una pagina di 3.781 byte con “Click the button below to continue shopping”. Solo 1 era una vera pagina prodotto. Tutte e 3 le pagine di ricerca (
/s?k=) hanno restituito 503. - La serie 2 è iniziata con una visita alla home page per ottenere i cookie. Le prime 5 risposte erano ancora pagine interstiziali. Le 15 successive erano vere pagine prodotto. Su 40 richieste, 16 hanno restituito una pagina reale: il 40%.
- Tutte le 16 pagine reali indicavano Singapore come luogo di consegna. Due di esse segnalavano che l'articolo non può essere spedito in quel luogo.
- Nel browser,
amazon.com/s?k=air+fryerfiniva su una pagina intitolata “Amazon.sg : air fryer”, lo store di Singapore.
Quindi, per vedere i prezzi, la consegna e i risultati di ricerca di un acquirente statunitense, la richiesta deve partire da un IP statunitense. È a questo che servono i proxy residenziali. La pagina delle soluzioni di IPFoxy indica e-commerce, raccolta dei dati e verifica degli annunci tra gli utilizzi principali (soluzioni di IPFoxy). Il blog di IPFoxy ha anche una guida alla raccolta dei dati per l'e-commerce (IPFoxy: guida alla raccolta dei dati per l'e-commerce). Le pagine di blocco in sé sono piccole (4.206 byte con gli header). Il loro costo si misura in richieste e tempo, non in traffico.
Il costo di 1.000 pagine prodotto
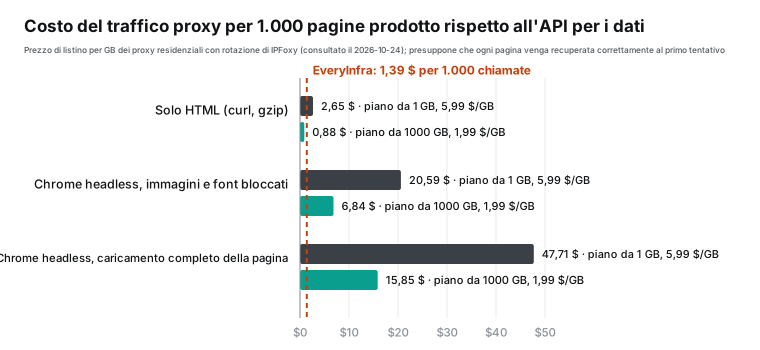
Moltiplichiamo le mediane del Test 1 per 1.000 e per il prezzo per GB di IPFoxy di ciascun piano. Assumiamo che ogni pagina vada a buon fine al primo tentativo. Non contiamo i nuovi tentativi, l'handshake del tunnel proxy né i byte in upload.
| Metodo | Piano 1GB $5,99/GB | Piano 10GB $4,99/GB | Piano 100GB $2,99/GB | Piano 1000GB $1,99/GB |
|---|---|---|---|---|
| Solo HTML | $2.65 | $2.20 | $1.32 | $0.88 |
| Browser, immagini e font bloccati | $20.59 | $17.15 | $10.28 | $6.84 |
| Browser, caricamento completo | $47.71 | $39.74 | $23.81 | $15.85 |
L'API dei dettagli prodotto di Amazon restituisce la stessa pagina a $0,001389 per chiamata, ovvero $1,39 per 1.000 chiamate (catalogo delle funzionalità, consultato alle 18:29). Le chiamate non riuscite o vuote non vengono addebitate. Alle 18:37 l'abbiamo chiamata una volta per B0CYJDVT31. Ha restituito 20 campi in 9,1 secondi, con un corpo JSON di 3.569 byte. Se ti servono solo i campi dell'elenco (prezzo, valutazione, numero di valutazioni, marca), una chiamata di ricerca restituisce 20 prodotti, quindi 1.000 prodotti costano circa $0,07.
Il tasso di successo necessario
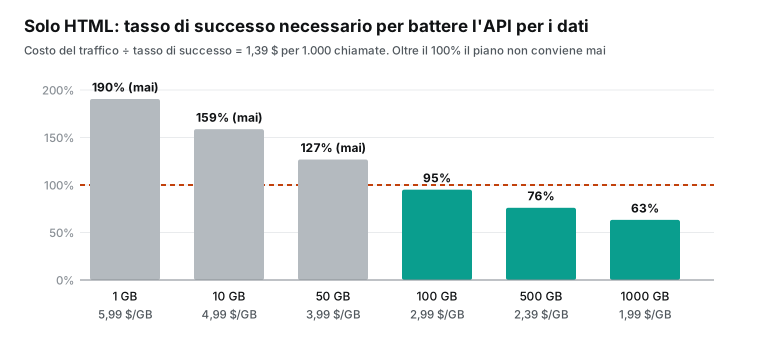
La tabella presuppone il 100% di successo. Le richieste reali falliscono e i fallimenti richiedono nuovi tentativi. Se il tasso di successo è s, il costo del traffico per pagina ottenuta correttamente è circa “costo del traffico ÷ s” (una pagina fallita pesa solo circa 4 KB, quindi la ignoriamo). Con il solo HTML, perché il costo sia inferiore a quello dell'API per i dati, serve un tasso di successo di almeno:
- Piani 1GB, 10GB e 50GB: 190%, 159% e 127%. Questi piani non costano mai meno.
- Piano 100GB: 95%.
- Piano 500GB: 76%.
- Piano 1000GB: 63%.
Senza proxy, usando una connessione a banda larga a Singapore, abbiamo ottenuto pagine reali nel 40% delle richieste. Con IP residenziali statunitensi il tasso sarà diverso. Non avevamo un account IPFoxy, quindi non l'abbiamo misurato e non forniamo un numero. Usa il tuo tasso di successo nella formula qui sopra.
Questo calcolo non include il costo del lavoro. Quando raccogli le pagine da solo, scrivi i parser, modifichi il codice quando cambia il layout della pagina e gestisci pagine di blocco e nuovi tentativi. Un'API per i dati restituisce nomi di campo fissi, quindi quel lavoro lo eviti. Però un'API per i dati copre solo le piattaforme e i campi presenti nel suo catalogo. Per le altre pagine la raccolta resta a tuo carico.
Chi fa cosa: IPFoxy o un'API per i dati
Sulla base di questi numeri, ecco cosa consigliamo:
- Usa IPFoxy per le pagine che devi aprire come un utente di un determinato paese. Esempi: consegna e prezzo finale per un acquirente statunitense, il tuo account venditore, i posizionamenti pubblicitari locali. Usalo anche per i siti che non sono nel catalogo di un'API per i dati e per le pagine che richiedono il rendering in un browser reale. Gli IP residenziali statici sono adatti a gestire a lungo un singolo store o account; il prezzo di listino parte da $7,99/mese (prezzi dei proxy residenziali statici di IPFoxy).
- Usa un'API per i dati per le piattaforme e i campi già presenti nel catalogo. È la scelta migliore per grandi job con campi fissi da inserire in un foglio di calcolo o in un database. Una chiamata all'API per i dati non richiede un proxy. Un proxy aggiunge solo traffico proxy.
Per fare entrambe le cose in un solo script, consulta la sezione “Uso con i proxy IPFoxy” della nostra documentazione. L'esempio in Python usa requests 2.34.2 (PyPI: requests). La tua richiesta viene inviata tramite il proxy. Quella a EveryInfra viene inviata direttamente, con trust_env = False (Requests advanced usage: proxies; Requests API: Session.trust_env). L'indirizzo del proxy ha la forma username:password@host:port e il centro assistenza di IPFoxy mostra una configurazione in Python (IPFoxy: rotating proxy with Python). Il suo esempio usa la libreria standard urllib.request, che per impostazione predefinita legge anche le variabili d'ambiente relative ai proxy (Python urllib.request docs). In Scrapy, imposta proxy nel meta della richiesta (Scrapy: HttpProxyMiddleware).
Non avevamo un account IPFoxy, quindi abbiamo testato la parte proxy dell'esempio con un proxy mock locale. Il mock apre un tunnel con il metodo HTTP CONNECT (RFC 9110, sezione 9.3.6; MDN: CONNECT) e verifica le credenziali Basic nell'header Proxy-Authorization (RFC 7617; MDN: Proxy-Authorization). Con la password corretta, l'esempio ha raggiunto ipinfo.io attraverso il mock e poi ha ottenuto i dati del prodotto da EveryInfra. Con una password errata, il mock ha restituito 407 (MDN: 407) e l'esempio si è fermato prima di chiamare EveryInfra, quindi non è stato addebitato nulla. Abbiamo anche impostato HTTPS_PROXY sul mock. Il log del mock mostrava comunque solo la richiesta a ipinfo.io: la richiesta a EveryInfra non è passata da lì.
Come citare questi dati
- Dati grezzi: amazon-page-weight-2026-10-24.csv (su GitHub: repository di esempi di EveryInfra, amazon-page-weight-2026-10-24.csv; copia su questo sito:
https://everyinfra.com/articles/proxy-traffic-cost-amazon-product-pages/amazon-page-weight-2026-10-24.csv), 51 righe. Ogni riga corrisponde a una richiesta o a un caricamento completo di pagina. Le colonne sono tipo di pagina, ASIN, metodo, ora, stato HTTP, pagina reale (sì o no), byte trasferiti, numero di richieste e una nota. - Periodo di rilevazione: 2026-10-24, 18:30–18:41 ora di Singapore (UTC+8). I prezzi di IPFoxy sono stati consultati lo stesso giorno.
- Come verificare: HTML con curl 8.7.1 e
--write-out '%{size_download} %{size_header}'; browser con Chrome 155 in modalità headless e CDP, tramite uno script Node.js 26 che usa l'oggettoWebSocketintegrato (Node.js global objects). Lo script e quello del grafico si trovano nella nostra cartella di esempi su GitHub, linkata da /docs#with-proxy. - Citazione suggerita: EveryInfra, “Quanto traffico proxy consuma una pagina Amazon?”, 2026-10-24, https://everyinfra.com/it/blog/proxy-traffic-cost-amazon-product-pages (dati consultati il 2026-10-24, 18:30–18:41 SGT).
Quando questi risultati non valgono
- Il campione è piccolo: 16 pagine HTML reali e 3 pagine per ciascun metodo con browser, tutte di un'unica categoria (friggitrici ad aria). Le pagine più lunghe (più recensioni, più varianti) usano più byte. Il report mensile di HTTP Archive mostra che il peso delle pagine cambia nel tempo (HTTP Archive: Page Weight report). Ripeti la misurazione tra un anno.
- Nessun proxy nel percorso: passando da un proxy, header, handshake del tunnel e redirect aggiungono qualche byte, e il tasso di successo cambia.
- Prezzi di listino: il sito di IPFoxy mostra sconti per la registrazione (dal 17% al 23% a partire dal piano 10GB). Non li abbiamo applicati. Controlla il prezzo attuale sul sito di IPFoxy.
- La conformità esula dall'ambito del test: abbiamo misurato solo i byte. Il robots.txt di Amazon non blocca le pagine prodotto
/dp/per i crawler generici. Ma blocca l'intero sito per diversi crawler specifici, come Scrapy e GPTBot (Amazon robots.txt). Le sue Conditions of Use (aggiornate il 2026-08-14) limitano il data mining e l'uso di robot nella sezione “License and Access” (Amazon Conditions of Use). Leggi i termini di un sito prima di raccoglierne i dati.
Costo di questo test: 3 chiamate a EveryInfra, $0,004167 in totale (1 ricerca, 2 dettagli prodotto). Altre tre richieste hanno restituito 429 per il limite di frequenza delle richieste sulla stessa chiave; non sono state addebitate. IPFoxy è nostro partner. I link a IPFoxy in questo articolo non hanno parametri di referral, quindi non li contrassegniamo come link di referral (regole di Google per i link a pagamento e di referral: Qualify your outbound links). La nostra pagina partner è IPFoxy Global Proxy. I numeri riportati provengono dai due siti nel giorno in cui li abbiamo consultati.
Letture consigliate
- Piattaforma: API di scraping per Amazon
- Funzionalità: API dei dettagli prodotto di Amazon, API di ricerca per parole chiave di Amazon
- Documentazione: Uso con i proxy IPFoxy, Prezzi
Riferimenti
- “Rotating Residential Proxy pricing”, IPFoxy, consultato il 2026-10-24. https://www.ipfoxy.com/pricing/rotating/
- “Static Residential Proxy pricing”, IPFoxy, consultato il 2026-10-24. https://www.ipfoxy.net/pricing/residential/
- “How to use Rotating proxy through Python?”, IPFoxy Help Center, 2025-11-18. https://www.ipfoxy.com/help/docs/bn3BDn
- “Solutions”, IPFoxy, consultato il 2026-10-24. https://www.ipfoxy.net/solution/
- “Proxy locations”, IPFoxy, consultato il 2026-10-24. https://www.ipfoxy.net/country/
- Guida alla raccolta dei dati per l'e-commerce (in cinese), blog di IPFoxy, consultata il 2026-10-24. https://www.ipfoxy.net/blog/use-cases/6929
- “Network domain” (loadingFinished, setBlockedURLs), Chrome DevTools Protocol, consultato il 2026-10-24. https://chromedevtools.github.io/devtools-protocol/tot/Network/
- “Chrome Headless mode”, Chrome for Developers, consultato il 2026-10-24. https://developer.chrome.com/docs/chromium/headless
- “Network features reference”, Chrome for Developers, consultato il 2026-10-24. https://developer.chrome.com/docs/devtools/network/reference
- “curl manual” (--write-out), progetto curl, consultato il 2026-10-24. https://curl.se/docs/manpage.html
- “Write out”, Everything curl, consultato il 2026-10-24. https://everything.curl.dev/usingcurl/verbose/writeout.html
- “Advanced Usage” (Proxies), documentazione di Requests, consultato il 2026-10-24. https://requests.readthedocs.io/en/latest/user/advanced/
- “Developer Interface” (Session.trust_env), documentazione di Requests, consultato il 2026-10-24. https://requests.readthedocs.io/en/latest/api/
- requests 2.34.2, PyPI, rilasciato il 2026-05-14. https://pypi.org/project/requests/
- “urllib.request”, documentazione di Python, consultato il 2026-10-24. https://docs.python.org/3/library/urllib.request.html
- RFC 9110, “HTTP Semantics”, IETF, 2022-06. https://www.rfc-editor.org/rfc/rfc9110
- RFC 7617, “The 'Basic' HTTP Authentication Scheme”, IETF, 2015-09. https://www.rfc-editor.org/rfc/rfc7617
- RFC 1952, “GZIP file format specification version 4.3”, IETF, 1996-05. https://www.rfc-editor.org/rfc/rfc1952
- RFC 7932, “Brotli Compressed Data Format”, IETF, 2016-07. https://www.rfc-editor.org/rfc/rfc7932
- “CONNECT request method”, MDN, consultato il 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Methods/CONNECT
- “Proxy-Authorization header”, MDN, consultato il 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Proxy-Authorization
- “407 Proxy Authentication Required”, MDN, consultato il 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/407
- “Accept-Encoding header”, MDN, consultato il 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Accept-Encoding
- “Web Almanac 2025: Page Weight”, HTTP Archive, 2026-01-15. https://almanac.httparchive.org/en/2025/page-weight
- “Page Weight report”, HTTP Archive, consultato il 2026-10-24. https://httparchive.org/reports/page-weight
- “Network”, documentazione di Playwright, consultato il 2026-10-24. https://playwright.dev/docs/network
- “Request Interception”, documentazione di Puppeteer, consultato il 2026-10-24. https://pptr.dev/guides/network-interception
- “Downloader Middleware” (HttpProxyMiddleware), documentazione di Scrapy, consultato il 2026-10-24. https://docs.scrapy.org/en/latest/topics/downloader-middleware.html
- “Prefixes for binary multiples”, NIST, consultato il 2026-10-24. https://physics.nist.gov/cuu/Units/binary.html
- robots.txt, Amazon, consultato il 2026-10-24. https://www.amazon.com/robots.txt
- “Conditions of Use”, Amazon, aggiornate il 2026-08-14. https://www.amazon.com/gp/help/customer/display.html?nodeId=508088
- “Developers”, IPinfo, consultato il 2026-10-24. https://ipinfo.io/developers
- “Global objects” (WebSocket), documentazione di Node.js, consultato il 2026-10-24. https://nodejs.org/api/globals.html
- Catalogo delle funzionalità di EveryInfra, GET /api/v1/social/catalog, consultato il 2026-10-24 alle 18:29. https://api.everyinfra.com/api/v1/social/catalog
- “Qualify your outbound links to Google”, Google Search Central, consultato il 2026-10-24. https://developers.google.com/search/docs/crawling-indexing/qualify-outbound-links
- Dati grezzi amazon-page-weight-2026-10-24.csv, repository di esempi di EveryInfra everyinfra-agent-plugins, 2026-10-24. https://github.com/everyinfra/everyinfra-agent-plugins/blob/main/examples/proxy-plus-data-api/data/amazon-page-weight-2026-10-24.csv
Riferimenti BL-36