Chiave API e documentazione di Serper: dall'accesso al tuo primo risultato
Serper non ha un sito di documentazione: la documentazione è il Playground, e le chiavi si possono solo creare, rinominare o reimpostare. 34 chiamate reali mappano parametri, errori e rotazione delle chiavi.
Chi cerca «serper api key», «serper api docs» o «serper api login» si scontra quasi sempre con lo stesso ostacolo: Serper non ha un sito di documentazione separato. Il 5 novembre 2026, serper.dev/docs restituiva un 404. La «documentazione» che funziona è il Playground, una pagina che puoi usare solo dopo aver effettuato l'accesso. Le regole sui parametri, i costi in crediti e il codice di esempio si trovano tutti nel JavaScript di quella pagina.
Abbiamo letto le pagine pubbliche di serper.dev e i relativi script front-end. Poi abbiamo inviato 34 richieste reali all'API di ricerca di EveryInfra tra le 00:18 e le 00:54 SGT dello stesso giorno. Ventuno richieste hanno restituito risultati e sono costate in totale $0,015269. Le altre 13 erano errori voluti (un header della chiave sbagliato, superamenti del limite di frequenza delle richieste e un risultato vuoto) e sono costate tutte $0.
Questa guida non confronta i prezzi. Confronta il percorso fino a una chiamata funzionante. Quanti passaggi separano la registrazione dal primo risultato? Dove si trova la chiave, quante chiavi puoi creare e cosa fai se la chiave trapela?
La guida mappa q, gl, hl, num, page e type sui nostri parametri. Mostra i veri corpi degli errori. Mostra anche dove inserire la chiave in Python, n8n e nei client MCP. Per i prezzi, leggi i nostri tre articoli precedenti su Serper, linkati nella prima sezione.
Cosa tratta questa guida e dove trovare i prezzi
Il riepilogo dei prezzi in una riga: i quattro pacchetti di Serper costano da $0,30 a $1,00 per 1.000 crediti e scadono dopo 6 mesi. La ricerca web di EveryInfra costa $0,000694 per chiamata ($0,694 per 1.000) senza scadenza. Per il costo per 1.000 query, leggi Alternativa a Serper API: prezzi, piano gratuito e test reali. Per sapere quanto durano 2.500 query gratuite, leggi Piano gratuito di Serper API. Per i quattro pacchetti mese per mese, leggi I prezzi di Serper API spiegati.
Questo articolo è per lo sviluppatore che usa Serper o pensa di provarlo. Tratta solo configurazione e debug. Vedrai dove ottenere la chiave e come inviarla. Vedrai anche dove si trovano le regole sui parametri, cosa fare quando una chiamata fallisce e come sostituire una chiave trapelata.
Per Serper abbiamo usato solo materiale pubblico, cioè la home page, la pagina di registrazione, la pagina di accesso, i termini, l'informativa sulla privacy e il JavaScript che queste pagine caricano nel browser di qualsiasi visitatore. Non abbiamo creato un account Serper, né usato una chiave Serper, né chiamato l'API di ricerca di Serper. Quindi ogni affermazione su «cosa vedi dopo l'accesso» proviene dal testo di quegli script o da post pubblici di terzi, e citiamo ogni volta la fonte. Ogni numero di EveryInfra proviene da una risposta reale del 5 novembre 2026.
La tabella di confronto: chiave, documentazione e prima richiesta
La tabella contiene solo fatti verificabili. La colonna Serper proviene dalle pagine e dagli script di serper.dev, letti il 5 novembre 2026. La colonna EveryInfra proviene dalla documentazione, dalla pagina dei prezzi, dal file OpenAPI, dal catalogo pubblico e dalle nostre chiamate reali. Abbiamo riletto la documentazione, la pagina dei prezzi e il file OpenAPI alle 01:25 SGT del 5 novembre 2026 e ne abbiamo conservato una copia.
| Voce | Serper | EveryInfra |
|---|---|---|
| Registrazione | Nome, email e password, più una verifica umana; verifica dell'email dopo la registrazione | Email, oppure continua con GitHub o Google |
| Accesso | Email e password; 2FA facoltativa con un'app di autenticazione | Come per la registrazione |
| Uso gratuito | 2.500 query, senza carta di credito | Metti una stella a due repo GitHub per un credito di prova di $1, valido 24 ore |
| Dove si trova la chiave | Pagina API Keys nella dashboard | API Keys nella console; la chiave completa viene mostrata una sola volta, alla creazione |
| Chiavi per account | Più di una, ognuna con un nome | Più di una, separate per ambiente o uso |
| Gestione delle chiavi | Crea, rinomina, copia, reimposta | Crea, limita per prodotto, disattiva, allowlist di IP, ruota |
| Header di autenticazione | X-API-KEY: <key> (la variante GET inserisce apiKey nell'URL) | Authorization: Bearer <key> |
| Endpoint | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| Dove si trova la documentazione | Playground (dopo l'accesso); nessun sito di documentazione | /docs, /llms.txt, /openapi.json e un catalogo gratuito degli strumenti |
| Specifica leggibile dalle macchine | Nessun file OpenAPI o llms.txt trovato | OpenAPI 3.0.3 con 61 path, llms.txt, JSON del catalogo degli strumenti |
| MCP | Nessuno ufficiale di Serper; server della community da eseguire in locale | Server MCP remoto su https://api.everyinfra.com/mcp |
| Formato degli errori | {"message": "...", "statusCode": 403} (post di terzi) | {"error": {"code", "message", "fault", "retryable", "next_steps", ...}} |
Tre righe contano più delle altre. La prima è «Dove si trova la documentazione». Serper mette parametri, codice di esempio e costi in crediti in una pagina interattiva che richiede l'accesso. Per una persona funziona bene, ma un assistente di programmazione AI ha bisogno di un passaggio in più per leggerla. La seconda è «Gestione delle chiavi».
La pagina delle chiavi di Serper ha quattro azioni e nessuna eliminazione. Non puoi limitare cosa può fare una chiave né da dove può essere usata. La terza è l'header di autenticazione. Le due API usano header diversi, ed è la modifica che si dimentica più spesso. Nel nostro test, una chiave valida inviata in X-API-KEY ha restituito un 401.
Login all'API di Serper: i passaggi di registrazione e accesso
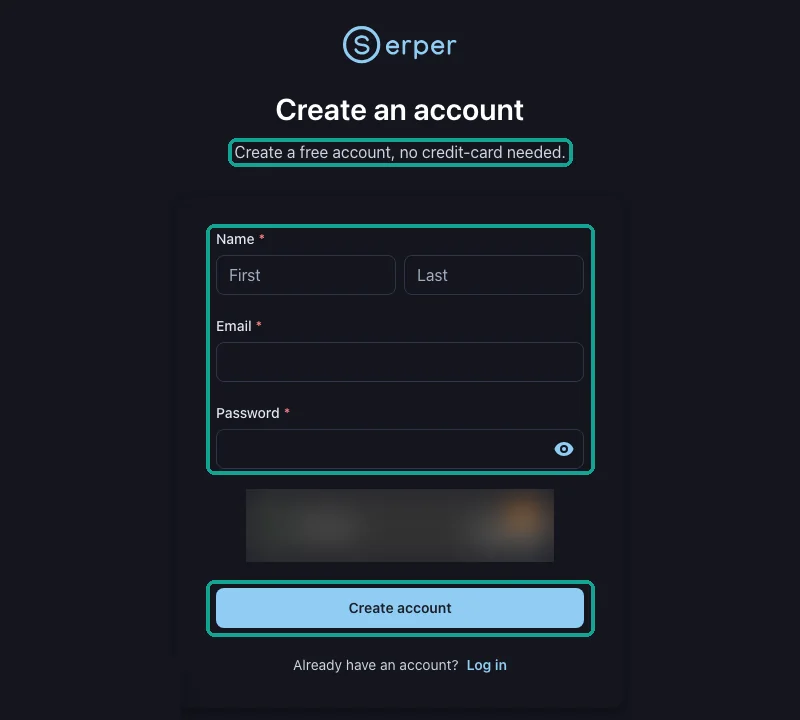
La pagina di registrazione di Serper riporta «Create an account» e «Create a free account, no credit-card needed.» Il modulo ha tre campi obbligatori: nome (nome e cognome), email e password (serper.dev/signup, letta il 5 novembre 2026). Sotto il modulo c'è una verifica umana, e il pulsante «Create account» funziona solo dopo averla superata. Lo script della pagina invia due token di verifica umana con la richiesta. Dopo la registrazione, una pagina mostra «Please verify your email account», con le opzioni per inviare di nuovo l'email o uscire. Un link valido mostra «Your email has been verified.» Un link vecchio mostra «The verification link is invalid or has expired.»
La pagina di accesso riporta «Log in to your account». Contiene email, password, «Remember me» e «Forgot password?» (serper.dev/login). Se attivi l'accesso a due fattori in Settings, digiti anche un codice generato da un'app di autenticazione. Il testo delle impostazioni recita «Scan the QR code below with your authenticator app». Negli script di registrazione e di accesso non abbiamo trovato il login con Google o GitHub.
Quindi «serper api login» ha un solo percorso: email e password. Un piccolo dettaglio spiega molti risultati di ricerca. Se apri serper.dev/api-keys senza aver effettuato l'accesso, la pagina mostra il modulo di login. Per questo il primo risultato per «serper api login» ha spesso il titolo «Log in to your account» ma l'URL /api-keys.
I termini di servizio di Serper riportano «Updated on May 29, 2024». Due regole riguardano gli account. La prima vieta agli utenti di «Register more than one account at any point in time». Quindi creare account aggiuntivi per avere altre query gratuite viola i termini.
La seconda vieta qualsiasi «Attempt to circumvent any restrictions or limits placed on your Serper API key or account». I termini specificano anche che Serper è un servizio business-to-business. L'informativa sulla privacy riporta «Date Last Reviewed: 5 November 2025» e indica che Serper raccoglie log di accesso e log di attività.
La registrazione a EveryInfra parte da «Inizia gratis», in alto a destra del sito. La pagina ha un solo campo email e un codice referral facoltativo, poi «Continua con GitHub» e «Continua con Google». Anche qui non abbiamo creato un nuovo account, quindi i passaggi successivi alla registrazione provengono dalla pagina e dalla documentazione. La guida rapida indica che dopo la registrazione crei una chiave API nella console e che la chiave completa viene mostrata una sola volta.
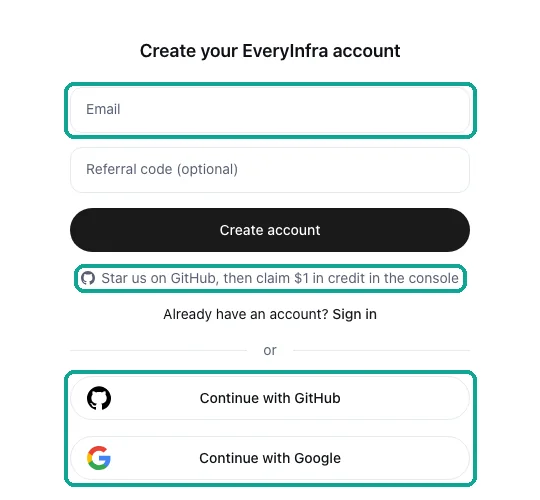
La differenza principale nella configurazione sta in un solo passaggio. Dopo la registrazione a Serper, apri un link di verifica nella tua casella di posta e poi accedi con email e password. Su EveryInfra puoi continuare con GitHub o Google e saltare la casella di posta. La prova da $1 di EveryInfra aggiunge una visita su GitHub per mettere una stella a due repo, ma quel passaggio serve per il credito, non per la chiave. Per un assistente AI che esegue la configurazione, ogni passaggio dalla casella di posta richiede una persona e interrompe il flusso.
Dove si trova la chiave API di Serper e cosa puoi farci?
La chiave di Serper si trova nella pagina API Keys della dashboard. Il titolo della pagina è «API Keys» e il sottotitolo «Your keys to unlock the power of Serper». Lo script della pagina chiama tre endpoint dell'account: elenco delle chiavi, creazione di una chiave e rinomina di una chiave. Una chiave deve avere un nome, e se lasci il campo vuoto il modulo mostra «Name is required».
Ogni chiave ha anche un'azione «Reset». La finestra di reset recita «Are you sure you want to reset this API key? This action cannot be undone and any applications using this key will stop working.» Dopo un reset, la pagina mostra «The old API key is not valid anymore. Replace it with the new one.»
La pagina ha anche un pulsante di copia con il messaggio «API key copied to clipboard». Quindi la chiave completa resta visibile nella dashboard, e chiunque abbia le tue credenziali di accesso può copiarla di nuovo in seguito. Lo script non ha un endpoint per eliminare una chiave. Non ha nemmeno impostazioni per limitare una chiave ad alcuni prodotti, a un tetto di spesa o ad alcuni indirizzi IP di origine.
La pagina Settings comprende nome, password, accesso a due fattori e carta di pagamento. Una pagina «Activity logs» elenca le richieste recenti con le colonne Time, Query, Type, Page, Num, Credits e Response time (ms). Puoi filtrarla per chiave. Un interruttore «Anonymize queries» impedisce al log di conservare il testo delle query.
| Azione | Serper (script della pagina API Keys) | EveryInfra (documentazione, pagina dei prezzi, OpenAPI) |
|---|---|---|
| Creazione | Sì, il nome è obbligatorio | Sì, una per ambiente o uso |
| Rinomina | Sì | Sì (PATCH /portal/api/keys/{key_id} in OpenAPI) |
| Rivedere la chiave completa | Pulsante di copia sulla pagina | La chiave completa viene mostrata una sola volta, alla creazione |
| Reset o rotazione | Sì, la vecchia chiave smette subito di funzionare | Sì, solo nella console |
| Disattivare senza eliminare | Non trovato | Sì, poi le chiamate restituiscono 401 |
| Eliminazione | Non trovato | Le chiavi create nella console si possono solo disattivare; quelle create tramite API si possono eliminare |
| Limitazione per prodotto | Non trovato | Sì, un prodotto bloccato restituisce 403 capability_denied |
| Allowlist di IP | Non trovato | Sì, solo nella console |
| Log per chiave | Sì, gli Activity logs si filtrano per chiave | Sì, cronologia delle chiamate nella console; OpenAPI ha un endpoint di utilizzo per chiave |
| Limite di spesa e scadenza per chiave | Non trovato | Sì, spend_limit_usd e expires_at (OpenAPI) |
Una funzione mancante non rende Serper inutilizzabile. A uno sviluppatore con una sola chiave per un solo script bastano creazione e reset. La lacuna emerge con i team, con più ambienti e con gli agenti AI. Supponi che una chiave si trovi sul tuo laptop, nella CI e in un notebook demo che hai condiviso con un cliente.
Se il notebook trapela, un reset su Serper blocca tutti e tre i punti insieme. Con chiavi separate per ambiente, disattivi solo quella trapelata. La documentazione di EveryInfra usa l'immagine del quadro elettrico: una chiave è l'interruttore generale, e API Keys → Permission limits spegne i singoli circuiti (guida rapida, sezione sull'autenticazione).
Gestire le chiavi da uno script: gli endpoint delle chiavi nel file OpenAPI di EveryInfra
La console non è l'unico modo per gestire le chiavi. La sezione Account del file OpenAPI di EveryInfra elenca una serie di endpoint per le chiavi, che abbiamo letto alle 01:25 SGT del 5 novembre 2026. Nessuno di questi è a pagamento. Condividono con gli altri endpoint dell'account un limite di 60 richieste al minuto per account.
Gli endpoint di lettura richiedono gli scope di lettura dell'account. Una chiave con accesso completo ai prodotti ha account:read, requests:read e billing:read per impostazione predefinita. Una chiave limitata ad alcuni prodotti li ottiene solo dopo che il proprietario dell'account li attiva nella console. Gli endpoint di scrittura richiedono lo scope keys:write. Questo scope è disattivato per impostazione predefinita e solo il proprietario dell'account può concederlo, dopo aver effettuato l'accesso alla console. Ogni modifica fatta con una chiave compare nelle notifiche della console.
| Endpoint | Cosa fa | Limiti nella specifica |
|---|---|---|
GET /portal/api/keys | Elenca per ogni chiave nome, prefisso mascherato, stato, scope, limite al minuto, limite di spesa in USD e ultimo utilizzo | Non restituisce mai il segreto della chiave |
POST /portal/api/keys | Crea una chiave e la restituisce una sola volta; può impostare ip_allow, expires_at e spend_limit_usd | Una chiave creata tramite API non ha mai permessi più ampi della chiave chiamante e non riceve mai uno scope di scrittura; al massimo 20 per account per giorno UTC; una chiave con limite di spesa non può creare chiavi |
PATCH /portal/api/keys/{key_id} | Rinomina una chiave, ne modifica la nota o ne anticipa la scadenza | Solo per le chiavi create tramite API o per la chiave chiamante; le chiavi create nella console si possono solo disattivare |
POST /portal/api/keys/{key_id}/disable | Disattiva subito qualsiasi chiave dell'account | Solo il proprietario dell'account può riattivarla, nella console |
DELETE /portal/api/keys/{key_id} | Elimina definitivamente una chiave | Solo per le chiavi create tramite API o per la chiave chiamante |
GET /portal/api/keys/{key_id}/usage | Mostra successi, errori, spesa e ultima chiamata di una chiave negli ultimi giorni | Richiede requests:read |
Questi campi contano se una chiave trapela. spend_limit_usd è un tetto in USD per tutta la vita di una chiave: addebiti meno rimborsi, e non si azzera mai. Dai un tetto basso alla chiave della CI o a quella del notebook demo, e una chiave trapelata ha un limite massimo di spesa. expires_at fa smettere di funzionare da sola una chiave temporanea. ip_allow fa funzionare una chiave solo dagli indirizzi IP del tuo server.
Nello script della pagina API Keys di Serper non abbiamo trovato opzioni equivalenti. Questa sezione segue il testo dell'OpenAPI. Non abbiamo creato chiavi di test per chiamare ogni endpoint.
Documentazione dell'API di Serper: il Playground è la documentazione
Per prima cosa abbiamo cercato un sito di documentazione separato. Il 5 novembre 2026, serper.dev/docs, serper.dev/llms.txt, serper.dev/openapi.json e serper.dev/sitemap.xml restituivano tutti 404. La colonna «Product» nel footer della home page elenca Playground e Dashboard, più i link di integrazione per Haystack, Jan AI, CrewAI e LangChain. Non c'è alcun link «Docs» o «API reference».
L'organizzazione GitHub di Serper, Serper-API, ha 7 repository. GitHub li segna tutti come fork di altri progetti, come Auto-GPT, chat-ui e Perplexica. Nessuno è un SDK o una specifica API.
Quindi, in pratica, «serper api documentation» significa il Playground. È un modulo: a sinistra scegli un tipo di risultato e digiti una query, a destra ottieni risultati e codice. Abbiamo letto il suo script e raccolto sette fatti che contano quando scrivi codice per questa API.
Primo: il tipo di risultato fa parte dell'URL, non del corpo della richiesta. Lo script aggiunge il tipo scelto a https://google.serper.dev/<type> e rimuove type dal corpo prima dell'invio. Il menu comprende search, images, videos, places, news, shopping, scholar, patents, autocomplete, product-reviews, lens, maps e reviews, e alcuni tipi dipendono dall'account. Lo scraping delle pagine web usa un altro host, https://scrape.serper.dev.
Uno strumento «Resolve links» costa 0 crediti. Secondo: i parametri hanno valori predefiniti, e lo script elimina qualsiasi parametro uguale al suo valore predefinito. I valori predefiniti sono gl=us, hl=en, page=1, num=10 e autocorrect=true.
Terzo: il menu del numero di risultati per la ricerca semplice ora ha una sola scelta, 10. Images offre 10 o 100, mentre shopping usa 40. Quarto: un interruttore «Mini-batch (up to 100 queries)» inserisce un elenco di query in una sola richiesta. Quinto: i crediti. Un widget «Credits: N» mostra in tempo reale il costo della richiesta corrente.
Lo script assegna 3 crediti a maps e lens, 2 a shopping e product-reviews e 1 alla maggior parte degli altri tipi. Lo scraping delle pagine web costa 2 crediti, oppure 6 o 10 per le pagine difficili. Nelle parole dello script, «Most webpages typically incur 2 credits, but for harder-to-scrape pages ... the cost can be 6 or 10 credits». Le ricerche di immagini con più di 10 risultati costano il doppio.
Sesto: il codice di esempio. Il pannello del codice usa la libreria open source di Postman postman-code-generators. Il menu dei linguaggi deriva direttamente dalla sua chiamata getLanguageList(), con Node.js come predefinito. Puoi scegliere POST o GET.
POST invia la chiave in un header X-API-KEY. GET inserisce ogni parametro e apiKey nell'URL. Una chiave in un URL finisce nei log di accesso dei server, nella cronologia del browser e nei log dei proxy. Quindi usa POST, a meno che il tuo strumento non supporti solo GET.
Un post della community di n8n del 26 luglio 2025 mostra questa trappola. Un utente ha inviato una GET con un header e ha ricevuto un 403. La risposta spiegava che con GET la chiave va nell'URL e che è POST il metodo che legge l'header (thread della community di n8n).
Settimo: le località. Il campo della località riporta «You can find a list of supported locations here» e rimanda a api.serper.dev/locations. Abbiamo scaricato quell'elenco pubblico. Contiene 100.029 voci in 240 paesi e territori, tra cui 48.384 codici postali, 37.208 città e 4.309 quartieri. È molto più dettagliato del campo location di EveryInfra. Il nostro catalogo degli strumenti indica di usare «il nome di un paese o il codice paese di due lettere; una città vale come il suo paese».
| Regola del Playground | Dove si trova | Cosa significa per il tuo codice |
|---|---|---|
| Il tipo è nell'URL, non nel corpo | https://google.serper.dev/ + tipo | Cambia l'URL per cambiare il tipo |
| Valori predefiniti gl=us, hl=en, num=10, page=1 | Rimossi dal codice generato | Senza parametri si ottiene l'inglese degli Stati Uniti |
| Nella ricerca semplice num ha una sola scelta, 10 | Menu del numero di risultati | Usa page per avere più risultati |
| Il costo in crediti varia in base al tipo | Widget «Credits: N» | maps e lens costano 3 crediti |
| Fino a 100 query per richiesta | Interruttore Mini-batch | I crediti si contano per query |
| GET inserisce apiKey nell'URL | Selettore GET/POST nel pannello del codice | Usa POST e l'header |
| 100.029 località | api.serper.dev/locations | Fino al livello di città e codice postale |
Una documentazione che vive dentro una pagina interattiva ha un costo, e una ricerca lo ha misurato. Alle 00:18:40 e alle 00:19:06 SGT abbiamo cercato «serper api documentation» con la ricerca web di EveryInfra, con location: us, e preso le prime due pagine, cioè 20 risultati. Solo 3 URL erano su serper.dev: la home page, /api-keys (un modulo di login se non hai effettuato l'accesso) e /signup. Nessuno era una pagina di documentazione.
Otto risultati erano documentazione di altri progetti: CrewAI, LangChain (tre, di cui uno su un vecchio mirror), Langflow, Haystack, Sim e Aikeedo. Quattro erano directory di API. Gli ultimi cinque erano l'organizzazione GitHub, un post su Medium, un video su YouTube, una scheda in una directory MCP e la home page di un'altra API di ricerca.
| Fonte dei primi 20 risultati | Conteggio | Esempi |
|---|---|---|
| Pagine di serper.dev | 3 | Home, /api-keys, /signup |
| Documentazione di framework e piattaforme | 8 | docs.crewai.com, reference.langchain.com, docs.haystack.deepset.ai, docs.langflow.org |
| Directory e marketplace di API | 4 | apitracker.io, apis.io e altri |
| Altro | 5 | github.com/Serper-API, medium.com, youtube.com |
Alle 00:45:40 SGT abbiamo fatto un secondo controllo per i lettori del Regno Unito: «serper api key» con location: gb. I primi due risultati erano di nuovo la home page di Serper e /api-keys. Seguivano la home page di un'altra API di ricerca, la documentazione di CrewAI e quella di LangChain. Il resto erano un confronto su Medium, una rassegna di API per SERP, la documentazione di Aikeedo e una issue GitHub di h2oGPT.
Chi cerca la documentazione di Serper finisce il più delle volte nella documentazione di qualche framework, e ogni framework descrive Serper in modo leggermente diverso.
Gli sviluppatori che chiedono a un assistente di programmazione AI di scrivere il codice client hanno bisogno di una documentazione che l'assistente possa leggere senza effettuare l'accesso. Da parte nostra, tre file pubblici svolgono questo compito.
| File | Contenuto |
|---|---|
| Catalogo degli strumenti | Tutti i 17 strumenti di ricerca con parametri, valori predefiniti, limiti, descrizioni in tre lingue e prezzo; non serve una chiave |
| File OpenAPI | Versione 3.0.3, con 61 path al 5 novembre 2026 |
/llms.txt | Un indice per i modelli linguistici; il primo blocco indica l'URL di base, l'header e una nota sul fatto che i parametri errati tornano con did_you_mean e allowed |
Questi file permettono a un assistente di verificare i parametri prima di scrivere il codice, invece di andare a memoria. Un'ipotesi sbagliata costa un 422, come mostrano i test più avanti. Le regole sui parametri di Serper stanno nel Playground, quindi un assistente legge soprattutto documentazione di framework di seconda mano. Per esempio, la documentazione di CrewAI dice ancora che «n_results» ha come valore predefinito 10, mentre il menu della ricerca semplice del Playground ora offre solo 10.
Parametri della documentazione dell'API di Serper a confronto con EveryInfra
In breve: entrambe le API accettano un corpo JSON e restituiscono JSON. Però i nomi dei parametri, il modo di scegliere il tipo di risultato e i campi della risposta sono diversi. Non puoi passare dall'una all'altra cambiando solo l'URL. Abbiamo confrontato i parametri della ricerca semplice nello script del Playground con i parametri dello strumento web di EveryInfra. La fonte era il catalogo degli strumenti gratuito, letto alle 00:16 SGT del 5 novembre 2026.
| Parametro Serper | Significato nel Playground | Equivalente EveryInfra | Nota |
|---|---|---|---|
q | Query | q (strumento web); keyword nel catalogo dei dati | Stesso nome, stesso significato |
gl | Paese, due lettere, predefinito us | location | gl restituisce 422; location funziona a livello di paese |
hl | Lingua dell'interfaccia, predefinita en | Nessuno in web; language in web/search | hl restituisce 422 |
num | Risultati per pagina, 10 per la ricerca semplice | num, fino a 10 | Stesso nome |
page | Numero di pagina a partire da 1 | page a partire da 1, ogni pagina è un addebito | Stesso nome |
type | Segmento dell'URL: search, news, images | Campo del corpo tool: web, news, media | type nel corpo restituisce 422 |
tbs | Intervallo di tempo qdr:h/d/w/m/y | after, before (date) | Convertire in date |
location | Città, area o codice postale; 100.029 voci | location funziona per paese | Stesso nome, significato diverso |
autocorrect | Correzione ortografica, attiva per impostazione predefinita | Nessuno | Rimuovilo |
| — | — | site (un solo dominio) | Serper usa site: all'interno di q |
Due righe richiedono attenzione. La prima riguarda location. Il nome è lo stesso da entrambe le parti, ma il significato no. In Serper, location indica un luogo preciso e gl imposta il paese. In EveryInfra, location è il paese, e una città vale come il paese a cui appartiene.
Quindi, quando passi da Serper, copia il valore di gl in location ed elimina il vecchio valore di location di Serper. La seconda riguarda hl. Lo strumento web non ha un parametro per la lingua. Se ti serve, usa web/search nel catalogo dei dati. Accetta keyword, country e language e costa 0,001389 $, il doppio del prezzo di web.
Cambiano anche i tipi di risultato. Serper indica il tipo nell'URL. La ricerca di EveryInfra ha un solo endpoint, POST /api/v1/search, e il campo tool nel corpo della richiesta sceglie uno dei 17 strumenti. Abbiamo costruito questa tabella a partire dai testi del catalogo. Una corrispondenza indica solo uno scopo simile, non risultati identici.
| Tipo Serper | Tool di ricerca EveryInfra | Opzioni nel catalogo dei dati |
|---|---|---|
| search | web | web/search, bing/search, duckduckgo/search |
| news | news | google_news/search |
| images, videos | media (kind è image o video) | — |
| places, maps | places | — |
| shopping | shopping | google_shopping/search |
| scholar, patents | scholar (kind è papers o patents) | — |
| autocomplete | suggest | — |
| lens | lens | — |
| webpage | read | — |
| reviews, product-reviews | Non disponibile nella ricerca | Le recensioni di mappe e prodotti si trovano nel catalogo dei dati, per piattaforma |
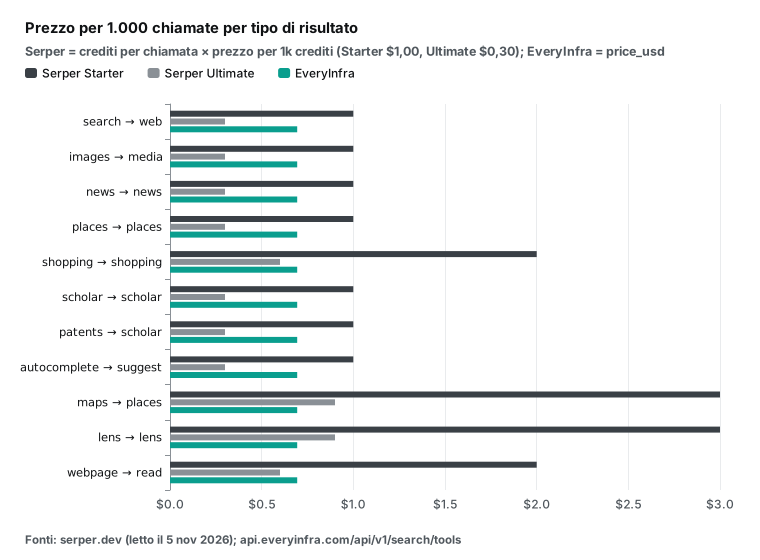
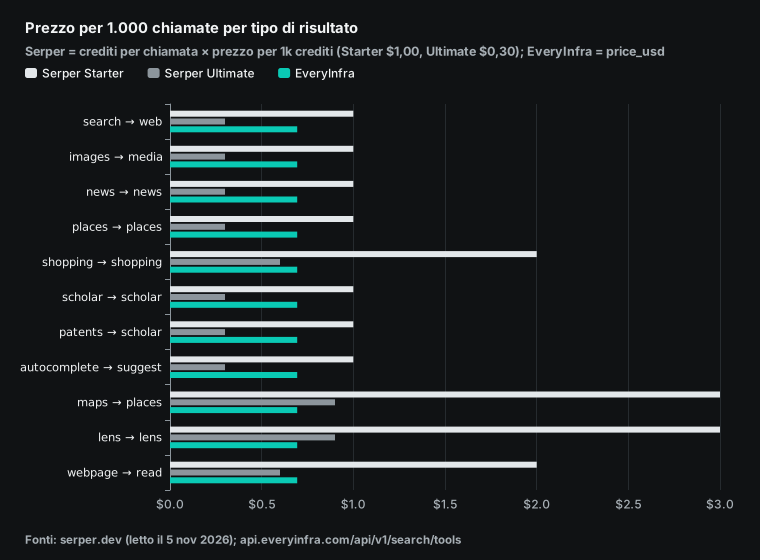
Poiché il costo in crediti dipende dal tipo, anche il prezzo di Serper per 1.000 chiamate dipende dal tipo. Con il pacchetto Starter, 1.000 crediti costano 1,00 $. Maps e lens usano 3 crediti per chiamata, quindi costano 3,00 $ per 1.000 chiamate. Con il pacchetto Ultimate, 1.000 crediti costano 0,30 $, quindi maps costa 0,90 $ per 1.000.
Tutti gli strumenti di ricerca di EveryInfra tranne crosscheck costano 0,000694 $ per chiamata. Il grafico mette a confronto, per tipo, i prezzi unitari pubblici. Per le dimensioni dei pacchetti e le regole di scadenza, leggi I prezzi dell'API di Serper spiegati.
La tua prima richiesta: curl da entrambe le parti
Ecco una prima richiesta a Serper nel formato POST del Playground. Non abbiamo una chiave Serper, quindi non l'abbiamo eseguita. L'abbiamo ricostruita dallo script della pagina e dal codice sorgente di CrewAI.
# Serper: configuration example (not run for this article)
curl -s https://google.serper.dev/search \
  -H "X-API-KEY: $SERPER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"q":"serper api documentation","gl":"us","hl":"en","num":10}'
Ecco la stessa ricerca su EveryInfra. L'abbiamo eseguita alle 00:18:40 SGT del 5 novembre 2026. Ha restituito HTTP 200 in 1,55 secondi con 10 risultati, e billing.charged_usd era 0.000694.
# EveryInfra: run for this article
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","q":"serper api documentation","location":"us","num":10}'
Cambiano quattro cose: l'URL, l'header, gl diventa location e hl sparisce. C'è un altro dettaglio facile da trascurare. La documentazione mette i parametri al primo livello del corpo, come in {"tool":"web","q":...}. Lo strumento MCP remoto everyinfra_search li mette invece dentro un oggetto params, come in {"tool":"web","params":{"q":...}}. Funzionano entrambi, ma non puoi mescolarli. La sezione MCP più avanti mostra cosa succede se lo fai.
Cambiano anche i batch. Il Mini-batch di Serper accetta fino a 100 query in una sola richiesta. L'API di ricerca di EveryInfra accetta una query per richiesta. Quindi un batch di 100 parole chiave diventa 100 richieste, inviate entro il tuo limite al minuto. Il limite predefinito dell'account è di 60 richieste al minuto, quindi 100 parole chiave richiedono circa due minuti.
Un pacchetto velocità alza il limite a 1.800 richieste al minuto (prezzi). Il costo resta lo stesso: 0,000694 $ per query, ovvero 0,0694 $ per 100. Inoltre le richieste singole falliscono una alla volta. Un parametro errato in una query restituisce un solo 422, e le altre 99 vengono comunque eseguite.
Campi della risposta: organic a confronto con results
La risposta di esempio sulla home page di Serper è un unico grande oggetto. Al primo livello contiene knowledgeGraph, organic, peopleAlsoAsk e relatedSearches. Ogni risultato organico ha title, link, snippet e position, e alcuni hanno anche sitelinks, date e attributes (esempio sulla home page di serper.dev). Il Playground rimuove searchParameters dalla risposta prima di mostrare i risultati, quindi una risposta reale riporta anche la richiesta. LangChain legge una chiave diversa per ogni tipo: organic per search, news per news, places per places e images per images (codice sorgente di LangChain).
La risposta di web di EveryInfra è {"id","tool","location","results","billing","quota"}. Ogni risultato ha title, url e snippet, più published quando la data è nota. Nella chiamata per la pagina 2 delle 00:19:06 SGT, 3 risultati su 10 avevano published. La voce del catalogo dei dati web/search restituisce più campi: title, url, text, rank, published_at, image_url e sub_links (catalogo dei dati). Nella chiamata delle 00:20:09 SGT, 3 risultati su 10 avevano published_at.
| Uso | Serper (search) | EveryInfra `web` | EveryInfra `web/search` |
|---|---|---|---|
| Titolo | organic[].title | results[].title | results[].title |
| Link | organic[].link | results[].url | results[].url |
| Snippet | organic[].snippet | results[].snippet | results[].text |
| Posizione | organic[].position | Ordine nell'array | results[].rank |
| Data | organic[].date (non sempre) | results[].published (non sempre) | results[].published_at (non sempre) |
| Knowledge panel, domande correlate | knowledgeGraph, peopleAlsoAsk | Nessuno | Nessuno |
| Costo di questa chiamata | La home page dice che i crediti vengono scalati per ogni risposta riuscita; nessun campo della risposta documentato | billing.charged_usd | billing.charged_usd |
L'ultima riga riguarda i record di addebito. Le FAQ di Serper dicono: «Ogni volta che ricevi risposte riuscite alle query, scaliamo i crediti dal saldo del tuo account». Quando il saldo arriva a zero, le nuove query si fermano. Per vedere quanto hai speso, apri la Dashboard e gli Activity logs. Ogni risposta di EveryInfra contiene un oggetto billing con charged, charged_usd e balance_after_usd.
Un job batch può riconciliare la spesa basandosi solo sulle risposte. Le chiamate fallite e quelle vuote mostrano charged: false. Lo strumento web non restituisce knowledge panel né domande correlate. Il codice che dipende da quei campi ha bisogno di una nuova logica, come spiega la sezione «Quando Serper è la scelta migliore».
Test 1: una richiesta in stile Serper inviata così com'è
L'errore più probabile dopo il passaggio è cambiare URL e header ma tenere i vecchi parametri. Abbiamo commesso questo errore di proposito per vedere come reagisce l'API.
Alle 00:18:28 SGT abbiamo inviato {"tool":"web","q":"serper api documentation","gl":"us","hl":"en","num":10}. L'API ha restituito HTTP 422 in 0,20 secondi. error.code era unknown_param. Il message diceva «gl is not a parameter of tool web Supported: after, before, location, num, page, q, site».
La lista allowed conteneva i 7 parametri validi. Il campo next_steps diceva «Remove gl; the parameters are listed at catalog_url. Nothing was charged.» L'API segnala un solo parametro sconosciuto per chiamata. Abbiamo rimosso gl, lasciato hl e inviato di nuovo la richiesta alle 00:18:47 SGT, ed è tornato lo stesso 422 con param: hl.
Alle 00:19:00 SGT abbiamo scritto location come locaton. Il 422 è tornato in 0,11 secondi con did_you_mean: ["location"]. Il primo passo successivo diceva «Rename locaton to location (did_you_mean), then resend. Nothing was charged.» Il secondo suggeriva di aprire un ticket se il catalogo elenca effettivamente il parametro inviato.
Alle 00:19:14 SGT abbiamo messo "type":"news" nel corpo, e la richiesta ha restituito 422 perché type non è un parametro di web. Alle 00:19:20 SGT abbiamo inviato kind: "videos" allo strumento media. L'errore era invalid_value, con allowed impostato su image e video e did_you_mean impostato su video.
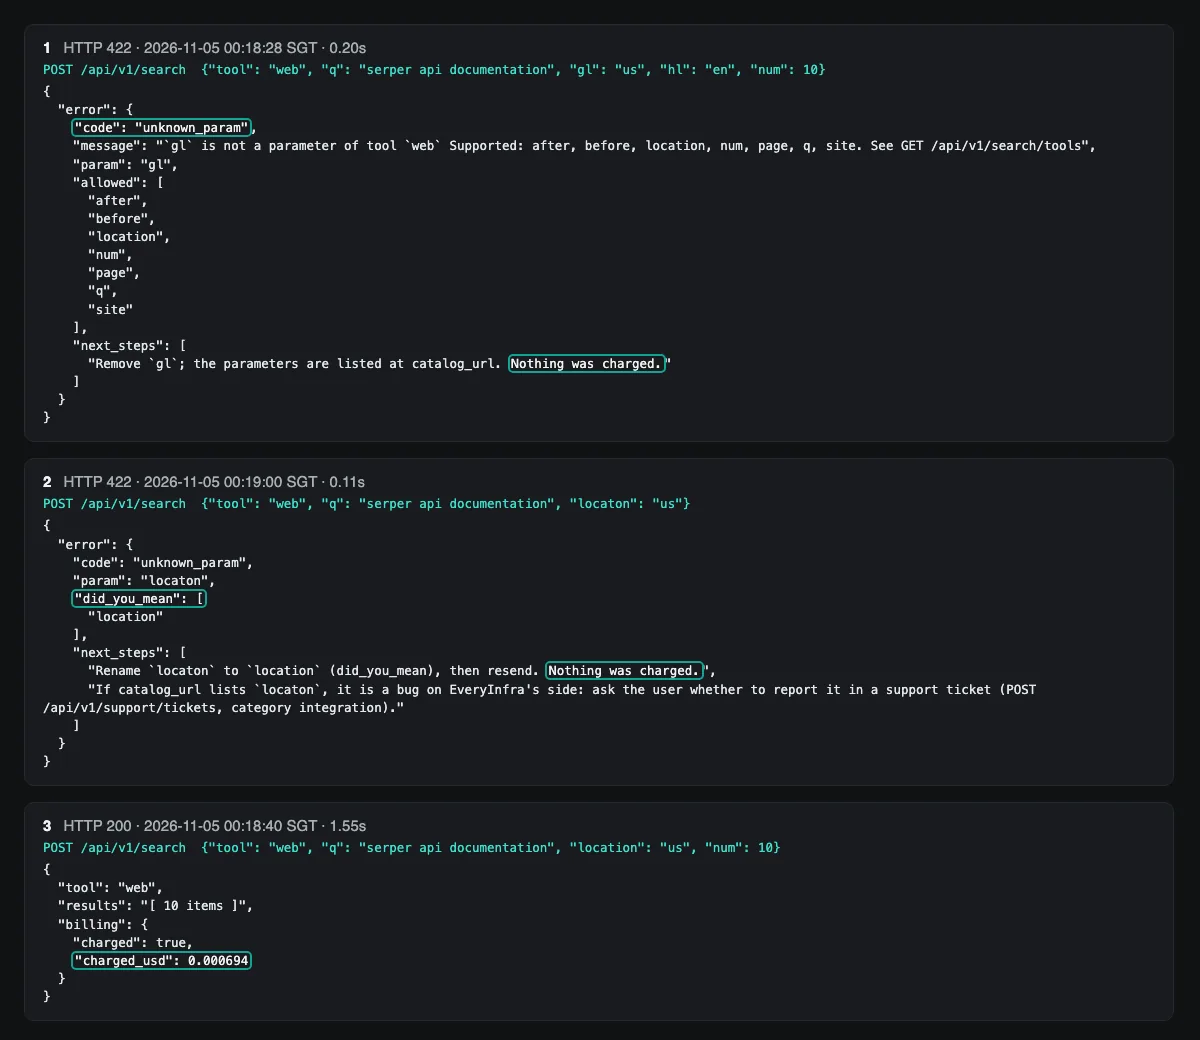
Questi errori esistono perché un assistente AI possa correggere da solo la propria chiamata. Un 422 dice a un programma che un nuovo tentativo non servirà, mentre allowed e did_you_mean dicono a un assistente cosa cambiare. HTTP definisce il 422 per una richiesta che il server comprende ma non può elaborare (MDN: 422, definito nella RFC 9110, sezione 15.5.21). È il caso di un nome o di un valore sbagliato. Il nostro corpo di errore non usa il formato problem+json della RFC 9457. È un nostro oggetto error, e la guida agli errori API autocorrettivi ne spiega ogni campo.
Test 2: chiave assente, header sbagliato e limiti di frequenza delle richieste
Alle 00:18:21 SGT abbiamo chiamato web senza header di autenticazione. L'API ha restituito HTTP 401 in 0,12 secondi con code: unauthorized e message: Missing API key. Il fault era account, retryable era false e next_steps diceva «This API key is not accepted; ask the user for a working key (console: API keys). Nothing was charged.» Alle 00:18:34 SGT abbiamo messo una chiave valida in un header X-API-KEY, nello stile di Serper. Il risultato è stato lo stesso 401 con lo stesso messaggio.
Su questo secondo risultato dobbiamo essere onesti. L'errore non dice «usa invece Authorization: Bearer». Se arrivi da Serper, cambia tu la riga dell'header, come mostra la tabella sopra.
Per Serper non abbiamo una chiave, quindi citiamo post pubblici. Il thread di n8n citato sopra mostra HTTP 403 con il corpo {"message":"Unauthorized. Sign up for a free account.","statusCode":403}. La issue #633 di CrewAI, del 2024, si intitola «Unauthorized Error (403) when Using SERPER_API_KEY».
La causa era una chiave di un altro servizio. Per il saldo esaurito, una nota di commit del 23 ottobre 2026 riporta 400 {"message":"Not enough credits"} (neo1415/q #339). Una lista di attività del 22 ottobre 2026 indica «400 or 403» e lo segna come non confermato (dbhq-uk/gannet #12). Su serper.dev non abbiamo trovato una tabella dei codici di errore.
I limiti di frequenza delle richieste sono emersi da soli. La nostra chiave di test ha un tetto proprio di 10 chiamate al minuto, condiviso da diversi job di scrittura. Abbiamo ricevuto HTTP 429 quattro volte, alle 00:19:55, 00:20:56, 00:22:38 e 00:24:51 SGT. Ognuno aveva code: rate_limited, un retry_after rispettivamente di 5, 4, 22 e 9 secondi, max_retries: 3 e la nota «Nothing was charged.
Retry after retry_after seconds». Il nostro script attendeva 60 secondi dopo ogni 429, e ogni tentativo successivo è andato a buon fine. Consulta MDN su Retry-After per l'header e la RFC 6585 per il codice 429.
| Caso | Serper (post pubblici) | EveryInfra (i nostri test) | Addebito |
|---|---|---|---|
| Chiave assente o errata | 403 Unauthorized. Sign up for a free account. | 401 unauthorized, Missing API key | Assente in entrambi i casi |
| Header sbagliato | Con GET la chiave va nell'URL | X-API-KEY restituisce 401 | Nessuno |
| Saldo esaurito | 400 Not enough credits (segnalazione di terze parti) | 402 quota_exhausted (documentazione) | Nessuno |
| Parametro sconosciuto | Non documentato | 422 unknown_param con allowed e did_you_mean | Nessuno |
| Valore non valido | Non documentato | 422 invalid_value con allowed | Nessuno |
| Limite di frequenza delle richieste | Da 50 a 300 query al secondo a seconda del pacchetto (home page) | 429 rate_limited con retry_after | Nessuno |
| Risultato vuoto | La home page dice che costano crediti solo le risposte riuscite | 200, charged: false, reason: empty_result_refunded | Nessuno |
Per la riga dei risultati vuoti, alle 00:20:17 SGT abbiamo cercato una stringa tra virgolette che non esiste. L'API ha restituito HTTP 200 con un array results vuoto, billing.charged: false, reason: empty_result_refunded e refund.status: succeeded. Per riconciliare nei tuoi record le chiamate fallite e quelle vuote, consulta la guida alla riconciliazione dei rimborsi per errori.
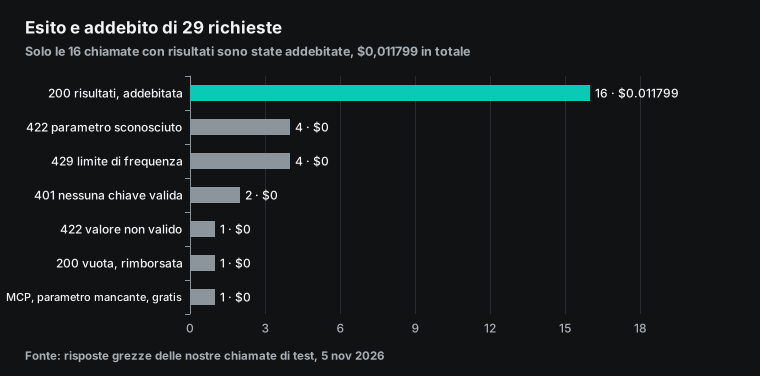
Test 3: una query in dieci paesi
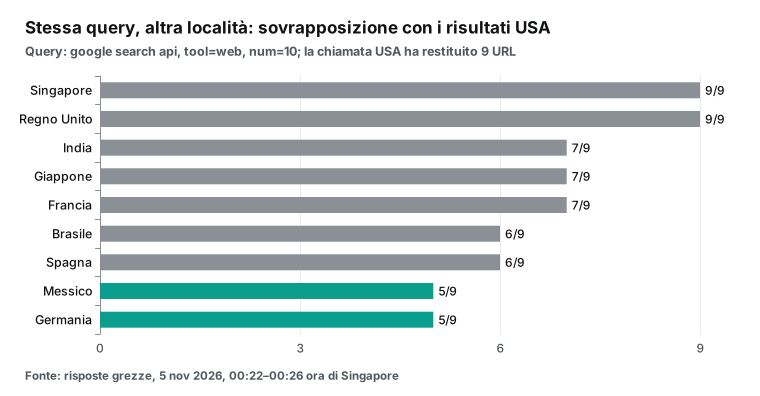
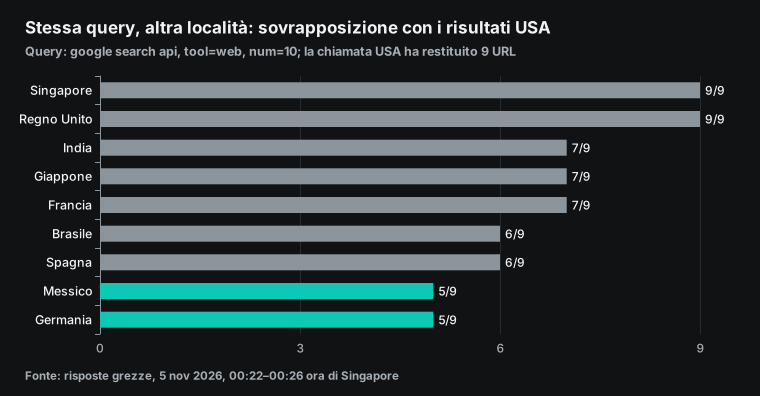
location funziona dopo che ci hai spostato il valore di gl? Dalle 00:22 alle 00:26 SGT abbiamo inviato la stessa query, «google search api», a web con num impostato a 10. I valori di location erano us, gb, de, fr, es, mx, br, jp, sg e in. Tutte e dieci le chiamate hanno restituito HTTP 200 e sono costate 0,000694 $ ciascuna, 0,00694 $ in totale. La chiamata per gli USA ha restituito 9 risultati, tutte le altre 10.
Abbiamo usato i 9 URL degli USA come base e contato quanti ne comparivano in ciascun altro paese. Singapore e il Regno Unito li hanno mantenuti tutti e 9. India, Giappone e Francia ne hanno mantenuti 7. Brasile e Spagna 6. Messico e Germania solo 5.
La Germania ha aggiunto un sito personale su un dominio .de e un video di YouTube. Il Giappone ha aggiunto qiita.com e il Messico rapidapi.com. Quindi il parametro del paese cambia i risultati. I mercati anglofoni restano vicini all'elenco degli USA, mentre gli altri se ne allontanano di più, come ci si aspetta da un ranking regionale.
Questo test mostra anche un limite. Abbiamo testato solo a livello di paese, perché location di EveryInfra si ferma al paese. Serper arriva fino alla città e al codice postale. Se ti servono «risultati locali per un singolo codice ZIP di New York», lo strumento web di EveryInfra non può fornirli.
Anche il campione è piccolo: una query, una chiamata per paese. Le posizioni cambiano nel tempo. I dati di sovrapposizione dimostrano che il parametro funziona. Non misurano le differenze di lungo periodo tra paesi.
Test 4: latenza e velocità di risposta degli errori
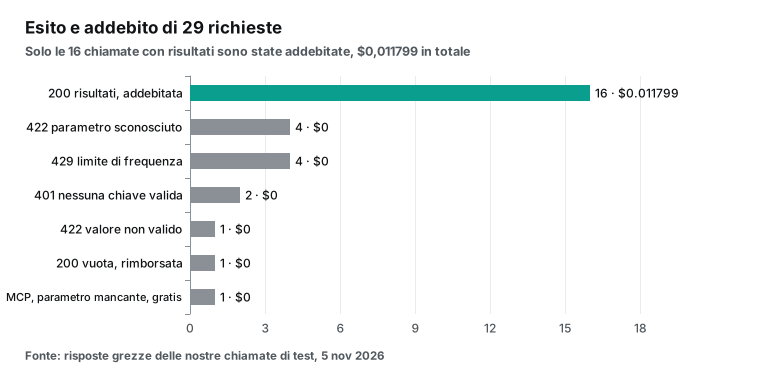
Abbiamo suddiviso tutte le 34 richieste per esito e misurato il tempo totale di curl da Singapore, rete inclusa. Le 21 richieste a pagamento hanno richiesto da 0,98 a 3,48 secondi, con una mediana di 1,81 secondi. La più veloce è stata suggest, con 0,98 secondi. La più lenta è stata la chiamata web per il Regno Unito delle 00:45:40 SGT, con 3,48 secondi. Il risultato vuoto ha richiesto 2,12 secondi, perché la ricerca è stata comunque eseguita.
Le 11 richieste rifiutate (401, 422 e 429) sono tornate in un tempo tra 0,09 e 0,20 secondi. Si sono fermate al controllo dell'autenticazione o dei parametri e non hanno mai avviato la ricerca. La home page di Serper dice «In genere, tutte le query vengono restituite in 1-2 secondi». Non abbiamo testato Serper, quindi non facciamo affermazioni sulla sua velocità.
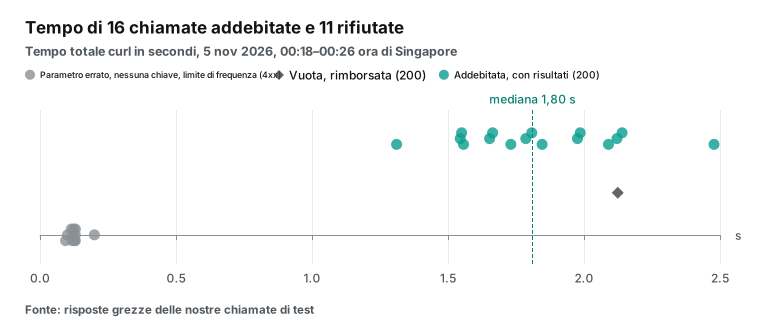
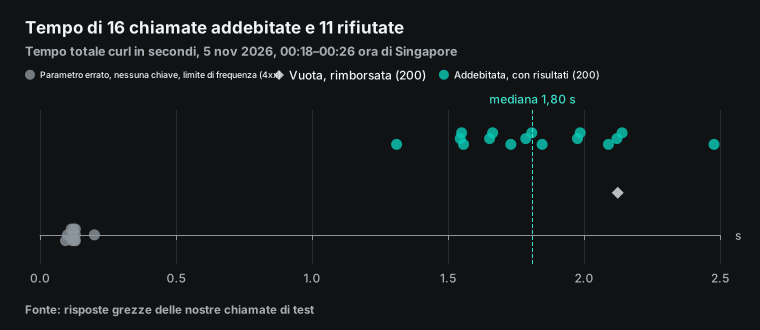
Il grafico copre le prime 29 richieste. Per l'edizione inglese di questo articolo abbiamo effettuato altre cinque chiamate. Includendole, la mediana di tutte le 21 chiamate a pagamento è di 1,81 secondi.
| Orario (SGT) | Chiamata | Risultati | Secondi | Addebito |
|---|---|---|---|---|
| 00:45:32 | suggest, «serper api docs» | 8 | 0.98 | $0.000694 |
| 00:45:40 | web, «serper api key», location: gb | 10 | 3.48 | $0.000694 |
| 00:45:51 | web, «SERPER_API_KEY», site: github.com | 10 | 2.67 | $0.000694 |
| 00:47:57 | web, costruita da un corpo Serper con la funzione Python riportata sotto | 10 | 2.24 | $0.000694 |
| 00:53:26 | suggest, «serper api login» | 9 | 1.15 | $0.000694 |
Gli errori rapidi aiutano chi scrive il codice. Un parametro sbagliato non costa due secondi di attesa. Un 422 con la correzione arriva in un decimo di secondo, quindi un assistente può correggere e inviare di nuovo la richiesta in un solo turno. Vale anche il contrario. Un programma che ritenta ogni risposta diversa da 200 come se fosse «servizio occupato» spreca tentativi sui 422. Ritenta solo gli errori con retryable: true, come 429 e 503.
Test 5: suggerimenti, notizie e la voce del catalogo dei dati
I tipi autocomplete e news di Serper corrispondono agli strumenti suggest e news di EveryInfra. Alle 00:20:01 SGT, suggest per «serper api key» ha restituito 10 righe. Ogni riga ha solo un title, come «serper api key free», «serper api key pricing», «serper api key crewai» e «get serper api key». La chiamata è costata 0,000694 $.
Alle 00:21:28 SGT, news per «Model Context Protocol» ha restituito 10 risultati, ciascuno con published. I valori erano relativi, come «17 hours ago» e «2 days ago». Per ordinarli per data in un database, convertili rispetto all'orario della richiesta. In alternativa usa google_news/search nel catalogo dei dati, che restituisce published_at in UTC ISO 8601 per 0,000792 $.
Alle 00:20:09 SGT abbiamo provato la voce del catalogo dei dati web/search per «serper api key», con keyword, country: us e language: en. Ha restituito 10 risultati per 0,001389 $. Questa voce ti permette di impostare la lingua dei risultati. I suoi campi sono text e rank, con la stessa struttura dei risultati di ricerca delle altre piattaforme del catalogo. È utile se salvi i risultati web accanto ai dati di altre piattaforme. Se ti servono solo risultati web e non devi impostare la lingua, lo strumento web costa la metà.
I primi tre risultati di web/search erano la home page di Serper, la home page di un'altra API di ricerca e serper.dev/api-keys. Il settimo era un post della community di Clay su come trovare la chiave nella dashboard di Serper. Non abbiamo eseguito la stessa query con web, quindi non confrontiamo l'ordine dei risultati. Non aspettarti che le due voci restituiscano lo stesso elenco.
Impostare la chiave in Python: i nomi delle variabili cambiano
Tieni la chiave in una variabile d'ambiente, non nel codice. Lo raccomandano sia The Twelve-Factor App sia l'OWASP Secrets Management Cheat Sheet. In locale, python-dotenv legge un file .env, che va elencato in .gitignore. Il problema è che Serper non ha un SDK proprio, quindi ogni framework sceglie il proprio nome di variabile. Abbiamo letto il codice sorgente e la documentazione attuali di quattro framework.
| Framework | Nome della variabile per Serper | Fonte |
|---|---|---|
LangChain (GoogleSerperAPIWrapper) | SERPER_API_KEY | Riferimento di LangChain |
CrewAI (SerperDevTool) | SERPER_API_KEY | Documentazione di CrewAI |
Haystack (SerperDevWebSearch) | SERPERDEV_API_KEY | Codice sorgente di Haystack, documentazione |
| LiteLLM (ricerca) | SERPER_API_KEY | Documentazione di LiteLLM |
Haystack aggiunge «DEV» al nome. Se sulla stessa macchina usi sia LangChain sia Haystack, imposta due variabili, oppure scrivi Secret.from_env_var("SERPER_API_KEY") in Haystack. Cambiano anche i nomi dei parametri. SerperDevTool di CrewAI usa country, locale e n_results, e il suo codice sorgente li mappa su gl, hl e num. Supporta solo i tipi search e news.
Abbiamo letto il branch main il giorno dopo la release 1.15.35 del 3 novembre 2026. LangChain usa k, gl, hl e type. Haystack usa top_k e search_params. Quindi per ogni framework che colleghi devi imparare nomi di variabili e parametri diversi.
In Python EveryInfra non richiede pacchetti specifici. Basta Requests. Se nel tuo codice hai già corpi delle richieste in stile Serper, una piccola funzione può convertirli in corpi per EveryInfra. Abbiamo eseguito la funzione qui sotto alle 00:47 SGT del 5 novembre 2026.
L'input era {"q": "serper api key rotate", "gl": "gb", "hl": "en", "num": 10, "tbs": "qdr:y", "autocorrect": true}. L'output era {"tool": "web", "q": "serper api key rotate", "location": "gb", "num": 10, "page": 1, "after": "2025-11-04"}. La chiamata ha restituito HTTP 200 con 10 risultati in 2,24 secondi per 0,000694 $. Tutti i 10 risultati avevano una data published successiva al 4 novembre 2025, quindi il filtro after ha funzionato.
import datetime as dt, os, requests

URL = "https://api.everyinfra.com/api/v1/search"
TYPE_TO_TOOL = {"search": "web", "news": "news", "images": "media", "videos": "media",
                "places": "places", "maps": "places", "shopping": "shopping",
                "scholar": "scholar", "patents": "scholar", "autocomplete": "suggest",
                "lens": "lens", "webpage": "read"}
TBS_DAYS = {"qdr:h": 1, "qdr:d": 1, "qdr:w": 7, "qdr:m": 31, "qdr:y": 366}

def from_serper(serper_type, body, today=None):
    """Turn a Serper-style request into an EveryInfra search body."""
    tool = TYPE_TO_TOOL[serper_type]
    out = {"tool": tool, "q": body["q"]}
    if tool == "web":
        if "gl" in body:
            out["location"] = body["gl"]          # country code moves to location
        out["num"] = min(int(body.get("num", 10)), 10)
        out["page"] = int(body.get("page", 1))
        if body.get("tbs") in TBS_DAYS:
            today = today or dt.date.today()
            out["after"] = (today - dt.timedelta(days=TBS_DAYS[body["tbs"]])).isoformat()
    # hl, autocorrect and Serper's city-level location have no web-tool match: dropped
    return out

body = from_serper("search", {"q": "serper api key rotate", "gl": "gb", "hl": "en",
                              "num": 10, "tbs": "qdr:y", "autocorrect": True})
r = requests.post(URL, json=body, timeout=90,
                  headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
data = r.json()
if r.status_code != 200 and not data["error"].get("retryable"):
    raise ValueError(data["error"]["next_steps"])   # 401 and 422: fix, do not retry
print(len(data.get("results", [])), data.get("billing", {}).get("charged_usd"))
La funzione mappa in dettaglio solo il percorso web. Per media e scholar, aggiungi tu kind e controlla prima il catalogo. La riga qdr:h viene arrotondata a un giorno, perché after accetta una data.
Impostare la chiave in n8n: HTTP Request e MCP Client Tool
n8n non ha un nodo Serper integrato. La pagina dell'integrazione Serper su n8n.io restituiva 404 il 5 novembre 2026. Si usa il nodo HTTP Request generico. Inserisci la chiave in una credenziale Header Auth con nome X-API-KEY (credenziali di HTTP Request in n8n).
Imposta il metodo su POST. Il thread sul 403 citato sopra nasceva da una richiesta GET. Le impostazioni qui sotto seguono la documentazione di n8n come l'abbiamo letta il 5 novembre 2026.
Puoi collegare EveryInfra in due modi. Il primo è lo stesso nodo HTTP Request. Imposta il nome di Header Auth su Authorization e il valore su Bearer , uno spazio e la tua chiave. Imposta l'URL su https://api.everyinfra.com/api/v1/search e copia il corpo dall'esempio curl.
Il secondo modo è il nodo MCP Client Tool in un workflow AI Agent. Imposta l'endpoint su https://api.everyinfra.com/mcp, scegli l'autenticazione Bearer e salva la chiave in una credenziale. L'agente elenca quindi strumenti come everyinfra_search e decide quando chiamarli.
Per questo articolo non abbiamo eseguito n8n, quindi considera entrambe le configurazioni come esempi tratti dalla documentazione di n8n. Per un workflow completo che gira ogni mattina, consulta la guida al report giornaliero con n8n.
Impostare la chiave nei client MCP: remoto a confronto con locale
Serper non gestisce un server MCP. Su GitHub esistono server della community, come marcopesani/mcp-server-serper (licenza MIT, 171 stelle, ultimo push il 13 marzo 2025) e garylab/serper-mcp-server (39 stelle, ultimo push il 10 novembre 2025). Entrambi avviano un processo locale sul tuo computer con npx o uvx. La chiave va nel blocco env del file di configurazione del client come SERPER_API_KEY. Quindi la chiave resta in chiaro in un file di configurazione su ogni macchina che esegue il client.
EveryInfra gestisce un server MCP remoto su https://api.everyinfra.com/mcp. Usa il trasporto HTTP della specifica MCP, versione 2026-07-28, e la chiave va nell'header Authorization. In Claude Code basta un comando per aggiungerlo (documentazione MCP di Claude Code). Per gli altri client, consulta la pagina di configurazione MCP e la guida alla configurazione dell'MCP remoto.
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
Puoi elencare gli strumenti senza chiave. Verso le 00:21 SGT abbiamo chiamato tools/list senza chiave e abbiamo ottenuto 12 strumenti. L'input di everyinfra_search è tool, uno dei 17, più un oggetto params. Alle 00:21:40 SGT abbiamo messo di proposito q fuori da params.
La risposta è stata HTTP 200 con isError: true e il testo «missing_param: q is required» e «Next steps: Add the required q. Nothing was charged.» Alle 00:21:58 SGT abbiamo inviato {"tool":"web","params":{"q":"serper api login","location":"us","num":5}}. La chiamata ha restituito 5 risultati, il primo era serper.dev/api-keys con il titolo «Log in to your account», e charged_usd era 0.000694, come in una chiamata API diretta.
La specifica MCP ha una sezione sull'autorizzazione per i server remoti, che raccomanda OAuth. Oggi usiamo una chiave Bearer statica. Qualsiasi client può inviarla, ma la chiave devi proteggerla tu, ed è l'argomento della prossima sezione. Per scegliere il tipo di strumento di ricerca per un agente AI, consulta come scegliere gli strumenti di ricerca per gli agenti.
La tua chiave è trapelata: come sostituirla su ciascun servizio
Partiamo da un caso reale recente. Il report sull'incidente di LiteLLM del 23 ottobre 2026 racconta questa storia. Il 27 maggio 2026 qualcuno ha fatto il commit di un file di configurazione con una chiave di amministrazione interna in un repo pubblico. Il file è stato rimosso circa tre ore dopo, e la chiave è finita in un elenco «da revocare».
Il commit è rimasto nella cronologia pubblica fino al 22 ottobre e, per un errore umano, la revoca non è mai avvenuta. Il 10 ottobre 2026 un attaccante ha usato quella chiave vecchia di quattro mesi, che funzionava ancora. Da lì è arrivato al token di un owner di un'organizzazione GitHub. Il 21 ottobre la pipeline di release di LiteLLM ha pubblicato una versione 1.107.0 compromessa (report sull'incidente di LiteLLM).
| Data (2026) | Cosa è successo |
|---|---|
| 27 maggio | Un file di configurazione con una chiave di amministrazione finisce in un repo pubblico |
| 27 maggio, circa 3 ore dopo | Il file viene rimosso; la chiave finisce in un elenco «da revocare» |
| Dal 27 maggio al 22 ottobre | Il commit resta nella cronologia pubblica; la chiave non viene mai revocata |
| 10 ottobre | Un attaccante usa la vecchia chiave, che funziona ancora |
| 21 ottobre | Viene pubblicata una release 1.107.0 compromessa |
Il report individua la lezione nel «non aver ruotato una chiave potenzialmente esposta». Lo stesso giorno Railway ha dichiarato che una terza parte potrebbe aver avuto accesso ai sistemi che conservano le variabili d'ambiente dei clienti. Ha chiesto a tutti gli utenti di rigenerare ogni variabile d'ambiente salvata in Railway, chiavi API comprese (comunicazione di Railway, 21 ottobre 2026). La regola è semplice.
Eliminare una chiave dal codice non la disattiva. Devi invalidare la vecchia chiave presso il servizio. Ecco come fare su ciascuno dei due.
Su Serper, accedi e apri API Keys. Trova la chiave trapelata e fai clic su «Reset». Dopo la conferma, la vecchia chiave smette subito di funzionare e la pagina mostra una nuova chiave. Sostituisci la chiave in ogni punto in cui la usavi.
Se una chiave serviva più punti, si interrompono tutti insieme, perché non puoi bloccarne uno solo. Poi apri gli Activity logs, filtra per quella chiave e cerca query che non riconosci. Se hai attivato «Anonymize queries», il log mostra conteggi e crediti ma non il testo delle query.
Su EveryInfra, disattiva la chiave trapelata nella console. Da quel momento le chiamate con quella chiave restituiscono 401. Puoi farlo anche da script. Una chiave con lo scope keys:write può chiamare POST /portal/api/keys/{key_id}/disable. Dopodiché, solo il proprietario dell'account può riattivare la chiave nella console. Crea una nuova chiave per sostituirla. Se hai creato una chiave per ogni ambiente, gli altri ambienti continuano a funzionare.
Rotazione, scope e IP allowlist si possono modificare solo nella console, quindi una chiave non può cambiare le proprie impostazioni (guida rapida, sezione sull'autenticazione). Poi controlla la cronologia delle chiamate per individuare richieste e spesa durante la fuga. Anche GET /api/v1/account mostra l'utilizzo delle ultime 24 ore, e non costa nulla.
Puoi anche prepararti a una fuga prima che accada. Suddividi le chiavi così:
| Dove viene usata la chiave | Impostazioni da usare |
|---|---|
| Server di produzione | Una chiave dedicata, con una IP allowlist per gli indirizzi del server |
| CI | Una chiave dedicata, con un limite di spesa basso in USD |
| Notebook demo o test condiviso | Una chiave dedicata, con un limite di spesa basso e una data di scadenza |
Così, se trapela una qualsiasi chiave, disattivi solo quella. Le altre continuano a funzionare, e la perdita resta entro il limite di quella chiave.
Nessun altro si accorgerà della fuga al posto tuo. Il secret scanning di GitHub trova nei repo le chiavi con formati noti e avvisa i servizi partner perché possano revocarle. Il 5 novembre 2026 abbiamo contato le voci del suo elenco dei pattern supportati: 207 provider, e né Serper né EveryInfra sono tra questi. La release v3.99.8 di TruffleHog del 2 novembre 2026 ha detector per altri tre servizi SERP, ma nessuno per Serper. Non ne hanno nemmeno le regole predefinite di Gitleaks.
Il 13 ottobre 2026 GitHub ha aggiunto due tipi di chiavi Anthropic alla push protection predefinita (changelog di GitHub). Il 28 ottobre 2026 ha aggiunto una push protection basata sull'AI che valuta il contesto invece di formati fissi. Questa funzionalità è disattivata per impostazione predefinita (changelog di GitHub). Finché uno scanner non riconosce il formato della tua chiave, gli utenti di GitHub Advanced Security possono scrivere dei custom pattern appositi.
Il codice pubblico mostra quanto spesso circola il nome della variabile. Alle 00:45:51 SGT abbiamo cercato «SERPER_API_KEY» con site: github.com. Tutti i 10 risultati erano pagine pubbliche di GitHub. Tra questi c'erano la issue di CrewAI sul 403, una issue di h2oGPT intitolata «configure the serper api key?» e due server MCP della community.
C'erano anche il README di un blueprint di NVIDIA e una richiesta di funzionalità per Hermes Agent del 21 luglio 2026. Un nome di variabile nel codice pubblico è normale e sicuro. Il rischio inizia quando il valore si trova accanto al nome in un file .env finito in un commit, e nessuno scanner predefinito segnala quel valore.
| Passaggio dopo una fuga | Serper | EveryInfra |
|---|---|---|
| Disattivare la vecchia chiave | API Keys → Reset, immediato | Disattivazione nella console; le chiamate restituiscono 401 |
| Bloccare un punto e mantenere gli altri | No, si reimposta l'intera chiave | Sì, con una chiave per ambiente |
| Limitare i danni | Nessun limite per chiave né impostazioni IP | Scope per prodotto, IP allowlist, limite di spesa in USD per chiave, scadenza |
| Controllare le chiamate durante la fuga | Activity logs filtrati per chiave | Cronologia delle chiamate nella console, /api/v1/account |
| Rilevamento automatico nei repo pubblici | Assente dalle regole predefinite di GitHub, TruffleHog e Gitleaks | Assente anche qui |
Quando Serper è la scelta migliore
Ecco i casi in cui Serper è più adatto di EveryInfra.
Primo, i risultati di ricerca locali per città, quartiere o codice postale. L'elenco delle località di Serper conta 100.029 voci, fino al livello del codice postale, mentre location di EveryInfra si ferma al paese. Per il monitoraggio del ranking SEO locale o per verificare i risultati città per città, Serper è lo strumento giusto. Secondo, i moduli della pagina dei risultati come knowledge panel, «People also ask» e ricerche correlate. Serper restituisce knowledgeGraph, peopleAlsoAsk e relatedSearches come campi.
Lo strumento web di EveryInfra restituisce solo titolo, link, snippet e data. Terzo, il throughput elevato. I pacchetti di Serper consentono da 50 a 300 query al secondo. Un account EveryInfra consente 60 richieste al minuto per impostazione predefinita e fino a 1.800 al minuto con un pacchetto velocità (prezzi). Per centinaia di richieste in un secondo, Serper è molto più potente.
Quarto, le recensioni di mappe e prodotti. Serper offre reviews, product-reviews e maps come tipi di ricerca. La ricerca di EveryInfra non ha strumenti di questo tipo, quindi devi trovare la funzionalità corrispondente nel catalogo dei dati per ogni piattaforma, il che richiede più configurazione. Quinto, le richieste batch fino a 100 query ciascuna.
Il Mini-batch di Serper le supporta, mentre la ricerca di EveryInfra accetta una query per chiamata. Sesto, una codebase ampia già costruita sui campi di Serper e che ha bisogno solo di risultati in inglese per gli USA. In quel caso le modifiche al codice potrebbero costare più di quanto risparmi, quindi aspetta. Valuta il passaggio quando aggiungi la ricerca a un agente AI o quando vuoi un'unica chiave per dati, ricerca e altre funzionalità.
Limiti: quando questi risultati non valgono
Primo, le nostre affermazioni sulla dashboard di Serper dopo l'accesso derivano dal testo degli script della pagina, non da schermate che abbiamo visto. Abbiamo escluso le funzionalità presenti nello script ma non visibili, come i tipi utilizzabili solo dagli account dello staff. Inoltre non possiamo vedere le funzionalità lato server che lo script non menziona. Secondo, i corpi di errore di Serper provengono da post di terze parti datati tra luglio 2025 e ottobre 2026, e potrebbero essere cambiati. Terzo, abbiamo descritto i passaggi di EveryInfra dopo la registrazione e le funzionalità delle chiavi basandoci sulla pagina, sulla documentazione, sulla pagina dei prezzi e sul file OpenAPI. Non abbiamo creato un nuovo account e non abbiamo usato una chiave con scope limitati per vedere il 403.
Quarto, le nostre 34 chiamate hanno usato una chiave di test con un tetto di 10 chiamate al minuto, a differenza di un account normale. Quinto, i test su località e latenza sono campioni singoli da Singapore. Sesto, non confrontiamo la qualità né la copertura dei risultati.
FAQ
Come configuro la chiave API di Serper nella mia app?
Impostala come variabile d'ambiente, poi verifica quale nome legge il tuo framework. LangChain, CrewAI e LiteLLM leggono SERPER_API_KEY. Haystack legge SERPERDEV_API_KEY. Una issue di h2oGPT intitolata «configure the serper api key?» (h2oai/h2ogpt #914) mostra l'errore tipico.
L'utente aveva incollato la chiave dove il codice si aspettava un nome di variabile. L'app continuava a non funzionare, con un errore di validazione che chiedeva una chiave diversa.
Il piano gratuito di Serper offre 2.500 query al mese?
La home page di Serper dice «Get 2,500 free queries» e non specifica «al mese». Una richiesta di funzionalità per Hermes Agent del 21 luglio 2026 parla di «2,500 free queries/month» (NousResearch/hermes-agent #68615). Controlla la dashboard dopo la registrazione e non contare su un azzeramento mensile. I termini vietano inoltre di avere più di un account alla volta. Per sapere quanto durano 2.500 query, consulta Il piano gratuito dell'API di Serper.
Perché CrewAI restituisce 403 Unauthorized con la mia chiave Serper?
Prima di tutto, verifica che la chiave provenga da serper.dev. Nella issue #633 di CrewAI, l'utente aveva una chiave di un altro servizio. Poi verifica che il nome della variabile sia SERPER_API_KEY, che il codice sorgente di CrewAI legge direttamente, e che la richiesta usi POST. Se il corpo dice «Unauthorized. Sign up for a free account.», la chiave è errata o mancante. Consulta la issue #633 di CrewAI.
Esiste un riferimento completo dell'API di Serper?
Il 5 novembre 2026 non ne abbiamo trovato nessuno. serper.dev/docs, /llms.txt e /openapi.json restituivano 404, e l'organizzazione GitHub non ha un SDK. Parametri, tipi e costi in crediti si trovano nel Playground, che genera anche il codice di esempio. La documentazione di CrewAI, LangChain, Haystack, LiteLLM e Langflow ne copre ciascuna una parte.
Posso usare Google o GitHub per accedere a Serper?
Negli script di registrazione e di accesso non abbiamo trovato login di terze parti. L'accesso a Serper avviene con email e password, con autenticazione a due fattori facoltativa. EveryInfra accetta email, GitHub o Google.
Per iniziare: dalla chiave al primo risultato
Per provarlo, registrati su everyinfra.com. Metti una stella ai due repo GitHub e richiedi nella console il credito di prova di 1 $, valido per 24 ore. Crea una chiave in API Keys, invia la richiesta curl riportata sopra e leggi billing.charged_usd nella risposta. Per consultare i parametri gratuitamente, apri il catalogo degli strumenti di ricerca. Per le funzionalità di ricerca nel catalogo dei dati, consulta la pagina della piattaforma di dati web, Bing, DuckDuckGo, Google News e Google Shopping. Per provare una chiamata con un clic nella console, usa l'Infra Marketplace.
Se passi da Serper, modifica questi elementi in quest'ordine. L'ultima riga non è una modifica: serve a testare la gestione degli errori.
| Passaggio | Serper | EveryInfra |
|---|---|---|
| 1. URL | https://google.serper.dev/<type> | https://api.everyinfra.com/api/v1/search |
| 2. Header | X-API-KEY | Authorization: Bearer |
| 3. Tipo di risultato | Segmento dell'URL | Campo tool nel corpo della richiesta |
| 4. Paese | gl | location |
| 5. Lingua, correzione ortografica | hl, autocorrect | Rimuovili oppure usa web/search con language |
| 6. Intervallo di tempo | tbs | after, before |
| 7. Link del risultato | organic[].link | results[].url |
| 8. Test degli errori | — | Invia un parametro errato e verifica che il tuo codice legga allowed e did_you_mean |
Per una visione più ampia, consulta le alternative e perché scegliere EveryInfra.
Riferimenti
- Serper home page (pricing, FAQ, sample response), Serper, consultato il 2026-11-05
- Create an account, Serper, consultato il 2026-11-05
- Log in to your account, Serper, consultato il 2026-11-05
- API Keys, Serper, consultato il 2026-11-05 (senza accesso mostra il modulo di login)
- Playground, Serper, script della pagina consultato il 2026-11-05
- Terms of Service, Serper, aggiornato il 2024-05-29, consultato il 2026-11-05
- Privacy Policy, Serper, rivisto il 2025-11-05, consultato il 2026-11-05
- Supported locations, Serper, consultato il 2026-11-05
- Serper-API GitHub organization, GitHub, consultato il 2026-11-05
- serper.dev web archive index, Internet Archive, consultato il 2026-11-05
- postman-code-generators, Postman, consultato il 2026-11-05
- Serper.dev authentication issues, community di n8n, 2025-07-26
- «Unauthorized Error (403) when Using SERPER_API_KEY #633», CrewAI, 17/05/2024
- «configure the serper api key? #914», h2oGPT, 01/10/2023
- «Add Serper.dev web search provider plugin #68615», Hermes Agent, 21/07/2026
- «Research: read a spent plan or refused key as what it is #339», GitHub, 23/10/2026
- «Live checks with real keys before release #12», GitHub, 22/10/2026
- Google Serper Search (SerperDevTool), CrewAI, consultato il 2026-11-05
- serper_dev_tool.py, CrewAI, consultato il 2026-11-05
- «CrewAI 1.15.35», CrewAI, 03/11/2026
- GoogleSerperAPIWrapper, LangChain, consultato il 2026-11-05
- google_serper.py, LangChain, consultato il 2026-11-05
- SerperDevWebSearch, deepset, consultato il 2026-11-05
- Haystack serperdev websearch.py, deepset, consultato il 2026-11-05
- Serper Search, LiteLLM, consultato il 2026-11-05
- Serper bundle, Langflow, consultato il 2026-11-05
- HTTP Request node, n8n, consultato il 2026-11-05
- HTTP Request credentials, n8n, consultato il 2026-11-05
- MCP Client Tool node, n8n, consultato il 2026-11-05
- «n8n 2.46.6», n8n, 04/11/2026
- mcp-server-serper, GitHub, consultato il 2026-11-05
- serper-mcp-server, GitHub, consultato il 2026-11-05
- Model Context Protocol Specification 2026-07-28, MCP, consultato il 2026-11-05
- MCP Authorization, MCP, consultato il 2026-11-05
- Connect Claude Code to tools via MCP, Anthropic, consultato il 2026-11-05
- «RFC 9110: HTTP Semantics», IETF, 06/2022
- «RFC 6585: Additional HTTP Status Codes», IETF, 04/2012
- «RFC 9457: Problem Details for HTTP APIs», IETF, 07/2023
- 422 Unprocessable Content, MDN, consultato il 2026-11-05
- Retry-After, MDN, consultato il 2026-11-05
- Supported secret scanning patterns, GitHub, consultato il 2026-11-05
- «Secret scanning blocks Anthropic keys by default, adds Salesforce», GitHub, 13/10/2026
- «Push protection beyond predefined secret patterns», GitHub, 28/10/2026
- Defining custom patterns for secret scanning, GitHub, consultato il 2026-11-05
- «TruffleHog v3.99.8», Truffle Security, 02/11/2026
- Gitleaks, Gitleaks, consultato il 2026-11-05
- «The attack chain behind the v1.107.0 LiteLLM release», LiteLLM, 2026-10-23
- «Security Disclosure: Wednesday October 21st», Railway, 2026-10-21
- How to Retrieve Your API Key from Serper.dev Dashboard, community di Clay, 2025-05-10
- Secrets Management Cheat Sheet, OWASP, consultato il 2026-11-05
- The Twelve-Factor App: Config, 12factor.net, consultato il 2026-11-05
- python-dotenv, PyPI, consultato il 2026-11-05
- Requests Quickstart, Requests, consultato il 2026-11-05
- EveryInfra search tool catalog, EveryInfra, consultato il 2026-11-05 alle 00:16 SGT
- EveryInfra data capability catalog, EveryInfra, consultato il 2026-11-05 alle 00:16 SGT
- EveryInfra OpenAPI, EveryInfra, consultato il 2026-11-05
Riferimenti BL-92