Un report giornaliero sui trend con n8n: alla prova lo scheduler della 2.45
Abbiamo eseguito n8n 2.45.3 secondo una pianificazione per interrogare le classifiche dei contenuti di tendenza di EveryInfra per X, Weibo e Douyin; lo abbiamo fermato due volte e abbiamo controllato ogni esecuzione, ogni esecuzione mancata e ogni addebito.
Un workflow n8n self-hosted può generare un report giornaliero sulle tendenze da EveryInfra al costo di 0,002224 $ per esecuzione. Le difficoltà non stanno nelle chiamate API. La prima riguarda le esecuzioni previste mentre n8n non è attivo. La seconda riguarda le riesecuzioni che possono sembrare addebitate due volte. La terza riguarda una singola chiamata fallita che può bloccare l'intero report.
Il 26 ottobre 2026, dalle 10:36 alle 11:25 ora di Singapore (SGT, UTC+8; 02:36–03:25 UTC), abbiamo eseguito n8n 2.45.3 su un Mac ogni 3 minuti. Lo abbiamo fermato due volte di proposito. Poi abbiamo confrontato 14 report con il database, le metriche e i log dei nostri server.
In questo articolo, un «report giornaliero sulle tendenze» è un workflow n8n sulla tua macchina. Lo avvia un nodo Schedule Trigger. Un nodo Code elenca le classifiche dei contenuti di tendenza da leggere. Un nodo HTTP Request chiama EveryInfra con una sola chiave API. Un secondo nodo Code scrive in un file Markdown i primi 10 di ogni classifica, la sovrapposizione con l'esecuzione precedente e il costo.
Il report ti dice di cosa si parla stamattina. Non prevede cosa diventerà di tendenza e non verifica se un argomento è vero.


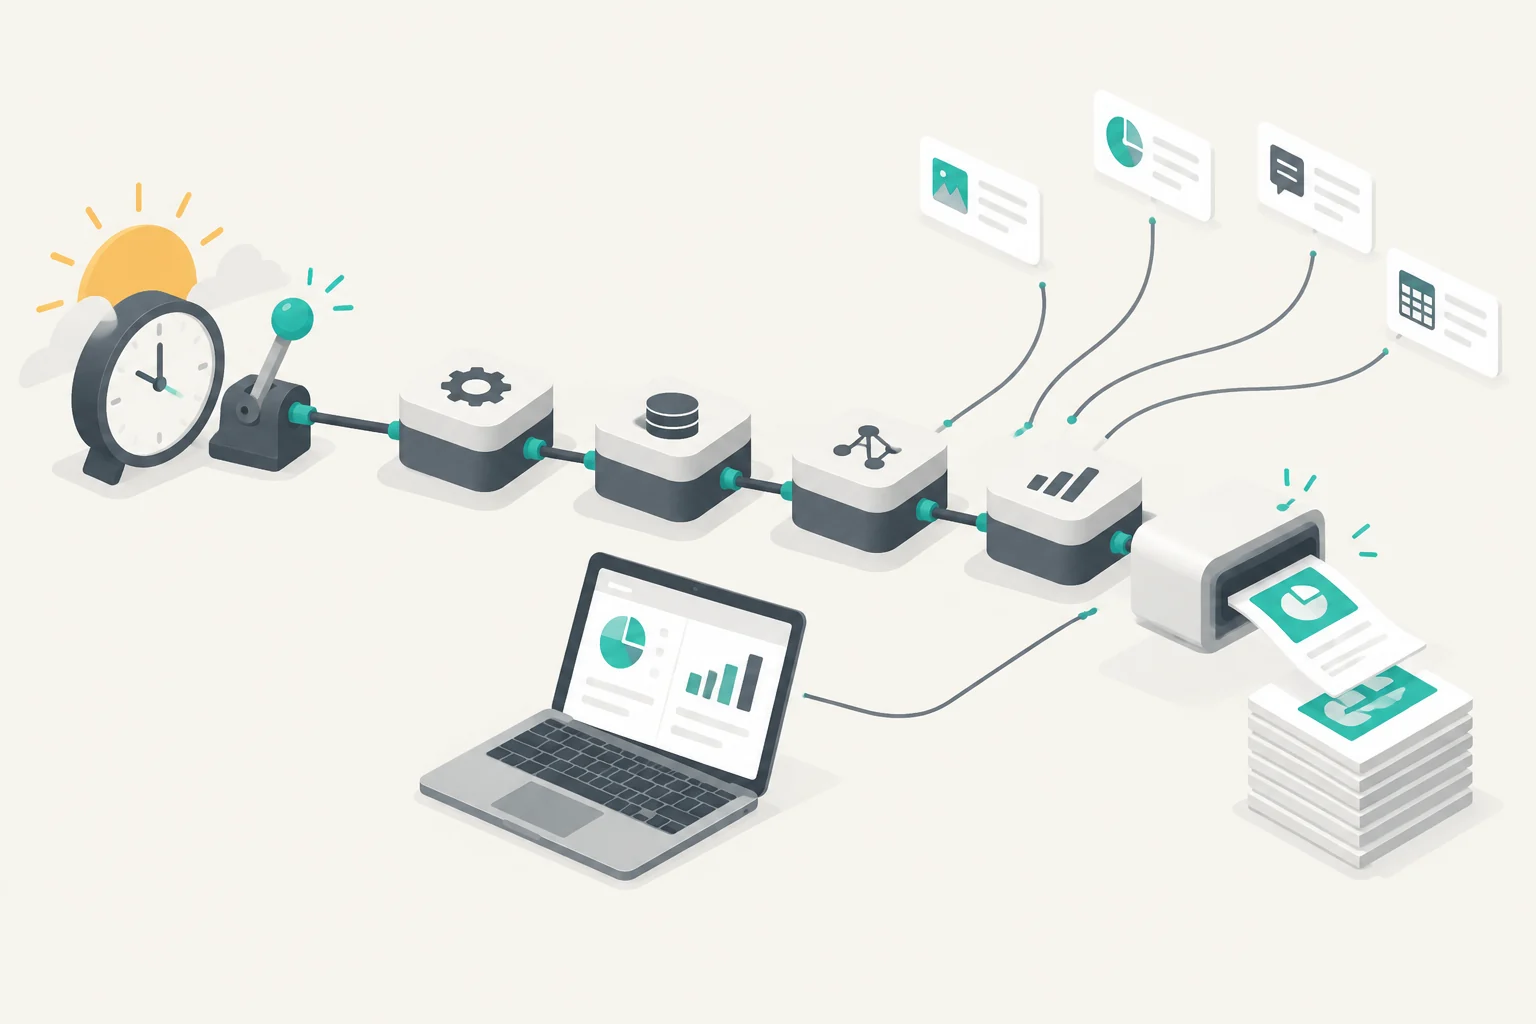
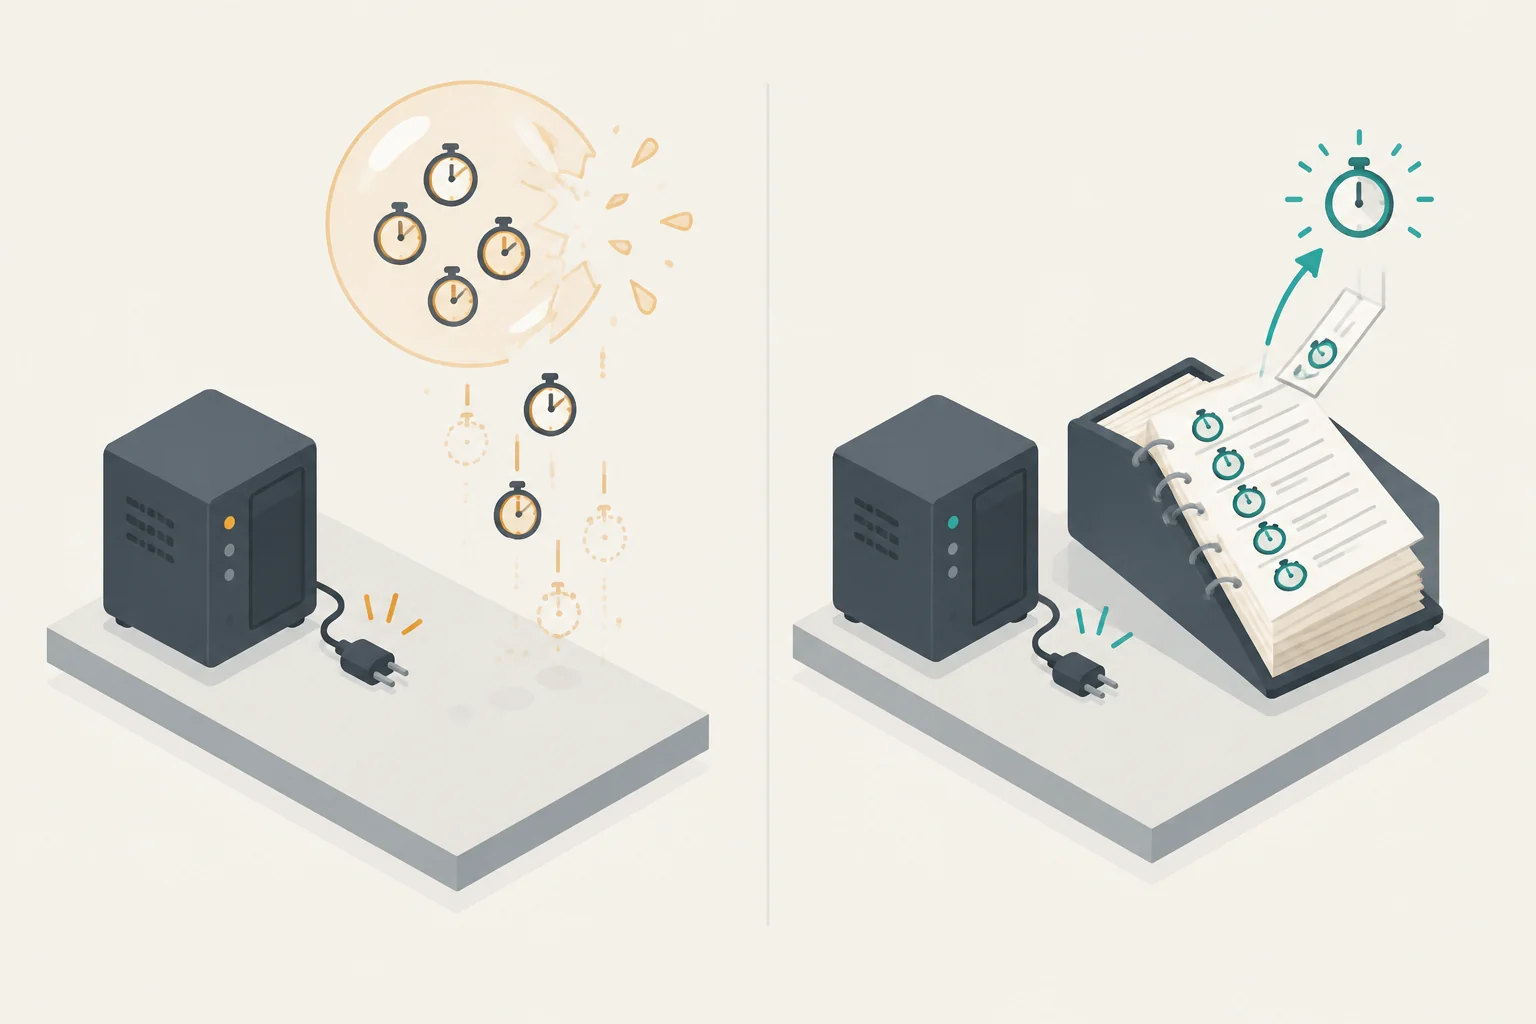
L'illustrazione mostra l'idea alla base del durable scheduler. Un'esecuzione non è un timer dentro un processo. È una riga nel database, inserita prima dell'orario previsto. Quando arriva quell'orario, un processo n8n prende in carico la riga e avvia l'esecuzione. La documentazione di n8n divide il meccanismo in cinque fasi: materializzazione, esecuzione, recupero, conservazione e riconciliazione del proprietario. In ogni test che segue, abbiamo letto in SQLite le righe reali di queste fasi.
Com'è fatto un report
Questo è il report dell'esecuzione delle 10:39:24 SGT. Il file originale proveniva dalla prima versione del passaggio 5, che numerava anche una posizione sponsorizzata di Weibo. Lo abbiamo rigenerato dalle risposte grezze di quell'esecuzione con il passaggio 5 corretto (ordinamento per rank, righe senza rank saltate). Abbiamo tolto alcune righe delle classifiche per accorciarlo.
# EveryInfra daily report 2026-10-26T10:39:24.294+08:00

## X US trends (52 items, $0.000556)
1. Lula
2. Brazil
3. Mahomes
4. Chiefs

## X Mexico trends (71 items, $0.000556)
1. Lula
2. Pachuca
3. #EleccionesBrasil2026

## Weibo hot search (10 items, 2 promoted slots skipped, $0.000556)
4. Brazil's President Lula wins re-election

## Deliberately misspelled list name: failed (HTTP 422, invalid_value)
- `boards` must be one of: challenge, entertainment, hotspot, seeding, social (got 'hot')

## Cost of this run
- Sum of charged_usd in the responses: $0.002224
- Actual charge after removing replays: $0.002224
I titoli sono in cinese perché il nostro team ha scritto il workflow in cinese. Le etichette sono testo libero nel nodo Code, quindi puoi modificarle in inglese intervenendo su una sola riga. Due cose di questo file meritano un'occhiata più da vicino.
Innanzitutto, un solo evento occupava posizioni di rilievo in quattro classifiche contemporaneamente. Il 25 ottobre il Brasile ha tenuto il secondo turno delle elezioni presidenziali (avviso del Tribunale Superiore Elettorale). Alle 10:39 SGT del giorno successivo (le 22:39 del 25 ottobre a New York), «Lula» era al numero 1 delle tendenze di X per gli Stati Uniti e per il Messico. La stessa notizia era al numero 4 della hot search di Weibo e al numero 5 della classifica degli hotspot di Douyin in Cina. La posizione su Weibo richiede una precisazione. La quarta riga della risposta di Weibo era una campagna di un brand senza campo rank: uno slot sponsorizzato (le regole della hot search di Weibo elencano gli annunci commerciali tra i tipi di etichetta). La riga di Lula aveva rank 4. Il nostro primo nodo del report numerava le righe in base alla posizione, quindi metteva Lula al numero 5 e presentava l'annuncio come argomento di tendenza. Ora il passaggio 5 ordina per rank, salta le righe con rank vuoto e indica nel titolo quante ne ha saltate. Un report che copre più piattaforme rende visibile a colpo d'occhio questo tipo di sovrapposizione. Nello stesso momento le tendenze statunitensi riguardano anche lo sport: «Mahomes», «Chiefs» e «Packers» occupano il resto della top 10 degli Stati Uniti.
Secondo: la chiamata fallita non ha fatto fallire il report. Il report la mostra come una breve nota con il motivo e il valore suggerito. La sezione dei costi indica che l'errore non è costato nulla. Il Test 4 spiega perché devi progettare questo comportamento prima del primo errore, non dopo.
I criteri di superamento scritti prima della prima esecuzione
Prima della prima esecuzione abbiamo scritto 10 criteri di superamento nel nostro file di verifica. Non li abbiamo cambiati dopo aver visto i risultati, con una sola eccezione. Avevamo previsto di verificare gli addebiti con il saldo dell'account. Alle 10:33 SGT abbiamo visto che altri autori usano la stessa chiave di test, quindi il saldo varia anche in base alle loro chiamate. Prima di qualsiasi chiamata addebitata, abbiamo cambiato la verifica: cerchiamo ogni request_id nel log delle chiamate del server.
| ID | Verifica | Criterio di superamento | Risultato |
|---|---|---|---|
| J1 | Le esecuzioni partono da sole | Almeno 3 esecuzioni con mode=trigger, ognuna scrive un report | Superato: 14 esecuzioni, 14 file |
| J2 | Puntualità | Ritardo rispetto all'orario previsto di 5 s al massimo nelle esecuzioni normali | Superato: 0,008–0,034 s |
| J3 | «Ogni N minuti» conta dalla pubblicazione | Intervalli di 180 ±5 s, non allineati ai minuti interi | Superato: tutte a 24,206 s dopo un multiplo di 3 minuti |
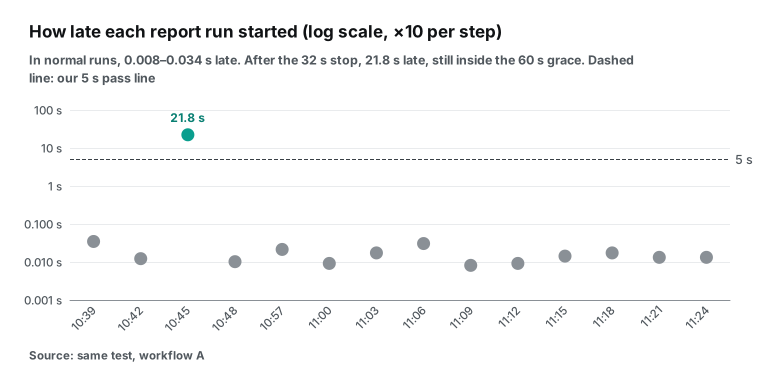
| J4a | Arresto entro il periodo di tolleranza | Un arresto di 32 s che copre un orario previsto: A e B partono entrambi in ritardo | Superato: entrambi con 21,8 s di ritardo |
| J4b | Arresto oltre la tolleranza, policy predefinita | A scarta entrambe le esecuzioni mancate | Superato |
| J4c | Arresto oltre la tolleranza, policy di recupero | B esegue un solo recupero | Superato: 1 esecuzione, 89,0 s di ritardo |
| J5 | Costi | Ogni esecuzione senza replay = 4 × 0,000556 $, e il log del server conferma il dato per ogni chiamata | Superato: tutte e 56 le chiamate addebitate trovano riscontro |
| J6 | Un errore non blocca il report | La chiamata errata riceve 422 con did_you_mean e 0 $, le altre chiamate proseguono | Superato |
| J7 | MCP | Il nodo MCP Client chiama everyinfra_call_api, con gli stessi campi di una chiamata REST | Superato |
| J8 | Quanto cambiano in fretta le classifiche | Solo conteggio: sovrapposizione della top 10 tra esecuzioni | Vedi «Quanto sono cambiate le classifiche in 45 minuti» |
| J9 | La chiave non arriva mai su disco | 0 corrispondenze per la chiave nel database di n8n, nei dati delle esecuzioni, nei report e nei file grezzi | Superato: 0 corrispondenze |
| J10 | Un replay non viene addebitato di nuovo | Di nuovo lo stesso Idempotency-Key: replayed: true, nessuna seconda voce nel log | Superato |
I problemi più difficili dei job pianificati non si presentano come errori: un'esecuzione manca, un'esecuzione avviene due volte o un addebito è un po' troppo alto, quindi le verifiche fissano in anticipo conteggi, righe e costi. Un utente di n8n ha scritto di nodi che ricevono zero elementi. I nodi successivi non vengono eseguiti, ma l'esecuzione mostra comunque «Success» e il workflow di gestione degli errori non parte mai (thread su Reddit r/n8n). Puoi trovare problemi del genere solo se prima scrivi il conteggio, le righe e il costo attesi.
Prima di iniziare: versione, metodo di installazione e Node.js
Versione. Il durable scheduler è attivo per impostazione predefinita da n8n 2.45.0, rilasciato il 20 ottobre 2026. Il changelog dice che i nodi Schedule Trigger «ora vengono eseguiti sul durable scheduler per impostazione predefinita». Ma il 26 ottobre il registro npm aveva ancora la 2.44.6 (22 ottobre) sotto il tag latest. La versione 2.45.3 (23 ottobre) era sotto next e beta. Quindi oggi un semplice npm install n8n ti dà la 2.44.6, in cui il durable scheduler è ancora disattivato per impostazione predefinita. Per ripetere questo test, devi indicare la versione.
n8n applica inoltre le patch alle due linee separatamente. L'aggiornamento di sicurezza del 14 ottobre riporta «beta patched in v2.44.1» e «stable patched in v2.43.5».
| Comando di installazione | Versione al 26 ott. | Durable scheduler | Usato qui |
|---|---|---|---|
npm install n8n | 2.44.6 (latest) | Disattivato per impostazione predefinita, imposta N8N_SCHEDULER_ENABLED=true | No |
npm install n8n@'2.45.3' | 2.45.3 (next, beta) | Attivo per impostazione predefinita | Sì |
| n8n Cloud | Gestita da n8n | Segue la versione Cloud | No (nessuna registrazione) |
| Immagine Docker | Il tag che scarichi | Attivo per impostazione predefinita dalla 2.45 | Non testato (niente Docker su questo Mac) |
Dal 13 al 23 ottobre, le linee 2.44 e 2.45 hanno pubblicato su npm 7 versioni in tutto (dalla 2.44.0 alla 2.45.3), alternandosi con le patch. Se installi «l'ultima versione» seguendo un tutorial online, puoi ritrovarti con l'una o con l'altra linea.
Metodo di installazione. Abbiamo usato npm perché questo Mac ha Node.js ma non Docker. Devi considerare due aspetti. Primo, la pagina di installazione con npm dice che «le installazioni basate su npm sono deprecate da n8n 3.0». La pagina dedicata ai breaking change di n8n 3.0 dice che la 3.0 richiede Docker e che su npm non ci sarà un pacchetto n8n eseguibile. La guida per sviluppatori di n8n su GitHub colloca la v3 intorno a ottobre 2026. Il nostro n8n ha stampato questo avviso all'avvio: «Running n8n outside a container is deprecated».
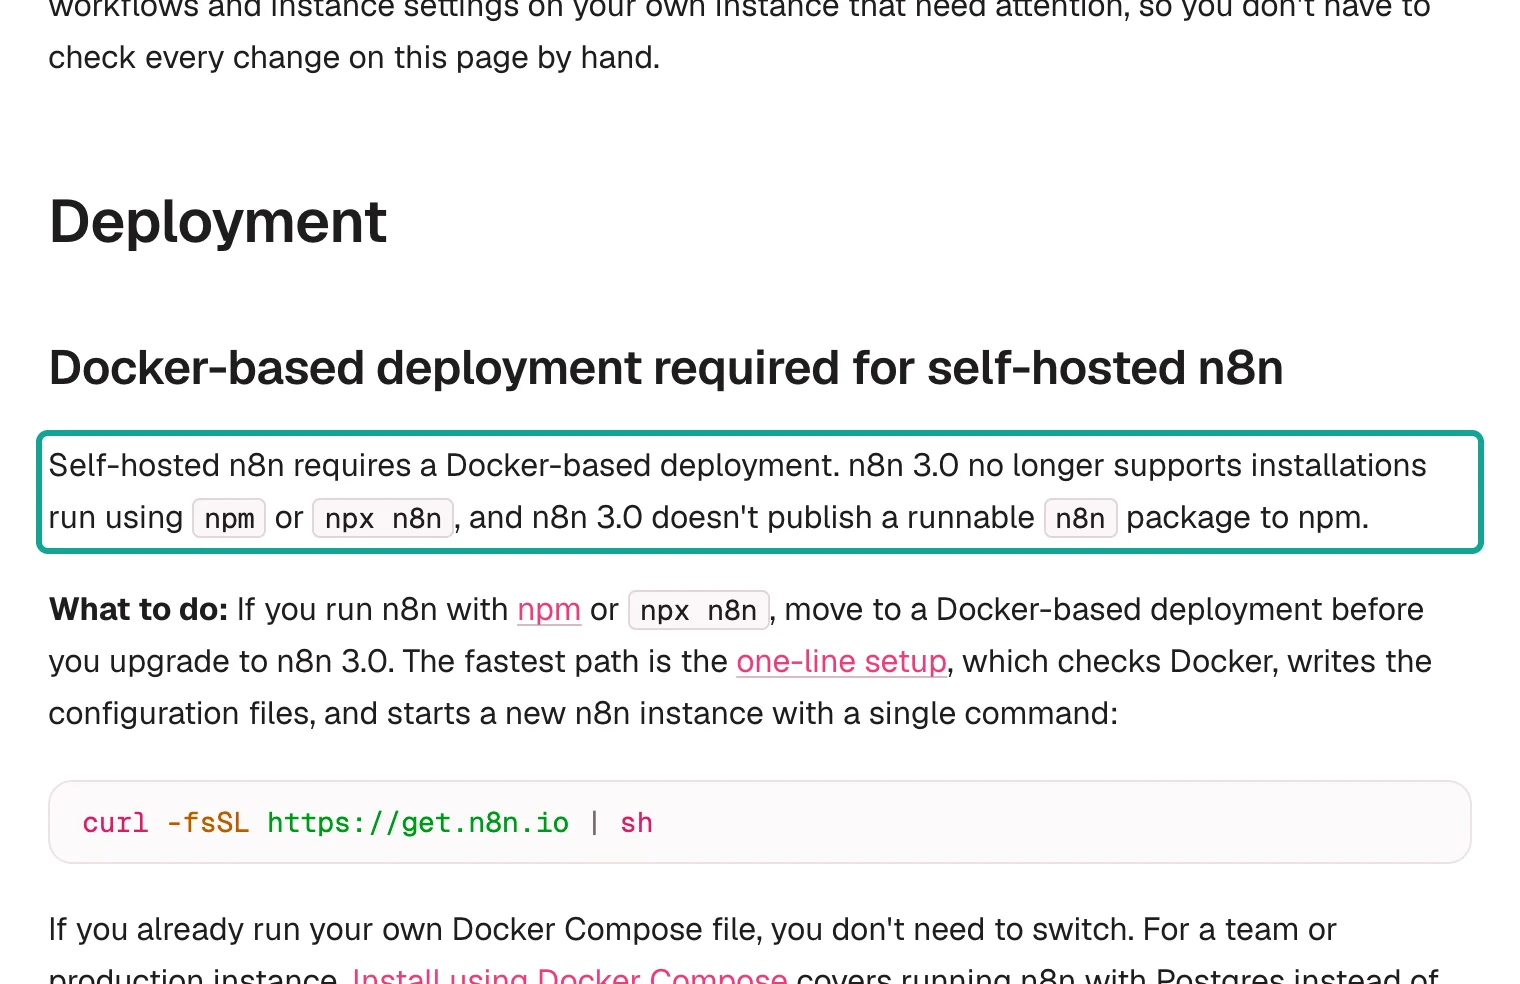
Quindi npm va bene per un test su un portatile. Per un report che gira ogni giorno per mesi, usa Docker Compose o il setup su una riga.
Secondo, le dimensioni. Un'installazione pulita ha aggiunto 2.328 pacchetti in 6 minuti e node_modules occupava 4,4 GB. La nostra prima installazione si è interrotta a metà. Con quella cartella installata solo in parte, n8n non si avviava e mostrava Cannot find module 'kuler'. Un secondo npm install nella stessa cartella non ha risolto il problema.
Abbiamo eliminato node_modules e package-lock.json, reinstallato e n8n si è avviato. Se un'installazione si interrompe, ricomincia da una cartella vuota. È la soluzione più rapida.
Versione di Node.js. La documentazione e il pacchetto non concordano. La pagina di installazione con npm dice «tra 20.19 e 24.x». Il pacchetto stesso (npm view n8n@'2.45.3' engines) richiede >=24.0.0. La tabella dei rilasci di Node.js mostra che la 20 ha raggiunto la fine del ciclo di vita a marzo 2026, la 24 è LTS e la 26 è «Current». Abbiamo usato la 26.11.1 senza problemi in questo test. È però fuori dall'intervallo documentato, quindi per un report di lunga durata usa Node.js 24 LTS.
C'è un'altra trappola: la porta. All'inizio abbiamo impostato n8n sulla porta 5679. n8n si è fermato subito con una sola riga nel log: «n8n Task Broker's port 5679 is already in use». In n8n 2.x i nodi Code girano in un task runner integrato, il cui broker usa per impostazione predefinita la porta 5679. Abbiamo spostato N8N_PORT su 5690 e impostato N8N_RUNNERS_BROKER_PORT su 5691.
Dopo questa modifica, n8n si è avviato. Queste sono tutte le impostazioni che abbiamo usato:
export N8N_USER_FOLDER=$HOME/Downloads/n8n-lf25/home # database and encryption key live here
export N8N_PORT=5690 N8N_LISTEN_ADDRESS=127.0.0.1 # listen on this machine only
export N8N_RUNNERS_BROKER_PORT=5691 # keep away from the broker default 5679
export GENERIC_TIMEZONE=Asia/Singapore TZ=Asia/Singapore # the default is America/New_York
export N8N_RESTRICT_FILE_ACCESS_TO=$HOME/Downloads/n8n-lf25/reports
export N8N_DIAGNOSTICS_ENABLED=false N8N_VERSION_NOTIFICATIONS_ENABLED=false
export N8N_METRICS=true N8N_METRICS_INCLUDE_SCHEDULER_METRICS=true
npm install n8nLe stesse impostazioni in tabella, con il motivo di ciascuna:
| Variabile | Predefinito | Il nostro valore | Perché |
|---|---|---|---|
N8N_USER_FOLDER | ~/.n8n | Una cartella in ~/Downloads | Tiene il database e la chiave di crittografia insieme al test |
N8N_PORT | 5678 | 5690 | La porta 5679 è quella predefinita del task broker |
N8N_LISTEN_ADDRESS | Tutte le interfacce | 127.0.0.1 | Solo questa macchina può aprire l'editor |
N8N_RUNNERS_BROKER_PORT | 5679 | 5691 | Impostata di proposito, così nessun'altra impostazione entra in conflitto |
GENERIC_TIMEZONE | America/New_York | Asia/Singapore | Stabilisce a quale fuso orario corrispondono le «8:00» del trigger |
N8N_RESTRICT_FILE_ACCESS_TO | ~/.n8n-files | La cartella reports/ | L'unica cartella in cui il nodo dei file può scrivere |
N8N_METRICS e N8N_METRICS_INCLUDE_SCHEDULER_METRICS | false | true | Contatori per le esecuzioni mancate e recuperate |
L'indirizzo di ascolto è 127.0.0.1, così solo questa macchina può aprire n8n. Censys, un'azienda specializzata nella scansione di Internet, ha contato 113.926 host n8n su Internet pubblico nel suo report annuale del 14 ottobre; tra quelli con una versione leggibile, il 76% aveva almeno una vulnerabilità critica recente (blog di Censys). Inoltre n8n rilascia aggiornamenti di sicurezza ogni due settimane (per esempio l'aggiornamento del 1° ottobre). Per leggere i report da un'altra macchina, sincronizza la cartella reports/. Non esporre l'editor di n8n su Internet.
Non saltare la riga del fuso orario. La pagina sul fuso orario dice che un'istanza self-hosted usa America/New_York per impostazione predefinita. Lo Schedule Trigger usa questo fuso per stabilire a quale ora locale corrispondono le «8:00» indicate. Per chi legge da New York questa impostazione predefinita è corretta per caso. Per tutti gli altri, un report delle 8:00
parte all'ora sbagliata. Puoi anche impostare un fuso orario per ogni workflow nelle sue impostazioni. Noi abbiamo impostato Asia/Singapore in entrambi i posti.
Anche l'impostazione relativa ai file è importante. Da n8n 2.0, il nodo Read/Write Files può usare solo ~/.n8n-files per impostazione predefinita. Per scrivere i report altrove, devi autorizzare quella cartella con N8N_RESTRICT_FILE_ACCESS_TO. Autorizza solo quella cartella.
Lettori negli Stati Uniti: attenzione al 1° novembre
Se il tuo report segue l'ora degli Stati Uniti, segnati una data. Secondo il NIST, nel 2026 l'ora legale termina il 1° novembre alle 2:00 ora locale, e l'ora che inizia all'1:00 si ripete. Un report giornaliero alle 8:00 in
America/New_York non corre rischi. È un orario lontano dal cambio, e il durable scheduler mantiene invariata l'ora locale. Un job all'1:30 è un altro discorso, perché quell'orario si presenta due volte il 1° novembre.
Questa tabella riporta il cambio del 1° novembre per i principali fusi orari degli Stati Uniti, in base alle regole del NIST:
| Fuso IANA | Prima del 1° nov. 2026 | Dopo il 1° nov. 2026 | Orari sicuri per il report giornaliero |
|---|---|---|---|
America/New_York | UTC−4 | UTC−5 | Qualsiasi orario fuori dalla fascia 1:00–2:59 |
America/Chicago | UTC−5 | UTC−6 | Qualsiasi orario fuori dalla fascia 1:00–2:59 |
America/Los_Angeles | UTC−7 | UTC−8 | Qualsiasi orario fuori dalla fascia 1:00–2:59 |
America/Phoenix | UTC−7 | UTC−7 (senza ora legale) | Qualsiasi orario |
Pacific/Honolulu | UTC−10 | UTC−10 (senza ora legale) | Qualsiasi orario |
La documentazione del durable scheduler dice che le pianificazioni orarie, giornaliere, settimanali e mensili scattano come prima «nell'uso quotidiano». Dice anche che il durable scheduler gestisce i passaggi dell'ora legale, gli anni bisestili e la 53ª settimana in modo più corretto rispetto allo scheduler in memoria, che «poteva sbagliare di un periodo». Non abbiamo testato un vero cambio d'ora, perché avverrà solo la settimana prossima. Il nostro consiglio è semplice. Non programmare un report giornaliero tra l'1:00
e le 3:00 ora locale. Imposta come fuso orario del workflow un vero nome IANA come America/Chicago, non un offset fisso. Il database dei fusi orari IANA è il posto in cui si trovano questi nomi e le loro regole.
Costruisci il workflow: sei nodi, un'azione per passaggio
Il workflow ha sei nodi. Questa animazione segue un'esecuzione.


Non abbiamo assemblato questo workflow a colpi di clic nell'editor. Lo abbiamo scritto in JSON e importato con la riga di comando di n8n. Questo ha due vantaggi. Puoi ripetere ogni passaggio esattamente. E non ti serve un account owner nella tua istanza n8n locale. Per ogni passaggio indichiamo l'azione, il risultato che dovresti vedere e il motivo.
- Salva la chiave API come credenziale n8n. Esegui
jq -n --arg t "$EVERYINFRA_API_KEY" '[{"id":"eiBearer000001","name":"EveryInfra API Key","type":"httpBearerAuth","data":{"token":$t}}]' | n8n import:credentials --input=/dev/stdin. Dovresti vedere «Successfully imported 1 credential».
Il punto chiave è --input=/dev/stdin. La chiave passa solo attraverso una variabile d'ambiente e una pipe. Non finisce mai in un file. Quando il campo data è in chiaro, il comando di importazione lo cifra con la chiave dell'istanza prima di scrivere la riga (nel codice sorgente è cipher.encryptV2). Non digitare la chiave in un campo header del nodo HTTP Request.
Se lo fai, finisce in chiaro nel JSON del workflow, in ogni export e nella cronologia delle versioni. La pagina delle credenziali di HTTP Request elenca Bearer, Header e altri tipi. Usa Bearer. Invia l'header Authorization: Bearer definito nella RFC 6750, che è il formato che EveryInfra si aspetta.
- Aggiungi uno Schedule Trigger. Per il test, imposta «ogni 3 minuti». Per l'uso quotidiano, imposta «Days», ore 8, minuto 0. Dopo la pubblicazione, nella tabella SQLite
scheduled_jobcompare una nuova riga conintervalSeconds180,misfirePolicyskipemisfireGraceSeconds60.
La pagina dello Schedule Trigger introduce due nuove impostazioni del nodo. «If Execution Is Missed» ha tre opzioni, e quella predefinita è saltare l'esecuzione. «Missed Execution Grace Period (Seconds)» usa il valore dell'istanza N8N_SCHEDULER_MISFIRE_GRACE, 60 secondi per impostazione predefinita, quando la lasci a 0. Entrambe le impostazioni valgono solo per i nodi aggiunti dalla 2.36 in poi, e solo quando il durable scheduler è attivo. Abbiamo letto il sorgente del nodo per ricavare i valori salvati: coalesce_owner è «Run the Most Recent Missed Execution», coalesce è la stessa cosa ma per singola regola, e skip è il valore predefinito.
- Elenca le richieste in un nodo Code, con una chiave per richiesta. Il nodo restituisce 5 elementi. Ogni elemento contiene la piattaforma, l'azione, i parametri e un campo
idem. Nei dati dell'esecuzione dovresti vedere 5 elementi in output.
const now = DateTime.now().setZone('Asia/Singapore');
// Daily use: one key per day (a rerun on the same day is a replay). Test: one key per minute.
const KEY_BY = 'day';
const keyBase = KEY_BY === 'day' ? now.toFormat('yyyyLLdd') : now.toFormat('yyyyLLdd-HHmm');
const reqs = [
  { label: 'Weibo hot search', platform: 'weibo', action: 'trending', params: {} },
  { label: 'Douyin hot list', platform: 'douyin', action: 'trending', params: { boards: 'hotspot' } },
  { label: 'X US trends', platform: 'twitter', action: 'trending', params: { country: 'us' } },
  { label: 'X Mexico trends', platform: 'twitter', action: 'trending', params: { country: 'mx' } },
  { label: 'Misspelled list name', platform: 'douyin', action: 'trending', params: { boards: 'hot' } },
];
return reqs.map(r => ({ json: { ...r,
  idem: `daily-report-${keyBase}-${r.platform}-${r.params.country || r.params.boards || 'default'}`,
  firedAt: now.toISO() } }));
Questo è esattamente il codice che abbiamo eseguito. Le etichette sono in cinese perché il nostro team legge i report in cinese; puoi cambiare liberamente le stringhe delle etichette.
Perché creare una chiave di idempotenza personalizzata? Un report giornaliero non deve essere eseguito e addebitato due volte né produrre due file diversi nello stesso giorno. La descrizione OpenAPI di EveryInfra dice che una chiamata sincrona con gli stessi Idempotency-Key, piattaforma, azione e parametri entro 24 ore «riproduce la prima risposta andata a buon fine». La chiamata non viene rieseguita e non viene addebitata di nuovo. Parametri diversi con la stessa chiave restituiscono 409 idempotency_conflict.
Una chiave basata sulla data dice all'API «una sola copia della classifica di oggi». Lo schema segue la bozza IETF sull'header Idempotency-Key, arrivata alla versione 08 il 22 ottobre 2026. Nel nostro test abbiamo impostato KEY_BY su minute. Con una chiave al giorno, dopo la prima tutte le esecuzioni del test pianificate ogni 3 minuti sarebbero state replay, e non avremmo visto come cambiano le classifiche.
- Chiama EveryInfra con un nodo HTTP Request. Usa il metodo POST e l'URL
https://api.everyinfra.com/api/v1/social. Seleziona la credenziale Bearer del passaggio 1. Aggiungi l'headerIdempotency-Key: {{ $json.idem }}. Invia un corpo JSON:{{ JSON.stringify({ platform: $json.platform, action: $json.action, params: $json.params }) }}. Attiva «Include Response Headers and Status» e «Never Error». Imposta il batching a 1 elemento per batch con 1.500 ms tra un batch e l'altro. Dovresti vedere 5 elementi per esecuzione: 4 constatusCode200 e 1 con 422.
«Never Error» è l'interruttore più importante di questo passaggio. La pagina di HTTP Request spiega che per impostazione predefinita una risposta non 2xx fa fallire il nodo. L'esecuzione si ferma lì e il nodo del report non viene mai eseguito. Un report giornaliero ha bisogno del contrario. Quando una classifica fallisce, le altre finiscono comunque nel report, e quella fallita riceve una nota chiara.
Con «Never Error» e la risposta completa, il corpo e lo stato del 422 arrivano al nodo successivo come dati normali. L'intervallo tra i batch ti mantiene sotto il limite di EveryInfra di 10 chiamate al minuto per chiave. GET /api/v1/account restituisce questo valore come key_requests_per_minute. Con 1,5 secondi tra le chiamate, un'esecuzione ha richiesto circa 13–16 secondi.
- Scrivi il report in un secondo nodo Code e ricorda l'esecuzione precedente. Questo nodo abbina in ordine le 5 risposte alle 5 richieste del passaggio 3. Prende la top 10 di ogni classifica in base a
ranke salta le righe sponsorizzate senza rank (vedi il codice sotto). Legge l'ultima top 10 da$getWorkflowStaticData('global'), conta la sovrapposizione e salva le nuove classifiche. Dovresti vedere un elemento conmarkdownefileName.
Cura a parte il calcolo della top 10. La risposta della hot search di Weibo include slot sponsorizzati. Hanno un titolo e un valore di popolarità, ma nessun rank. Nelle nostre 14 esecuzioni, gli slot sponsorizzati hanno occupato complessivamente 16 posti tra i primi 10 risultati di Weibo; Douyin e X non ne avevano. Se numeri per posizione, un annuncio diventa un argomento caldo e ogni rank successivo slitta di uno. Inserisci questa logica nel secondo nodo Code: se almeno una riga di una classifica ha un rank, tieni solo le righe con rank e ordinale in base a quello; usa la posizione solo quando nessuna riga ha un rank.
function top10(results) {
  const rows = results || [];
  const hasRank = rows.some(x => x.rank != null);
  const kept = hasRank ? rows.filter(x => x.rank != null).sort((a, b) => a.rank - b.rank) : rows;
  return {
    top: kept.slice(0, 10).map((x, i) => ({ rank: x.rank ?? i + 1, title: x.title || x.keyword || x.name })),
    promoted: rows.length - kept.length,   // goes into the heading: "N promoted rows skipped"
  };
}
Questi sono i 7 slot sponsorizzati comparsi nelle nostre 14 esecuzioni. Occupavano solo due posizioni: la 4ª e l'8ª. I loro titoli sembrano normali argomenti caldi, quindi solo il rank vuoto li tradisce. L'ultimo, «Diverse creme contorno occhi accusate di pubblicità ingannevole», sembra una notizia, ma non ha rank, quindi saltiamo anche quello. Se vuoi tenere righe del genere, ti serve una regola a parte.
| Titolo dello slot sponsorizzato | Volte in cui è comparso | Posizione | Quando (SGT) |
|---|---|---|---|
| ROSÉ nominata global ambassador di Johnnie Walker Black Label | 5 | 4th | 10:42–11:18 |
| Se gestisci una casa, vieni a provarlo | 3 | 4th | 11:03–11:15 |
| Come Lynk & Co ha vinto 16 titoli in sette anni | 3 | 8th | 11:06–11:15 |
| Liu Haocun nominata global brand ambassador di Anta | 2 | 4th | 10:39–11:00 |
| Mikimoto e Dilraba: una trilogia di perle | 1 | 8th | 10:39 |
| Acquista moda e prodotti di bellezza scontati del 50% su JD con Lou Yixiao | 1 | 4th | 11:21 |
| Diverse creme contorno occhi accusate di pubblicità ingannevole | 1 | 8th | 11:21 |
I dati statici sono la forma di memoria più leggera tra un'esecuzione e l'altra in n8n. La documentazione di n8n indica due limiti. Non vengono salvati nelle esecuzioni di test manuali, ma solo quando un workflow pubblicato viene eseguito da un trigger. Inoltre possono essere poco affidabili ad alta frequenza. Quindi in un'esecuzione manuale la «sovrapposizione con l'esecuzione precedente» è sempre vuota.
È il comportamento previsto. Per i dati da conservare, la documentazione suggerisce le data table.
Questo nodo calcola anche il costo, in due modi. «Somma delle risposte» somma billing.charged_usd di tutte le chiamate. «Addebito effettivo» esclude le chiamate in cui replayed è true. Il Test 3 mostra perché ti servono entrambi i numeri.
- Converti in file e scrivilo su disco. Usa Convert to File con «Convert to Text File» sul campo
markdown. Poi scrivi il file nella cartellareports/con il nodo Read/Write Files. Dovresti vedere un nuovo filereport-<time>.mdper ogni esecuzione.
Se questo passaggio segnala che il percorso non è scrivibile o non è consentito, controlla prima N8N_RESTRICT_FILE_ACCESS_TO. Il percorso deve trovarsi dentro la cartella che questa variabile autorizza.
- Pubblica, poi riavvia n8n. Esegui
n8n import:workflow --input=A.json, poin8n publish:workflow --id=eiDailyReport01, poin8n start. Il log di avvio dovrebbe mostrare «Scheduler started» e «Processed 0 draft workflows, 2 published workflows».
La pubblicazione da riga di comando ha un dettaglio facile da trascurare. publish:workflow scrive direttamente nel database. Il comando stesso stampa «Changes will not take effect if n8n is running». Un'istanza n8n in esecuzione deve riavviarsi per vedere la modifica. Questo dettaglio decide la risposta del Test 1.
Test 1: è puntuale e da quando si conta «ogni N minuti»?
n8n 2.45 cambia il significato di «ogni N minuti». La pagina del durable scheduler dice che queste pianificazioni «vengono eseguite a intervalli uniformi misurati dalla pubblicazione del workflow». Non si allineano più ai minuti interi. Per mantenere la temporizzazione allineata all'orologio, devi impostare N8N_SCHEDULER_TRIGGER_NODE_MODE=legacy. Questo è il testo originale, con la regola in un riquadro verde acqua.
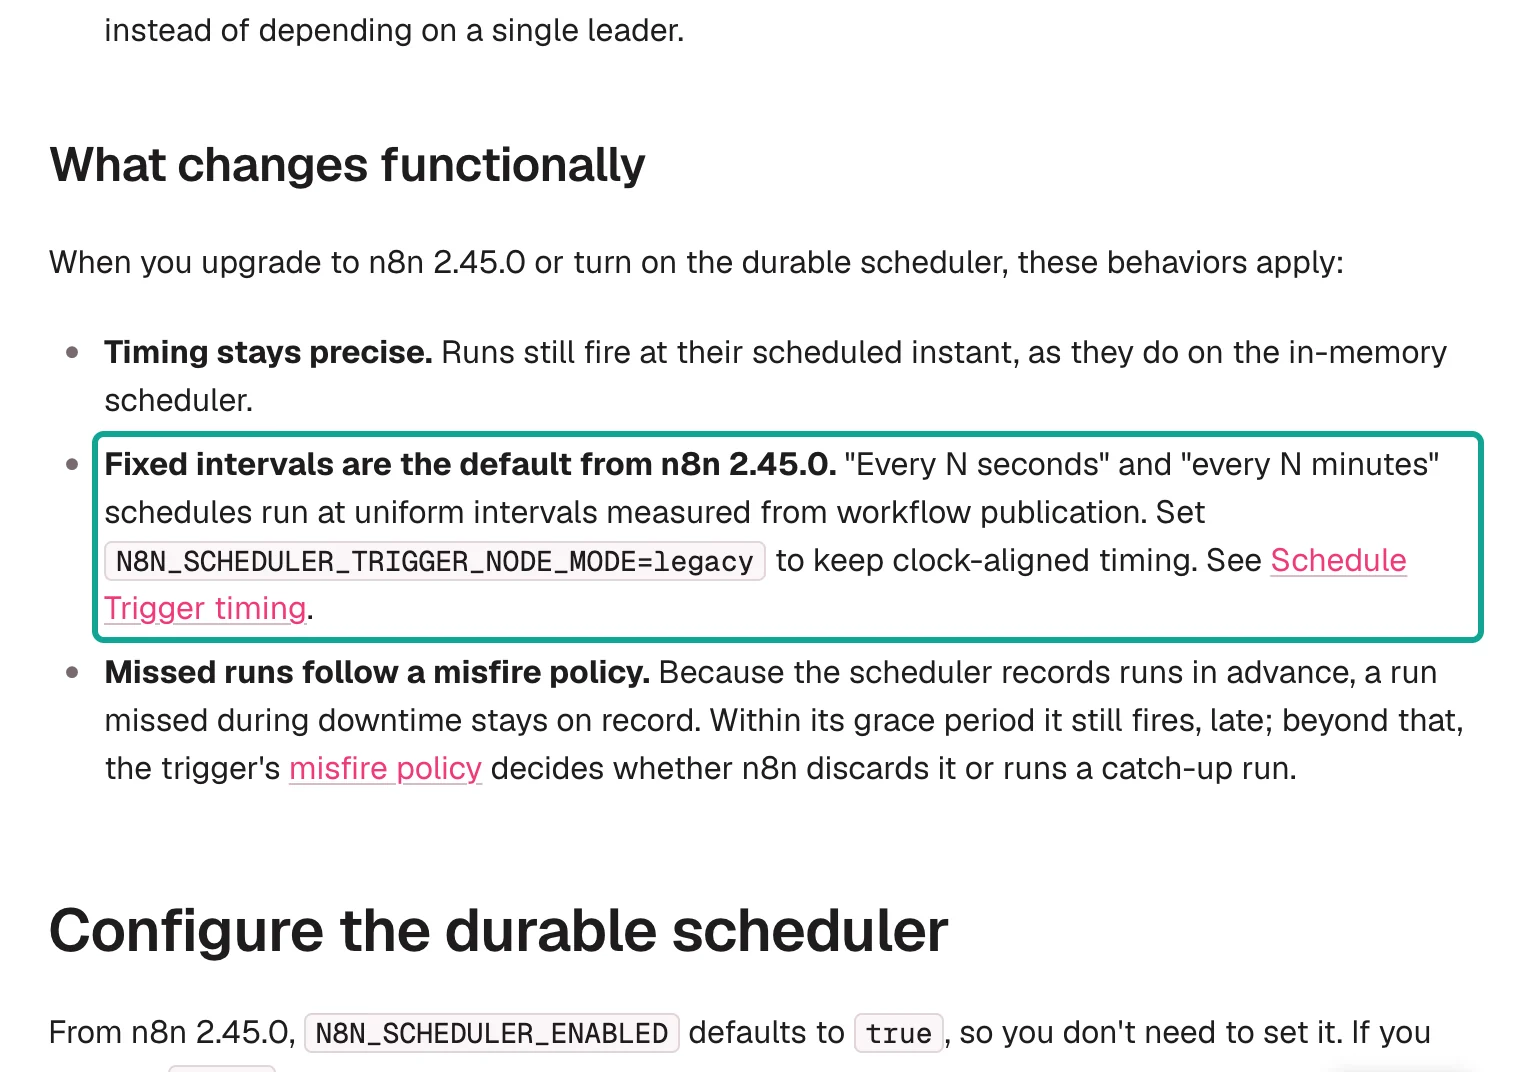
Qual è quindi il momento della «pubblicazione»? Abbiamo pubblicato i due workflow dalla riga di comando alle 10:32:59 e alle 10:33:01 SGT. n8n si è avviato alle 10:36:20 e li ha attivati alle 10:36:24. La tabella SQLite scheduled_job dà la risposta. Le due righe hanno createdAt alle 10:36:24,207 e alle 10:36:24,209, e il primo nextRunAt è alle 10:39:24,206.
Il conteggio parte quando un'istanza n8n in esecuzione attiva il workflow, non quando il comando scrive nel database. Nell'editor i due momenti coincidono nello stesso clic. Con la riga di comando erano a 3 minuti e 25 secondi di distanza.
Tutte le 14 esecuzioni successive sono cadute sulla stessa fase: 24,206 secondi dopo ogni multiplo di 3 minuti, dalle 10:39:24 alle 11:24:24. Nelle esecuzioni normali, l'avvio è avvenuto tra 0,008 e 0,034 secondi dopo l'orario previsto, molto al di sotto del nostro criterio di superamento di 5 secondi. Senza arresti di mezzo, l'intervallo tra due esecuzioni è stato di 179,978–180,013 secondi.
Abbiamo riavviato n8n due volte durante il test, e la fase non è cambiata. Dopo ogni riavvio la riga di scheduled_job era ancora lì e nextRunAt proseguiva dalla vecchia fase. Un riavvio non ha fatto ripartire il conteggio. È la differenza più netta rispetto al vecchio scheduler in memoria.
Questa tabella mostra tutti e 16 gli orari previsti, uno per uno. Tutti i valori provengono da SQLite e dai dati delle esecuzioni; il nostro script di analisi analysis.py li calcola. Gli orari sono in SGT.
| Previsto | Avviato | Ritardo (s) | Chiamate addebitate | Addebito | Righe: Weibo / Douyin / X Stati Uniti / X Messico |
|---|---|---|---|---|---|
| 10:39:24.206 | 10:39:24.240 | 0.034 | 4 | $0.002224 | 10 / 8 / 52 / 71 |
| 10:42:24.206 | 10:42:24.218 | 0.012 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 10:45:24.206 | 10:45:46.037 | 21.831 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:48:24.206 | 10:48:24.216 | 0.010 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:51:24.206 | Non eseguita (arresto, skip predefinito) | — | 0 | $0 | — |
| 10:54:24.206 | Non eseguita (arresto, skip predefinito) | — | 0 | $0 | — |
| 10:57:24.206 | 10:57:24.227 | 0.021 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:00:24.206 | 11:00:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:03:24.206 | 11:03:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:06:24.206 | 11:06:24.236 | 0.030 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 11:09:24.206 | 11:09:24.214 | 0.008 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:12:24.206 | 11:12:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:15:24.206 | 11:15:24.220 | 0.014 | 4 | $0.002224 | 15 / 20 / 50 / 72 |
| 11:18:24.206 | 11:18:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:21:24.206 | 11:21:24.219 | 0.013 | 4 | $0.002224 | 19 / 20 / 50 / 72 |
| 11:24:24.206 | 11:24:24.219 | 0.013 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
L'ultima colonna mostra un aspetto che non c'entra con la pianificazione. Nella prima esecuzione Weibo ha restituito solo 10 righe e Douyin solo 8. In seguito, entrambi hanno restituito quasi sempre 20 righe, che è il default_limit di entrambi nel catalogo. Il Test 3 spiega cosa significa per il costo.
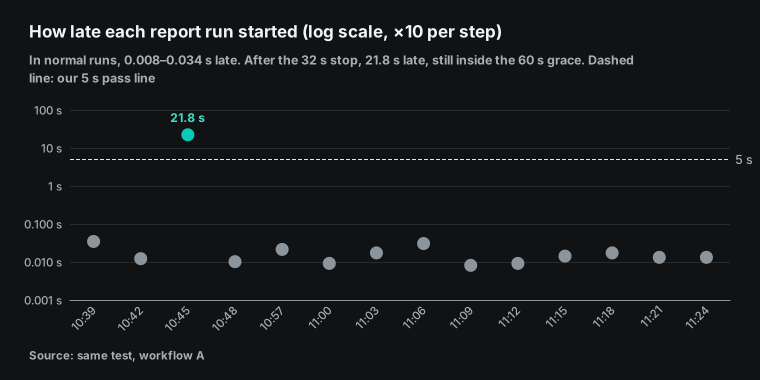
Cosa significa per un report giornaliero? Per ricevere il report alle 8:00 in punto, usa l'intervallo «Days» con ore 8 e minuto 0. La documentazione dice che le pianificazioni orarie, giornaliere, settimanali e mensili si comportano allo stesso modo in entrambe le modalità nell'uso quotidiano. Cambiano solo «ogni N minuti» e «ogni N secondi».
Se usavi «ogni 30 minuti» per eseguire ai minuti :00 e :30, dalla 2.45 l'esecuzione avviene ogni 30 minuti a partire dal secondo in cui hai cliccato su «Publish». Per mantenere l'allineamento all'ora intera, usa un'espressione cron come 0 */30 * * * *. La documentazione dice che cron non dipende da questa impostazione. Puoi anche impostare legacy, but la documentazione indica legacy come deprecato, e una versione futura lo rimuoverà.
Test 2: dove finisce un'esecuzione quando n8n è spento?
È il cambiamento più grande della 2.45, e quello a cui abbiamo dedicato più tempo. Il vecchio scheduler in memoria tiene la prossima esecuzione nel processo. La documentazione lo dice chiaramente: «I riavvii perdono le esecuzioni in sospeso». Un'esecuzione che scade durante un'interruzione viene saltata. Il durable scheduler scrive prima ogni esecuzione nel database, quindi un'esecuzione mancata «resta registrata». Se n8n torna attivo entro il periodo di tolleranza, l'esecuzione parte in ritardo. Oltre il periodo di tolleranza, decide la policy per le esecuzioni mancate.
Per confrontare due policy nella stessa interruzione, abbiamo pubblicato due workflow. Il workflow A è il report, con l'opzione predefinita «Don't Run Missed Executions». Il workflow B è un heartbeat. Non chiama nessuna API e scrive solo l'ora in un file, quindi non costa nulla. B usa «Run the Most Recent Missed Execution».
Entrambi girano ogni 3 minuti sulla stessa fase. Uno script fermava n8n con SIGTERM tramite il process ID, aspettava che il processo terminasse e lo riavviava a un orario stabilito. Lo script registrava ogni orario.
| Interruzione (ora di Singapore) | Orari previsti durante l'interruzione | Workflow A (skip) | Workflow B (most recent) |
|---|---|---|---|
| 10:45:12 → 10:45:40, pronto alle 10:45:44 | 10:45:24 | Eseguito alle 10:45:46,0, con 21,8 s di ritardo | Eseguito alle 10:45:46,0, con 21,8 s di ritardo |
| 10:49:00 → 10:55:40, pronto alle 10:55:44 | 10:51:24 e 10:54:24 | Nessuna delle due eseguita | Un recupero alle 10:55:53, con 89,0 s di ritardo |
Primo arresto: 32 secondi, entro il periodo di tolleranza. Abbiamo fermato n8n alle 10:45:12 SGT, lo abbiamo riavviato alle 10:45:40 ed era pronto alle 10:45:44. L'orario previsto delle 10:45:24 cadeva nel mezzo dell'arresto. L'esecuzione era già nella tabella scheduled_task prima dell'arresto. La finestra di materializzazione, N8N_SCHEDULER_MATERIALIZATION_WINDOW, è di 60 secondi per impostazione predefinita, quindi ogni esecuzione riceve la sua riga circa un minuto prima. Dopo il riavvio, A e B sono partiti entrambi alle 10:45:46,0, cioè con 21,8 secondi di ritardo, entro i 60 secondi di tolleranza.
Un dettaglio: prima dell'arresto, missedAfter per entrambe le righe era 10:46:24,206, cioè l'orario previsto più 60 secondi. Dopo il riavvio, n8n lo ha cambiato in 10:46:45,677. Sembra che il riavvio abbia concesso un nuovo periodo di tolleranza a partire dall'orario di avvio. Lo abbiamo visto una sola volta e non abbiamo approfondito la regola.
Secondo arresto: 6 minuti e 44 secondi, a cavallo di due orari previsti. Abbiamo fermato n8n alle 10:49:00 SGT, lo abbiamo riavviato alle 10:55:40 ed era pronto alle 10:55:44. Gli orari previsti delle 10:51:24 e delle 10:54:24 cadevano entrambi nell'arresto, ed entrambi avevano superato i 60 secondi di tolleranza quando n8n è tornato attivo. Il risultato corrispondeva alla documentazione.
A non è stato eseguito in nessuno dei due casi, e la sua esecuzione successiva è stata alle 10:57:24. B è stato eseguito una volta, alle 10:55:53. Quell'esecuzione appartiene all'orario previsto delle 10:54:24, il più recente, ed è partita con 89,0 secondi di ritardo. B non ha eseguito un recupero separato per le 10:51:24.
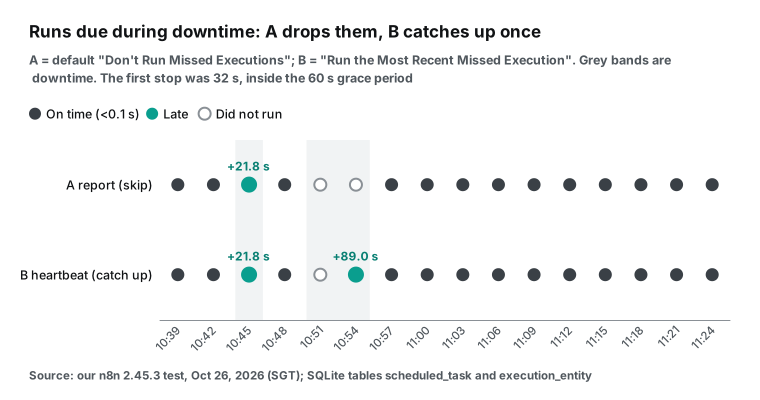
I dati delle esecuzioni da soli non bastano, perché un'esecuzione mancata semplicemente non c'è. Così abbiamo attivato le metriche Prometheus di n8n e letto /metrics una volta, alle 10:56:30 SGT, dopo il secondo riavvio. I contatori partono da zero all'avvio del processo, quindi mostrano solo il secondo arresto.
| Metrica | Valore | Significato |
|---|---|---|
n8n_scheduler_occurrences_misfired_total{policy="skip"} | 2 | A ha scartato le 10:51:24 e le 10:54:24 |
n8n_scheduler_occurrences_misfired_total{policy="coalesce_owner"} | 1 | B ha accorpato le 10:51:24 nel recupero |
n8n_scheduler_occurrences_materialized_total | 1 | Il recupero di B è entrato in coda |
n8n_scheduler_tasks_dispatched_total | 1 | È stata inviata un'esecuzione |
n8n_scheduler_tasks_completed_total{result="success"} | 1 | Il recupero è riuscito |
n8n_scheduler_tasks_reclaimed_total | 0 | Nessuna esecuzione lasciata a metà è stata ripresa in carico |
Gli intervalli tra le esecuzioni del report mostrano chiaramente entrambi gli arresti. Il primo arresto ha fatto partire un'esecuzione con 21,8 secondi di ritardo, quindi gli intervalli prima e dopo sono stati di 201,8 e 158,2 secondi. Sommati fanno comunque 360 secondi, quindi la fase non si è spostata. Il secondo arresto ha fatto saltare due esecuzioni, e quell'intervallo è stato di 540,0 secondi, esattamente tre periodi.
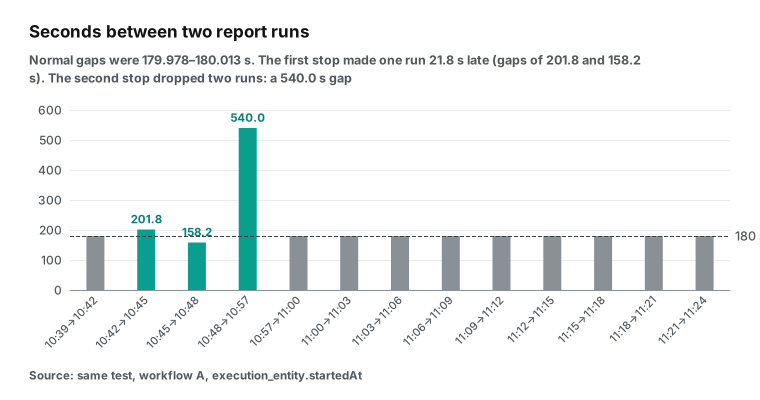
Tre fonti raccontano la stessa storia: i dati delle esecuzioni, la tabella scheduled_task e le metriche. Per questo consideriamo J4 superato. La pagina delle variabili dello scheduler spiega ogni contatore. n8n pubblica anche una dashboard Grafana già pronta. Se altre persone leggono il tuo report, imposta un avviso su occurrences_misfired_total. Quando aumenta, il report di un giorno non è stato generato.
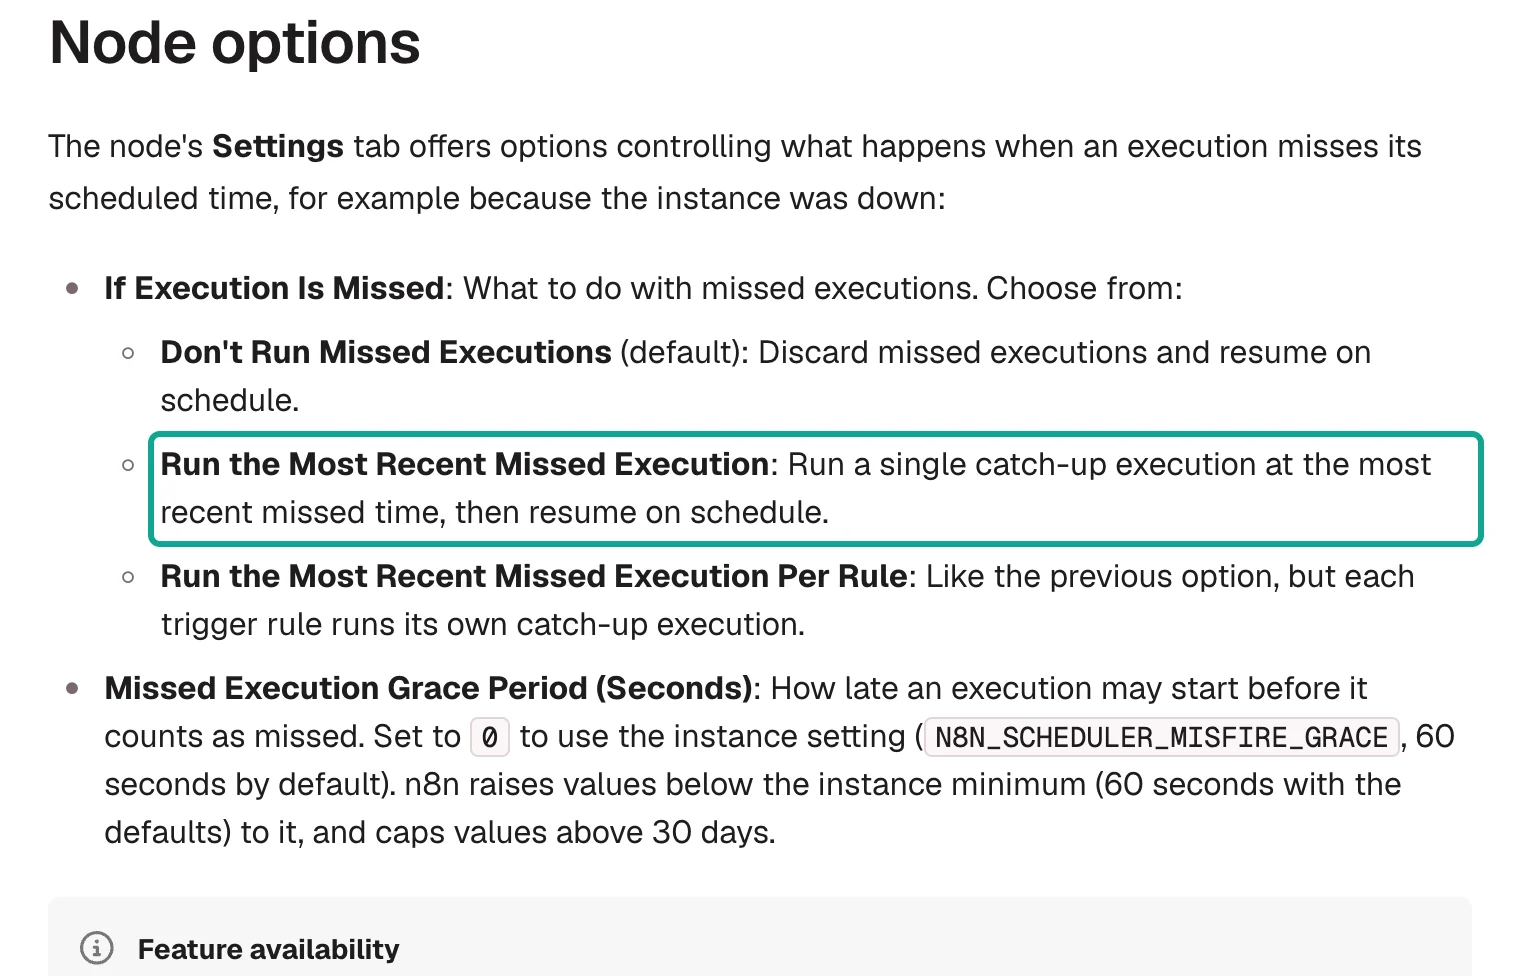
Quale policy è giusta per un report giornaliero? Consigliamo “Run the Most Recent Missed Execution”, insieme alla chiave basata sulla data del passaggio 3. Un report giornaliero richiede una copia al giorno. Dopo un arresto, vuoi la copia di oggi. Se n8n torna attivo il giorno dopo, il recupero usa la nuova data e una nuova chiave, quindi ottieni la copia del nuovo giorno. La policy predefinita, che salta le esecuzioni mancate, è adatta ai job che in ritardo non servono più, come un heartbeat ogni minuto.
Imposta il periodo di tolleranza in base al tempo di riavvio. La documentazione dice che deve essere più lungo dell'intervallo dell'executor e non più breve della finestra di materializzazione, il che con i valori predefiniti dà 60 secondi. Se sulla tua macchina un riavvio per aggiornamento richiede 3 minuti, imposta la tolleranza del nodo a 300 secondi.
Test 3: i costi e il replay che sembra addebitato
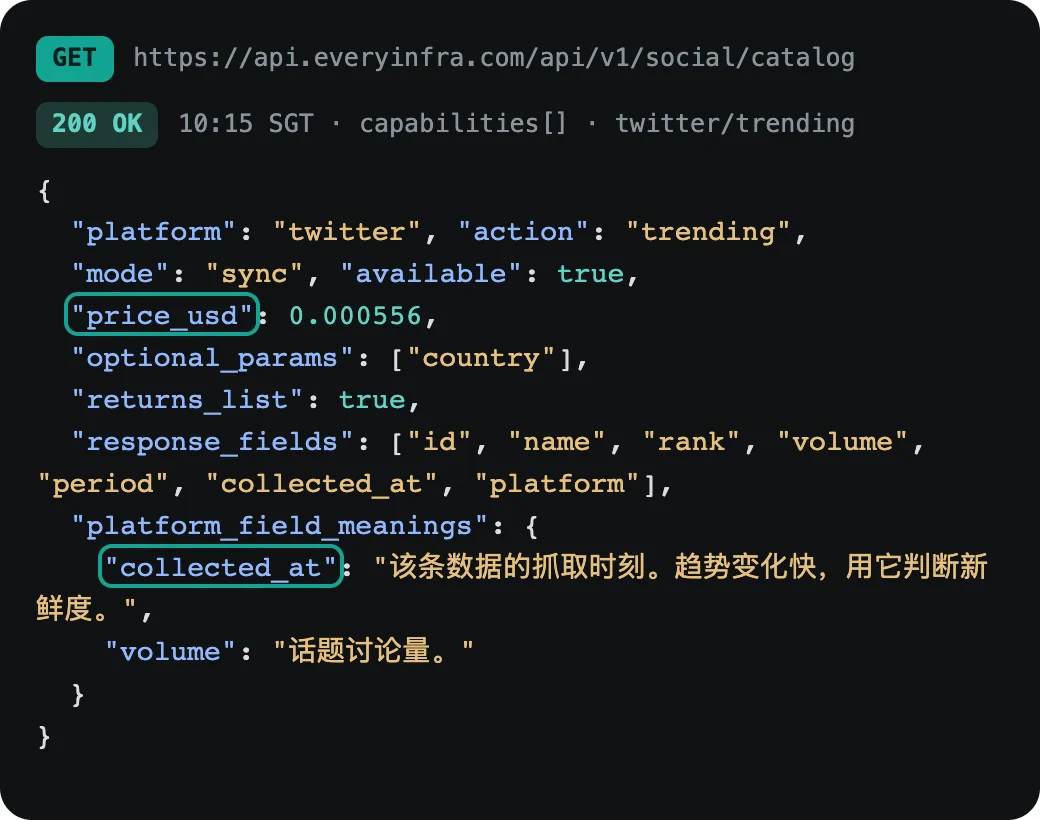
Ogni esecuzione chiama 4 funzionalità di tendenza: twitter/trending per gli Stati Uniti e per il Messico, weibo/trending e douyin/trending. Nel catalogo EveryInfra, letto alle 10:15 SGT, tutte e tre hanno price_usd pari a 0,000556 per chiamata. Quindi ogni esecuzione dovrebbe costare 4 × 0,000556 $ = 0,002224 $. Questa è la risposta reale del catalogo per twitter/trending. I riquadri verde acqua evidenziano il prezzo e il significato di collected_at.
Escludendo i replay, tutte le 14 esecuzioni sono costate esattamente 0,002224 $. Il totale è stato di 0,031136 $.
Non ci siamo fidati solo delle risposte. Dopo il test abbiamo letto il log delle chiamate sul server con GET /portal/api/logs e abbiamo confrontato ogni request_id. Tutte le 56 chiamate addebitate delle 14 esecuzioni erano presenti nel log. Ognuna aveva un cost di 40 crediti, cioè $0.000556, lo stesso valore di charged_usd nella risposta fino alla sesta cifra decimale (6 decimali). Le 14 chiamate che hanno restituito 422 non avevano alcuna voce nel log delle chiamate. Quindi non sono state addebitate.
La trappola è il replay. Alle 10:40:46 SGT abbiamo rinviato con curl la chiamata Weibo dell'esecuzione delle 10:39, con la stessa chiave daily-report-20261026-1039-weibo-default.
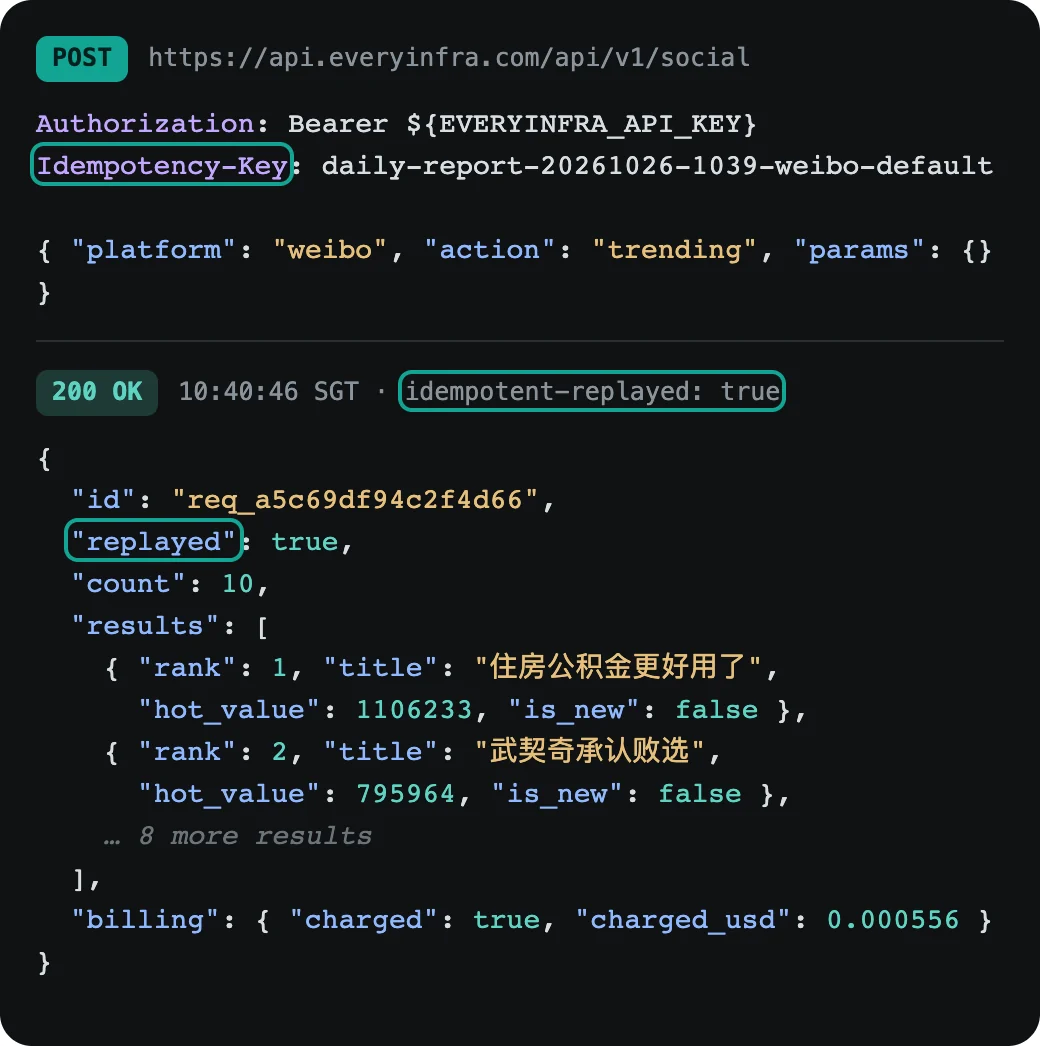
La risposta è stata 200, con l'header idempotent-replayed: true e replayed: true nel corpo. L'id era quello della prima chiamata, req_a5c69df94c2f4d66. La nuova richiesta aveva un proprio ID nell'header x-request-id, req_7278432b29f64594. Il log del server non riportava un secondo addebito. Però il blocco billing indicava ancora "charged": true, "charged_usd": 0.000556.
Il testo OpenAPI spiega il motivo. Un replay restituisce la prima risposta salvata, con lo “stesso billing, senza eseguire né addebitare di nuovo”. Quindi billing descrive il primo addebito, non questa chiamata.
In un report giornaliero, questo si traduce nel grafico qui sotto. Abbiamo impostato KEY_BY su day ed eseguito il workflow due volte a mano con n8n execute; i record delle esecuzioni riportano come orari di inizio 10:56:46.565 e 10:57:04.358 SGT. Nella seconda esecuzione tutte e 4 le chiamate erano replay, e l'addebito effettivo è stato di 0 $. Un report che somma ogni charged_usd, come fa la maggior parte dei tutorial, mostrerebbe 0,002224 $ per la seconda esecuzione.
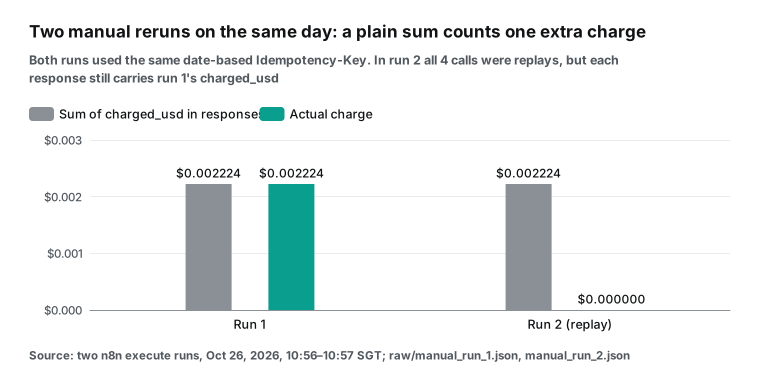
Quindi conta solo le chiamate in cui replayed non è true. Il nostro report mostra entrambi i numeri. Quando i due numeri sono diversi, quel giorno c'è stata una riesecuzione, e puoi scoprire chi l'ha lanciata e perché.
Abbiamo testato anche l'altro caso. Alle 10:40:54 SGT abbiamo inviato la stessa chiave con parametri diversi. L'API ha restituito 409 idempotency_conflict, e next_steps diceva “send the new request with a new key. Nothing was charged.” Quindi una chiave basata sulla data deve contenere anche la piattaforma e i parametri. Altrimenti due liste diverse nello stesso giorno si bloccano a vicenda. Per questo la chiave del passaggio 3 contiene la piattaforma e il paese.
Quanto costa
Questo è il conto dell'intero test. Tutti gli importi sono l'addebito effettivo al netto dei replay, verificato con il log del server.
| Voce | Chiamate | Addebito |
|---|---|---|
| 14 esecuzioni pianificate del report, 4 chiamate addebitate ciascuna | 56 | $0.031136 |
| 14 chiamate errate di proposito (422) | 14 | $0 |
| 2 esecuzioni manuali con una chiave basata sulla data: 4 chiamate addebitate, 4 replay, 2 chiamate errate | 10 | $0.002224 |
| 1 chiamata con MCP Client | 1 | $0.000556 |
| 1 replay con curl, 1 conflitto di chiave (409), 1 nome di board errato inviato da solo (422), 1 chiamata senza chiave (401) | 4 | $0 |
| Totale per le chiamate a EveryInfra | 85 | $0.033916 |
Per il tuo report, il costo dipende dalla pianificazione:
| Pianificazione | Chiamate addebitate al giorno | Al giorno | 30 giorni |
|---|---|---|---|
| Una volta al giorno alle 8:00, 4 liste | 4 | $0.002224 | $0.06672 |
| Due volte al giorno, alle 8 del mattino e alle 8 di sera | 8 | $0.004448 | $0.13344 |
| Ogni ora | 96 | $0.053376 | $1.60128 |
| Una volta al giorno, più un recupero e una riesecuzione manuale (chiave basata sulla data) | 4 addebitate + 8 replay | $0.002224 | $0.06672 |
Tutti i prezzi provengono da price_usd del catalogo, letto il 26 ottobre 2026 alle 10:15 SGT. L'ultima riga mostra il valore della chiave: per quante volte tu riesegua nello stesso giorno, paghi una volta sola.
C'è un altro dato facile da trascurare. Le classifiche dei contenuti di tendenza sono addebitate per chiamata, non per riga. Con gli stessi 0,000556 $, la lista X del Messico ha restituito 71 righe e le liste Weibo e Douyin 20 righe ciascuna (mediane di 14 esecuzioni). Per 1.000 righe, la differenza è di 3,6×.
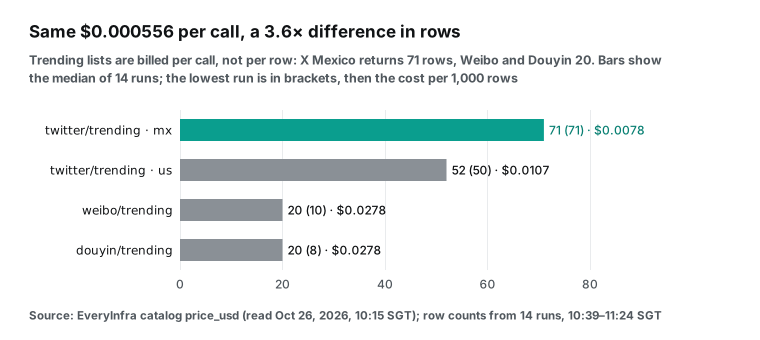
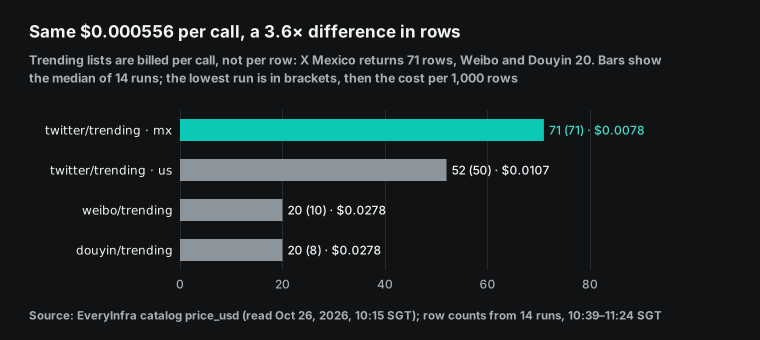
Anche il numero di righe cambia da una chiamata all'altra. Nella prima esecuzione delle 10:39 SGT, Weibo ha restituito 10 righe e Douyin 8. Nelle 13 esecuzioni successive, Douyin ha restituito sempre 20 righe, e Weibo da 15 a 20, quasi sempre 20. È il default_limit di entrambe nel catalogo, e weibo/trending ha un max_limit di 200. Le regole della hot search di Weibo descrivono una Top 50 che si aggiorna ogni minuto, quindi con il valore predefinito ne ottieni solo una parte.
Il nostro report usa solo la top 10, quindi la prima esecuzione ha perso solo 2 posizioni di Douyin. Ti serve la lista completa? Verifica nel catalogo se limit è consentito. Poi conferma il numero di righe con una chiamata reale. Scrivi anche nel report il numero di righe di ogni esecuzione.
Non fare stime partendo dal valore predefinito. Anche una risposta corta costa 0,000556 $, quindi tienine conto quando calcoli un prezzo per riga.
Test 4: una chiamata errata, e il report arriva lo stesso
In ogni esecuzione, la quinta chiamata imposta il valore boards di Douyin su hot. Il valore corretto è hotspot. In tutte le 14 esecuzioni questa chiamata ha restituito 422, il report è arrivato comunque e le altre 4 liste erano complete. Questa è la risposta reale dell'esecuzione delle 10:39:
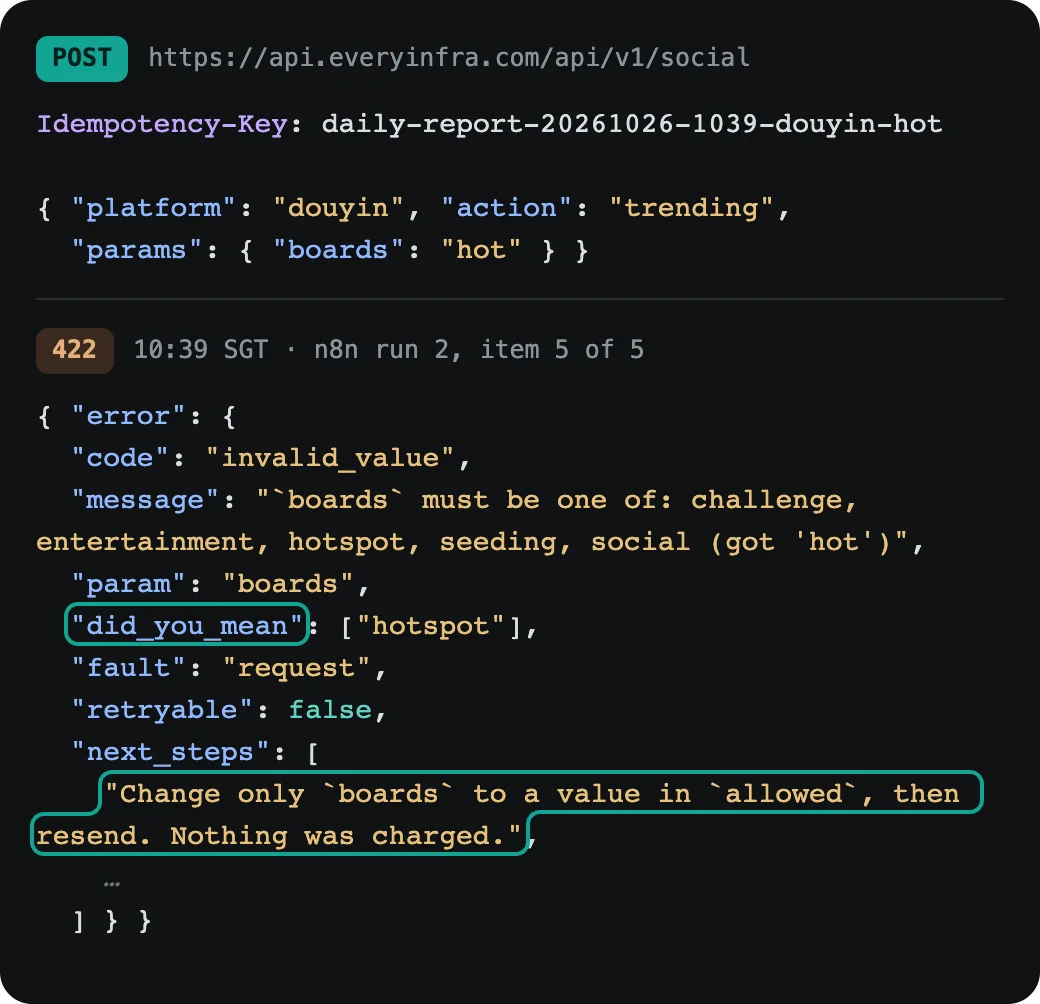
Perché questa risposta è adatta all'automazione? Fornisce la correzione in campi che un programma può leggere. allowed elenca i valori validi. did_you_mean indica quello più vicino. retryable: false ti dice che la stessa richiesta fallirà di nuovo.
La prima riga di next_steps dice “Nothing was charged”. Il nostro nodo del report copia message e did_you_mean nel report, così chi legge sa che deve cambiare il valore in hotspot. Lo stato 422 è “Unprocessable Content” nella RFC 9110: la richiesta è formata correttamente, ma il suo contenuto non può essere elaborato. Un nuovo tentativo con la stessa richiesta non può riuscire.
L'opzione “Never Error” del passaggio 4 è ciò che fa funzionare questo design. Senza di essa, n8n segna l'esecuzione come fallita e avvia il tuo workflow di errore (pagina sulla gestione degli errori), e quel giorno non c'è alcun report. Per un file che le persone leggono ogni giorno, una lista mancante è molto meglio di nessun file. Questa tabella elenca le risposte che abbiamo provocato nel test o trovato nel testo OpenAPI, con ciò che il report dovrebbe fare.
| Caso | Stato e codice | Addebito | Cosa fa il report |
|---|---|---|---|
| Nessuna chiave | 401 missing_key | Nessuno (“Nothing was charged”) | Interrompi l'esecuzione, invia un avviso, controlla la credenziale |
| Valore non consentito | 422 invalid_value | Nessuno | Annota il motivo e did_you_mean, mantieni le altre liste |
| Stessa chiave, parametri diversi | 409 idempotency_conflict | Nessuno | Correggi lo schema della chiave |
| Stessa chiave, prima chiamata ancora in corso | 409 idempotency_in_progress con Retry-After | Nessuno | Attendi Retry-After, poi invia di nuovo |
| Di nuovo la stessa chiave | 200, replayed: true | Nessun nuovo addebito, billing è quello della prima chiamata | Conta il costo una sola volta |
| Successo senza righe | 200, count: 0 | Rimborso completo | Scrivi “questa lista oggi è vuota” |
| Esito del rimborso sconosciuto | 503 | Da verificare | Non fare nuovi tentativi alla cieca, controlla prima il log delle chiamate |
I primi cinque casi li abbiamo provocati noi. Il 401 viene da una chiamata senza chiave alle 10:18 SGT, e conserviamo la risposta grezza. Le ultime due righe vengono dal testo OpenAPI. Non le abbiamo provocate in questo test.
Test 5: la stessa funzionalità tramite il nodo MCP Client
n8n ha anche un nodo MCP Client. Usa gli strumenti di qualsiasi server MCP come un normale passaggio del workflow. L'endpoint MCP di EveryInfra è https://api.everyinfra.com/mcp. Per elencare gli strumenti non serve una chiave, e alle 10:39 SGT ne risultavano 25. Abbiamo chiamato everyinfra_call_api una volta con gli stessi parametri di una chiamata REST:
{
  "type": "@n8n/n8n-nodes-langchain.mcpClient",
  "typeVersion": 1.1,
  "parameters": {
    "endpointUrl": "https://api.everyinfra.com/mcp",
    "authentication": "bearerAuth",
    "tool": { "__rl": true, "mode": "id", "value": "everyinfra_call_api" },
    "inputMode": "json",
    "jsonInput": "{\"platform\":\"weibo\",\"action\":\"trending\",\"params\":{}}",
    "options": { "timeout": 90000 }
  },
  "credentials": { "httpBearerAuth": { "id": "eiBearer000001", "name": "EveryInfra API Key" } }
}
L'abbiamo eseguito alle 10:39:52 SGT con n8n execute --id=eiMcpCheck0001. Il nodo ha impiegato 9,3 secondi. content[0].text è tornato come oggetto con i campi di primo livello id, platform, action, results, count, billing, quota e async_hint. Il conteggio era 10, l'addebito era di 0,000556 $ e il log del server conteneva la chiamata (req_0e075488e27f44e6, 10:40:01). Ogni risultato aveva rank, title, hot_value, is_hot, is_new, label, url e platform, gli stessi campi della risposta REST nello stesso momento. Il trasporto era quello predefinito, Streamable HTTP, uno dei due trasporti standard della specifica MCP del 2025-11-25.
| REST con HTTP Request | MCP Client | |
|---|---|---|
| Richiesta | POST /api/v1/social | tools/call su everyinfra_call_api |
| Righe Weibo | 10 nella prima esecuzione | 10 |
| Addebito | $0.000556 | $0.000556 |
| Nel log lato server | Sì, con il relativo request_id | Sì, req_0e075488e27f44e6 |
Header Idempotency-Key | Sì | Non c'è un posto dove inserirlo |
| Adatto a | Chiamate pianificate fisse | Un modello che sceglie cosa cercare |
Allora perché non usare MCP per il report? Per due motivi. Primo, il nodo HTTP Request può inviare un header Idempotency-Key, mentre il nodo MCP Client non ha un posto per inserirlo negli argomenti dello strumento. Senza la chiave, un'esecuzione di recupero non ha la protezione “un solo addebito al giorno”. Secondo, MCP dà il meglio quando è un modello a scegliere lo strumento e a costruire gli argomenti.
Un report con 5 chiamate fisse non ne ha bisogno. MCP Client è adatto dopo un nodo AI Agent, dove un modello legge il report e decide se approfondire un argomento. Per questo caso n8n ha un nodo MCP Client Tool separato.
La riga di comando nasconde un'altra trappola. Mentre il servizio n8n è in esecuzione, n8n execute avvia un proprio task broker sulla stessa porta. Abbiamo impostato N8N_RUNNERS_BROKER_PORT=5692 solo per quel comando, e così ha funzionato. Per configurare l'MCP di EveryInfra in Claude, Cursor e altri client, leggi la guida alla configurazione dell'MCP remoto. La pagina del server MCP contiene altri dettagli.
Quanto sono cambiate le liste in 45 minuti
Basta un report al giorno? Dipende da quanto velocemente cambia ogni lista. Abbiamo misurato solo 45 minuti, dalle 10:39 alle 11:24 SGT, quindi questa analisi risponde a “nell'arco di un'ora” e non a “nell'arco di un giorno”. Il nostro script di analisi analysis.py calcola tutti i numeri dai 14 record delle esecuzioni.
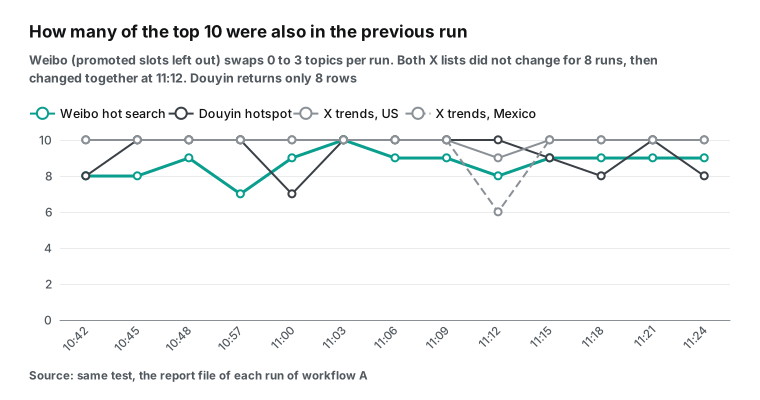
Ecco i numeri lista per lista. Per la hot search di Weibo contiamo per rank ed escludiamo le posizioni sponsorizzate (da 0 a 2 delle prime 10 posizioni in ogni esecuzione; contando per posizione, sembravano nuovi argomenti). Tra due esecuzioni sono rimasti da 7 a 10 argomenti della top 10, quindi da 0 a 3 argomenti sono cambiati ogni 3 minuti, e in 9 coppie su 13 è cambiato un solo argomento o nessuno. L'argomento al numero 1 è cambiato due volte, alle 10:57 e alle 11:18 SGT. Solo 4 argomenti erano sia nella prima sia nell'ultima top 10.
Il numero 1 fissato in cima alla lista hotspot di Douyin non è mai cambiato. Tra due esecuzioni sono rimasti da 7 a 10 argomenti, e 5 erano sia nella prima sia nell'ultima lista (la prima esecuzione aveva solo 8 righe).
Nessuna delle due liste X è cambiata nelle prime 8 esecuzioni. Poi, nell'esecuzione delle 11:12, sono cambiate entrambe insieme. Nella lista degli Stati Uniti, “Chiefs” è salito al numero 1. Nella lista del Messico, un nuovo hashtag di un programma TV è entrato al numero 2, e solo 6 argomenti sono rimasti rispetto all'esecuzione precedente. Dopo, entrambe le liste sono tornate stabili. Tra la prima e l'ultima esecuzione sono rimasti 9 argomenti nella lista degli Stati Uniti e 6 in quella del Messico.
| Lista | Mantenuti tra due esecuzioni consecutive | Prima e ultima esecuzione | Argomenti diversi in 45 min | Cambi del n. 1 |
|---|---|---|---|---|
| Weibo (posizioni sponsorizzate escluse) | 7–10 | 4 | 21 | 2 (10:57 e 11:18) |
| Douyin | 7–10 | 5 | 18 | 0 (il n. 1 è fissato) |
| X Stati Uniti | 9–10 | 9 | 11 | 1 (11:12) |
| X Messico | 6–10 | 6 | 14 | 0 |
Ecco, a confronto, l'effetto delle posizioni sponsorizzate sui numeri di Weibo:
| Hot search di Weibo, 14 esecuzioni | Per posizione (primo report) | Per `rank`, posizioni sponsorizzate escluse (corretto) |
|---|---|---|
| Sovrapposizione della top 10 tra due esecuzioni | 7–9 | 7–10 |
| Sovrapposizione tra prima e ultima esecuzione | 4 | 4 |
| Argomenti distinti in 45 minuti | 27 | 21 |
| Posizione di Lula alle 10:39 | 5th | 4th |
| Cambi dell'argomento al numero 1 | 2 | 2 |
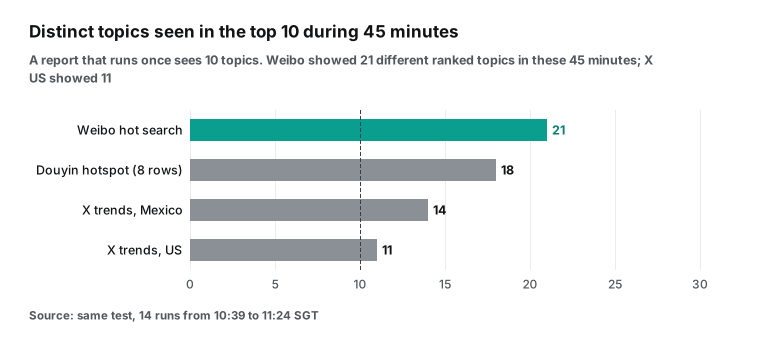
Ecco gli stessi dati visti da un'altra prospettiva. In 45 minuti, 21 argomenti classificati diversi sono entrati nella top 10 di Weibo (27 contando per posizione; i 6 in più sono posizioni sponsorizzate a rotazione), 18 in quella di Douyin, 14 in quella di X Messico e 11 in quella di X Stati Uniti. Un report eseguito una volta al giorno ne mostra 10 per lista. Per X, questo copre gran parte dell'ora. Per Weibo, più della metà degli argomenti entrati nella top 10 in quest'ora (11 su 21) non compare mai nel tuo report.
Questi numeri mostrano che le quattro liste si muovono a velocità diverse. Non dimostrano che una lista sia migliore. Le liste X erano aggiornate a ogni chiamata: collected_at precedeva ogni chiamata di pochi secondi, per esempio 10:39:34 e 10:42:35 SGT. La top 10 è rimasta per lo più invariata e poi è cambiata in un colpo solo. In questo periodo, le elezioni brasiliane della notte precedente occupavano le prime posizioni.
Abbiamo visto un solo cambio di questo tipo, quindi non possiamo dire con quale frequenza X aggiorni le sue liste. La pagina di X sui consigli delle tendenze dice che le tendenze sono argomenti “popolari adesso”. Dice anche che X esclude gli account nuovi e quelli con pochi follower, e rileva le tendenze per paese, regione e città. Quindi le tendenze di X si muovono più lentamente della hot search di Weibo, che si aggiorna ogni minuto.
Per il tuo report, questo significa che una o due esecuzioni al giorno bastano per seguire le grandi notizie su X. Per seguire gli alti e bassi di Weibo, con un'esecuzione al giorno perdi molti argomenti che salgono e scendono tra un'esecuzione e l'altra. Esegui il report più spesso, oppure conserva ogni lista e riporta “tutti gli argomenti visti oggi”.
La chiave è finita su disco?
Un report resta in funzione a lungo. Anche una chiave che finisce in un'esportazione, nei dati delle esecuzioni o in un backup ci resta a lungo.
Dopo il test, alle 11:25 SGT, abbiamo fermato n8n e cercato il testo della chiave in tre posti. Il primo era l'intera cartella dei dati di n8n, con il database SQLite, il suo file WAL, il log degli eventi e il file delle impostazioni. Il secondo erano i 16 report in reports/. Il terzo erano tutti i file grezzi di questo articolo. Le corrispondenze sono state 0.
La tabella delle credenziali contiene solo il valore cifrato. Nei dati delle esecuzioni, l'output del nodo HTTP Request contiene lo stato, gli header della risposta e il corpo, ma non gli header della richiesta. Nemmeno i dati di errore delle chiamate 422 contenevano la chiave.
Abbiamo esaminato di proposito i dati di errore. Il 14 ottobre n8n ha corretto un problema simile: GHSA-qmvv-q3c9-wpp7 riguarda i nodi Git, MongoDB Atlas Vector Store e Google Cloud Storage. Quando un'operazione falliva, questi nodi inserivano nei dati di errore una password o un token presi dalla loro credenziale. Un utente in grado di vedere i dati delle esecuzioni ma non la credenziale poteva leggere il segreto. Le versioni corrette sono 1.123.85, 2.44.1 e 2.43.5.
Il nodo HTTP Request non è nell'elenco, e il nostro test non ha trovato fughe di dati. Però questo caso mostra perché conviene cercare segreti nei dati delle esecuzioni dopo ogni aggiornamento.
I problemi che abbiamo incontrato davvero
Ogni riga qui sotto descrive un problema che si è verificato durante questo test, in ordine. La maggior parte non sono bug di n8n. Nascono dai nuovi valori predefiniti della 2.x quando si usa la riga di comando.
| Sintomo | Causa | Soluzione |
|---|---|---|
L'avvio fallisce con Cannot find module 'kuler' | Il primo npm install si è interrotto a metà, e una seconda installazione non l'ha riparato | Elimina node_modules e package-lock.json, poi reinstalla (6 minuti) |
| n8n esce subito: “Task Broker's port 5679 is already in use” | N8N_PORT era 5679, la porta predefinita del task broker integrato | Usa un'altra porta, oppure imposta N8N_RUNNERS_BROKER_PORT |
publish:workflow riesce, ma non parte nulla secondo la pianificazione | Il comando scrive nel database, e un'istanza n8n in esecuzione non lo rilegge | Riavvia n8n; il comando stampa questo avviso |
| Le esecuzioni cadono al secondo :24, non al minuto esatto | Dalla 2.45, “ogni N minuti” si conta dall'attivazione | Usa “Days” o “Hours”, oppure un'espressione cron |
n8n execute fallisce mentre il servizio è in esecuzione | Il comando avvia un secondo task broker sulla stessa porta | Imposta N8N_RUNNERS_BROKER_PORT e N8N_PORT per quel comando |
| “Sovrapposizione con l'ultima esecuzione” è sempre vuota nelle esecuzioni manuali | I dati statici vengono salvati solo per i workflow pubblicati avviati da un trigger | Comportamento previsto; usa le data table se ti servono nei test |
| Molti avvisi di deprecazione all'avvio | La linea 2.x prepara la 3.0 | Va bene per un test; per l'uso quotidiano passa a Docker e a un task runner esterno |
La prima riga ci è costata più tempo, ed è facile interpretarla male. L'errore cita un pacchetto di logging che non ha nulla a che fare con n8n, quindi sembra un problema di Node.js. Non lo è. L'installazione non è terminata, e un'installazione pulita risolve il problema.
Leggi insieme la terza e la quarta riga. Nell'editor, la scrittura nel database e l'attivazione del workflow avvengono con lo stesso clic, quindi la fase è il secondo in cui fai clic. Con la riga di comando e un riavvio, la fase è il secondo in cui il riavvio attiva il workflow. Nel nostro test, i due momenti erano a 3 minuti e 25 secondi di distanza. Se distribuisci i report dalla riga di comando e ti serve che “ogni N minuti” sia allineato con un altro sistema, la fase viene fissata al riavvio.
Gli avvisi di deprecazione meritano una lettura attenta. Il nostro log di avvio delle 10:36 SGT ne elencava sei. N8N_UNVERIFIED_PACKAGES_ENABLED avrà come valore predefinito false. La modalità interna del task runner verrà rimossa, e dovresti passare alla modalità esterna. Il timeout dei task N8N_RUNNERS_TASK_TIMEOUT scenderà da 300 a 60 secondi.
Due limiti del nodo di compressione verranno ridotti. Infine, “Running n8n outside a container is deprecated”. Per i report conta il timeout dei task. Dopo la 3.0, un task del nodo Code che dura più di 60 secondi si interrompe, quindi imposta tu il timeout o suddividi il lavoro. La pagina sui task runner spiega la modalità esterna.
Come verificarlo da solo in SQLite
L'editor di n8n elenca le esecuzioni, ma non mostra “un'esecuzione che doveva avvenire e non è avvenuta”. Lo scheduler durevole conserva questa informazione in due tabelle, e sqlite3 può leggerle. Abbiamo usato queste tre query per decidere da J1 a J4:
DB=$HOME/Downloads/n8n-lf25/home/.n8n/database.sqlite
# 1. Phase, interval, misfire policy and grace of each schedule
sqlite3 -header $DB "select name, intervalSeconds, nextRunAt, lastFiredAt, misfirePolicy, misfireGraceSeconds from scheduled_job;"
# 2. Each run in the queue: planned time, actual start, latest allowed start
sqlite3 -header $DB "select id, jobId, status, scheduledFor, startedAt, missedAfter from scheduled_task order by id;"
# 3. Runs that executed: trigger mode, status, start time (all times in UTC)
sqlite3 -header $DB "select id, workflowId, mode, status, startedAt from execution_entity order by id;"
Tieni a mente tre cose. Primo, tutti gli orari sono in UTC. Aggiungi 8 ore per l'ora di Singapore, oppure sottrai 4 ore per l'ora di New York fino al 1° novembre.
Secondo, scheduled_task contiene solo le esecuzioni entrate nella coda. La finestra è di 60 secondi per impostazione predefinita. Un'esecuzione prevista durante il fermo, e già oltre la sua tolleranza quando n8n è tornato attivo, non compare mai in questa tabella. Quindi non puoi contare le esecuzioni perse contando le righe. Ricavale dalla fase, oppure leggi n8n_scheduler_occurrences_misfired_total.
Abbiamo fatto esattamente così: le esecuzioni di A delle 10:51:24 e delle 10:54:24 SGT non hanno una riga. Le abbiamo trovate con “fase + 180 s × k” e le abbiamo confrontate con il valore 2 del contatore.
Terzo, le esecuzioni completate restano per un giorno per impostazione predefinita (N8N_SCHEDULER_RETENTION è 86.400 secondi), mentre quelle fallite o mancate restano per sette giorni. Per una revisione mensile, esportale secondo una pianificazione. Noi abbiamo esportato le tre tabelle in executions.json, e il nostro script di analisi analysis.py calcola ogni orario di questo articolo da quel file.
Questa tabella associa ogni criterio di superamento alle prove che lo hanno deciso. Conserviamo ogni file.
| Verifica | Prova | Cosa abbiamo confrontato |
|---|---|---|
| J1–J3 | executions.json (tabelle execution_entity, scheduled_task, scheduled_job) | Orario di inizio rispetto all'orario previsto, intervalli, fase |
| J4 | executions.json, metrics_1057.txt | Righe mancanti rispetto ai contatori |
| J5 | run_*.json, logs_*.json | charged_usd per chiamata rispetto a cost nel log del server |
| J6 | run_*.json | Stato 422, did_you_mean, nessuna voce nel log |
| J7 | mcp_n8n_weibo_trending.json, run_2_eiDailyReport01.json | Nomi dei campi, MCP rispetto a REST |
| J8 | analysis.json | Insiemi della top 10 tra le esecuzioni |
| J9 | Una ricerca nella cartella di n8n, nei report e nei file grezzi salvati | Il testo della chiave, 0 corrispondenze |
| J10 | replay_weibo.json, replay_weibo.headers, manual_run_*.json | replayed, header, log del server |
Riferimento dei campi: tutti i campi che il report può usare
Il report usa solo il nome e la posizione di ogni riga, ma le 4 funzionalità restituiscono di più. Abbiamo verificato questa tabella campo per campo rispetto a response_fields del catalogo, letto alle 10:15 SGT. La colonna “Questa esecuzione” mostra quali campi erano presenti nelle righe dell'esecuzione delle 10:39.
| Funzionalità | `response_fields` del catalogo | Questa esecuzione | Usati dal report | Significato (dal catalogo) |
|---|---|---|---|---|
twitter/trending | id, name, rank, volume, period, collected_at, platform | Tutti e 7 | name, rank | volume è il volume di discussione; collected_at è l'orario di acquisizione, quindi usalo per valutare quanto sono recenti i dati |
weibo/trending | rank, title, category, hot_value, label, is_hot, is_new, url, platform | Nessun category in 14 esecuzioni; label presente, vuoto, “new” o “hot” | title, rank | hot_value è il punteggio di popolarità proprio di Weibo ed è confrontabile solo all'interno della lista; is_new indica che l'argomento è nuovo nella lista |
douyin/trending | rank, keyword, hot_value, video_count, board, image_url, event_time, sentence_id, group_id, label, word_type, article_count, is_pinned, max_rank, live_room_count, topic_view_count, sentence_tag, label_icon_url, related_music_id, platform | Tutti i 20 campi visti in 14 esecuzioni; hot_value e max_rank vuoti solo per il numero 1 fissato | keyword, rank | hot_value è il punteggio di popolarità proprio di Douyin e può essere vuoto nella lista hotspot; event_time è l'orario dell'evento |
Abbiamo scoperto tre cose solo controllando le risposte grezze riga per riga. Primo, la riga fissata di Douyin (is_pinned: true) non ha hot_value, mentre le altre 19 righe lo hanno. Un ordinamento per popolarità mette la riga fissata in fondo, quindi ordina Douyin per rank.
Secondo, un campo, event_time, arrivava in due formati. La riga fissata usava “2026-10-26 10:41:56” senza fuso orario. Le altre righe usavano “2026-10-25T01:23:31.000Z” in UTC. Un semplice confronto tra stringhe dà risultati errati, quindi interpreta entrambi i formati.
Terzo, Weibo non ha mai restituito category in 14 esecuzioni. Non dare per scontato che un campo sia sempre presente. Leggilo con un valore predefinito, per esempio x.category ?? '', altrimenti il nodo Code genera un errore il giorno in cui il campo manca. Altri valori di boards potrebbero comportarsi diversamente, e non li abbiamo testati.
I parametri e i campi completi sono nella pagina dell'API per le tendenze di X, nella pagina delle tendenze di Weibo e nella pagina delle tendenze di Douyin. Le panoramiche delle piattaforme sono l'API di scraping per X, l'API di scraping per Weibo e l'API di scraping per Douyin.
La stessa chiamata in codice
Se non vuoi ancora installare n8n, questo comando curl invia la stessa richiesta del nodo HTTP Request del passaggio 4. Usalo per verificare prima la chiave e i parametri in un terminale.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer ${EVERYINFRA_API_KEY}" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: daily-report-$(TZ=America/New_York date +%Y%m%d)-twitter-us" \
  -d '{"platform":"twitter","action":"trending","params":{"country":"us"}}' \
  | jq '{replayed, count, top3: [.results[0:3][].name], charged_usd: .billing.charged_usd}'
Eseguilo una seconda volta nello stesso giorno e replayed diventa true. charged_usd mostra ancora il primo valore, ma non c'è un nuovo addebito. Nota che qui la data nella chiave usa l'ora di New York. Scegli un fuso orario per la chiave e usa lo stesso in n8n. Altrimenti, un report eseguito vicino alla mezzanotte può ricevere una nuova chiave prima o dopo del previsto.
Per ottenere una chiave e vedere il formato di richieste e risposte, parti dalla guida rapida. I prezzi di ogni funzionalità sono nella pagina dei prezzi. Il tuo report controlla anche i rimborsi delle chiamate fallite? La guida alla riconciliazione dei rimborsi per le chiamate fallite mostra come abbinare ogni addebito con charge_id e il log delle chiamate.
Altri modi per fare lo stesso lavoro
Per un report giornaliero non ti serve per forza n8n. Questa tabella riporta solo fatti che abbiamo potuto verificare, e quando è adatto ciascun metodo.
| Metodo | Un'esecuzione prevista durante il fermo | Protezione dai doppi addebiti in caso di riesecuzione | Adatto quando |
|---|---|---|---|
| Scheduler durevole di n8n 2.45+ (questo articolo) | In ritardo entro la tolleranza; oltre la tolleranza, scartata o un solo recupero | L'Idempotency-Key in ogni richiesta | Vuoi modificare il flusso da un'interfaccia, con più passaggi e un ramo per gli errori |
| n8n 2.44 e precedenti (scheduler in memoria) | Saltata, nessun recupero | Uguale | Istanze che non puoi ancora aggiornare |
| cron di sistema + script curl | Saltata (cron non esegue gli orari mancati) | Uguale, ma la chiave la costruisce il tuo script | Una o due chiamate, senza bisogno di interfaccia |
| Chiedere a mano in un client AI tramite MCP | Nessuna pianificazione | Nessuna chiave negli argomenti del tool | Una domanda occasionale, senza un output giornaliero fisso |
“Cron non recupera” descrive il cron classico. Alcuni timer possono recuperare, per esempio un timer systemd con Persistent=true. Non li abbiamo testati. La nostra regola: per una o due chiamate senza un ramo per gli errori, cron e curl sono più leggeri. Per tre o più passaggi, errori che devono finire nel report o un flusso modificato anche da altre persone, usa n8n. La nostra guida al monitoraggio della reputazione su più piattaforme segue un altro approccio, se vuoi fare un confronto.
Quando questa configurazione non è la scelta giusta
Ti serve ogni esecuzione, esattamente una volta. La policy di recupero esegue al massimo l'ultima esecuzione mancata, non tutte. Secondo la documentazione, nessuna policy riesegue gli arretrati uno per uno. Se ti serve ogni copia oraria, per esempio per calcolare una media giornaliera, controlla gli orari pianificati nel report e colma tu i vuoti.
Condividi un unico database SQLite tra più istanze n8n. Abbiamo testato una sola istanza. Secondo la documentazione, con più istanze main ogni esecuzione viene presa in carico da una sola istanza, ma servono Postgres e la queue mode, che non abbiamo testato.
Ti serve la lista completa. Per impostazione predefinita ogni chiamata restituisce 20 righe, e la prima chiamata ne ha restituite solo 10 e 8 (vedi il Test 3).
Ti serve una finestra lunga. Abbiamo misurato 45 minuti la mattina del 26 ottobre (SGT). Era il giorno dopo le elezioni in Brasile, quando un'unica notizia era in cima a tutte le classifiche.
Modifiche recenti
- 20 ottobre 2026: n8n 2.45 attiva il durable scheduler per impostazione predefinita. Vedi il changelog e le release notes su GitHub. La release rimuove anche la variabile inutilizzata
N8N_SCHEDULER_MIN_INTERVAL. Cosa cambia per te: dopo l'aggiornamento, “ogni N minuti” assume una nuova fase e il downtime viene gestito in modo diverso, quindi rivedi la policy per le esecuzioni mancate di ogni workflow pianificato. - Dalla 3.0: solo Docker. La pagina delle breaking changes della 3.0 chiude il supporto a npm e a
npx n8ne rimuove i vecchi nodi Cron e Interval. Cosa cambia per te: l'installazione via npm di questo articolo serve per i test; sposta i report di lunga durata su Docker e sostituisci i nodi Cron con lo Schedule Trigger. - 14 ottobre 2026: aggiornamento di sicurezza di n8n. L'aggiornamento elenca 15 advisory, tra cui credenziali nei dati di errore delle esecuzioni. Cosa cambia per te: mantieni le istanze self-hosted all'ultima patch e, dopo un aggiornamento, cerca eventuali segreti nei dati delle esecuzioni.
- 14 ottobre 2026: secondo Censys, n8n è il prodotto legato all'AI più esposto. Il report di Censys conta 113.926 host. Cosa cambia per te: un n8n che genera report sulla tua macchina non ha motivo di essere esposto su internet.
- 6 ottobre 2026: Diagrid annuncia la durable execution per n8n. Un comunicato stampa a pagamento afferma che, dopo un crash, i workflow riprendono dal nodo che ha fallito. Un registro di idempotenza evita effetti collaterali ripetuti. Cosa cambia per te: n8n 2.45 garantisce che un'esecuzione dovuta non vada persa. Un crash a metà esecuzione è un problema diverso, e i partner ci stanno già lavorando.
- 12 ottobre 2026: ZoomInfo rilascia un nodo nativo per n8n. Il comunicato su Business Wire afferma che ZoomInfo offre i propri dati anche tramite API e MCP. Cosa cambia per te: i servizi di dati arrivano in n8n sia con nodi dedicati sia tramite MCP. Oggi EveryInfra non ha un nodo n8n dedicato; questo articolo usa i nodi generici HTTP Request e MCP Client.
- 22 ottobre 2026: la bozza IETF sull'Idempotency-Key arriva alla versione 08. Vedi la pagina sul datatracker IETF. Cosa cambia per te: l'idempotenza tramite header di richiesta sta diventando uno standard, quindi una chiave basata sulla data funziona anche con altre API.
FAQ
Come imposto il fuso orario di uno Schedule Trigger di n8n? (Fonte: suggerimento di Google “n8n schedule trigger time zone”, consultato il 26 ottobre 2026)
n8n self-hosted usa America/New_York per impostazione predefinita. Imposta GENERIC_TIMEZONE, per esempio su America/Chicago, e riavvia. Puoi anche impostare un fuso orario nelle impostazioni del workflow, che prevale su quella dell'istanza (pagina dello Schedule Trigger). Noi abbiamo impostato Asia/Singapore in entrambi i punti, quindi i nomi dei file usano l'ora di Singapore.
Perché lo Schedule Trigger di n8n non è partito dopo un riavvio? (Fonte: suggerimento di Google “n8n schedule trigger not running”, consultato il 26 ottobre 2026)
Controlla prima la versione. Fino alla 2.44, lo scheduler in memoria predefinito salta ogni esecuzione prevista durante il downtime. Dalla 2.45, il durable scheduler la esegue in ritardo se n8n torna attivo entro il periodo di tolleranza (60 secondi per impostazione predefinita). Oltre quel limite decide l'impostazione del nodo “If Execution Is Missed”, e anche qui il valore predefinito è saltare. Durante il nostro arresto di 6 minuti e 44 secondi, la policy predefinita ha saltato due esecuzioni, come previsto. Per recuperare, imposta “Run the Most Recent Missed Execution” e usa una chiave basata sulla data, così il recupero non viene addebitato due volte.
Come gestisco gli errori di HTTP Request in n8n senza fermare il workflow? (Fonte: suggerimento di Google “n8n http request error handling”, consultato il 26 ottobre 2026)
Attiva “Never Error” e “Include Response Headers and Status” nelle opzioni del nodo HTTP Request. Una risposta non 2xx passa così al nodo successivo come dato, e puoi creare un ramo in base a statusCode. Nelle nostre 14 esecuzioni, la chiamata errata ha restituito 422 ogni volta, e il report è arrivato ogni volta. Gli errori di EveryInfra includono next_steps, quindi puoi inserirli nel report così come sono.
Letture correlate
- Configurazione dell'MCP remoto: collega l'MCP di EveryInfra a Claude, Cursor e altri client.
- Riconciliazione dei rimborsi per le chiamate non riuscite: abbina ogni addebito al relativo rimborso.
- Vendere report tematici dai commenti di YouTube: un altro report pianificato, eseguito ogni mese.
- Specifica MCP 2026 e preparazione alla produzione: contesto su trasporti e autenticazione di MCP.
Riferimenti
- “Durable scheduler”, n8n Docs, ottobre 2026, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/durable-scheduler/>
- “Scheduler environment variables”, n8n Docs, ottobre 2026, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/scheduler/>
- “Schedule Trigger node”, n8n Docs, ottobre 2026, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.scheduletrigger/>
- “Changelog” (durable scheduler attivo per impostazione predefinita), n8n Docs, 20 ottobre 2026, <https://docs.n8n.io/changelog/>
- “Release notes” (n8n 2.45 e 2.44), n8n Docs, 20 ottobre 2026, <https://docs.n8n.io/changelog/release-notes/>
- “Release n8n 2.45.0”, n8n su GitHub, 20 ottobre 2026, <https://github.com/n8n-io/n8n/releases/tag/n8n%402.45.0>
- “v3.0 Breaking changes”, n8n Docs, ottobre 2026, <https://docs.n8n.io/changelog/v30-breaking-changes/>
- “Developing v3 features”, n8n su GitHub, 2026, <https://github.com/n8n-io/n8n/blob/master/.github/DEVELOPING_V3.md>
- “Install with npm”, n8n Docs, ottobre 2026, <https://docs.n8n.io/deploy/host-n8n/install-options/install-with-npm/>
- “n8n package metadata” (dist-tags e date di rilascio), registro npm, consultato il 26 ottobre 2026, <https://registry.npmjs.org/n8n>
- “Use Docker Compose”, n8n Docs, ottobre 2026, <https://docs.n8n.io/deploy/host-n8n/install-options/install-using-docker-compose/>
- “One-line setup”, n8n Docs, ottobre 2026, <https://docs.n8n.io/deploy/host-n8n/install-options/one-line-setup/>
- “Node.js Releases”, Node.js, aggiornato il 21 ottobre 2026, <https://nodejs.org/en/about/previous-releases>
- “Set the timezone”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/set-the-timezone/>
- “Daylight Saving Time Rules”, NIST, 2026, <https://www.nist.gov/pml/time-and-frequency-division/popular-links/daylight-saving-time-dst>
- “Time Zone Database”, IANA, <https://www.iana.org/time-zones>
- “Security environment variables”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/security/>
- “Read/Write Files from Disk node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.readwritefile/>
- “Use the command line”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/use-the-command-line/>
- “HTTP Request credentials”, n8n Docs, <https://docs.n8n.io/integrations/builtin/credentials/httprequest/>
- “RFC 6750: Bearer Token Usage”, IETF, 2012, <https://www.rfc-editor.org/rfc/rfc6750>
- “EveryInfra OpenAPI” (chiavi di idempotenza, replay, errori), EveryInfra, consultato il 26 ottobre 2026, <https://api.everyinfra.com/openapi.json>
- “The Idempotency-Key HTTP Header Field”, draft-08, IETF HTTPAPI WG, 22 ottobre 2026, <https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/>
- “HTTP Request node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/>
- “getWorkflowStaticData”, n8n Docs, <https://docs.n8n.io/build/code-in-n8n/cookbook/built-in-methods-and-variables-examples/getworkflowstaticdata/>
- “Convert to File node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.converttofile/>
- “Enable Prometheus metrics”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/enable-prometheus-metrics/>
- “n8n-scheduler Grafana dashboard”, n8n-observability su GitHub, <https://github.com/n8n-io/n8n-observability/tree/main/dashboards/grafana/n8n-scheduler>
- “EveryInfra capability catalog”, EveryInfra, consultato il 26 ottobre 2026 alle 10:15 SGT, <https://api.everyinfra.com/api/v1/social/catalog>
- “Hot search rules”, Weibo, <https://m.s.weibo.com/hot/description>
- “RFC 9110: HTTP Semantics” (422 Unprocessable Content), IETF, 2022, <https://www.rfc-editor.org/rfc/rfc9110>
- “Handle errors gracefully”, n8n Docs, <https://docs.n8n.io/build/flow-logic/handle-errors-gracefully/>
- “MCP Client node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-langchain.mcpclient/>
- “MCP Client Tool node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolmcp>
- “MCP specification 2025-11-25: Transports”, Model Context Protocol, <https://modelcontextprotocol.io/specification/2025-11-25/basic/transports>
- “Trends Recommendations”, X Help Center, <https://help.x.com/en/resources/recommender-systems/trends-recommendations>
- “Set up task runners”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/set-up-task-runners/>
- “GHSA-qmvv-q3c9-wpp7: Credential Secrets Exposed in Execution Error Data”, n8n su GitHub, 14 ottobre 2026, <https://github.com/n8n-io/n8n/security/advisories/GHSA-qmvv-q3c9-wpp7>
- “5 Key Takeaways From Censys' State of the Internet Report”, Censys, 14 ottobre 2026, <https://censys.com/blog/state-of-the-internet-report-2026/>
- “Security update — 01 October 2026”, n8n Community, 1° ottobre 2026, <https://community.n8n.io/t/security-update-01-october-2026/318054>
- “Security update — 14 October 2026”, n8n Community, 14 ottobre 2026, <https://community.n8n.io/t/security-update-14-october-2026/321284>
- “Diagrid Brings Durable Execution to n8n” (comunicato stampa a pagamento), Business Wire via Yahoo Finance, 6 ottobre 2026, <https://finance.yahoo.com/technology/ai/articles/diagrid-brings-durable-execution-n8n-130000140.html>
- “ZoomInfo Launches Native Integration With n8n Through GTM.AI”, Business Wire, 12 ottobre 2026, <https://www.businesswire.com/news/home/20261012317239/en/ZoomInfo-Launches-Native-Integration-With-n8n-Through-GTM.AI>
- “Faltam 12 dias: consulte propostas das candidaturas que disputam o 2º turno”, Tribunale Superiore Elettorale del Brasile, 13 ottobre 2026, <https://www.tse.jus.br/comunicacao/noticias/2026/Outubro/faltam-12-dias-consulte-propostas-das-candidaturas-que-disputam-o-2o-turno>
- “An n8n execution can show Success after processing zero items”, Reddit r/n8n, <https://www.reddit.com/r/n8n/comments/1xadlkd/an_n8n_execution_can_show_success_after/>
Riferimento LF-26