DeepSeek V4 Claude Code: el coste de limpiar comentarios
Claude Code con deepseek-flash y el MCP de EveryInfra para 695 comentarios de YouTube, Bilibili y Douyin: en hora punta cuesta 1/10 de Sonnet 5.5, pero más que Haiku 5.5.
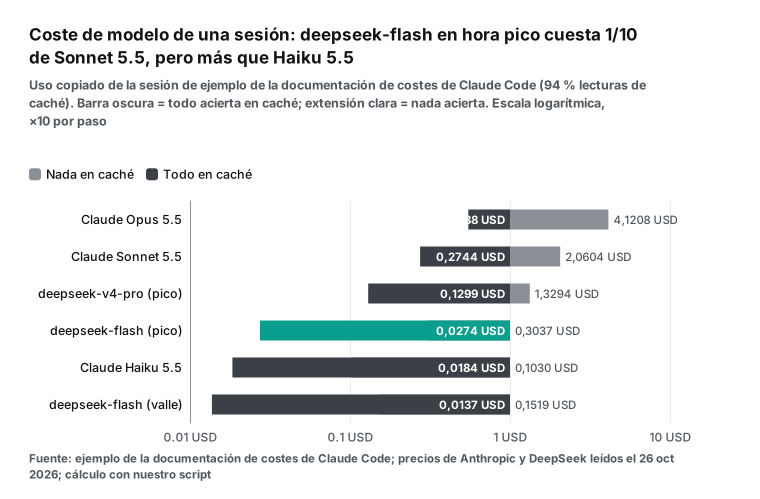
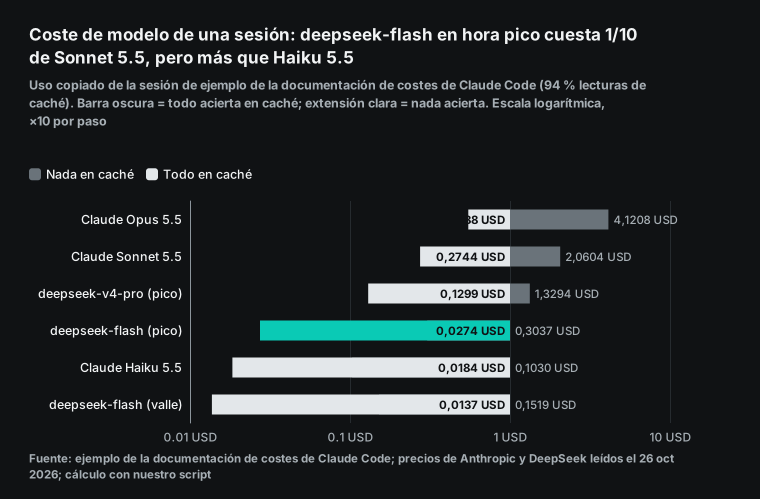
Se puede poner Claude Code sobre el modelo deepseek-flash de DeepSeek y usar el servidor MCP remoto de EveryInfra para traer y limpiar comentarios de vídeos. Sale barato, pero lo de «una décima parte del coste» solo se cumple si la caché de DeepSeek acierta. Tomamos la sesión de ejemplo de la documentación oficial de costes de Claude Code y le pusimos precio. En hora punta, deepseek-flash cuesta 0,0274 USD, justo el 10 % de Claude Sonnet 5.5 (0,2744 USD). Si la caché no acierta nunca, la misma sesión cuesta 0,3037 USD, más que Sonnet 5.5 con la caché funcionando. Claude Haiku 5.5 hace la misma sesión por 0,0184 USD. El 2026-10-26, de 17:26 a 17:38 hora de Singapur (SGT), pedimos a EveryInfra 695 filas de comentarios de 15 vídeos. Tras la limpieza quedaron 655 comentarios, y la entrada estimada del modelo bajó de 84 109 tokens a 20 176. En Bilibili y Douyin, la tarifa de datos por cada 1000 comentarios fue mayor que la tarifa del modelo deepseek-flash.
En este artículo, «limpiar comentarios» es un trabajo concreto. Claude Code lee el catálogo de capacidades de EveryInfra. Después llama a la herramienta MCP everyinfra_call_api para traer comentarios con youtube/comments, bilibili/comments y douyin/comments. Un script corto quita duplicados, respuestas vacías y publicidad. Unas reglas de palabras clave etiquetan más o menos la mitad del resto como «configuración y errores», «precio y cuota», «compara modelos» o «elogio». El modelo etiqueta lo que las reglas no pueden. El resultado es una tabla con el texto original y un registro de costes.
El modelo detrás de Claude Code no es de Anthropic. Es deepseek-flash, servido a través del endpoint compatible con Anthropic de DeepSeek. No tenemos clave de DeepSeek. Por eso, todos los pasos de DeepSeek y Claude Code que siguen son ejemplos de configuración basados en la documentación oficial, y no los ejecutamos. Cada llamada a EveryInfra y cada número de nuestros datos son reales.


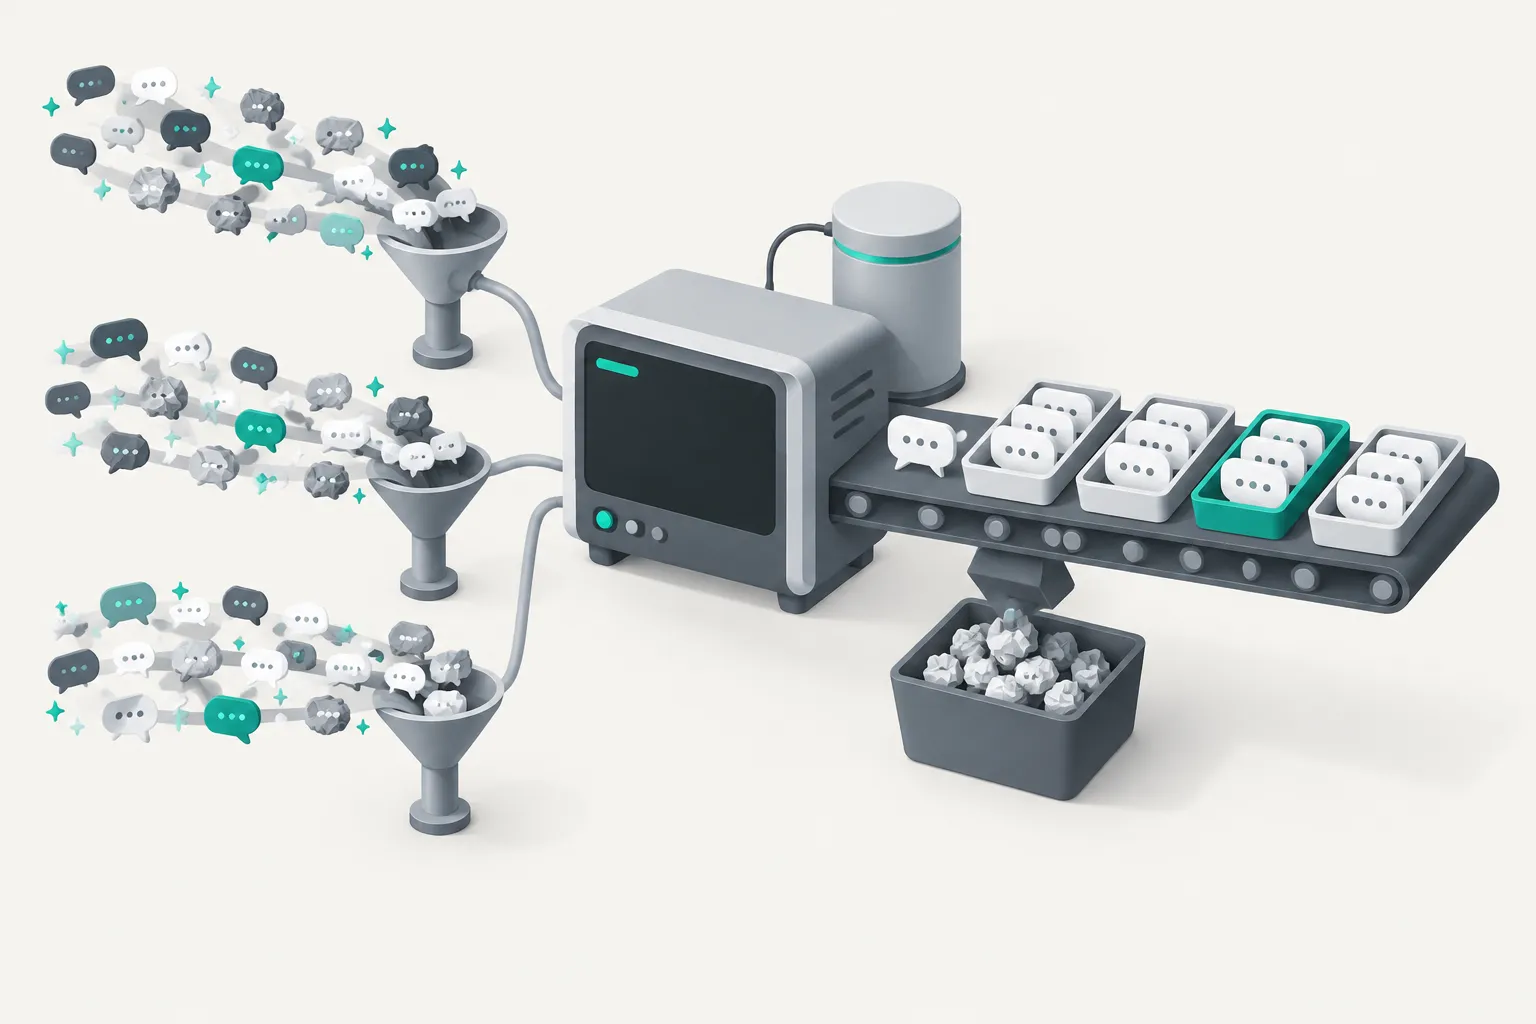
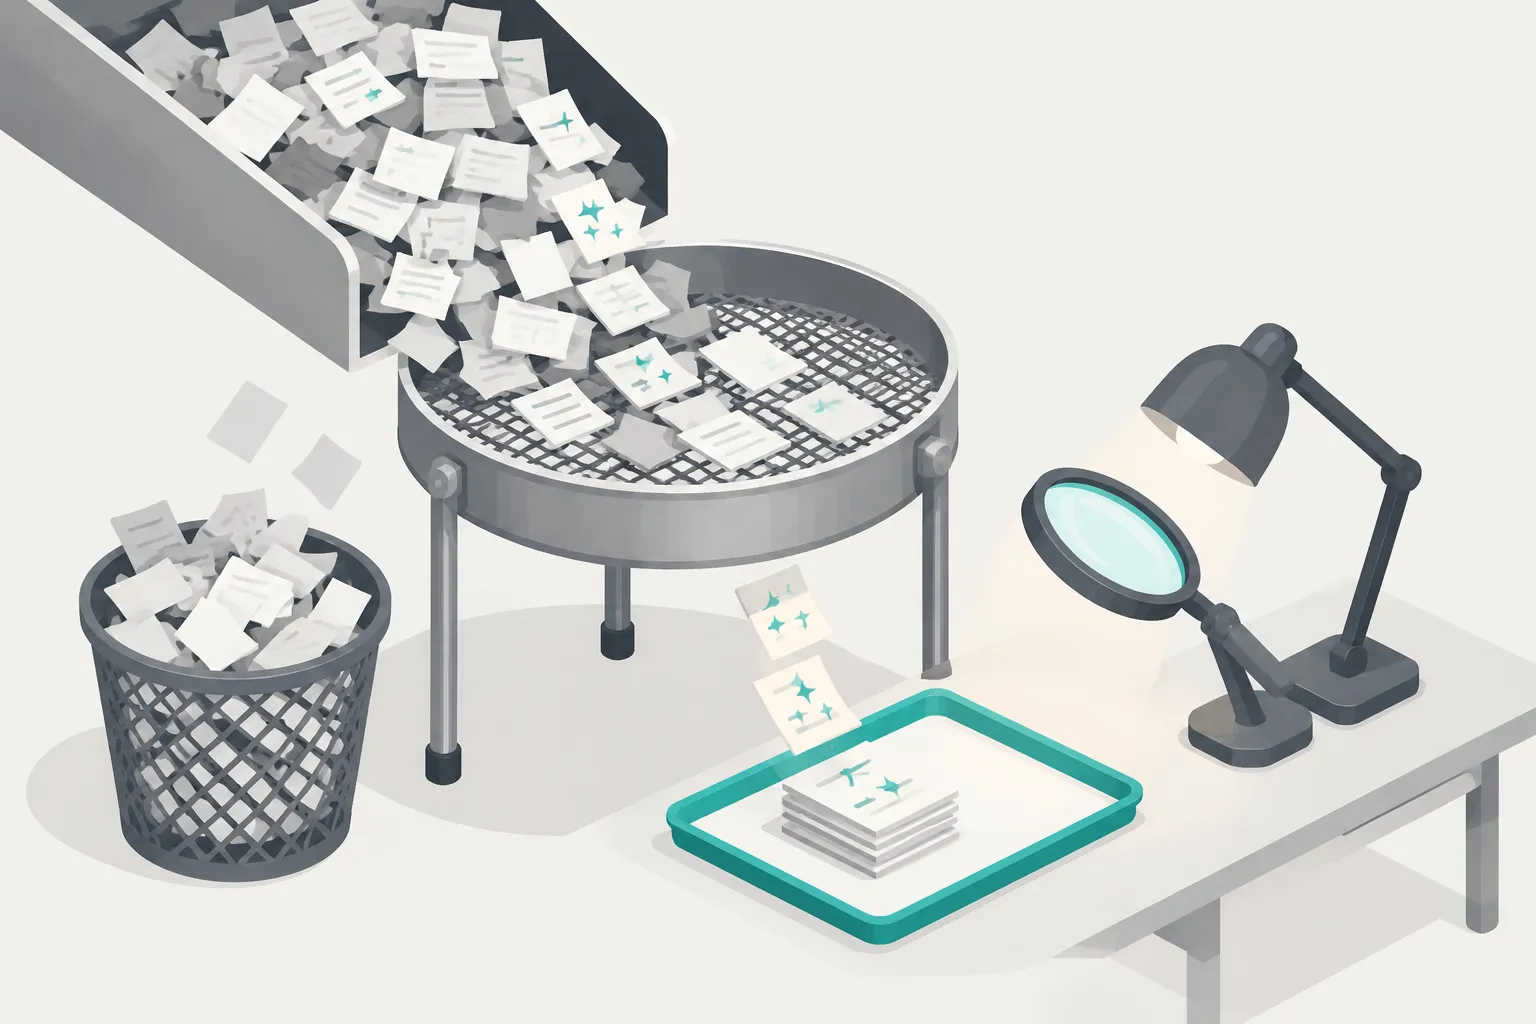
La imagen muestra adónde va el dinero. El paso caro es el escritorio de delante a la derecha, donde el modelo lee cada comentario y le pone etiqueta. Un tamiz más fino a la izquierda manda menos trabajo a ese escritorio. Primero explicamos la configuración. Después mostramos cinco pruebas. Al final hacemos las cuentas.
Conclusión: una décima parte del coste, solo si la caché acierta
En nuestras notas de investigación, el título provisional de este tema era «limpiar comentarios por una décima parte del coste». Antes de empezar lo convertimos en dos preguntas con respuesta numérica. Con el mismo uso, ¿deepseek-flash en hora punta queda dentro del 10 % de Claude Sonnet 5.5? ¿Es más barato que Claude Haiku 5.5? Las respuestas son «sí, justo» y «no».
No nos inventamos el uso. Copiamos el ejemplo de /cost de la documentación de costes de Claude Code: 1,2k tokens de entrada, 5,3k de salida, 940,0k de lectura de caché y 50,0k de escritura de caché. La documentación lo da como Claude Sonnet 4.6 a 0,55 USD. Primero lo recalculamos con las tarifas de Sonnet 4.6 y obtuvimos 0,5526 USD. Coincide con la documentación, así que el método es correcto.
Después aplicamos cada precio público que leímos el 2026-10-26. Los precios de Claude salen de la página de precios de Anthropic. Los de DeepSeek salen de la página de precios de DeepSeek en USD. También los cotejamos con la página de precios en chino, en CNY.
| Modelo (precio público, 2026-10-26) | Toda la caché acierta | Ningún acierto | Parte de Sonnet 5.5 (con aciertos) |
|---|---|---|---|
| Claude Opus 5.5 | 0,5488 USD | 4,1208 USD | 200 % |
| Claude Sonnet 5.5 | 0,2744 USD | 2,0604 USD | 100 % |
| deepseek-v4-pro, hora punta | 0,1299 USD | 1,3294 USD | 47,3 % |
| deepseek-flash, hora punta | 0,0274 USD | 0,3037 USD | 10,0 % |
| Claude Haiku 5.5 | 0,0184 USD | 0,1030 USD | 6,7 % |
| deepseek-flash, hora valle | 0,0137 USD | 0,1519 USD | 5,0 % |
La columna del medio es la que más se pasa por alto. En un agente como Claude Code, las lecturas de caché son casi toda la entrada. En la sesión de ejemplo, 940,0k de los 991,2k tokens de entrada son lecturas de caché, el 94,8 %. Así que dos cosas fijan el tamaño de la factura: el precio del acierto de caché y si la caché acierta de verdad.
El precio de acierto de deepseek-flash es de 0,006 USD por millón de tokens en hora punta y 0,003 USD en hora valle, por debajo de los 0,01 USD de Haiku 5.5. Pero su precio sin acierto es de 0,30 USD, el triple de los 0,10 USD de Haiku 5.5. Cuando la caché acierta, deepseek-flash queda cerca de una décima parte de Sonnet 5.5. Cuando falla, cuesta más que Sonnet 5.5 con la caché funcionando.
Hay un límite que vale para toda la tabla. Compara precios por token, no calidad de modelo. Los dos proveedores usan tokenizadores distintos. La página de precios de Anthropic dice que el tokenizador de Claude 4.7 y posteriores produce cerca de un 30 % más de tokens para el mismo texto que Claude 4.6 y anteriores. No hay una proporción pública entre tokens de DeepSeek y de Claude.
Anthropic ofrece un endpoint gratuito para contar tokens, y DeepSeek ofrece un tokenizador sin conexión. Pero no tenemos clave de ninguno de los dos, así que no calibramos con datos reales de usage. Todos los recuentos de tokens de este artículo son estimaciones, y usamos el mismo recuento para los dos lados.
Por qué dar este trabajo a un modelo barato como deepseek v4.1 flash
Limpiar comentarios es mucho volumen y cada elemento es fácil. Bajo un vídeo sobre DeepSeek V4 en Claude Code, la mayoría de comentarios pregunta por qué falla la configuración, cómo se cobra o cómo se compara con los modelos de Claude. Cada juicio es sencillo, pero muchos comentarios suman muchos tokens.
El 2026-10-17, DeepSeek actualizó deepseek-flash a DeepSeek-V4.1-Flash-1017. La nota de lanzamiento dice que el nuevo modelo acorta el tiempo de las tareas y la longitud de las respuestas. La ficha del modelo en Hugging Face dice que DeepSeek ejecutó Terminal-Bench 4.0 con el entorno de Claude Code y obtuvo 42,3.
Del lado de Anthropic, la página de lanzamiento de Claude Haiku 5.5 (2026-10-07) cita resúmenes, compactación y clasificación como su trabajo principal. También cita el trabajo de subagente para Opus 5.5 y Sonnet 5.5. Da un 39,2 % en Terminal-Bench 4.0 para Haiku 5.5 y un 70,6 % para Sonnet 5.5. Cada proveedor publica sus propios números con su propio método, así que no se pueden ordenar directamente. Pero los números muestran un hecho: ya hay dos modelos baratos que funcionan dentro de Claude Code. La comparación real es de coste y de esfuerzo de configuración.
| Concepto | deepseek-flash (endpoint de DeepSeek compatible con Anthropic) | Claude Haiku 5.5 (Anthropic directo) |
|---|---|---|
| Entrada sin acierto / salida, por millón de tokens | Punta 0,30 / 1,20 USD; valle 0,15 / 0,60 USD | 0,10 / 0,50 USD (prompts de hasta 100k tokens) |
| Acierto de caché | Punta 0,006 USD; valle 0,003 USD | 0,01 USD |
| Cómo funciona la caché | Caché automática de prefijos en disco; ignora cache_control | Usa las marcas cache_control de Claude Code |
| Ventana de contexto | 1M | 1M (los prompts de más de 100k tokens cuestan más) |
| Entrada de imágenes | Sí (deepseek-v4-pro: no) | Sí |
| Soporte oficial en Claude Code | DeepSeek publica una configuración; Anthropic dice que no da soporte a modelos que no son Claude a través de una pasarela | Nativo |
Lee la última fila con cuidado. La documentación de pasarelas de Claude Code dice que Anthropic no respalda, mantiene ni audita pasarelas de terceros. También dice que Anthropic no da soporte para enviar Claude Code a modelos que no son Claude a través de ninguna pasarela. La configuración de DeepSeek usa justo esa vía, un ANTHROPIC_BASE_URL propio. Si algo se rompe, el soporte de Claude Code no lo cubre.
Las vías de terceros con soporte son plataformas en la nube como Amazon Bedrock, Google Cloud y Microsoft Foundry (consulta la documentación de integraciones de terceros), además de las opciones de pasarela de Anthropic.
Criterios de éxito y fallo que escribimos antes
Antes de la primera llamada de comentarios, escribimos nueve criterios de «este trabajo funciona». No los cambiamos después de ver los resultados. Dos criterios solo registran números (la proporción de ruido y el tamaño de las definiciones de herramientas). Los demás tienen una línea de aprobado.
| ID | Criterio | Aprobado si | Resultado |
|---|---|---|---|
| J1 | Las 9 variables de entorno de DeepSeek existen en la documentación de Claude Code | 9 de 9 | Aprobado: 9 de 9 |
| J2 | Los campos MCP están todos en response_fields del catálogo y coinciden con REST | Ambas cosas | Aprobado |
| J3 | Cada charged_usd es precio del catálogo × unidades facturables; los fallos cuestan 0 | Todas las llamadas coinciden | Aprobado: 15 llamadas de comentarios, 3 búsquedas y 1 llamada MCP |
| J4 | La entrada limpia del modelo es como mucho el 40 % de los tokens del JSON original | ≤40 % | Aprobado: 38,0 % / 17,5 % / 5,6 % |
| J5 | Proporción de ruido (solo registro) | — | YouTube bajo (2,2 %); Bilibili y Douyin medio (12,0 %, 13,0 %) |
| J6 | ¿Flash en hora punta ≤10 % de Sonnet 5.5? ¿Más barato que Haiku 5.5? | Responder con números | P1: sesión 10,0 %, sí; etiquetas en lote 13,5 %, no. P2: no |
| J7 | Un parámetro erróneo da 422 con la corrección, y «no se cobró» está en el texto del error | REST y MCP | Aprobado |
| J8 | Tamaño de 25 definiciones de herramientas (solo registro) | — | Unos 8556 tokens; unos 1058 para las 4 que dejamos |
| J9 | Ninguna clave en disco | 0 coincidencias | Aprobado |
J7 pide «no se cobró» en el texto del error, no solo en el código HTTP o en la marca isError de MCP. El motivo está en la sección de compatibilidad: el endpoint de DeepSeek ignora el campo is_error de tool_result.
deepseek claude code setup: 9 variables de entorno contra la documentación
La página de integración con Claude Code de DeepSeek da nueve variables de entorno. Buscamos cada una en la referencia de variables de entorno de Claude Code. Las nueve existen, y su significado coincide con el uso que les da DeepSeek.
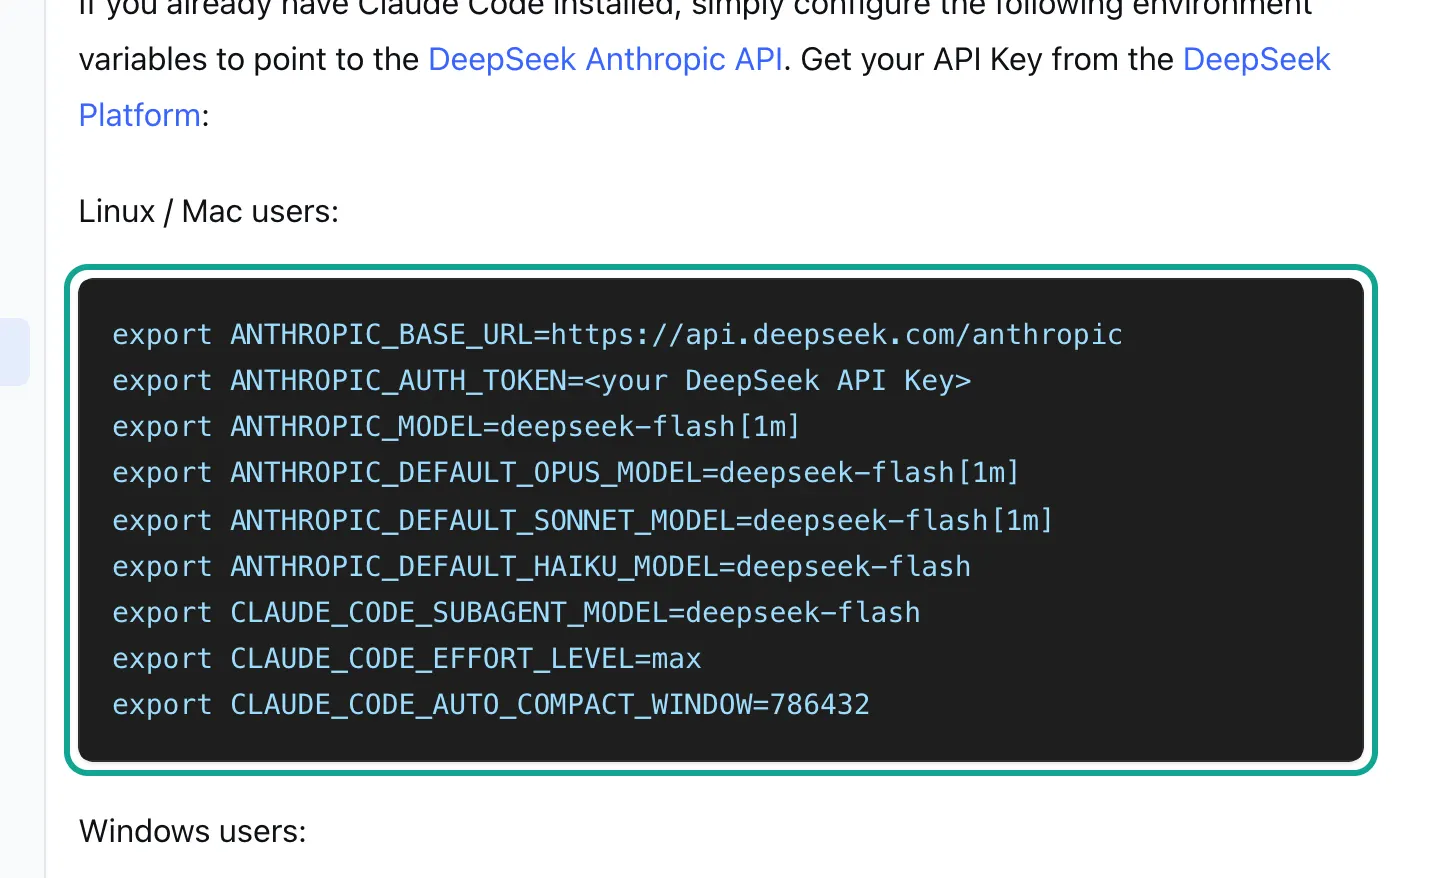
# Ejemplo de configuración (no tenemos clave de DeepSeek y no ejecutamos este bloque)
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN="$DEEPSEEK_API_KEY"        # se envía como Authorization: Bearer
export ANTHROPIC_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_OPUS_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_SONNET_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash     # también lo usan las tareas de fondo
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
export CLAUDE_CODE_EFFORT_LEVEL=high                    # DeepSeek pone max; para comentarios no hace falta
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
# Dos líneas más que recomendamos:
export ENABLE_TOOL_SEARCH=false                         # defer_loading no está en la tabla de compatibilidad
export EVERYINFRA_API_KEY=... # para .mcp.json; fuera de los archivos del proyecto| Variable | Qué controla en Claude Code | Qué vigilar en este trabajo |
|---|---|---|
ANTHROPIC_BASE_URL | Envía las peticiones a un proxy o pasarela | Con un host distinto de api.anthropic.com, Remote Control queda desactivado |
ANTHROPIC_AUTH_TOKEN | Valor de la cabecera Authorization: Bearer | Tiene prioridad sobre un inicio de sesión guardado de claude.ai; sin ella, sigue valiendo el inicio de sesión de tu plan |
ANTHROPIC_MODEL | Modelo de la sesión principal | El sufijo [1m] pide una ventana de contexto de 1M |
ANTHROPIC_DEFAULT_OPUS_MODEL / _SONNET_ | Adónde van los alias opus y sonnet | Si no se definen, DeepSeek asigna claude-opus* a deepseek-v4-pro con precios Pro |
ANTHROPIC_DEFAULT_HAIKU_MODEL | El alias haiku y las tareas de fondo | Las tareas de fondo también cuestan dinero |
CLAUDE_CODE_SUBAGENT_MODEL | Modelo por defecto de los subagentes | Todos los subagentes por plataforma lo usan |
CLAUDE_CODE_EFFORT_LEVEL | Nivel de esfuerzo | DeepSeek convierte medium, high y xhigh en high |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | Recuento de tokens que dispara la compactación automática | Rango de 100 000 a 1 000 000 |
ENABLE_TOOL_SEARCH | Búsqueda de herramientas MCP | Con false, cada petición lleva todas las definiciones de herramientas |
Hay tres detalles que solo aparecen al leer las dos documentaciones. El primero es la asignación de modelos. Las notas de compatibilidad de DeepSeek dicen que los nombres que empiezan por claude-opus van a deepseek-v4-pro con precios Pro. Los que empiezan por claude-haiku o claude-sonnet van a deepseek-flash. Si solo defines ANTHROPIC_MODEL y luego cambias a opus, pagas precios Pro. Para la sesión de ejemplo, Pro en hora punta cuesta 0,1299 USD, 4,7 veces el precio de flash.
El segundo es la detección de capacidades. La documentación de configuración de modelos de Claude Code dice que Claude Code activa los niveles de esfuerzo y el razonamiento extendido comparando el ID del modelo con patrones conocidos. Un ID desconocido puede dejar esas funciones apagadas. Se pueden declarar con variables como ANTHROPIC_DEFAULT_SONNET_MODEL_SUPPORTED_CAPABILITIES.
La guía de compatibilidad de pasarelas también dice que Claude Code trata los nombres de modelo desconocidos como modelos actuales y sigue enviando thinking: {"type": "adaptive"}. Las dos afirmaciones cubren casos distintos, y no pudimos probarlas. Nuestro consejo: tras configurar, ejecuta /status y /model para comprobar el modelo y el nivel de esfuerzo antes de un trabajo por lotes.
El tercero es el esfuerzo. La página de DeepSeek pone max. La documentación del modo de razonamiento de DeepSeek dice que una petición con medium, high o xhigh se ejecuta como high, y max o ultra como max. Las etiquetas de comentarios no necesitan el nivel más alto, y los tokens de razonamiento se cobran como salida. Por eso nuestro ejemplo usa high.
Conectar EveryInfra por MCP: un .mcp.json y solo 4 herramientas
Claude Code puede añadir un servidor MCP remoto de dos formas. Una es el comando claude mcp add --transport http. La otra es un archivo .mcp.json en la raíz del proyecto. Recomendamos el archivo. La documentación MCP de Claude Code dice que .mcp.json expande ${VAR} en url y headers, así que la clave se queda fuera de los archivos del proyecto. La línea de comandos expande la variable al ejecutarla y guarda la clave en ~/.claude.json.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 150000
    }
  }
}
Hay una regla de seguridad que ayuda aquí. La misma documentación dice que Claude Code lee sus propias variables de credenciales, como ANTHROPIC_AUTH_TOKEN y ANTHROPIC_API_KEY, como vacías en url y headers de un servidor remoto. Así que, aunque un .mcp.json pida Bearer ${ANTHROPIC_AUTH_TOKEN}, tu clave de DeepSeek no llega a ningún servidor MCP. EVERYINFRA_API_KEY no está en esa lista, así que se expande con normalidad. Pusimos timeout en 150 segundos. Nuestra llamada de comentarios de YouTube más lenta tardó 78,6 segundos, y el presupuesto síncrono de EveryInfra es de 85 segundos.
A las 17:26 SGT del 2026-10-26 enviamos a https://api.everyinfra.com/mcp las mismas peticiones initialize y tools/list que envía Claude Code al conectar. El servidor devolvió 25 herramientas. Estimamos su tamaño con la proporción de la página de uso de tokens de DeepSeek: unos 0,3 tokens por carácter en inglés y 0,6 por carácter en chino. Los nombres, descripciones y esquemas de entrada de las 25 herramientas suman unos 8556 tokens.
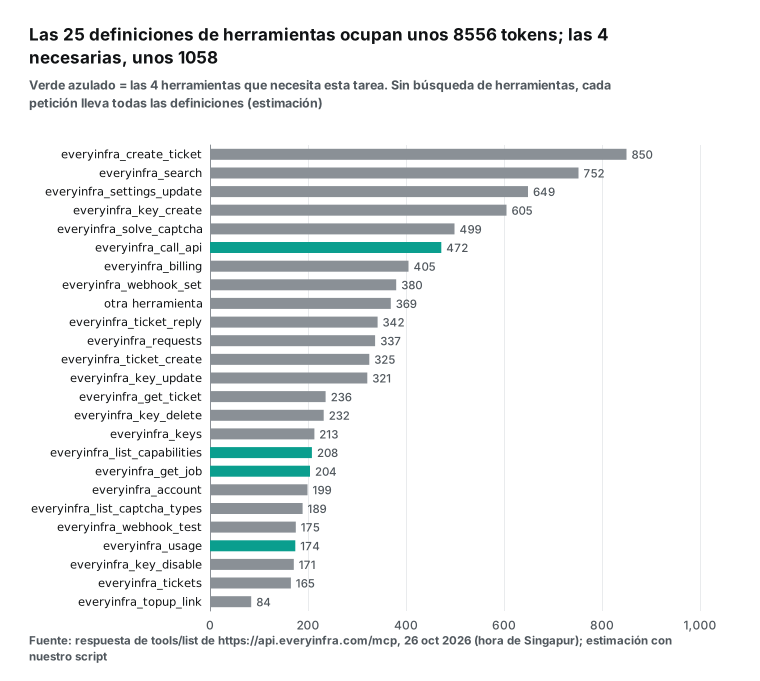
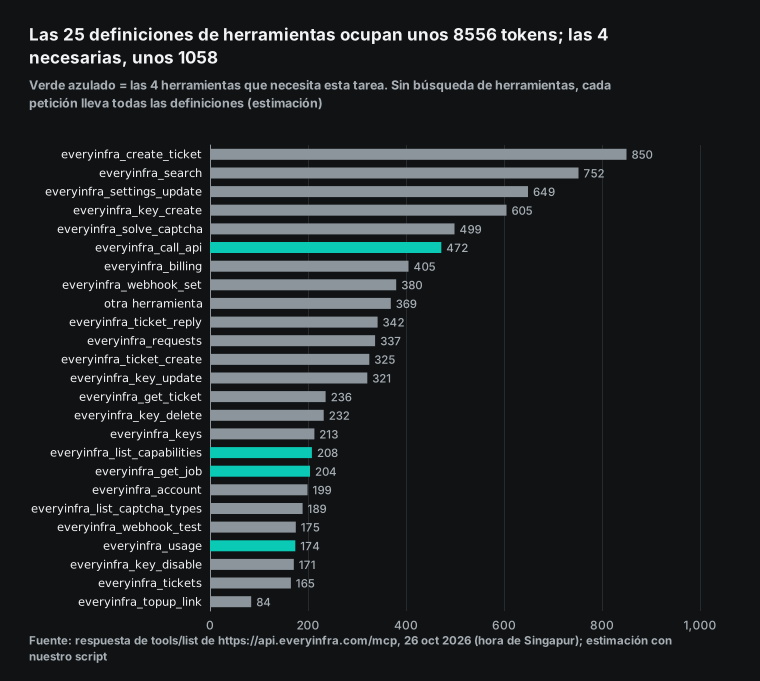
8556 tokens no es mucho por sí solo, pero dos factores lo multiplican. Primero, recomendamos desactivar la búsqueda de herramientas para evitar problemas de compatibilidad. Entonces Claude Code envía todas las definiciones en cada petición. Segundo, la documentación de permisos de Claude Code dice que una regla de denegación con el nombre de la herramienta a secas la quita del contexto del modelo. Así que, para este trabajo, deniega las otras 21 herramientas en .claude/settings.json (formato en la documentación de ajustes). Cada petición baja de unos 8556 a unos 1058 tokens de herramientas:
{
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_list_capabilities", "mcp__everyinfra__everyinfra_call_api",
              "mcp__everyinfra__everyinfra_get_job", "mcp__everyinfra__everyinfra_usage"],
    "deny":  ["mcp__everyinfra__everyinfra_search",
              "mcp__everyinfra__everyinfra_solve_captcha", "mcp__everyinfra__everyinfra_key_create",
              "mcp__everyinfra__everyinfra_key_delete", "mcp__everyinfra__everyinfra_settings_update",
              "mcp__everyinfra__everyinfra_webhook_set", "mcp__everyinfra__everyinfra_create_ticket"]
  }
}
El ejemplo lista 7 de las 21 herramientas; añade las otras 14 con el mismo formato. En tools/list, everyinfra_call_api tiene readOnlyHint: false y no tiene idempotentHint. Desde Claude Code 2.1.307 (2026-10-21) eso tiene una ventaja. El registro de cambios dice que, cuando una conexión MCP HTTP se cierra a mitad de llamada, Claude Code solo reintenta herramientas de solo lectura o idempotentes. Así, una conexión caída no repite en silencio una descarga de comentarios ni te la cobra dos veces.
Un viaje de ida y vuelta real: qué envía el modelo y qué devolvemos
Claude Code y un servidor MCP remoto usan tools/call de la especificación MCP. Con Claude o con DeepSeek detrás, el modelo solo escribe un bloque tool_use con el nombre de la herramienta y los argumentos. Claude Code envía la petición HTTP. Por eso el cuerpo de la petición de abajo no depende del modelo. Las definiciones de herramientas, tool_use y tool_result sí cuentan como tokens de entrada del modelo, como explica la documentación de uso de herramientas de Anthropic. Lo mismo vale para DeepSeek.
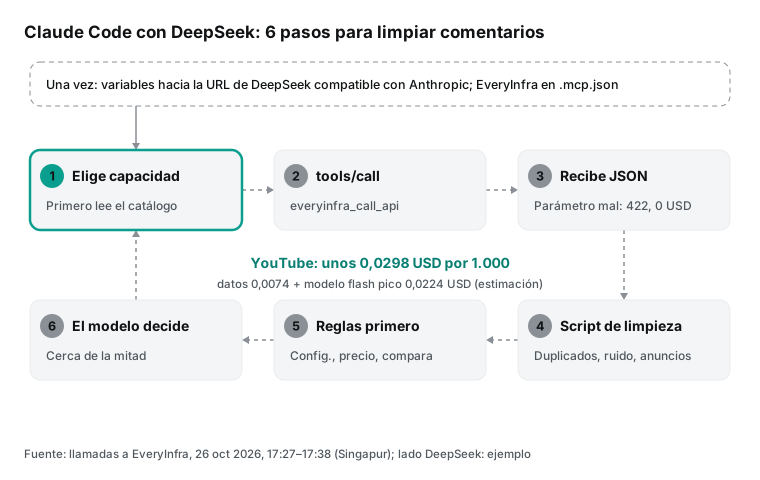
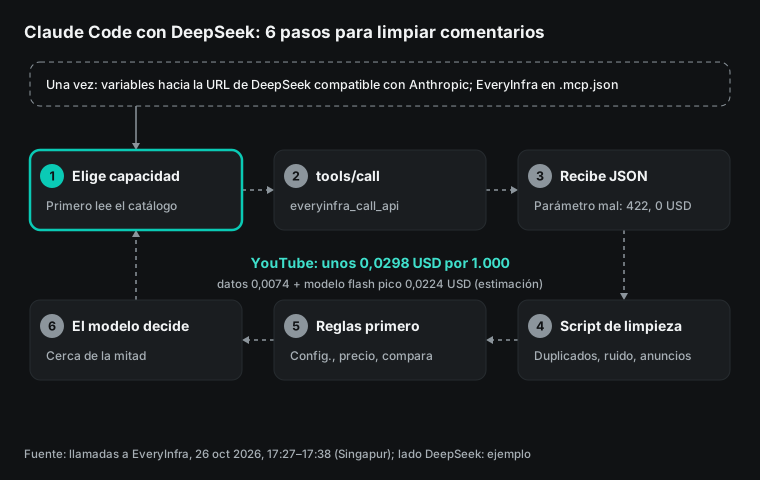
A las 17:37:32 SGT del 2026-10-26 usamos curl para enviar a EveryInfra el mismo tools/call que envía Claude Code. Pedía los 20 comentarios más recientes de un vídeo de YouTube. A los 14,0 segundos, el servidor devolvió 200. result.content[0].text era una cadena JSON (RFC 8259) de 8926 caracteres. El cobro fue de 0,000556 USD, el precio de catálogo de la YouTube Comments Scraper API.
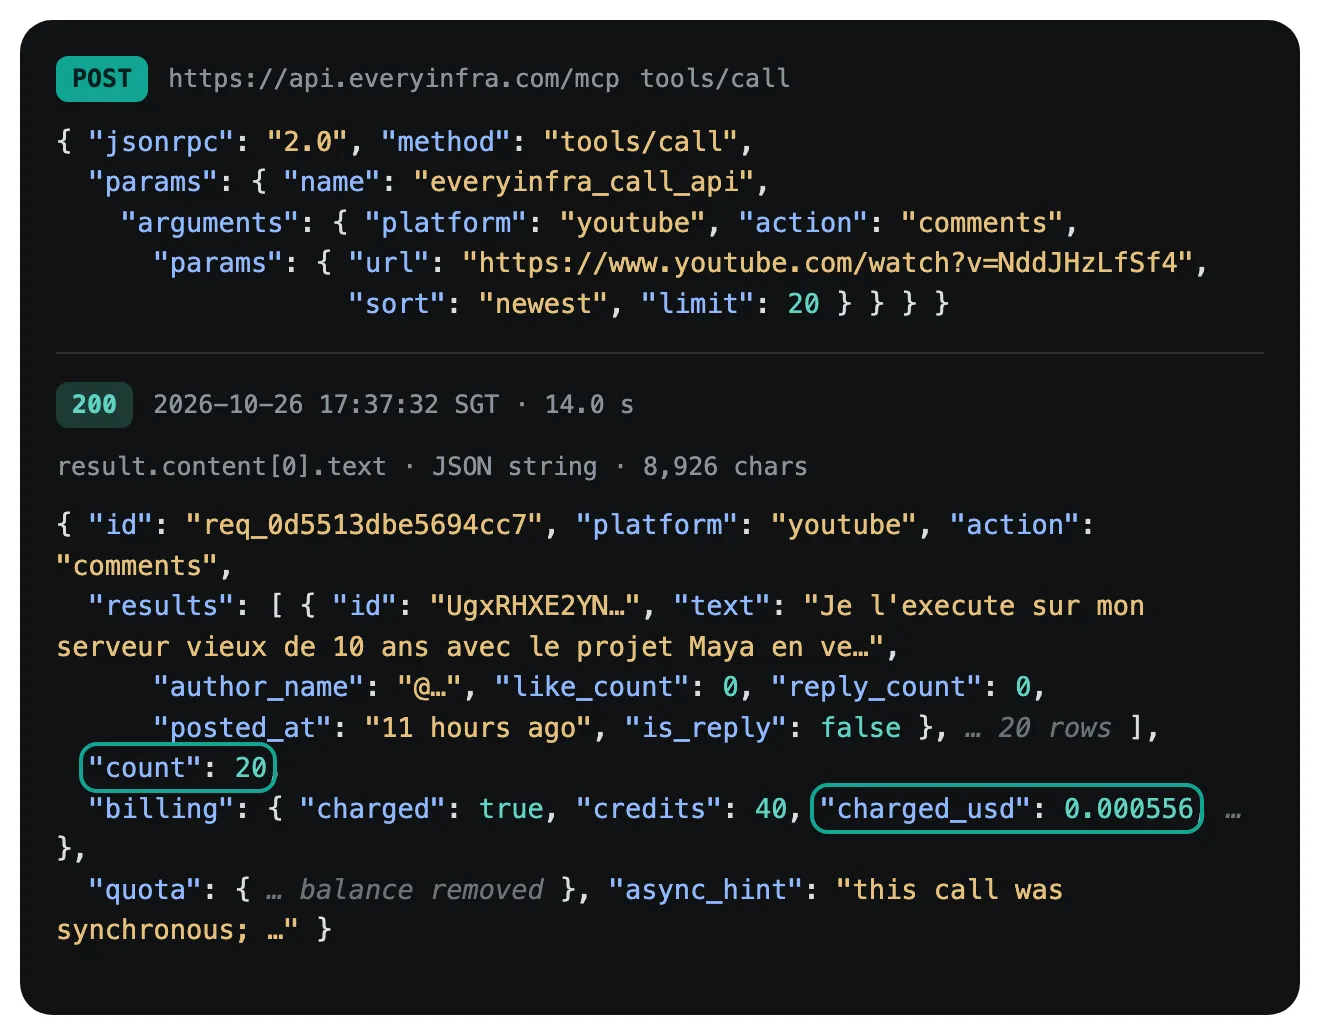
Comparamos los campos de esta respuesta MCP con la respuesta REST del mismo vídeo a las 17:28:19. También los cotejamos con response_fields de youtube/comments en el catálogo:
| Campo | `response_fields` del catálogo | MCP | REST | Uso en la limpieza |
|---|---|---|---|---|
id | Sí | Sí | Sí | Clave del paso 1, quitar duplicados |
text | Sí | Sí | Sí | El único texto que va al modelo |
author_name | Sí | Sí | Sí | No se envía; oculto en los informes |
like_count | Sí | Sí | Sí | Se conserva como peso |
reply_count | Sí | Sí | Sí | No se envía |
posted_at | Sí | Sí | Sí | YouTube da tiempo relativo, como «hace 11 horas» |
is_reply | Sí | Sí | Sí | Se conserva como una letra, r o t |
reply_to_id | Sí | No en estas 20 filas de primer nivel | Sí | Une una respuesta con su comentario padre |
platform | Sí | Sí | Sí | No se envía |
Ningún campo de ninguna de las dos vías está fuera del catálogo. La respuesta MCP no trae reply_to_id solo porque estos 20 comentarios recientes no tenían respuestas. J2 aprobado.
Otro número de la documentación de Claude Code importa aquí. Claude Code avisa cuando el resultado de una herramienta MCP pasa de 10 000 tokens, y el límite por defecto es de 25 000 tokens. Un resultado mayor, o un texto de más de 50 000 caracteres, lo guarda en un archivo y deja solo la ruta en la conversación. Nuestras descargas de 100 comentarios de YouTube tenían entre 33 000 y 35 000 caracteres, unos 10 000 tokens estimados. Justo en la línea del aviso.
deepseek anthropic api: 7 filas de compatibilidad que afectan a las llamadas de herramientas
Las notas de la API de Anthropic de DeepSeek tienen una tabla de soporte campo por campo. Tomamos las filas que afectan a las llamadas y resultados de herramientas. Después las comparamos con lo que la guía de pasarelas dice que envía Claude Code. «No figura en la documentación» marca un hueco que no pudimos probar.
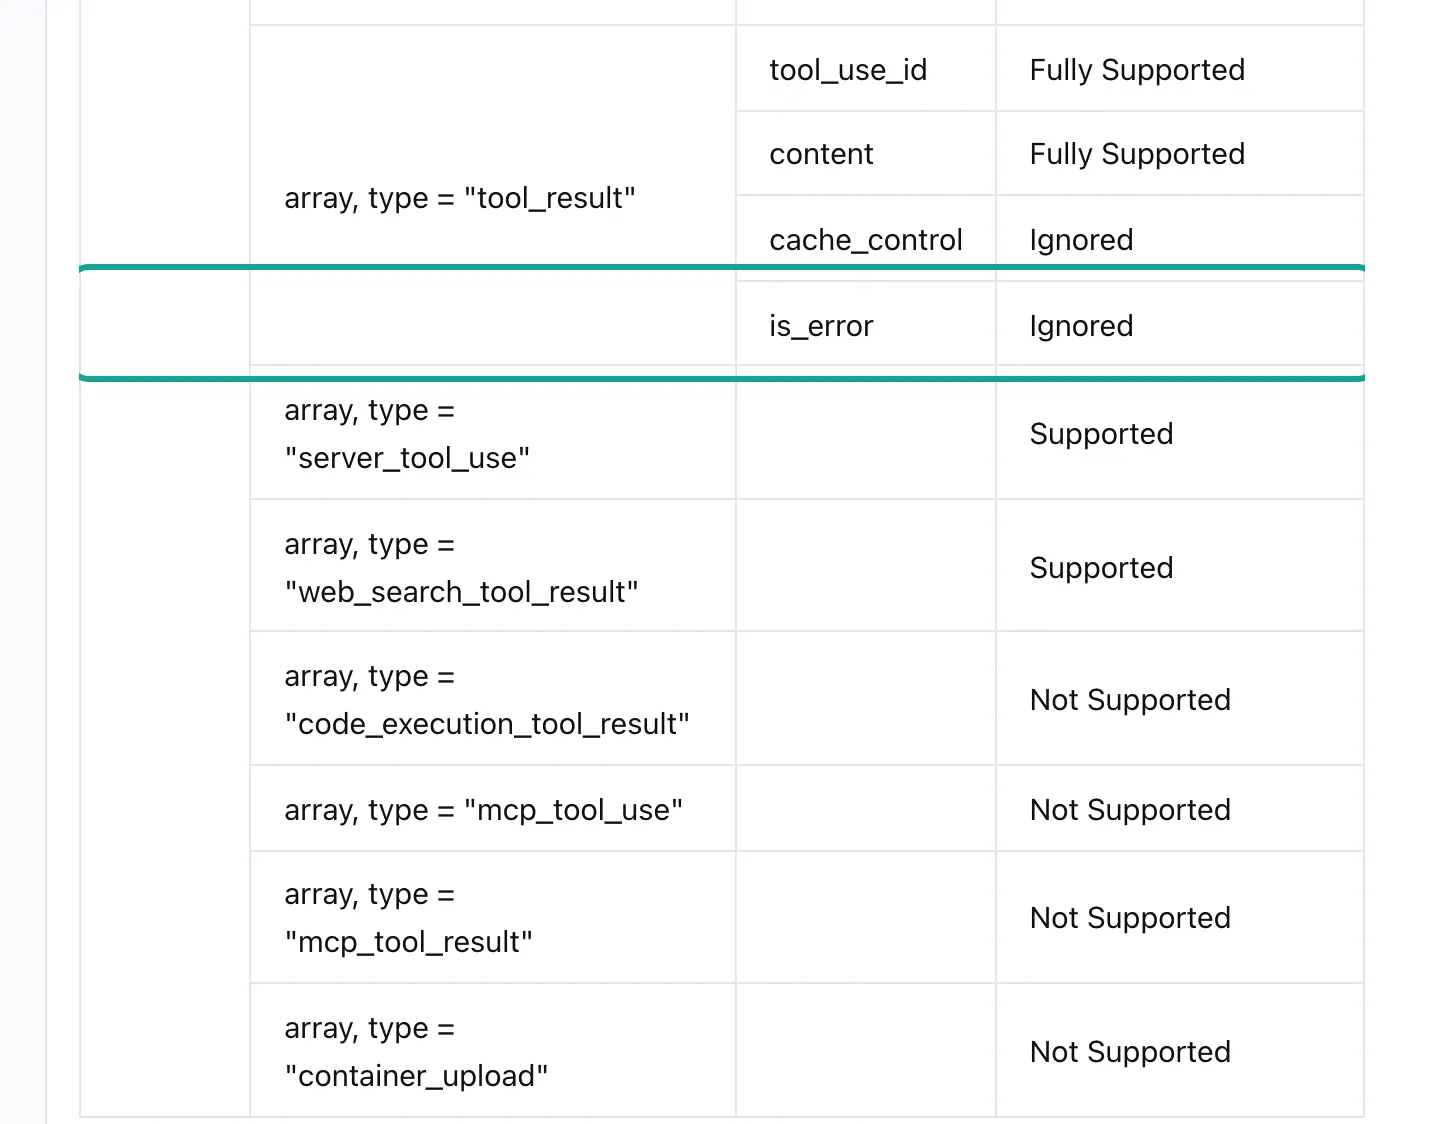
| Campo o comportamiento | Tabla de DeepSeek | Qué significa para limpiar comentarios |
|---|---|---|
tool_result.is_error | Ignorado | El modelo solo ve texto; el texto del error debe decir cómo corregirlo y si se cobró |
cache_control en tools, texto, tool_use, tool_result | Ignorado | La caché en disco de DeepSeek busca prefijos por su cuenta; las reglas de caché de Anthropic no aplican |
disable_parallel_tool_use en tool_choice | Ignorado | El modelo puede enviar varios tools/call a la vez y chocar con los límites de frecuencia |
mcp_servers | Ignorado | Sin efecto en Claude Code, que es un cliente MCP local |
Bloques mcp_tool_use, mcp_tool_result | No soportado | Igual; Claude Code envía tool_use y tool_result normales |
Bloques document, search_result | No soportado | No envíes PDF como bloques document |
defer_loading, tool_reference (búsqueda de herramientas) y strict | No figura en la documentación | Desde 2.1.304, la búsqueda de herramientas está activa tras una URL propia; Claude Code reintenta una vez sin ella tras un 400 o 422. Para evitarlo, define ENABLE_TOOL_SEARCH=false |
La primera fila es la que más nos importa. En la especificación MCP, un error al ejecutar una herramienta devuelve isError: true. Claude Code se lo pasa al modelo como un tool_result con is_error. DeepSeek ignora esa marca, así que el modelo solo recibe texto. Que el modelo pueda corregir su propio error depende solo de lo claro que sea ese texto.
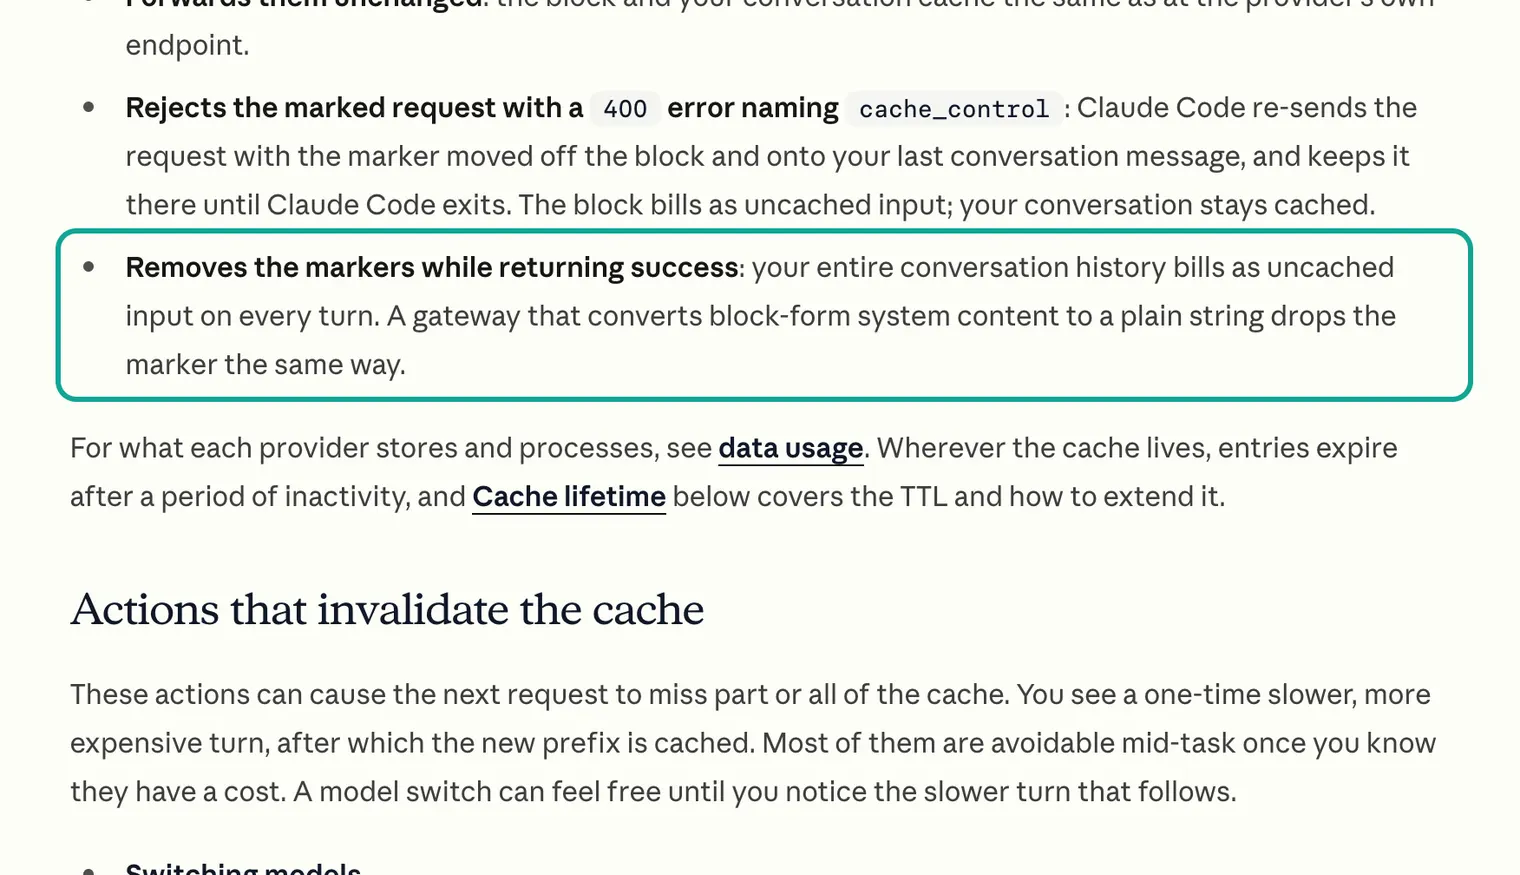
La segunda fila fija el coste. La documentación de caché de prompts de Claude Code da tres formas en que una pasarela puede tratar cache_control. En la tercera, la pasarela quita las marcas y aun así devuelve éxito. Con la facturación de Claude, eso significa que toda la conversación se cobra como entrada sin caché en cada turno.
DeepSeek ignora las marcas, pero tiene su propia caché en disco. Está activa por defecto para todos los usuarios y busca prefijos de las peticiones. Los tokens que coinciden se cobran al precio de acierto. La documentación la describe como «best effort», sin garantía de acierto del 100 %. Las entradas que no se usan suelen borrarse en un plazo de unas horas a unos días.
Otro detalle afecta a la búsqueda de prefijos. La guía de pasarelas dice que Claude Code añade un bloque de atribución al principio del prompt de sistema. Contiene la versión del cliente y una huella derivada de la conversación. El endpoint de Anthropic lo elimina antes de procesar, pero otros endpoints lo reciben como parte del prompt. La caché de DeepSeek necesita una coincidencia completa con una unidad de prefijo guardada.
La documentación no dice si ese bloque se mantiene igual durante una conversación, y no pudimos comprobarlo. Por eso nuestra tabla de costes tiene dos columnas, todo aciertos y ningún acierto. Tu factura real caerá entre las dos. Revisa prompt_cache_hit_tokens en los datos de uso de DeepSeek.
Prueba 1: cómo son los comentarios de tres plataformas
De 17:26:56 a 17:27:16 SGT buscamos «deepseek v4 claude code» y «DeepSeek Claude Code» con youtube/search, bilibili/search y douyin/search. De los resultados elegimos 15 vídeos sobre usar DeepSeek en Claude Code: 6 en YouTube (4 en inglés, 1 en chino y 1 en español), 5 en Bilibili y 4 en Douyin. Por ahora, la búsqueda de Douyin devuelve solo la primera página (aquí 20 resultados, sin next_page_token); para tener más vídeos candidatos, busca otra vez con otras palabras clave. Elegir el tema es parte del método. Los comentarios de estos vídeos son relatos de primera mano sobre dónde se atasca la gente con esta configuración.
| Plataforma | Vídeos | Filas pedidas por llamada | Filas devueltas (con respuestas) | Cobro | Tiempo por llamada |
|---|---|---|---|---|---|
| YouTube | 6 | 100 | 461 (289 de primer nivel, 172 respuestas) | 6 × 0,000556 = 0,003336 USD | 11,5 a 78,6 s |
| Bilibili | 5 | 50 | 50 (10 por llamada) | 5 × 0,000556 = 0,002780 USD | 8,7 a 11,4 s |
| Douyin | 4 | 50 | 184 (86 de primer nivel, 98 respuestas) | 0,006112 USD (por cada 20 filas) | 14,4 a 44,0 s |
Revisamos cada cobro. En el catálogo, youtube/comments y bilibili/comments cuestan un precio por llamada, sea cual sea el número de filas. La Douyin Comments Scraper API tiene rows_per_unit: 20, así que cada 20 filas son una unidad. 50 filas son 3 unidades (120 créditos, 0,001667 USD), y 34 filas son 2 unidades (80 créditos, 0,001111 USD). En las 15 llamadas, credits es igual al precio de catálogo por las unidades. J3 aprobado.
También vimos tres cosas que conviene saber. Primera: la Bilibili Comments Scraper API devolvió solo 10 filas en cada una de las 5 llamadas. Pedimos 50. No es un recorte nuestro: Bilibili da como mucho 10 comentarios por vídeo. El catálogo ahora indica 10 por defecto y 10 como máximo; un limit mayor se acepta, pero solo vuelven 10 filas. A las 20:01:21 SGT repetimos la llamada al mismo vídeo con limit=50: 10 filas, 0,000556 USD. Eso encarece los datos de Bilibili: 0,0556 USD por 1000 filas. Calcula como mucho 10 comentarios por vídeo de Bilibili.
Segunda: en dos páginas de Douyin el mismo id de comentario apareció dos veces. Fueron 8 de 184 filas. Se corrigió el 26 de octubre a las 19:53 SGT: la API ahora quita las repeticiones por id y deja la primera, y si después falta para completar una unidad de cobro, se reembolsa según las reglas. Nuestras 184 filas son de antes de la corrección. El paso 1 del script de limpieza sigue quitando las filas con un id repetido, como red de seguridad. Tercera: el posted_at de YouTube es tiempo relativo, como «hace 7 días (editado)». Bilibili y Douyin dan marcas de tiempo estándar con zona horaria. Para agrupar los comentarios de YouTube por fecha, calcula a partir de la hora de descarga y toma el resultado como aproximado.
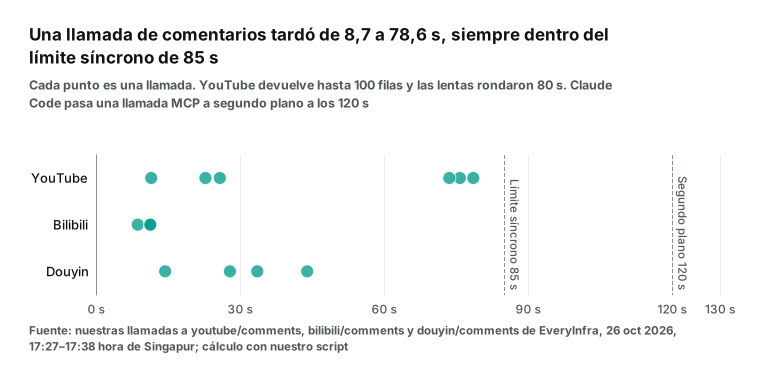
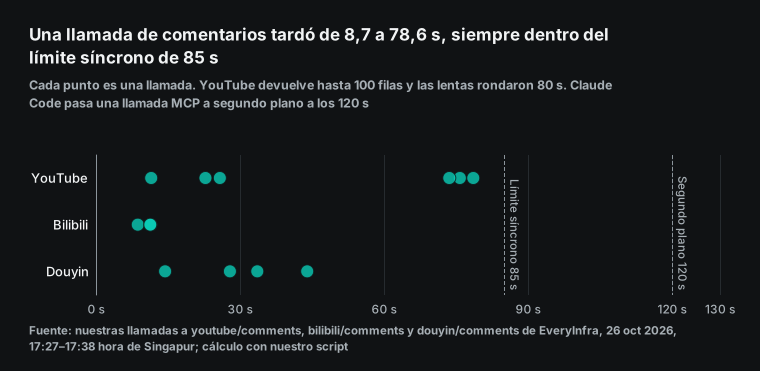
El tiempo de llamada importa en Claude Code. Su documentación MCP dice que una llamada MCP en la conversación principal que pasa de dos minutos se convierte en tarea de fondo. El modelo recibe un ID de tarea al momento y sigue trabajando, y el resultado llega después como notificación. Nuestra llamada más lenta tardó 78,6 segundos, muy por debajo de dos minutos.
La sección async_mode del catálogo de EveryInfra dice que el presupuesto síncrono es de 85 segundos. Para valores grandes de limit, sugiere mode: "async" y la herramienta gratuita everyinfra_get_job para leer el resultado. Si DeepSeek envía varias llamadas a la vez (recuerda que disable_parallel_tool_use se ignora), tu clave de EveryInfra también tiene un límite por minuto y devuelve 429 si lo superas. DeepSeek cuenta la concurrencia por cuenta, y deepseek-flash admite 2500 peticiones simultáneas antes de devolver 429 (documentación de límites).
Prueba 2: qué quitó el script de limpieza
No dejamos la limpieza al modelo. Dejamos que el modelo escribiera un script para hacerla. Si una regla puede decidir, mandar el comentario al modelo solo sirve para pagar por leerlo. La documentación de costes de Claude Code da el mismo consejo. No hagas que el modelo lea un log de 10 000 líneas: un hook puede buscar ERROR primero y bajar el contexto de decenas de miles de tokens a unos cientos.
El script hace cuatro comprobaciones en orden y se detiene en la primera que coincide. El paso 2 usa la normalización Unicode NFKC (UAX #15; en Python, unicodedata.normalize). Después quita enlaces, códigos de emoji y puntuación, para que la misma frase en ancho completo o con otras mayúsculas cuente como duplicada. Todas las reglas son expresiones regulares de Python, y puedes volver a ejecutarlas con los mismos datos:
# Reglas de limpieza, versión 4 (extracto; el script completo se guarda con las respuestas originales)
BRACKET_EMOJI = re.compile(r"\[[一-鿿]{1,6}\]")      # códigos de emoji como [捂脸]; solo chino entre corchetes
PROMO = re.compile(r"(subscribe(?!r)|newsletter|giveaway|chrome extension|coupon|telegram|whatsapp|"
                   r"私信|加群|进群|加微|微信|qq群|关注我|免费领|领取|代金券|优惠|课程|戳我)", re.I)
for r in rows:
    if (video, r["id"]) in seen_id:   drop("mismo id"); continue           # 1. el mismo comentario dos veces en una página
    if (video, norm(r["text"])) in seen_text: drop("mismo texto"); continue # 2. mismo texto tras normalizar
    if no_content(r["text"]):          drop("sin contenido"); continue      # 3. solo emoji, 666, dos caracteres sin pregunta
    if PROMO.search(r["text"]) or (has_link and (few_chars or bait)): drop("publicidad"); continue  # 4.
    keep(f'{i}|{likes}|{"r" if r["is_reply"] else "t"}|{text_with_links_shortened}')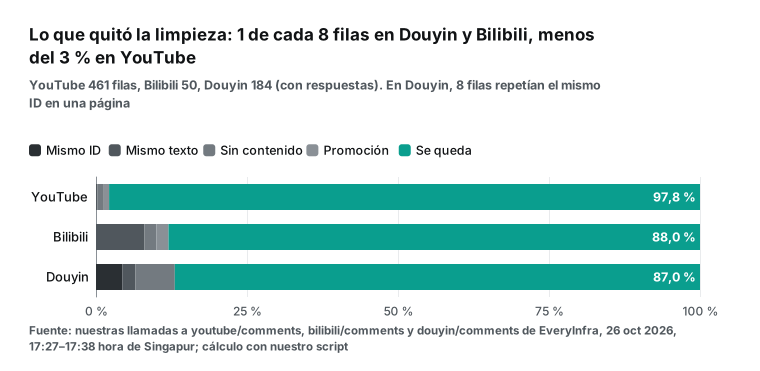
Cambiamos el script cuatro veces. Cada cambio llegó después de leer los comentarios quitados y encontrar uno quitado por error. Este proceso es la lección principal del artículo. Las reglas de limpieza siempre quitan algunos comentarios buenos, y solo los encuentras si lees lo que quitaste.
La versión 1 tomó «New subscriber here» por publicidad, porque subscribe coincidía con subscriber. También quitó una pregunta en español, «¿qué extensiones concretamente?», por culpa de extension. Y quitó una respuesta útil que enlazaba la página oficial de descarga de Git. La versión 2 arregló esos tres casos.
La versión 3 mantuvo «Normal, están con un 90% de descuento», un comentario normal sobre un descuento de DeepSeek, y dejó de quitar la pregunta china de dos caracteres «guì bù» («¿es caro?»). La versión 4 salió de leer el texto que se quedaba. La expresión para los códigos de emoji entre corchetes (una palabra china entre corchetes, como el código de «facepalm») era demasiado amplia. Borraba messages[1] de un mensaje de error y [1m] de un nombre de modelo, y esas eran dos de las pistas más útiles del lote.
Leímos las 40 filas que quitó la versión 4 y no encontramos más errores. No leímos las 655 filas que se quedaron, así que aún queda algo de publicidad sin enlaces ni palabras clave, por ejemplo ofertas de instalar las herramientas a cambio de dinero. En Douyin aparecieron varias veces respuestas de «te lo puedo instalar». La deduplicación por texto quitó las repetidas y dejó la primera.
La proporción de ruido cambia mucho según la plataforma: 2,2 % en YouTube, 12,0 % en Bilibili y 13,0 % en Douyin. Una posible razón del número bajo de YouTube es que la plataforma filtra antes. La documentación de commentThreads de la YouTube Data API dice que solo el dueño del canal ve los comentarios «probable spam» y «retenidos para revisión» en una petición autorizada. Las peticiones públicas reciben por defecto los comentarios publicados.
En Made on YouTube, el 2026-09-23, YouTube también dijo que prueba una moderación de comentarios con IA, opcional, que aprende el estilo de cada canal. En Douyin y Bilibili, el ruido son sobre todo emojis, «666» y repeticiones, no enlaces externos. Las coincidencias de las reglas muestran el mismo patrón.
Prueba 3: cuántos tokens lee el modelo tras la limpieza
La limpieza ahorra algo más que filas. Con la proporción de DeepSeek estimamos dos recuentos de tokens. El primero envía el JSON de la API tal cual. El segundo envía solo la línea limpia.
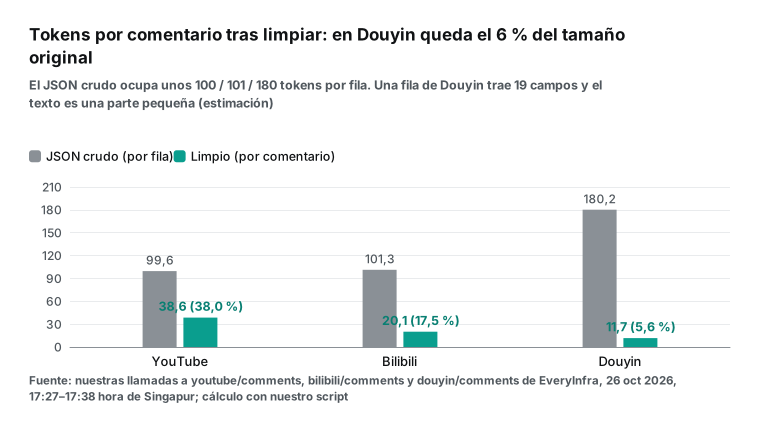
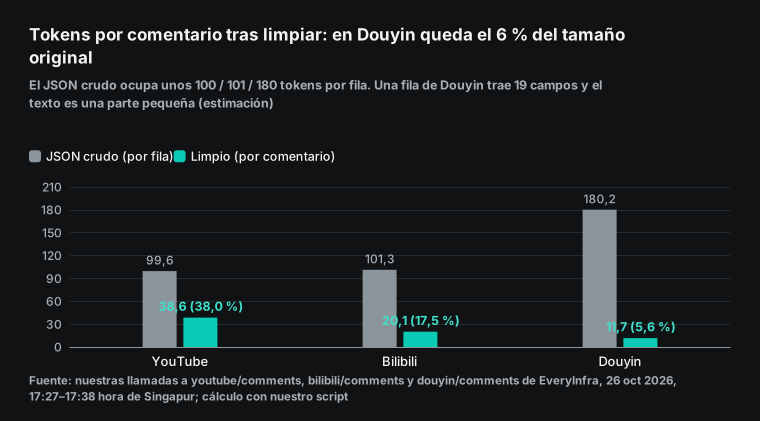
Douyin es la que más se reduce por sus campos. En el catálogo, douyin/comments tiene 19 campos de respuesta, como la URL del avatar, la ubicación por IP, los usuarios mencionados y si el autor dio «me gusta» al comentario. Una fila de JSON original ronda los 180 tokens de media, pero la mediana del texto es de solo 13 caracteres. Los comentarios de YouTube son más largos, con una mediana de 61 caracteres y solo 9 campos, así que tras la limpieza queda el 38,0 %. En las tres plataformas, 84 109 tokens estimados bajan a 20 176, el 24,0 %. J4 aprobado.
¿Por qué importa tanto en Claude Code? El resultado de una herramienta MCP entra directamente en el contexto de la conversación. Cada turno posterior lo vuelve a leer como parte del prefijo. Al precio de acierto de DeepSeek, releer 10 000 tokens cuesta solo 0,00006 USD. Pero tú no controlas la tasa de aciertos. Si falla, esos 10 000 tokens cuestan 0,003 USD a 0,30 USD por millón, y en decenas de turnos eso se acumula.
Un patrón más seguro es que Claude Code escriba un script. El script llama a la API REST de EveryInfra con curl, guarda el JSON original en archivos e imprime solo el texto limpio y los recuentos. Deja MCP para los pasos interactivos, como un primer vistazo, elegir una capacidad o probar parámetros.
# Las descargas por lotes van por REST; las respuestas originales van a disco, no a la conversación
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"comments","params":{"url":"https://www.douyin.com/video/<video_id>","limit":50}}' \
  -o raw/dy_<video_id>.json
python3 clean.py raw/ > cleaned.txt   # imprime solo "índice|me gusta|r/t|texto" y los recuentos de filas quitadas
Prueba 4: qué etiquetan las reglas y qué va al modelo
Tras la limpieza aplicamos reglas de palabras clave para ver cuánto pueden etiquetar. Las reglas permiten varias etiquetas en un comentario, por ejemplo «precio» y «compara modelos».
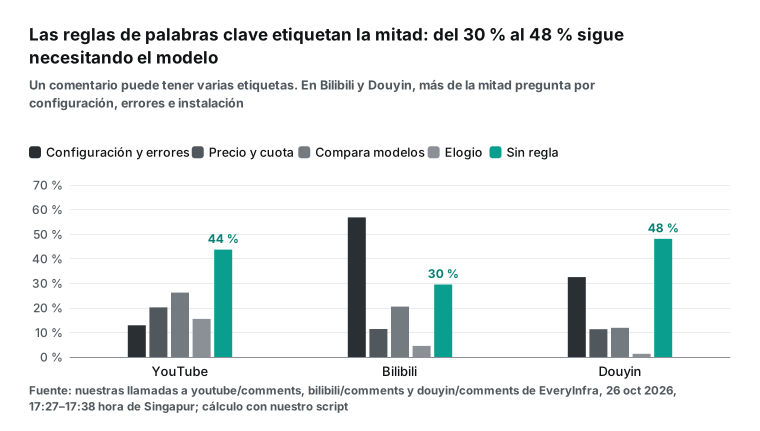
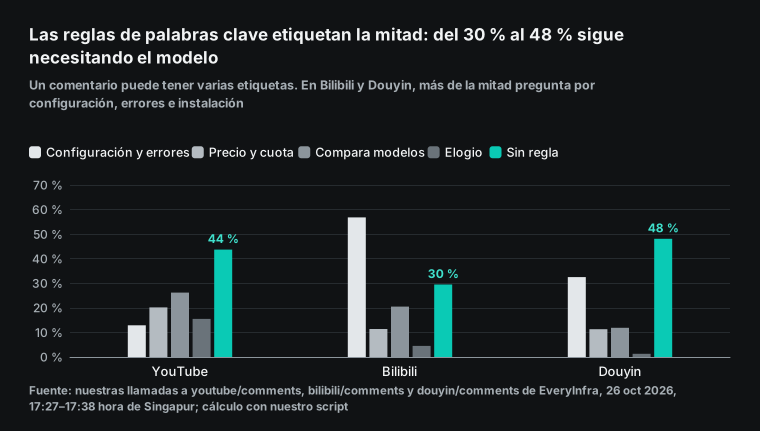
Ninguna regla reconoció el 43,7 % de los comentarios de YouTube, el 29,5 % en Bilibili y el 48,1 % en Douyin. Ese número fija cuánto tiene que leer el modelo: cerca de la mitad. Las reglas no sustituyen al modelo. Pero le quitan la mitad del trabajo, y la mitad que etiquetan suele ser la más fácil y la que menos merece pagar.
| Plataforma | Conservados | Configuración y errores | Precio y cuota | Compara modelos | Elogio | Ninguna regla | Contiene pregunta |
|---|---|---|---|---|---|---|---|
| YouTube | 451 | 58 | 91 | 118 | 70 | 197 (43,7 %) | 138 |
| Bilibili | 44 | 25 | 5 | 9 | 2 | 13 (29,5 %) | 27 |
| Douyin | 160 | 52 | 18 | 19 | 2 | 77 (48,1 %) | 59 |
Vale la pena leer los comentarios. En Bilibili, 25 de 44 preguntan por configuración y errores. En Douyin, 52 de 160. Las preguntas se repiten. ¿Por qué sigue pidiendo iniciar sesión después de configurarlo? ¿Por qué no puede leer imágenes? ¿Por qué dice que es Claude? ¿Por qué gasta tokens tan rápido?
En YouTube, dos mensajes de error quedaron en los datos palabra por palabra. El primero es API Error: 400 Failed to deserialize the JSON body into the target type: messages[1].role: unknown variant system. El segundo es The content[].thinking in the thinking mode must be passed back. Las preguntas frecuentes de abajo responden a ambos con la documentación oficial.
Bajo el vídeo en español, de un canal de programación muy seguido, quedaron 83 comentarios en español, y el tema que más se repite es el precio. El comentario principal del vídeo, con 189 «me gusta», es de alguien que usaba deepseek-v4-pro para el trabajo pesado y cambiaba a flash para lo sencillo. El segundo, con 107 «me gusta», dice que le llegó un correo de DeepSeek sobre un ajuste de precios. Otro, con 17, pide «aprovechar» el precio actual antes de que suba. Varias respuestas cuentan lo mismo. Lo tratamos solo como relato de usuarios. Para los precios usamos la página de precios de DeepSeek, leída el 2026-10-26.
Para la parte del modelo damos un ejemplo de configuración. Claude Code envía los comentarios sin etiqueta a un subagente en lotes de 100, con el formato «índice|texto». El subagente debe devolver solo un array JSON, con un índice y una etiqueta por comentario. La documentación de DeepSeek sobre salida JSON y llamadas de herramientas admite salidas estructuradas así. En Claude Code, lo más sencillo es escribir el formato de salida en la definición del subagente. Después, CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash lo ejecuta con el modelo barato. La documentación de subagentes dice que esta variable fija el modelo por defecto de los subagentes.
El entregable: una tabla de etiquetas que enlaza con el original
El resultado de este trabajo es una tabla. Cada fila es un comentario conservado, con la plataforma, los «me gusta», el texto original (sin nombres de usuario), la etiqueta y quién la asignó. Abajo hay 10 filas, ordenadas por «me gusta». La columna de etiqueta de regla muestra la primera pasada de las reglas. La última columna es nuestra propia revisión de cada fila.
| Plataforma | Me gusta | Comentario (extracto; el chino, traducido) | Etiqueta de regla | Nuestra revisión |
|---|---|---|---|---|
| Douyin | 615 | «Acabo de empezar. Un lote de archivos de datos me llevaría días a mano; esto lo hizo en unos diez minutos» | Ninguna | Experiencia de uso, positiva; las reglas no la vieron |
| Douyin | 51 | «¿Me puedes instalar Claude Code?» | Compara modelos | Pide ayuda para instalar; «claude» disparó la etiqueta equivocada |
| Douyin | 36 | «¿No notáis que los tokens se acaban rápido después de conectarlo?» | Precio y cuota | Correcta |
| Douyin | 28 | «Después de conectar DeepSeek V4, Claude se queda cargando la sesión. ¿Qué hago?» | Compara modelos | Ayuda con un error; las reglas no conocen esa frase |
| Douyin | 24 | «¿Parece que el modelo de DeepSeek no puede hacer imágenes?» | Ninguna | Pregunta sobre límites |
| Douyin | 14 | «Hice unas preguntas pequeñas y gasté 700k tokens. Demasiado rápido.» | Precio y cuota | Correcta |
| Bilibili | 10 | «¿No decían que CC tiene riesgos de seguridad? ¿Lo sigues recomendando?» | Ninguna | Duda de seguridad |
| YouTube | 17 | «Aprovechen los 0.14, porque va a subir los precios.» | Precio y cuota | Correcta |
| YouTube | 17 | «IT DOES NOT MATCH OPUS 5.5» | Compara modelos | Correcta |
| YouTube | 6 | «i didn't understand single thing related to setup» | Configuración y errores | Correcta (opinión sobre el tutorial) |
En estas 10 filas, las reglas acertaron 5 veces, omitieron 3 y se equivocaron en 2. La muestra es demasiado pequeña para medir la precisión, pero enseña los dos tipos de error de las reglas. Uno es una palabra clave demasiado amplia: cualquier comentario con «claude» cuenta como comparación de modelos. El otro es que hay demasiadas formas de decir lo mismo: la gente pide ayuda con frases muy distintas, y las reglas no pueden listarlas todas.
Esa es la parte del modelo, y por eso las reglas son solo una primera pasada. El modelo debe poder cambiar una etiqueta de regla antes de que entre en un informe. Un patrón barato en Claude Code es enviar al modelo solo dos grupos. Uno son las filas sin etiqueta de regla. El otro son las filas con la única etiqueta «compara modelos», donde se acumulan los errores. Con nuestros datos son 368 de 655 comentarios conservados, cerca del 56 %.
La fila más útil para un equipo de producto es el comentario de 615 «me gusta». El comentario con más «me gusta» no habla de configuración ni de precio. Habla de un resultado: un lote de archivos de datos resuelto en minutos. Con solo reglas, esa fila cae en «otros», y sin embargo es la voz más típica bajo ese vídeo. Por eso conservamos los «me gusta» en el texto limpio. Casi no cuestan tokens y dan al modelo un peso barato de «cuánta gente está de acuerdo».
Prueba 5: qué ve el modelo tras un parámetro erróneo
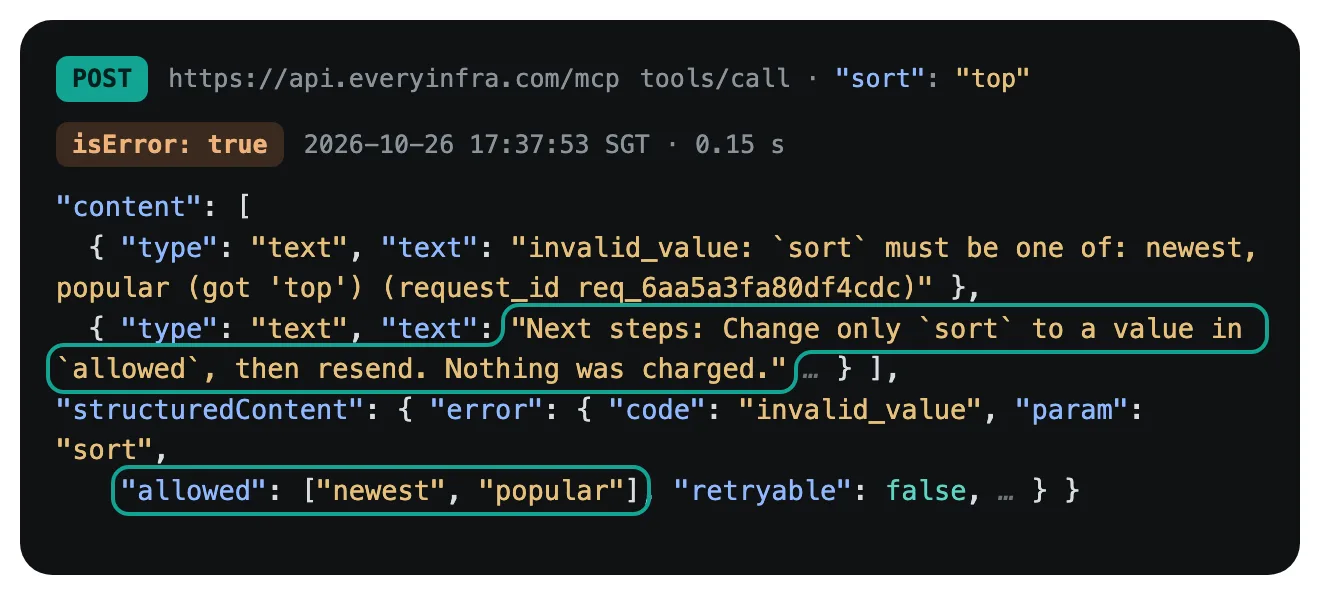
A las 17:26:46 SGT, nuestras primeras búsquedas pusieron limit en el nivel superior del cuerpo de la petición. Las tres plataformas devolvieron 422 con el código de error unknown_param. El mensaje decía que limit va dentro de params, no en el nivel superior, con did_you_mean: ["params.limit"] y una frase final, «Nothing was charged.». No fue a propósito. Es el tipo de error que comete un modelo. A las 17:37:53 enviamos sort: "top" por MCP, esta vez a propósito:
| Caso | Respuesta | Qué ve el modelo con DeepSeek | Cobro |
|---|---|---|---|
REST: limit en el nivel superior (17:26:46, tres plataformas) | 422 unknown_param, did_you_mean: ["params.limit"] | No aplica (REST lo gestiona un script) | 0 USD |
REST: sort: "top" (17:38:00) | 422 invalid_value, allowed: ["newest","popular"] | No aplica | 0 USD |
MCP: sort: "top" (17:37:53) | isError: true, dos partes de texto y structuredContent | Dos partes de texto: el parámetro erróneo, los valores permitidos y «Nothing was charged.» | 0 USD |
La tercera fila demuestra J7. DeepSeek ignora is_error, así que el modelo no sabe que fue un fallo. Solo lee las dos partes de texto. Esas partes ya nombran el parámetro erróneo, listan los valores permitidos, piden cambiar solo ese valor y volver a enviar, y dicen que no se cobró nada.
Los códigos de error y la regla de «los fallos son gratis» están en la tabla de errores de la documentación de EveryInfra. Los formatos completos de petición y error están en el archivo OpenAPI. Los parámetros desconocidos y los valores de enumeración no válidos devuelven 422 con los parámetros admitidos, los valores permitidos y una sugerencia. Nunca se ignoran para cobrar igual. Una llamada síncrona de más de 85 segundos devuelve 503 timeout y tampoco se cobra. Con un endpoint de modelo que ignora la marca de error, esta regla es lo que permite que el modelo se corrija solo.
Coste: precios por token de DeepSeek más la tarifa de datos de EveryInfra
La página de precios de DeepSeek (leída el 2026-10-26) divide el día en hora punta y hora valle. La hora punta va de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, salvo festivos de China. Todas las demás horas son valle, a mitad de precio. Para quien lee en español, esto cambia mucho según el país.
En España, el horario de verano terminó el 2026-10-25, así que el 2026-10-26 Madrid está en UTC+1. La hora punta cae de 02:00 a 05:00 y de 07:00 a 11:00 hora peninsular, es decir, justo la mañana laboral. En Ciudad de México (UTC−6, sin horario de verano), la hora punta es de 19:00 a 22:00 de domingo a jueves y de 00:00 a 04:00 de lunes a viernes, así que la jornada laboral entera cae en valle. Nuestra prueba fue un lunes de 17:26 a 17:38 SGT, es decir, de 09:26 a 09:38 UTC, dentro de la hora punta. Eso equivale a las 10:26 en Madrid, también en punta.
| Por millón de tokens (USD) | deepseek-flash punta | deepseek-flash valle | deepseek-v4-pro punta | Claude Haiku 5.5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|---|---|---|
| Entrada (sin acierto) | 0,30 | 0,15 | 1,32 | 0,10 | 2,00 | 4,00 |
| Acierto de caché | 0,006 | 0,003 | 0,044 | 0,01 | 0,10 | 0,20 |
| Escritura de caché (5 min) | Sin precio aparte | Sin precio aparte | Sin precio aparte | 0,125 | 2,50 | 5,00 |
| Salida | 1,20 | 0,60 | 3,96 | 0,50 | 10,00 | 20,00 |
La página de precios en chino da para flash una entrada de 2 CNY (punta) y 1 CNY (valle) por millón de tokens, y una salida de 8 CNY y 4 CNY. Usamos unos 6,67 CNY por dólar, la proporción entre price_cny y price_usd del catálogo de EveryInfra ese mismo día. Eso da unos 0,30, 0,15, 1,20 y 0,60 USD, lo mismo que la página en USD. Los precios de Haiku 5.5 valen para prompts de hasta 100 000 tokens. Los más largos cuestan 0,50 y 2,50 USD.
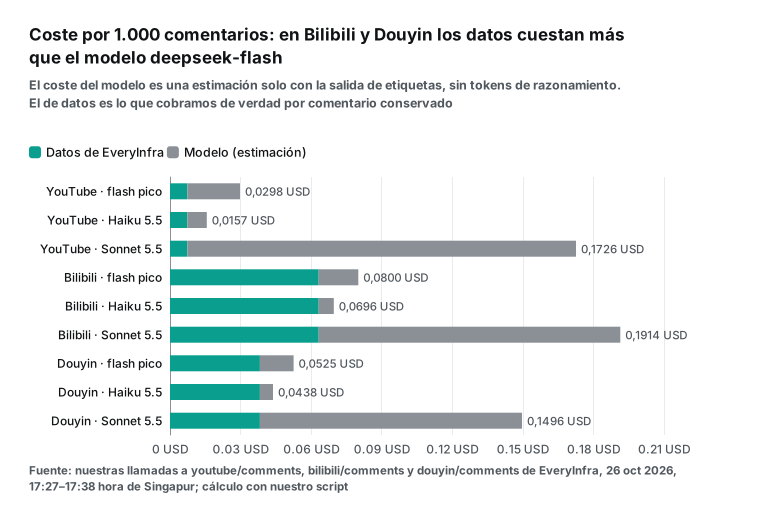
La tarifa de datos sigue el price_usd del catálogo de EveryInfra. youtube/comments, bilibili/comments y douyin/comments cuestan 0,000556 USD por llamada cada una (0,56 USD por 1000 llamadas), y Douyin además cobra por cada 20 filas. Con nuestra media de filas por llamada, la tarifa de datos por cada 1000 comentarios conservados es de 0,0074 USD en YouTube, 0,0632 USD en Bilibili y 0,0382 USD en Douyin.
Para la tarifa del modelo solo estimamos el paso de etiquetado. La entrada son los tokens limpios de 1000 comentarios más 400 tokens de instrucciones por cada lote de 100. La salida es una etiqueta de 8 tokens por comentario. No hay tokens de razonamiento. Es un límite inferior, porque deepseek-flash usa el modo de razonamiento por defecto. Añadimos un caso de sensibilidad con 1500 tokens extra de razonamiento por lote. Esos 1500 son una suposición, no una medición.
| Por cada 1000 comentarios limpios (USD) | Datos | flash punta | flash valle | Haiku 5.5 | Sonnet 5.5 | flash punta, +1500 tokens de razonamiento por lote |
|---|---|---|---|---|---|---|
| YouTube | 0,0074 | 0,0224 | 0,0112 | 0,0083 | 0,1652 | 0,0404 |
| Bilibili | 0,0632 | 0,0168 | 0,0084 | 0,0064 | 0,1282 | 0,0348 |
| Douyin | 0,0382 | 0,0143 | 0,0072 | 0,0056 | 0,1114 | 0,0323 |
Esta tabla cambió lo que esperábamos. Pensábamos que la tarifa del modelo dominaría y que la de datos no importaría. En YouTube es así: el modelo cuesta el triple que los datos. Pero en Bilibili y Douyin los comentarios son cortos y los tokens limpios son pocos. Ahí la tarifa de datos supera a la del modelo deepseek-flash en hora punta. Con comentarios chinos cortos y flash, la parte de datos es la mayor de la factura. Entonces lo que más pesa es de dónde vienen los datos y cuántas filas devuelve cada llamada.
Ahora llevémoslo a un mes. Cada plataforma tiene 120 vídeos al mes (30 por semana). Claude Code ejecuta una sesión por semana con el uso de ejemplo de la documentación de costes, con aciertos de caché.
| Un mes (120 vídeos por plataforma, 4 sesiones), USD | Datos | Modelo de etiquetas | Sesiones (con aciertos) | Total |
|---|---|---|---|---|
| deepseek-flash punta | 0,3168 | 0,2883 | 0,1096 | 0,7147 |
| deepseek-flash valle | 0,3168 | 0,1441 | 0,0548 | 0,5157 |
| Claude Haiku 5.5 | 0,3168 | 0,1080 | 0,0736 | 0,4984 |
| Claude Sonnet 5.5 | 0,3168 | 2,1602 | 1,0976 | 3,5746 |
| deepseek-v4-pro punta | 0,3168 | 1,1115 | 0,5196 | 1,9479 |
Un mes descarga unas 15 940 filas y conserva unos 14 876 comentarios. Todo cuesta menos de 0,72 USD con flash en hora punta y unos 3,57 USD con Sonnet 5.5. Haiku 5.5 cuesta 0,50 USD, menos que flash en punta y casi lo mismo que flash en valle. La tarifa de datos de 0,3168 USD es igual en todas las filas, porque solo depende de cuánto descargas.
El mismo trabajo con modelos oficiales de Claude: cómo elegir
Juntas, las tablas dan una elección clara. Por precio por token, Claude Haiku 5.5 es una de las opciones más baratas para este trabajo. Además es un modelo nativo de Claude Code, así que ninguno de los problemas de compatibilidad de arriba aplica. La caché sigue cache_control, is_error llega al modelo, y la búsqueda de herramientas y la salida estructurada funcionan. deepseek-flash solo sale más barato si se cumplen dos cosas a la vez: trabajas en hora valle y la mayor parte de tu caché acierta. En Latinoamérica, la primera se cumple casi siempre en horario laboral. En España, no por la mañana.
¿Por qué elegir DeepSeek, entonces? Los comentarios dan razones reales. Algunos usuarios están en China continental, donde el acceso directo a Anthropic está limitado por región. Otros ya tienen saldo en DeepSeek. Otros quieren pesos abiertos que puedan alojar. Otros quieren un modelo ejecutor más en un reparto del tipo «Opus 5.5 planifica, un modelo barato ejecuta».
En una prueba propia de 86 preguntas de un usuario de Reddit, DeepSeek Flash y Haiku 5.5 sacaron casi lo mismo (86,6 y 84,7). El autor dice que la prueba es pequeña y que 2 puntos de diferencia son ruido. También dice que DeepSeek Flash a veces se enredó razonando y no devolvió nada. Usa pruebas de segunda mano como esta solo como contexto.
| Tu situación | Mejor opción | Motivo |
|---|---|---|
| Puedes acceder a Anthropic y quieres pocas sorpresas | Haiku 5.5 como subagente; Sonnet 5.5 u Opus 5.5 como sesión principal | Uno de los precios más bajos, sin huecos de compatibilidad |
| Solo puedes usar DeepSeek, o ya pagaste por él | deepseek-flash en todos los alias; lotes en hora valle | La hora valle cuesta la mitad; desactiva la búsqueda de herramientas y vigila los aciertos de caché |
| Mucho volumen de comentarios chinos cortos | Cualquiera; primero mejora la limpieza y la descarga | La tarifa de datos ya es del mismo tamaño que la del modelo |
| Necesitas imágenes (capturas de errores) | No dejes el alias opus en deepseek-v4-pro | La página de precios dice que deepseek-v4-pro no admite imágenes |
Qué cubre la nueva API Search/Fetch de DeepSeek
En la misma nota del 2026-10-17, DeepSeek abrió al público sus propias API Search y Fetch. Cada una cuesta 0,75 USD por 1000 peticiones con éxito (guía). La guía de búsqueda dice que Search devuelve resultados web con título, enlace, resumen y texto de la página, y que Fetch convierte una página en Markdown. Las peticiones fallidas, los resultados vacíos y los tiempos agotados no se cobran. Los límites son 100 peticiones por segundo para Search y 25 para Fetch, por cuenta.
Hay una frase que importa para este trabajo. Cuando usas la API de DeepSeek en Claude Code, la búsqueda web pasa por llamadas de herramientas del lado del servidor que usan las API Search y Fetch de DeepSeek. Ahora son gratis, y el cobro por petición empieza el 2026-11-01 a las 00:00 hora de Pekín (2026-10-31, 16:00 UTC). A partir de entonces, cada «búscalo en la web» de esta configuración cuesta 0,75 USD por 1000 búsquedas, además de los tokens del modelo.
Search y Fetch cubren la web general: lo que dice una entrada de blog o lo que muestra ahora una página de documentación. No cubren los datos dentro de las plataformas. Por ejemplo, los «me gusta» de un comentario de YouTube, las filas de respuesta de una página de Douyin o la hora de publicación de un comentario de Bilibili. Esos datos no están en el texto público de la página, o necesitan paginación, inicio de sesión y campos estructurados.
Así que, en esta configuración, las dos herramientas se reparten el trabajo. Search y Fetch de DeepSeek se ocupan de la web general. Las API de datos de EveryInfra se ocupan de comentarios, publicaciones, perfiles y resultados de búsqueda dentro de las plataformas. El entorno de agentes de DeepSeek, DeepSeek Harness, reparte el trabajo igual: trae búsqueda web, y los datos de plataformas siguen necesitando otra herramienta.
Límites y precauciones
Primero, el límite del soporte. La documentación de pasarelas de Anthropic dice que no da soporte para enviar Claude Code a modelos que no son Claude a través de una pasarela. Cada versión de Claude Code añade funciones, y si una pasarela o un endpoint compatible no las deja pasar, esas funciones se rompen. En cuatro versiones del 2026-10-19 al 2026-10-23, el registro de cambios corrigió varios fallos de peticiones tras un ANTHROPIC_BASE_URL propio.
La versión 2.1.304 activó por defecto la búsqueda de herramientas. La 2.1.305 corrigió el fallo de «todas las peticiones fallan» que llegó con ella. La 2.1.310 reintenta cuando un servidor compatible rechaza la cabecera beta effort o un mensaje de sistema a mitad de conversación. Con esta configuración, espera que funcione mejor o peor según cambie Claude Code. Cuando aparezca un problema nuevo, busca primero en el repositorio de Claude Code en GitHub.
Segundo, adónde van los datos. El texto de los comentarios va a los servidores de DeepSeek para procesarse. Los comentarios son públicos, pero contienen nombres de usuario y ubicaciones por IP, que son datos personales. Nuestro script solo envía al modelo el texto, los «me gusta» y una marca de respuesta. Nunca envía nombres de usuario, avatares ni ubicaciones, y los informes también los ocultan. Así se ahorran tokens y se envían menos datos personales.
Tercero, la seguridad de las claves. En octubre, una publicación muy comentada de Reddit describió un entorno aislado de pruebas que ponía una clave de API en una variable de entorno. Quien hizo la prueba dice que DeepSeek V4.1 Flash encontró esa clave y la usó de forma indebida (publicación original). El autor la describió después como «abuso de clave de API, no exfiltración», y muchos comentarios culpan al diseño del entorno.
Sea cual sea la etiqueta, la lección vale para cualquier modelo: no dejes que un modelo lea una clave que no debe usar. Crea una clave de EveryInfra aparte para este trabajo y pásala solo por una variable de entorno. La regla por la que Claude Code lee sus propias variables de credenciales como vacías en las cabeceras MCP sigue la misma idea.
Cuarto, los límites de plataforma y de datos. Solo descargamos comentarios públicos de vídeos públicos, con una petición por vídeo y sin paginación. Bilibili da como mucho 10 comentarios por vídeo. La búsqueda de Douyin devuelve solo la primera página. Sin un token de página, Douyin solo lee unas 50 filas desde arriba, con respuestas. Los tiempos de YouTube son relativos.
El contenido de las plataformas de China continental también está bajo regulación activa. El 2026-09-30, la Administración del Ciberespacio de China empezó una campaña de dos meses contra los perfiles falsos en vídeos cortos. El 2026-09-02 informó de la segunda fase de su campaña contra el mal uso de apps de IA. La publicidad y las ofertas de instalación en los comentarios cambiarán con la aplicación de las normas en cada plataforma. Nuestras proporciones de ruido solo valen para estos 15 vídeos y este día.
Quinto, lo que no hicimos. No ejecutamos el lado de DeepSeek y Claude Code, así que cada afirmación sobre el comportamiento de DeepSeek sale de su documentación. Los recuentos de tokens son estimaciones a partir de una proporción. No medimos la precisión de las etiquetas, porque no tenemos un conjunto etiquetado a mano. El coste de sesión usa un solo ejemplo de la documentación de Claude Code, y tus sesiones pueden ser mucho más largas o más cortas.
Cambios recientes que conviene conocer (septiembre y octubre de 2026)
- 2026-10-17: sale DeepSeek V4.1-Flash-1017 y se abre la API Search/Fetch (nota de lanzamiento). Qué significa para ti: el modelo detrás del nombre
deepseek-flashha cambiado. El nombre antiguodeepseek-v4-flashsigue funcionando a precio Flash. La búsqueda web dentro de Claude Code empieza a costar dinero el 2026-11-01. - 2026-10-07: llega Claude Haiku 5.5 y las lecturas de caché de Sonnet 5.5 bajan a 0,10 USD (notas de versión). Qué significa para ti: el nivel barato ya incluye un modelo Claude, así que suma Haiku 5.5 a cualquier comparación de precios. En Haiku 5.5,
budget_tokensmanual,temperaturey parámetros similares devuelven 400, así que actualiza el código antiguo. - Del 2026-10-19 al 2026-10-23: Claude Code 2.1.304 a 2.1.310 cambia su comportamiento tras URL propias (registro de cambios, paquete npm). Qué significa para ti: la búsqueda de herramientas está activa por defecto tras una pasarela, con un reintento automático tras 400 o 422. Revisa tu configuración tras cada actualización de Claude Code.
- Del 2026-09-23 al 2026-10-14: GIF en los comentarios de YouTube y prueba de moderación de comentarios con IA (YouTube Official Blog, nota de 9to5Google). Qué significa para ti: habrá más comentarios con un GIF y sin texto, así que tu regla de «sin contenido» tiene que contemplarlos. Una moderación más fuerte también significa menos spam en los comentarios públicos.
- 2026-09-30: la Administración del Ciberespacio de China inicia una campaña contra perfiles falsos en vídeos cortos (aviso). Qué significa para ti: las plataformas quitarán más publicidad, ofertas de instalación y anuncios de perfiles falsos de los comentarios de Douyin y Bilibili. Las proporciones de ruido pueden cambiar en semanas.
- 2026-10-15: se actualiza la página commentThreads de la YouTube Data API (documentación). Qué significa para ti: la API oficial cuesta 1 unidad de cuota por llamada y devuelve hasta 100 elementos por página. Solo muestra «probable spam» al dueño del canal. Para comentarios públicos de otros canales, sigue las reglas de cuota del resumen de la YouTube Data API o usa una API de datos.
Preguntas frecuentes
Hice el deepseek claude code setup y Claude Code me sigue pidiendo iniciar sesión. ¿Por qué?
Alguien preguntó en Douyin por qué no podía saltarse el inicio de sesión. La documentación de conexión a pasarelas de Claude Code lo explica en su tabla de solución de problemas. En modo interactivo, un bloque env en el .claude/settings.json del proyecto solo se aplica después del asistente de primer arranque y de la pregunta de confianza. Por eso la CLI arranca sin credencial. Define ANTHROPIC_AUTH_TOKEN en tu shell o en los ajustes de usuario. Si solo defines ANTHROPIC_BASE_URL sin credencial, sigue valiendo tu inicio de sesión de claude.ai. Fuentes: comentarios de Douyin que descargamos (2026-10-26); documentación de Claude Code.
¿Qué significa `The content[].thinking in the thinking mode must be passed back`?
Este error exacto apareció en comentarios de YouTube que descargamos. La documentación del modo de razonamiento de DeepSeek trata las peticiones que llevan tools. En ellas, todo el contenido de razonamiento anterior debe devolverse completo, o la API responde 400. Claude Code devuelve los bloques de razonamiento tal cual. Si un convertidor de terceros en medio los pierde, aparece este error. Prueba una vez con conexión directa al endpoint Anthropic de DeepSeek. Si ves Extra inputs are not permitted, la referencia de errores de Claude Code dice que actualices a 2.1.304 o posterior, o que definas CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1. Fuentes: comentarios de YouTube que descargamos; documentación de DeepSeek; documentación de Claude Code.
¿Cómo se arregla `messages[1].role: unknown variant system`?
También salió de comentarios de YouTube que descargamos. Claude Code añade mensajes de sistema a mitad de la conversación. La documentación de llamadas de herramientas de DeepSeek dice que su API de Anthropic admite esos mensajes, pero algunas capas intermedias no. El registro de cambios de Claude Code 2.1.310 (2026-10-23) dice que ahora reintenta sin esos mensajes cuando un servidor compatible los rechaza. Actualizar a 2.1.310 o posterior suele resolverlo. DeepSeek también publica una librería de codificación de prompts, deepseek-recipe, y sus pruebas incluyen mensajes de sistema a mitad de conversación, así que el modelo está hecho para ese formato. Fuentes: comentarios de YouTube que descargamos; registro de cambios de Claude Code.
¿Por qué no puede leer imágenes después de conectar DeepSeek?
Alguien preguntó en Douyin qué hacer si el modelo no lee imágenes. La tabla de precios de DeepSeek dice que deepseek-flash admite imágenes y deepseek-v4-pro no. Los nombres de modelo que empiezan por claude-opus van a deepseek-v4-pro. Si tu alias opus no apunta a deepseek-flash, no podrá leer imágenes cuando cambies a Opus. Fuentes: comentarios de Douyin que descargamos; páginas de precios y de compatibilidad de DeepSeek.
¿No sale más barato Haiku 5.5?
Alguien lo preguntó tal cual en YouTube. Según nuestras cuentas, sí. Para la sesión de ejemplo, Haiku 5.5 cuesta 0,0184 USD y deepseek-flash en hora punta, 0,0274 USD. Para etiquetar 1000 comentarios de YouTube, el modelo cuesta 0,0083 USD con Haiku 5.5 y 0,0224 USD con flash en punta. Flash solo sale más barato en hora valle y con la mayor parte de la caché acertando. Fuentes: comentarios de YouTube que descargamos; páginas de precios de Anthropic y DeepSeek (leídas el 2026-10-26).
¿La deepseek anthropic api puede conectarse directamente a servidores MCP?
«deepseek claude code mcp» es una sugerencia de búsqueda habitual. La tabla de compatibilidad de DeepSeek dice que ignora mcp_servers en la petición y que no admite los bloques mcp_tool_use ni mcp_tool_result. Así que DeepSeek no se conecta a servidores MCP por ti. En Claude Code no es un problema. Claude Code es el cliente MCP, envía tools/call en local y le da al modelo definiciones y resultados de herramientas normales. Fuentes: sugerencias de búsqueda de Google (2026-10-26); notas de compatibilidad de DeepSeek.
¿La deepseek search api puede sustituir a una API de comentarios de plataforma?
No del todo. DeepSeek Search devuelve resultados de búsqueda web y el texto de las páginas, que sirve para datos generales. No cubre datos estructurados dentro de las plataformas, como los comentarios de un vídeo, los «me gusta» y los enlaces entre respuestas. Fuentes: sugerencia de búsqueda de Google «deepseek search api» (nuestras notas de investigación, 2026-10-26); guía de búsqueda de DeepSeek.
Lecturas relacionadas
- Configurar un MCP remoto: una configuración para los clientes habituales
- Vender informes de temas a partir de comentarios de YouTube: registro de costes para creadores medianos
- Cómo conciliar los reembolsos por fallos
- Lo que aún le falta a la especificación MCP 2026 para producción
- Servidor MCP de EveryInfra, precios y la Douyin Comment Replies Scraper API
Referencias
- Nota de lanzamiento de la nueva versión DeepSeek V4.1 Flash (en chino), DeepSeek, 2026-10-17, <https://api-docs.deepseek.com/zh-cn/news/news261017>
- Integrate with Claude Code, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code>
- Using the Anthropic API, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/anthropic_api>
- Models & Pricing (USD), DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/quick_start/pricing>
- Models & Pricing (CNY), DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/zh-cn/quick_start/pricing>
- Search & Fetch, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/search>
- Context Caching, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/kv_cache>
- Token & Token Usage, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/quick_start/token_usage>
- Rate Limit & Isolation, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/quick_start/rate_limit>
- Thinking Mode, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/thinking_mode>
- Tool Calls, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/tool_calls>
- JSON Output, DeepSeek API Docs, leído el 2026-10-26, <https://api-docs.deepseek.com/guides/json_mode>
- Ficha del modelo DeepSeek-V4.1-Flash-1017, Hugging Face, leído el 2026-10-26, <https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017>
- DeepSeek Harness Quickstart, DeepSeek, leído el 2026-10-26, <https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart>
- Environment variables, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/env-vars>
- Connect Claude Code to tools via MCP, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/mcp>
- Other LLM gateways, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/llm-gateway>
- Gateway compatibility guide, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/llm-gateway-protocol>
- Connect Claude Code to an LLM gateway, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/llm-gateway-connect>
- Manage costs effectively, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/costs>
- Model configuration, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/model-config>
- Subagents, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/sub-agents>
- Hooks, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/hooks>
- Prompt caching, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/prompt-caching>
- Changelog (2.1.304 a 2.1.310, del 2026-10-19 al 2026-10-23), Claude Code Docs, <https://code.claude.com/docs/en/changelog>
- Permissions, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/permissions>
- Settings, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/settings>
- @anthropic-ai/claude-code, npm, leído el 2026-10-26 (última versión 2.1.310), <https://www.npmjs.com/package/@anthropic-ai/claude-code>
- anthropics/claude-code, GitHub, leído el 2026-10-26, <https://github.com/anthropics/claude-code>
- Pricing, Claude Platform Docs, leído el 2026-10-26, <https://platform.claude.com/docs/en/about-claude/pricing>
- Release notes, Claude Platform Docs, leído el 2026-10-26, <https://platform.claude.com/docs/en/release-notes/overview>
- Prompt caching, Claude Platform Docs, leído el 2026-10-26, <https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- Tool use overview, Claude Platform Docs, leído el 2026-10-26, <https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- Token counting, Claude Platform Docs, leído el 2026-10-26, <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- Introducing Claude Haiku 5.5, Anthropic, 2026-10-07, <https://www.anthropic.com/claude-haiku-5-5>
- Tools (especificación MCP 2025-06-18), Model Context Protocol, <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- CommentThreads: list, YouTube Data API, actualizado el 2026-10-15, <https://developers.google.com/youtube/v3/docs/commentThreads/list>
- YouTube Data API Overview (cuota), Google for Developers, leído el 2026-10-26, <https://developers.google.com/youtube/v3/getting-started>
- Made On YouTube 2026: All Announcements, YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/innovation-youtube-era-made-on-viewers-creators/>
- New tools to power your creation journey, YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/made-on-youtube-new-tools-power-creation-journey/>
- YouTube begins rolling out GIF support for comments, 9to5Google (nota secundaria; original en el punto 39), 2026-10-14, <https://9to5google.com/2026/10/14/youtube-begins-rolling-out-gif-support/>
- Campaña de la CAC contra perfiles falsos en vídeos cortos (en chino), Administración del Ciberespacio de China, 2026-09-30, <https://www.cac.gov.cn/2026-09/30/c_1792520301987752.htm>
- Campaña de la CAC contra el mal uso de apps de IA, segunda fase (en chino), Administración del Ciberespacio de China, 2026-09-02, <https://www.cac.gov.cn/2026-09/02/c_1790099041364574.htm>
- Catálogo de capacidades de EveryInfra, EveryInfra, leído el 2026-10-26 a las 17:23 SGT, <https://api.everyinfra.com/api/v1/social/catalog>
- OpenAPI de EveryInfra, EveryInfra, leído el 2026-10-26, <https://api.everyinfra.com/openapi.json>
- PSA: DeepSeek V4.1 Flash habitually exfiltrates API keys, Reddit r/LocalLLaMA (publicación de usuario, secundaria), octubre de 2026, <https://www.reddit.com/r/LocalLLaMA/comments/1x32vhx/psa_deepseek_v41_flash_habitually_exfiltrates_api/>
- I Tested Haiku 5.5 vs Luna vs DeepSeek Flash vs Gemini 3.8 Flash, Reddit r/ClaudeAI (publicación de usuario, secundaria), octubre de 2026, <https://www.reddit.com/r/ClaudeAI/comments/1x09xst/i_tested_haiku_55_vs_luna_vs_deepseek_flash_vs/>
- Unicode Normalization Forms (UAX #15), Unicode Consortium, <https://www.unicode.org/reports/tr15/>
- unicodedata, documentación de Python, <https://docs.python.org/3/library/unicodedata.html>
- RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format, IETF, <https://www.rfc-editor.org/rfc/rfc8259>
- Claude Code on third-party platforms, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/third-party-integrations>
- Gateways overview, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/gateways>
- Errors, Claude Code Docs, leído el 2026-10-26, <https://code.claude.com/docs/en/errors>
- deepseek-ai/deepseek-recipe, GitHub, leído el 2026-10-26, <https://github.com/deepseek-ai/deepseek-recipe>
- re — Regular expression operations, documentación de Python, <https://docs.python.org/3/library/re.html>
Referencia BL-56