Proxy residencial o API de datos: cuándo usar cada uno, con la configuración de 1024Proxy
Las bases de IP marcan la nube como centro de datos. Probamos 88 IP y 5 páginas desde una línea doméstica: cuándo usar 1024Proxy y cuándo llamar a una API.
Un servidor en la nube se reconoce fácilmente por su IP de salida. El 09-11-2026 a las 00:23, hora de Singapur, tomamos 40 direcciones de las listas públicas de 10 empresas de nube y las consultamos en dos bases de datos de IP. Una de las dos bases, o las dos, marcó 39 de las 40 como centro de datos o VPN. También tomamos 42 direcciones de operadores de banda ancha doméstica, y solo 1 recibió la marca de centro de datos.
Ese es el problema que resuelve un servicio de IP residenciales como 1024Proxy: lleva la salida de tu propio scraper a una línea de banda ancha de un hogar. Pero la salida es solo la primera puerta. Ese mismo día, a las 00:24, usamos una línea doméstica de Singapur que ninguna base de centros de datos marca. Abrimos en Chrome sin interfaz las páginas de búsqueda de 5 plataformas, y solo YouTube mostró resultados.
Reddit pidió una verificación humana, Amazon devolvió HTTP 503, Shopee exigió iniciar sesión y la zona de resultados de TikTok mostró un error. A las 00:18 y 00:19, desde la misma máquina, llamamos a la capacidad de búsqueda de EveryInfra para esas 5 plataformas. Las 5 llamadas devolvieron entre 10 y 20 filas estructuradas, con un cargo total de $0.010307.
Publicamos este artículo por primera vez el 07-11-2026. El 09-11-2026 revisamos otra vez los precios y la ayuda de 1024Proxy y añadimos cuatro pruebas nuevas. La primera mide cómo etiquetan las bases de IP cada salida. La segunda pesa una carga de página sobre una salida residencial. La tercera muestra cómo escribir las credenciales del proxy sin errores. La cuarta detecta qué clientes HTTP meten por error las llamadas a la API de datos dentro del proxy.
La idea central no cambia. Un proxy residencial se ocupa de las peticiones que tú mandas a los sitios objetivo. Una API de datos se ocupa de los datos estructurados de las plataformas que ya tiene en su catálogo. Cada uno cubre una capa distinta del mismo sistema, y conviene saber en qué capa cae cada petición antes de pagar por tráfico.
EveryInfra ofrece a herramientas de IA y a desarrolladores una sola API de datos. Mandas POST https://api.everyinfra.com/api/v1/social con platform, action y params, y recibes datos públicos de muchas plataformas. El 09-11-2026 a las 00:17, hora de Singapur, el catálogo de capacidades, que es gratuito, listaba 106 plataformas y 573 capacidades. De ellas, 571 estaban disponibles, frente a las 570 de nuestro borrador del 07-11-2026.
Muchos equipos tienen además sitios que no están en ningún catálogo, paneles que piden inicio de sesión y scrapers que escribieron ellos mismos. Suelen ejecutar ese código en servidores de nube y, con el tiempo, los sitios objetivo empiezan a limitar sus peticiones. Este artículo explica primero de dónde vienen esos límites. Después muestra cómo conectar un proxy residencial y cómo estimar la factura de tráfico. Al final indica qué tareas no necesitan proxy en absoluto.
Las reglas que fijamos antes de empezar
Escribimos cuatro reglas antes de ejecutar ninguna prueba, para que los resultados no pudieran cambiar las reglas. Primera: una conclusión sobre etiquetas de IP necesita al menos 40 direcciones de nube y 20 de banda ancha, consultadas en al menos dos bases de datos. Segunda: una página cuenta como éxito solo si aparecen resultados de búsqueda en ella. Un HTTP 200 no cuenta, porque las páginas de verificación humana y los muros de inicio de sesión también devuelven 200.
Tercera: el coste de tráfico usa solo bytes medidos multiplicados por el precio de lista de 1024Proxy, sin estimaciones ni medias del sector. Cuarta: un cliente «usa el proxy» solo si nuestro proxy simulado local registra una conexión a api.everyinfra.com:443. No lo dedujimos de la documentación. Estas reglas también marcan los límites del artículo. No tenemos cuenta en 1024Proxy, así que no probamos a través de sus salidas residenciales.
El peso de cada página viene de una sola carga, que es una muestra pequeña. Las etiquetas de IP vienen solo de dos bases gratuitas. Cada resultado de abajo dice en qué condiciones se cumple. Puedes aplicar las mismas reglas a tus propias páginas objetivo y obtener cifras que encajen con tu caso.
1. El problema habitual: tu scraper sale por una IP de centro de datos
Un servicio alojado en un servidor de nube manda todas sus peticiones salientes desde las direcciones IP de la empresa de nube. Cada bloque de direcciones IP de internet pertenece a un sistema autónomo (AS). Cada AS tiene un número, el ASN, y lo gestiona un solo operador de red con una sola política de rutas (ARIN: Autonomous System Numbers, RFC 1930).
Un ASN solo dice quién gestiona el bloque. No dice «centro de datos» ni «hogar»: esas etiquetas las ponen las bases de datos de IP. Por ejemplo, la guía de datos ASN de IPinfo da a cada ASN un campo type con valores como isp, business, hosting y education. La documentación de la API JSON de ip-api.com tiene un campo hosting para direcciones de alojamiento, colocación o centro de datos.
La base comercial Anonymous IP de MaxMind tiene a la vez is_hosting_provider e is_residential_proxy. Es decir, las salidas de los proxies residenciales también son algo que las bases de datos etiquetan. Este detalle importa para el resto del artículo, porque significa que una salida residencial tampoco es invisible para siempre.
Nuestro primer borrador solo consultó tres IP, que únicamente enseñan cómo es una etiqueta, así que esta vez usamos 88 direcciones. Para la nube usamos las listas que publica cada empresa. La primera es ip-ranges.json de AWS (guía), generada el 08-11-2026, con 1906 prefijos IPv4 para EC2. La segunda es cloud.json de Google Cloud (guía), generada el mismo día.
También usamos public_ip_ranges.json de Oracle Cloud (guía), actualizado el 28-10-2026. DigitalOcean publica un archivo de geolocalización, y Linode, que pertenece a Akamai, publica un geofeed en el formato de RFC 8805. No encontramos listas públicas igual de limpias para Azure, Hetzner, OVHcloud, Alibaba Cloud y Tencent Cloud. Para esas cinco usamos la API announced-prefixes de RIPEstat y tomamos los prefijos que sus ASN anunciaban el 08-11-2026.
Para la banda ancha también usamos RIPEstat. Tomamos 14 operadores de línea fija. En América Latina están Claro Brasil y Telmex, que interesan a quien vende o mide precios en México y Brasil. En EE. UU. y Reino Unido están Comcast, Charter, BT y Virgin Media. En Europa y Asia están Deutsche Telekom, Orange, NTT OCN, KT y Telkom Indonesia, y en Singapur, Singtel, StarHub y M1. Añadimos dos operadores móviles, T-Mobile US y Jio.
| Grupo | Empresas | De dónde salen los prefijos |
|---|---|---|
| Nube con lista propia | AWS, Google Cloud, Oracle Cloud, DigitalOcean, Akamai/Linode | Archivos públicos de cada empresa (08-11-2026 y 28-10-2026) |
| Nube sin lista limpia | Azure, Hetzner, OVHcloud, Alibaba Cloud, Tencent Cloud | Prefijos anunciados por su ASN en RIPEstat (08-11-2026) |
| Línea fija | 14 operadores de América, Europa y Asia | Prefijos anunciados por su ASN en RIPEstat (08-11-2026) |
| Móvil | T-Mobile US, Jio | Prefijos anunciados por su ASN en RIPEstat (08-11-2026) |
El muestreo usó una semilla aleatoria fija. Para cada empresa elegimos prefijos al azar y después una dirección de host al azar dentro de cada prefijo. Tomamos 4 direcciones por empresa de nube y 3 por operador, 88 en total. El 09-11-2026 a las 00:23, hora de Singapur, mandamos las 88 direcciones al servicio por lotes de ip-api.com, que acepta hasta 100 por llamada. Después las mandamos a la versión v2 de proxycheck.io, que da 100 consultas gratis al día sin registro.
Una dirección elegida al azar no siempre está en uso. Las bases suelen etiquetar esas direcciones por bloque entero o por ASN entero. Por eso estas cifras dicen qué tipo tiene el bloque en la base de datos. No dicen qué hace ahora mismo una máquina concreta, y conviene leerlas con esa cautela.
| Grupo de muestra | Cantidad | ip-api `hosting=true` | proxycheck: VPN o centro de datos | proxycheck: Residential | proxycheck: Business |
|---|---|---|---|---|---|
| Listas de IP de nube (10 empresas) | 40 | 30 (75 %) | 38 (95 %) | 0 | 2 |
| Operadores de línea fija (14 empresas) | 42 | 1 (2.4 %) | 0 | 15 (36 %) | 26 (62 %) |
| Operadores móviles (2 empresas) | 6 | 1 | 0 | 0 | 1 (otros 5 con Wireless) |
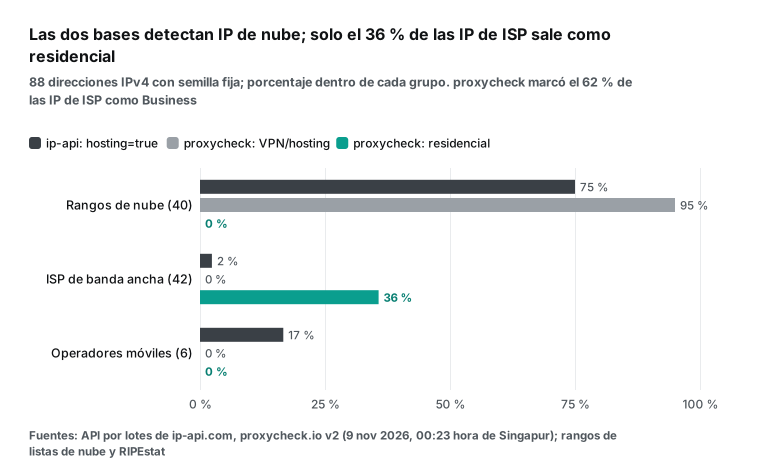
La tabla se lee de dos maneras. Primera: las direcciones de nube son difíciles de esconder. Al menos una de las dos bases marcó 39 de 40, es decir, el 97.5 %. La única dirección que ninguna base marcó venía de la lista de AWS. Segunda: «no es centro de datos» no significa «es residencial». De las 42 direcciones de banda ancha, proxycheck solo etiquetó 15 como Residential y 26 como Business.
Los grandes operadores venden a la vez banda ancha para hogares y líneas para empresas. Cuando un bloque se asigna a clientes empresariales, la base lo etiqueta como Business. Las etiquetas también cambian dentro de un mismo operador. La tabla muestra cómo etiquetó proxycheck las 3 direcciones de cada operador (su campo type).
| Etiquetas de proxycheck (3 por operador) | Operadores |
|---|---|
| Las 3 Residential | StarHub |
| 2 Residential, 1 Business | Singtel, Virgin Media, Orange, Telmex, Telkom Indonesia |
| 1 Residential, 2 Business | Comcast (ip-api marcó 1 de ellas como hosting), BT |
| Ninguna Residential | Charter, Deutsche Telekom, NTT OCN, KT y Claro: 3 Business cada uno. M1: 2 Business y 1 Wireless |
Además, las dos bases no responden a la misma pregunta. ip-api solo tiene tres campos de sí o no, hosting, proxy y mobile, y ninguno para «residencial»: dio hosting=false a 41 de las 42 direcciones de banda ancha. proxycheck da un solo valor de type por dirección. Así que nuestra muestra solo indica esto: cerca de un tercio de las direcciones de operador recibió la etiqueta Residential de proxycheck, y la mayoría recibió Business. El nombre del operador no basta para adivinar la etiqueta. Cuando compres una IP ISP o residencial, revísala en dos bases en cuanto la recibas.
La guía de IP residenciales con doble ISP del blog de 1024Proxy, del 29-10-2026, también aconseja revisar la IP en una base de datos al recibirla. Las preguntas frecuentes de su página de precios (guardada a las 02:44, hora de Singapur, del 09-11-2026) dicen que, si la región de una IP no coincide con la de algunos sitios de comprobación, la referencia es IPinfo. Es decir, que bases distintas den respuestas distintas es lo normal. Antes de comprar, pregunta qué base usa el proveedor como referencia.
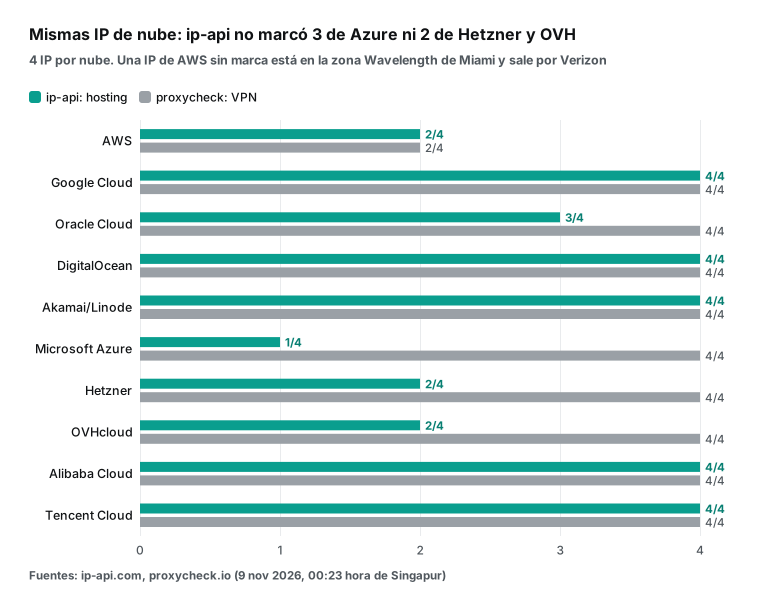
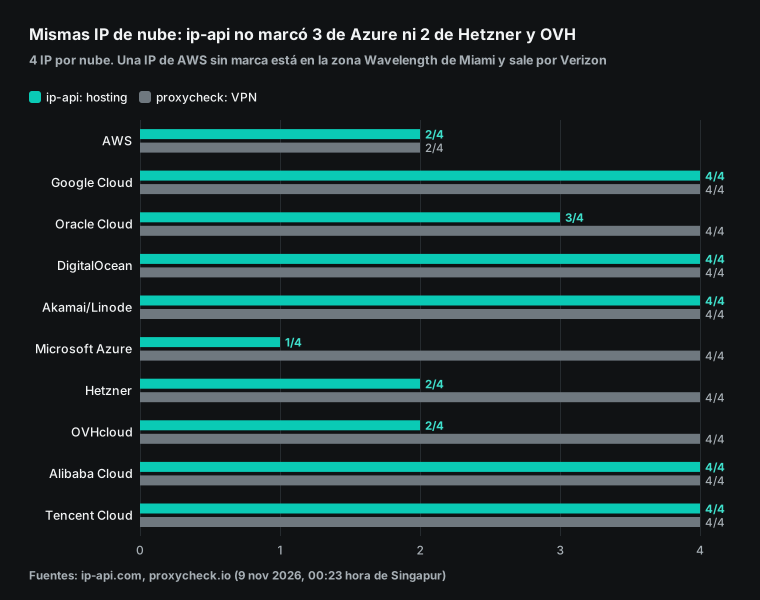
La diferencia se ve mejor por empresa. ip-api no marcó 3 direcciones de Azure ni 2 de Hetzner y 2 de OVHcloud, pero proxycheck marcó las 4 de cada una de esas tres empresas. En AWS, las dos bases marcaron solo 2, por motivos distintos. Una dirección pertenece a la región us-gov-west-1, y proxycheck la etiquetó como Business. Otra, del bloque 155.146.80.0/20, figura en la lista de AWS como us-east-1-wl1-mia-wlz-1, es decir, la zona Wavelength de Miami.
AWS Wavelength coloca la computación dentro de la red de un operador de telecomunicaciones y usa direcciones del operador. En RIPEstat, ese bloque lo anuncia Verizon Business (AS6167), e ip-api lo etiquetó con mobile=true.
ip-api pasó por alto otra dirección de AWS: 35.55.10.109. La lista de AWS sitúa 35.55.10.0/24 en EC2, en la región de Sídney (ap-southeast-2). ip-api devolvió para ella el ASN AS16509 Amazon.com, Inc., pero con hosting en false, y proxycheck la etiquetó como VPN. Es decir, ip-api no marca hosting para todo un ASN de golpe y puede pasar por alto un bloque pequeño dentro de un ASN de nube. Por eso conviene comparar dos bases. La regla «un servidor de nube siempre sale marcado como centro de datos» tiene excepciones, pero las que se escapan de las dos bases a la vez son raras, y una instancia EC2 normal no puede elegirlas.
La tabla muestra una por una las 4 muestras de AWS, para ver dónde falló cada base.
| Dirección | Región en la lista de AWS | ip-api (ASN, `hosting`) | proxycheck |
|---|---|---|---|
| 3.32.158.126 | us-gov-west-1 | AS8987, true | Business |
| 155.146.82.54 | Zona Wavelength de Miami (us-east-1-wl1-mia-wlz-1) | AS6167 Verizon Business, false (mobile=true) | Business |
| 35.55.10.109 | Sídney (ap-southeast-2) | AS16509, false | VPN |
| 54.180.190.35 | Seúl (ap-northeast-2) | AS16509, true | VPN |
¿Qué puede hacer un sitio con esas etiquetas? La documentación de las CDN y de los cortafuegos en la nube lo dice sin rodeos. Las reglas de acceso por IP de Cloudflare permiten permitir, bloquear o desafiar visitas por IP, ASN o país. Las reglas personalizadas de Cloudflare tienen el campo ip.src.asnum para el ASN. AWS WAF tiene una regla de coincidencia por ASN, y el lenguaje de reglas de Google Cloud Armor tiene origin.asn.
Cloudflare además asigna a cada petición una puntuación de bot, y el dueño del sitio puede filtrar el tráfico por esa puntuación. Por eso, en tareas de mucho volumen o de larga duración, las peticiones desde IP de centro de datos reciben más CAPTCHA. También pueden recibir 403 Forbidden, o 429 Too Many Requests si llegan demasiado rápido. Esto ocurre en la salida de red y no es un fallo del código de tu scraper.
También tiene un límite. El mismo sitio mira la frecuencia de peticiones, las cookies y el comportamiento del navegador. Si solo cambias la IP y nada más, el sitio puede seguir limitándote. La prueba de la sección siguiente lo mide con cifras concretas.
2. La solución: dar a tu scraper una IP de salida residencial
Para que las peticiones de tu propio scraper pasen con más facilidad, cambia su IP de salida a una línea real de banda ancha doméstica. Eso es una IP residencial. Su ASN pertenece a un operador local de banda ancha, así que en la base de datos del sitio objetivo se parece más a un usuario normal. 1024Proxy da el mismo consejo en su guía de doble ISP del 29-10-2026: cuando recibas una IP, comprueba su ASN y su etiqueta residencial en una base como IPinfo.
Es la misma comprobación que usamos en la sección 1. La entrada del 14-10-2026 de 1024Proxy sobre cómo comprobar la reputación de una IP añade una advertencia útil. Una reputación limpia no garantiza que tu trabajo salga bien. Los sitios también miran la frecuencia de peticiones, el comportamiento de navegación, el estado de la cuenta y los datos del dispositivo. Nuestra prueba de páginas, más abajo, pone cifras a esa advertencia.
La empresa detrás de 1024Proxy es GUANG XUN YONG YAO LIMITED, fundada en 2024 (quiénes somos). Tiene tres tipos de producto para tres tipos de trabajo de scraping. Abajo explicamos qué tipo encaja con cada tarea. Revisamos de nuevo cada función y cada precio contra sus páginas oficiales el 09-11-2026, y guardamos el HTML original de esas páginas a las 02:44, hora de Singapur, para poder comparar si los precios cambian.
Scraping rotativo de páginas públicas: tráfico residencial rotativo. Una salida residencial resuelve el problema de la sección 1: una IP que la base de datos etiqueta como centro de datos. No medimos si además provoca menos CAPTCHA o sube la tasa de éxito frente a una salida de centro de datos. El apartado siguiente muestra que, con una salida residencial, solo 1 de 5 páginas mostró resultados. Así que no des por hecho que la tasa de éxito va a subir.
El producto de tráfico residencial rotativo de 1024Proxy permite segmentar por país, estado o provincia, ciudad y operador, sin coste extra por segmentar. Las sesiones pueden ser fijas (la misma IP entre 1 y 120 minutos) o rotativas (una IP nueva por petición). Los protocolos son HTTP(S) y SOCKS5 (página de tráfico residencial rotativo). La página de inicio anuncia un 99.5 % de tiempo activo; es una afirmación de la propia empresa y no la medimos. La guía de control de sesiones recomienda sesiones rotativas para scraping, recogida de resultados de buscadores y seguimiento de precios, y aconseja controlar la frecuencia de peticiones e imitar un ritmo de visita real.
Cuentas y tiendas con sesión iniciada: ISP estático. Algunas tareas tienen que mantener la sesión iniciada durante mucho tiempo, como el panel de una tienda o una cuenta de redes sociales. Necesitan una salida que no cambie durante días o meses, y una sesión fija del residencial rotativo dura como máximo 120 minutos. El producto ISP estático de 1024Proxy ofrece IP nativas dedicadas sin límite de tráfico, durante 7, 30 o 90 días (página de ISP estático).
El 09-11-2026 esa página listaba precios por IP según el país, en dos grupos: «nativa doméstica» y «difusión doméstica». En el grupo de nativa doméstica, EE. UU., Alemania y Reino Unido costaban $3.9 por IP (precio tachado de $4.9), y Singapur $5.8 por IP. Había también una opción «EE. UU. doble Comcast» a $5.5 por IP. En el grupo de difusión doméstica, Singapur y Alemania costaban $2.9 por IP. La página no indica a qué periodo de validez corresponde cada precio, así que revisa la página de pago antes de comprar. Una salida fija cuesta más porque compras cada IP: 10 IP nativas domésticas de EE. UU. al precio listado de $3.9 suman $39. Con el método de la sección 4, el tramo de 1 TB del residencial rotativo, por $490, cubre unos 3 millones de cargas de solo HTML de la página de búsqueda de YouTube. Así que compra IP estáticas solo para tareas que de verdad necesitan una identidad fija.
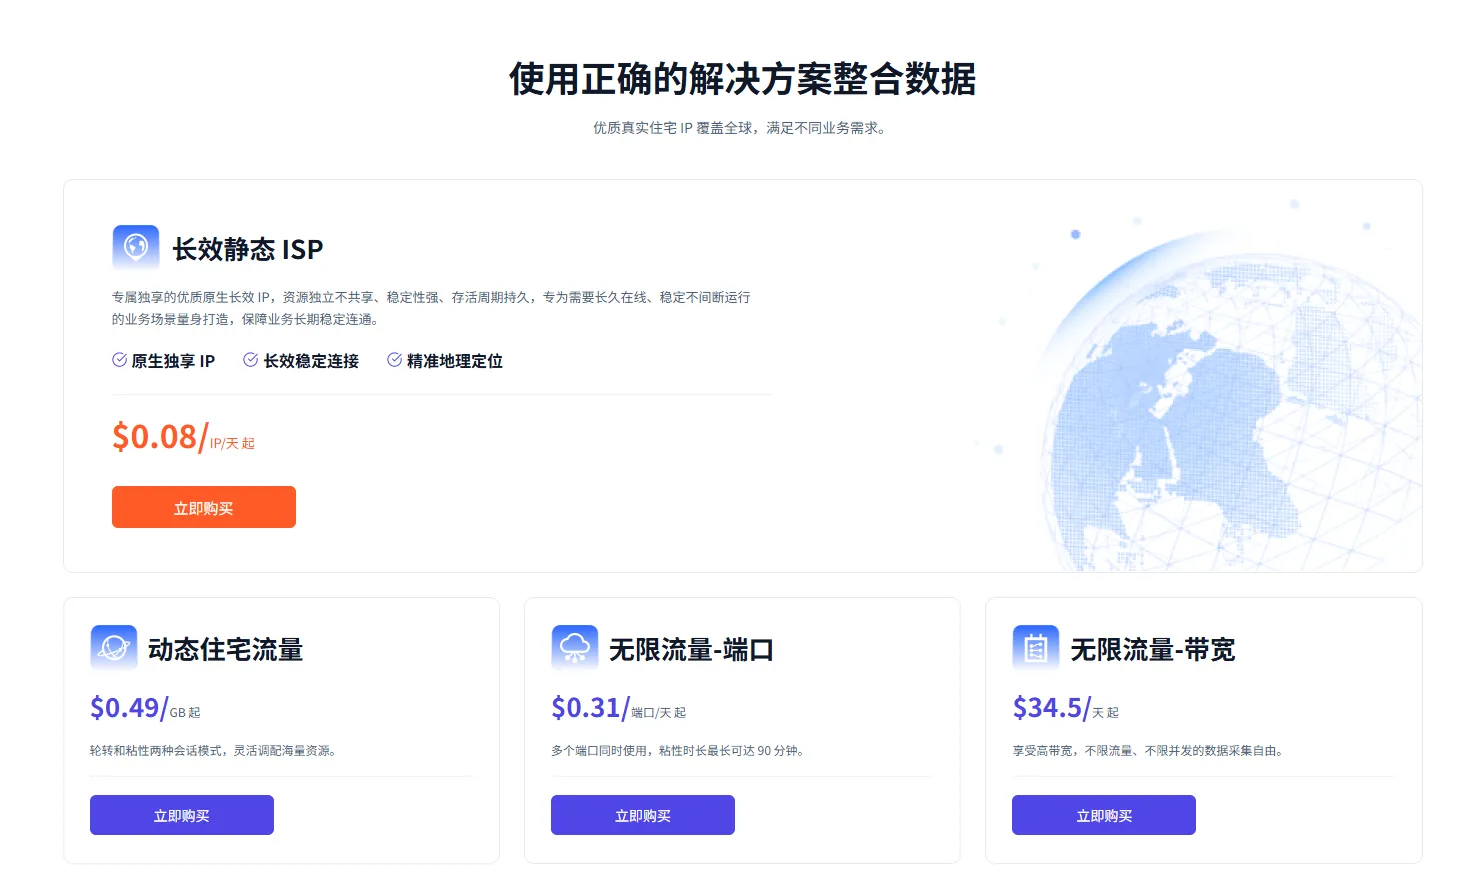
El «desde $0.08 por IP y día» de la tarjeta de la página de inicio es el precio diario más bajo. La guía de control de sesiones también dice que las sesiones fijas del producto residencial rotativo duran como máximo 120 minutos. Para trabajos más largos, elige el ISP estático y renuévalo en el panel antes de que caduque (guía de inicio de sesión del ISP estático).
Archivos grandes, audio y vídeo: tráfico ilimitado. Si pagas por GB, cuanto más descargas, más pagas. Los planes de tráfico ilimitado cobran por puerto o por ancho de banda. Encajan con tareas de descargas grandes cuyo volumen total es difícil de prever. 1024Proxy tiene dos. «Tráfico ilimitado por puerto» empieza en 2 puertos durante 3 días por $5.00, unos $0.83 por puerto y día. El tramo de 101 a 999 puertos cuesta $127.26 por 101 puertos durante 3 días, es decir, $0.42 por puerto y día. La página dice que la IP rota sola cada 3 a 30 minutos y menciona como usos la protección de marca y la descarga de texto e imágenes.
«Tráfico ilimitado por ancho de banda» cuesta $1,035 por 100 Mbps durante 30 días ($34.50 al día), $1,709.10 por 200 Mbps y $3,005.10 por 400 Mbps. No tiene límite de tráfico ni de concurrencia (página de tráfico ilimitado). La columna de «precio unitario» del texto estático de esa página no cuadra con los totales. Por ejemplo, el tramo de 2 a 15 puertos muestra un precio unitario de $0.56. Dividimos cada total entre puertos y días, y los resultados coinciden con los $0.83 y $0.42 de nuestro borrador del 07-11-2026. Las preguntas frecuentes de la página de precios dan otro dato que afecta a la elección: cada puerto tiene 6 Mbps de ancho de banda, y el plan por ancho de banda usa un servidor dedicado. A 6 Mbps sin pausa, un puerto mueve como mucho unos 64.8 GB al día. Así que el número de puertos fija tu límite de concurrencia y de volumen; no es ilimitado de verdad. La tabla resume los tramos de los dos planes (totales para 3 y 30 días, guardados el 09-11-2026).
| Plan | Tramo | Total | Por unidad |
|---|---|---|---|
| Ilimitado por puerto, 3 días | 2–15 puertos (con 2 puertos) | $5.00 | Unos $0.83 por puerto y día |
| Ilimitado por puerto, 3 días | 16–40 puertos | $32.00 | — |
| Ilimitado por puerto, 3 días | 41–100 puertos | $68.06 | — |
| Ilimitado por puerto, 3 días | 101–999 puertos (con 101 puertos) | $127.26 | Unos $0.42 por puerto y día |
| Ilimitado por ancho de banda, 30 días | 100 / 200 / 300 / 400 Mbps | $1,035 / $1,709.10 / $2,429.10 / $3,005.10 | $34.50 / $56.97 / $80.97 / $100.17 al día |
Nuestro primer borrador no trataba otro producto: la «IP residencial rotativa», que se cobra por número de IP (página de precios SOCKS5). Cubre más de 195 países y regiones, sin límite de tráfico mientras usas las IP. El tramo para empresas admite reparto de claves CDK. Los tramos son estos (guardados a las 02:44, hora de Singapur, del 09-11-2026).
| Tramo | Total | Por IP |
|---|---|---|
| 20 IP | $3.00 | $0.15 |
| 100 IP | $12.00 | $0.12 |
| 500 IP | $30.00 | $0.06 |
| 10 000 IP | $390.00 | $0.039 |
| 30 000 IP | $900.00 | $0.03 |
| 80 000 IP | $2,160.00 | $0.027 |
El precio por IP baja a medida que sube el tramo. Con 80 000 IP, cada una cuesta menos de una quinta parte que en el tramo de 20, pero solo compensa si de verdad usas tantas salidas distintas.
La página de inicio lista además dos ofertas para usuarios nuevos: puedes pedir al soporte 1 GB de tráfico de prueba, y hay un plan inicial de $0.99 durante los 7 primeros días tras el registro. La tabla siguiente recoge el precio de partida y la unidad de cobro de los cinco productos. Son precios de lista en USD tal como se mostraban en la web de 1024Proxy el 09-11-2026.
| Producto | Precio de lista el 09-11-2026 | Unidad de cobro | Mejor uso en tareas de datos |
|---|---|---|---|
| Tráfico residencial rotativo | 2–100 GB $1.20/GB, 200 GB $0.70/GB, 1 TB $0.49/GB | Por GB, no caduca | Scraping rotativo de páginas públicas, páginas locales por ciudad |
| IP residencial rotativa | 20 IP a $0.15 cada una, 80 000 a $0.027 cada una | Por IP, tráfico ilimitado mientras se usa | Muchas salidas distintas con poco uso por salida |
| ISP estático | Desde $0.08 por IP y día, precio por IP según país, por ejemplo EE. UU. $3.9 | Por IP y periodo (7/30/90 días) | Tiendas y cuentas con sesión iniciada en una salida fija |
| Tráfico ilimitado por puerto | 2 puertos 3 días $5.00, 101 puertos 3 días $127.26 | Por puerto y día | Usos indicados: protección de marca, descarga de texto e imágenes |
| Tráfico ilimitado por ancho de banda | 100 Mbps 30 días $1,035 | Por ancho de banda, 30, 7 o 1 días | Descargas grandes de audio y vídeo |
Una salida residencial es necesaria, pero no suficiente
Para ver hasta dónde llega una salida residencial por sí sola, hicimos una prueba pequeña el 09-11-2026 entre las 00:24 y las 00:25, hora de Singapur. La salida fue nuestra línea doméstica de banda ancha en Singapur. ip-api devolvió el ASN AS4817 con hosting, proxy y mobile en false. Para una base de datos es una línea residencial normal, así que sirve como sustituto ideal de la salida de un proxy residencial.
Abrimos las páginas de búsqueda por palabra clave de 5 plataformas de dos maneras. La primera usó curl para bajar solo el HTML. La segunda usó Chrome sin interfaz para una carga completa: cada página tuvo un contexto de navegador nuevo y sin caché, y esperamos 8 segundos al terminar la carga. La prueba con navegador tuvo dos niveles: página completa, y página con imágenes, contenido multimedia y fuentes bloqueados.
Sumamos los bytes con encodedDataLength del Chrome DevTools Protocol. Es el número de bytes que viajan por la red, y es el que usa una factura de proxy por GB. La tabla muestra qué obtuvo cada método.
| Página de búsqueda | curl, solo HTML | Resultados en el HTML | Navegador, página completa | Qué mostró el navegador |
|---|---|---|---|---|
| TikTok «residential proxy» | 200, 96.0 KB | 0 | 5.15 MB, 225 peticiones | La zona de resultados decía «Something went wrong» |
| YouTube «residential proxy» | 200, 328.7 KB | 43 ID de vídeo | 4.24 MB, 150 peticiones | Aparecieron resultados |
| Reddit «residential proxy» | 200, 9.7 KB | 0 (estructura vacía) | 542.9 KB, 7 peticiones | Página de verificación «Prove your humanity» |
| Amazon «usb c cable» | 200, 229.5 KB | 30 ASIN | 78.2 KB | HTTP 503 «Sorry! Something went wrong!» |
| Shopee Indonesia «usb c cable» | 200, 25.6 KB | 0 | 4.20 MB, 189 peticiones | Redirigida a /verify/traffic/error, pide iniciar sesión |
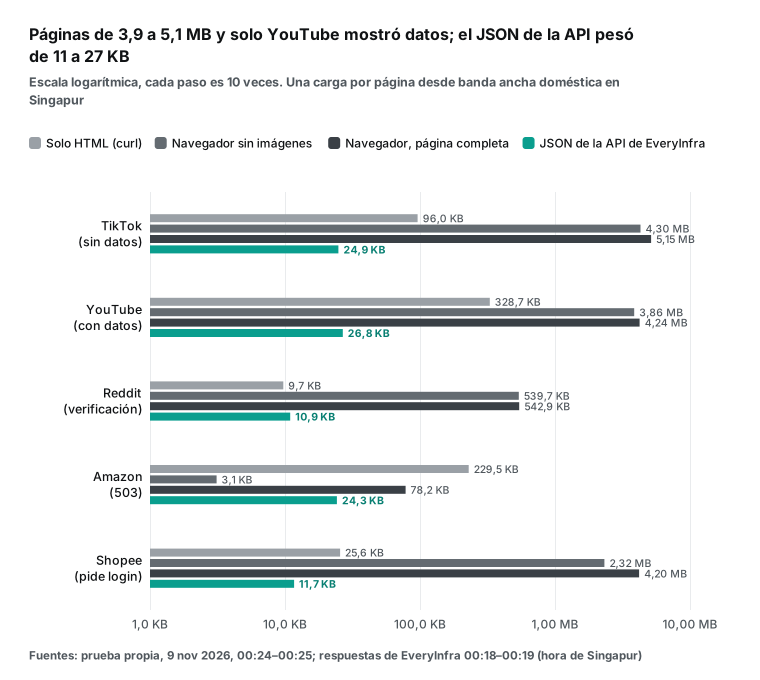
De las cinco páginas, el navegador solo obtuvo resultados en YouTube. Con curl hubo datos aprovechables en dos HTML: 43 ID de vídeo en YouTube y 30 ASIN en Amazon. Pero Amazon devolvió 503 al navegador sin interfaz, así que trata de forma distinta a los navegadores sin interfaz y a los clientes HTTP simples. Los cuatro fallos ocurrieron sobre una salida residencial. Por tanto, la causa no es el tipo de IP, sino la huella del navegador, el estado de la sesión y el patrón de peticiones.
Esto coincide con la advertencia de 1024Proxy de que una reputación limpia puede fallar igualmente. También coincide con el consejo de la guía de control de sesiones de controlar la frecuencia de peticiones. La prueba tiene límites claros que conviene decir. Cargamos cada página una sola vez.
Nuestra salida está en Singapur, mientras que los sitios por defecto de TikTok y Amazon están en EE. UU. Otra salida de otro país, cookies guardadas o un navegador con ventana visible pueden cambiar el resultado. La prueba solo demuestra que una IP residencial por sí sola no basta. No demuestra que una plataforma concreta te bloquee siempre, y no debe leerse así.
3. Configuración: API de extracción o usuario y contraseña
1024Proxy ofrece dos maneras de obtener proxies: el modo API y el inicio de sesión con usuario y contraseña. En el menú del sitio, bajo «obtener proxies», el modo de usuario y contraseña cubre residencial rotativo, ancho de banda ilimitado, ISP estático y puertos ilimitados. El modo API cubre residencial rotativo y ancho de banda ilimitado. Los pasos de abajo siguen su centro de ayuda.
Cambiamos todos los ejemplos de código para que abran solo tu propio sitio objetivo. Estos proxies son para tu scraper, no para llamar a EveryInfra. La guía de protocolos lista HTTP, HTTPS y SOCKS5. Un proxy HTTPS usa el túnel CONNECT de RFC 9110: el proxy solo reenvía bytes cifrados y no puede leer el contenido de la página. Eso es bueno para la privacidad y explica por qué la factura del proxy solo cuenta bytes y no sabe nada de las páginas.
| Modo | Productos que cubre | Cómo se autentica | Cuándo conviene |
|---|---|---|---|
| API de extracción | Residencial rotativo, ancho de banda ilimitado | IP pública del servidor en la lista permitida | Tareas que piden muchas IP nuevas por lotes, con una IP de servidor fija |
| Usuario y contraseña | Residencial rotativo, ancho de banda ilimitado, ISP estático, puertos ilimitados | Usuario y contraseña en cada conexión, con opciones de ubicación y sesión en el usuario | Servidores con IP cambiante, sesiones fijas y segmentación por ciudad o ASN |
Opción 1: API de extracción (para cambiar de IP a menudo)
La guía de la API de 1024Proxy dice que el modo API obtiene IP en bloque mediante parámetros del enlace. Se usa en tareas que cambian de IP a menudo, como el scraping. El primer paso es añadir la IP pública de tu servidor a la lista de permitidas del panel. La guía de lista de IP permitidas indica que solo se aceptan IP públicas y que debes actualizar la lista si cambia tu IP de salida. Después, las llamadas a la API no necesitan usuario ni contraseña.
El segundo paso es comprar un plan de tráfico residencial rotativo. El tercero es fijar los parámetros en el modo API del panel. Defines el país o región region, el separador de líneas format (n es \n, rn es \r\n) y el tipo de sesión, fija o rotativa. La sesión fija añade un parámetro de duración time, que según la guía es de 10 o 15 minutos en modo API. También defines el formato de datos type (txt o json) y la cantidad num. Por último, copias el enlace generado en tu código.
El paso de la lista permitida tiene una trampa fácil de pasar por alto. Cuando un servidor de nube se reinicia, su IP pública puede cambiar. Si cambias de IP y no actualizas la lista, las llamadas de extracción fallan. Para una máquina que va a funcionar mucho tiempo, asigna una IP elástica fija.
Esto es un ejemplo de configuración. No tenemos cuenta en 1024Proxy, así que no pudimos ejecutar un enlace de extracción real. El 09-11-2026 a las 00:26, hora de Singapur, usamos un servicio simulado local para repetir la prueba del problema de división de líneas de nuestro primer borrador. Con format=rn, split('\n') dejó un \r al final de dos de tres direcciones, y eso rompe la URL del proxy. splitlines() dividió bien los dos formatos. El servicio simulado devolvía direcciones de documentación de RFC 5737, no proxies reales.
# Ejemplo de configuración: llamar en Python a un enlace de extracción del modo API de 1024Proxy
import requests

# El enlace generado en "modo API" del panel, con region, num, type, format, etc.
api_url = "YOUR_1024PROXY_API_LINK"

try:
    resp = requests.get(api_url, timeout=10)
    resp.raise_for_status()
    # Con type=txt hay un proxy por línea; splitlines() acepta \n y \r\n
    proxy_list = [line.strip() for line in resp.text.splitlines() if line.strip()]
    print("Proxy:", proxy_list[0] if proxy_list else "ninguno")
except Exception as e:
    print(f"No se pudo obtener un proxy: {e}")
En el modo de lista permitida, cada proxy extraído se usa como IP y puerto. El formato exacto está en el «ejemplo de respuesta» del panel, igual que los nombres de campo del formato json. No vimos una muestra real, así que aquí no inventamos nombres de campo.
Opción 2: usuario y contraseña (para conexiones largas y estables)
Para conexiones estables, como las de un ISP estático, usa el inicio de sesión con usuario y contraseña. La guía de inicio de sesión del ISP estático tiene tres pasos. Primero, en el panel, dentro de autenticación por usuario y gestión de cuentas, eliges ISP estático y añades una subcuenta, porque este producto no crea una por defecto. Segundo, filtras la lista de IP por país, región y ciudad, eliges el número de días y extraes. Tercero, eliges un formato de salida en la lista de uso.
La guía de inicio de sesión del residencial rotativo lista cuatro formatos. Uno de ellos es Hostname:Port:Username:Password. El ejemplo de nuestro primer borrador usaba el host gateway.1024proxy.com. El 07-11-2026 a las 19:53, hora de Singapur, dig +short no devolvió nada para ese host.
El ejemplo de la guía de ubicación de 1024Proxy usa us.1024proxy.io:3000. La guía de inicio de sesión dice que el panel da hosts de entrada en EE. UU. y Hong Kong. Por eso el código de abajo usa el marcador YOUR_PROXY_HOST; pon el valor que te dé el panel.
El modo de usuario y contraseña tiene otra función que nuestro primer borrador no explicaba: las opciones de ubicación y de sesión van dentro del nombre de usuario. La guía de ubicación añade -region-US-st-Louisiana-city-New Orleans tras el usuario, para afinar por país, estado y ciudad. También puedes añadir -asn-AS11272 para elegir un operador por su ASN.
La guía de sesiones añade después -sid-<nombre de sesión>-t-<minutos>. El mismo nombre de sesión conserva la misma IP durante ese tiempo; sin esa parte, cada petición recibe una IP nueva. La captura de abajo muestra el texto de la guía, y un recuadro verde azulado marca la línea de la sesión fija. Las páginas de ayuda no muestran la fecha de actualización de cada guía, así que comprueba el formato actual en el panel.
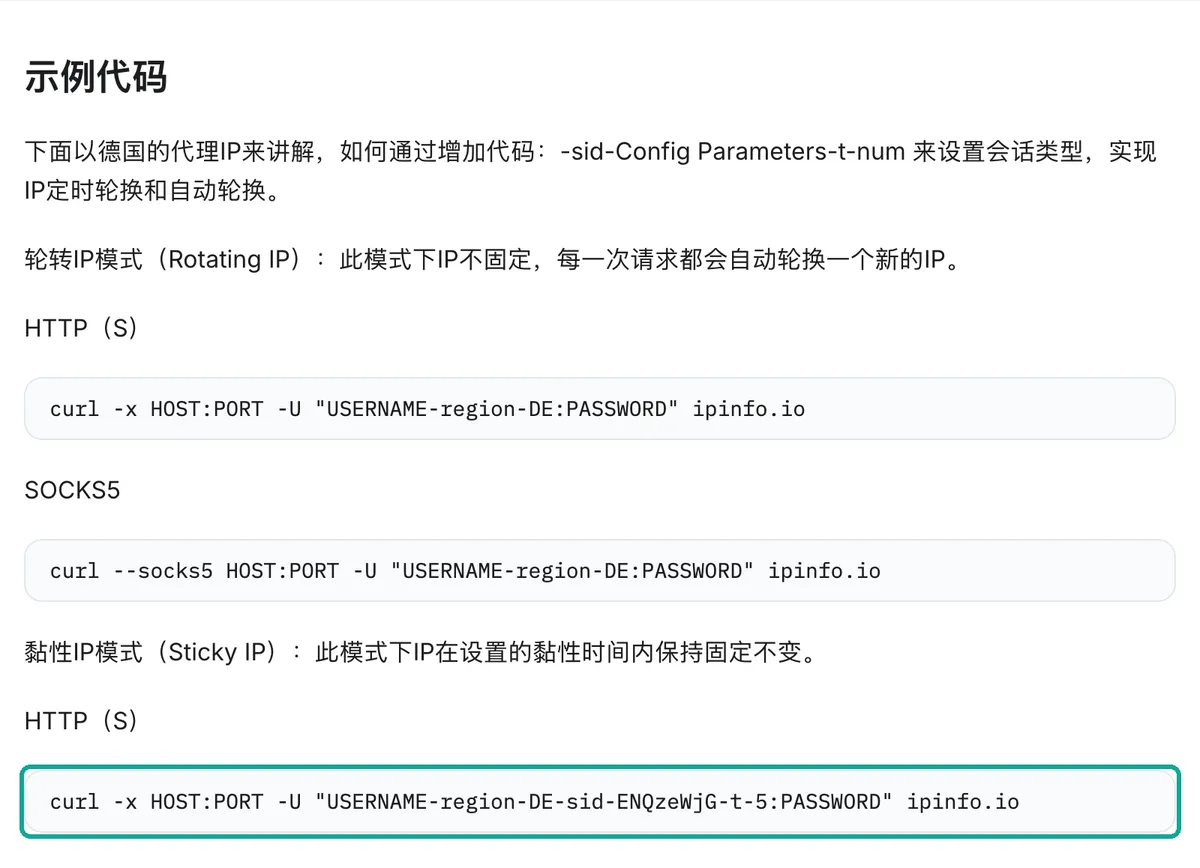
Con las opciones de ubicación en el usuario, el nombre puede llevar un espacio, como en la ciudad New Orleans. Y la contraseña del panel puede llevar caracteres como @ o :. Dentro de la URL de un proxy, esos caracteres necesitan codificación por porcentaje según la sección 3.2.1 de RFC 3986. Sin ella, la URL se corta en el sitio equivocado.
Lo probamos con un proxy simulado local el 09-11-2026, entre las 00:25 y las 00:26, hora de Singapur. El proxy simulado esperaba el usuario u-region-US-st-Louisiana-city-New Orleans-sid-ab12-t-5 y la contraseña p@ss:w0rd, con autenticación Basic de RFC 7617. La tabla muestra cada método y su resultado.
| Método (hora de Singapur, 09-11-2026) | Destino | Resultado |
|---|---|---|
| Python requests 2.34.2, credenciales sin codificar en la URL (00:25) | HTTP y HTTPS | Ambos 200, usuario completo en el registro del proxy |
requests, credenciales codificadas con quote(..., safe='') (00:25) | HTTP y HTTPS | Ambos 200 |
| requests, codificación correcta pero contraseña errónea (00:25) | HTTP | 407 Proxy Authentication Required |
| requests, codificación correcta pero contraseña errónea (00:25) | HTTPS | ProxyError, el registro del proxy muestra 407 |
curl 8.7.1, credenciales sin codificar en la URL de -x (00:26) | HTTPS | Falla, código de salida 5 (no pudo resolver el proxy) |
curl, credenciales en el parámetro -U (00:26) | HTTPS | 200 |
curl, credenciales codificadas en la URL de -x (00:26) | HTTPS | 200 |
requests acepta la forma sin codificar porque separa las credenciales en la última @ de la URL. curl no la acepta, y la misma cadena falla al instante. Para que el código funcione en cualquier herramienta, el ejemplo de abajo codifica las credenciales. El formato del diccionario proxies sigue la documentación de Requests.
# Ejemplo: usar en Python un proxy de 1024Proxy con usuario y contraseña para acceder a tu propio sitio objetivo
import requests
from urllib.parse import quote

# Sustituye por los datos del proxy de tu panel de 1024Proxy (host:puerto:usuario:contraseña)
proxy_host = "YOUR_PROXY_HOST"
proxy_port = "YOUR_PORT"
# Las opciones de ubicación y sesión van en el usuario: país-estado-ciudad-nombre de sesión-minutos
proxy_user = "YOUR_USERNAME-region-US-st-Louisiana-city-New Orleans-sid-shop01-t-30"
proxy_pass = "YOUR_PASSWORD"

auth = f"{quote(proxy_user, safe='')}:{quote(proxy_pass, safe='')}"
proxies = {
    "http": f"http://{auth}@{proxy_host}:{proxy_port}",
    "https": f"http://{auth}@{proxy_host}:{proxy_port}",
}

session = requests.Session()
session.trust_env = False  # usa solo los proxies de arriba, ignora HTTP(S)_PROXY de la máquina

try:
    # El destino es tu propia página: un sitio fuera del catálogo, un panel con inicio de sesión, etc.
    resp = session.get("YOUR_TARGET_URL", proxies=proxies, timeout=30)
    print(resp.status_code)
except requests.exceptions.ProxyError as e:
    print(f"Falló la conexión al proxy. Revisa host, puerto, usuario y contraseña: {e}")
except Exception as e:
    print(f"La petición falló: {e}")
Cuando veas un error, revisa primero los cuatro valores y la codificación, antes de culpar al sitio objetivo. Un 407 en un destino HTTP y un ProxyError en un destino HTTPS significan lo mismo: la petición se quedó en el proxy y nunca llegó al sitio objetivo.
4. Cuánto cuesta el tráfico del proxy, a partir de bytes medidos
El tráfico residencial rotativo se cobra por GB, así que el coste depende de cuántos bytes baja cada petición. Los bytes de la sección 2 permiten hacer la cuenta: el coste de tráfico por 1000 cargas es los bytes por carga, por 1000, por el precio por GB. Usamos 1 GB = 1 000 000 000 bytes. Con 2 elevado a 30 bytes, el coste sale un 6.9 % más bajo.
Los precios son los tres tramos del tráfico residencial rotativo de 1024Proxy el 09-11-2026. Para EveryInfra usamos el price_usd del catálogo por 1000. El tráfico del proxy es solo una parte del coste de tu propio scraper. Deja fuera servidores, análisis del HTML, almacenamiento y reintentos, así que la tabla muestra un mínimo, no un total.
| Plataforma | Navegador, página completa, por 1000 ($0.49–1.20/GB) | Solo HTML, por 1000 ($0.49–1.20/GB) | EveryInfra por 1000 (precio del catálogo) | Quién obtuvo datos esta vez |
|---|---|---|---|---|
| Búsqueda en TikTok | $2.52–6.18 | $0.047–0.115 | $0.556 (tiktok/search) | Solo la API |
| Búsqueda en YouTube | $2.08–5.08 | $0.161–0.394 | $0.556 (youtube/search) | Los tres métodos |
| Búsqueda en Reddit | $0.27–0.65 | $0.005–0.012 | $0.556 (reddit/search) | Solo la API |
| Búsqueda en Amazon | $0.038–0.094 | $0.112–0.275 | $2.236 (amazon/search) | curl y la API |
| Búsqueda en Shopee | $2.06–5.04 | $0.013–0.031 | $6.403 (shopee/search) | Solo la API |
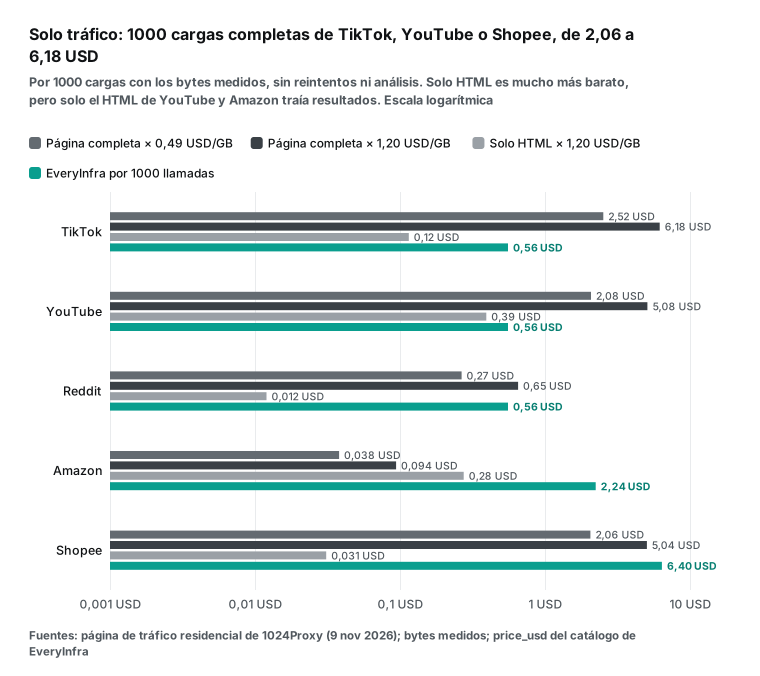
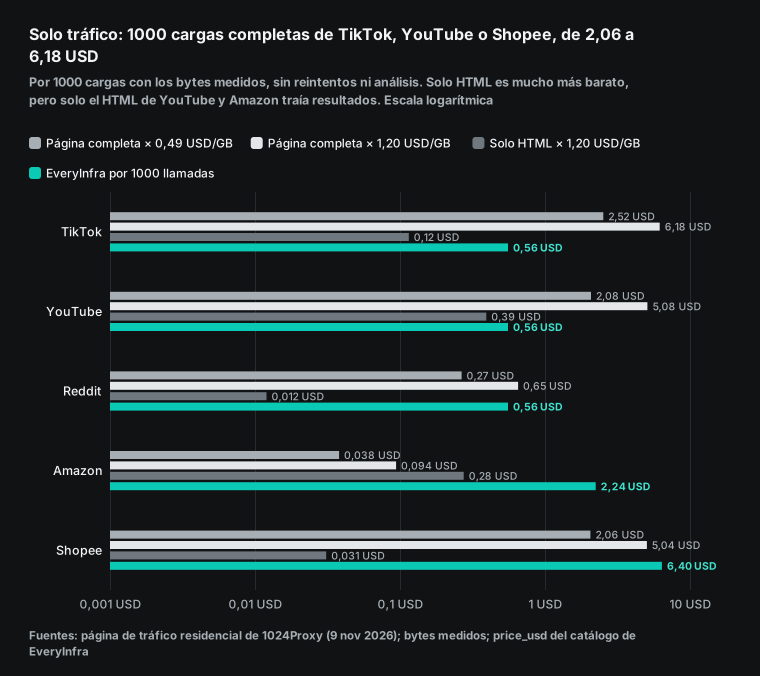
Esta tabla se lee en dos mitades. En la columna de navegador, las tres páginas cargadas por completo (TikTok, YouTube y Shopee) cuestan entre $2.06 y $6.18 por 1000 cargas solo en tráfico. Es de 4 a 11 veces lo que cuesta la búsqueda de EveryInfra, $0.556, y de las tres solo YouTube mostró resultados. Las cifras de Reddit y Amazon son bajas porque esas páginas se pararon en una verificación o en un 503: es tráfico barato, pero no trajo datos.
La columna de solo HTML es mucho más barata. YouTube cuesta solo entre $0.161 y $0.394 por 1000, y Amazon entre $0.112 y $0.275, un orden de magnitud por debajo de amazon/search de EveryInfra, a $2.236. Algunas páginas son como estas dos: el HTML trae los datos y la plataforma no bloquea las peticiones HTTP simples. Para esas páginas, tu propio scraper con un proxy residencial sí sale más barato en tráfico, y es el terreno donde un servicio como 1024Proxy es más fuerte.
Nuestro artículo anterior sobre cómo se cobra el tráfico de proxy midió 40 páginas de producto de Amazon y apunta en la misma dirección. Si tu caso se parece al comercio electrónico, ese artículo complementa bien a este.
Mucha gente piensa en otra forma de ahorrar tráfico: pedir al navegador que no baje imágenes, vídeo ni fuentes. Probamos ese nivel en la misma ronda y ahorró menos de lo esperado. La página de búsqueda de TikTok pasó de 5.15 MB a 4.30 MB, un ahorro de solo el 16.5 %. YouTube pasó de 4.24 MB a 3.86 MB, un 8.9 %. Reddit casi no cambió (de 542.9 KB a 539.7 KB), porque la página de verificación no tiene imágenes.
Shopee fue la que más ahorró: de 4.20 MB a 2.32 MB, un 44.7 %, y el número de peticiones bajó de 189 a 144. La mayor parte del peso de estas páginas son paquetes de JavaScript y datos de API, no imágenes. La tabla siguiente pasa esas cargas a coste con las tres tarifas de 1024Proxy. Las tres plataformas siguen por encima del doble de los $0.556 de la búsqueda de EveryInfra.
| Página de búsqueda | Página completa | Imágenes, multimedia y fuentes bloqueados | Ahorro | Carga bloqueada, por 1000 ($0.49–1.20/GB) |
|---|---|---|---|---|
| TikTok | 5.15 MB, 225 peticiones | 4.30 MB, 216 peticiones | 16.5 % | $2.11–5.16 |
| YouTube | 4.24 MB, 150 peticiones | 3.86 MB, 131 peticiones | 8.9 % | $1.89–4.63 |
| Reddit (verificación) | 542.9 KB, 7 peticiones | 539.7 KB, 7 peticiones | 0.6 % | $0.26–0.65 |
| Shopee Indonesia | 4.20 MB, 189 peticiones | 2.32 MB, 144 peticiones | 44.7 % | $1.14–2.79 |
Así que, en páginas que necesitan navegador, bloquear imágenes no es el ahorro principal. El ahorro de verdad está en saltarse el navegador y encontrar la petición que hay detrás de la página y que devuelve JSON. Si la encuentras, el coste baja al nivel de la columna de solo HTML. Si no la encuentras, la factura de tráfico se queda alta.
Los fallos también consumen tráfico. El gráfico siguiente añade la tasa de éxito. Tomemos la página de búsqueda de YouTube con solo HTML, a 328 703 bytes por carga. El coste de tráfico por cada 1000 páginas que muestran resultados es el coste por carga dividido entre la tasa de éxito. Con un 100 % de éxito, los tres tramos dan $0.161, $0.230 y $0.394, todos por debajo de la API.
Con el tramo más pequeño ($1.20/GB), el coste de tráfico supera los $0.556 de EveryInfra cuando el éxito baja del 71 %. Con el tramo de 1 TB, solo lo supera por debajo del 29 %. EveryInfra no cobra los fallos ni los resultados vacíos, así que su línea es plana.
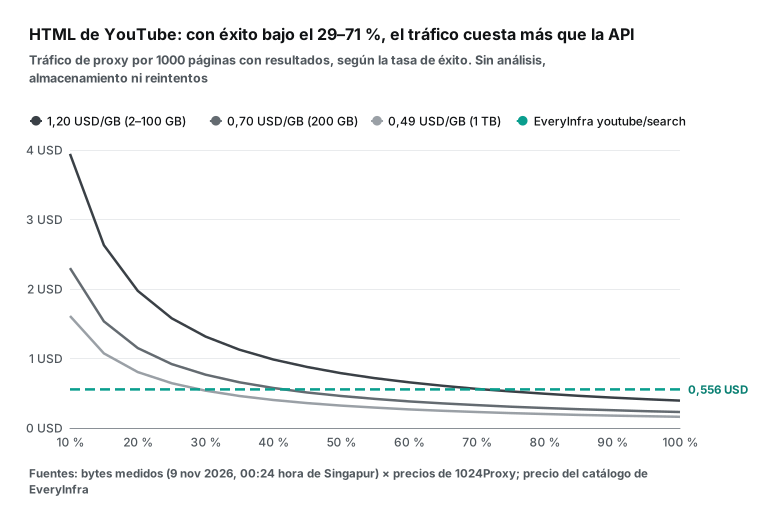
Esta curva traza una línea para tu propio scraper. Para una página dada, si mantienes la tasa de éxito por encima del punto de cruce, tu scraper gana en tráfico. Si te quedas por debajo, o si la página necesita navegador para mostrar datos, no compensa. Para medir la tasa de éxito, usa el 1 GB de prueba de 1024Proxy y lanza una o dos centenas de cargas contra tu página objetivo. Cuenta una carga como éxito solo cuando aparecen resultados en la página, no cuando recibes HTTP 200; la sección 2 explica por qué.
5. Una trampa en máquinas compartidas: HTTPS_PROXY mete en el proxy las llamadas a tu API de datos
Nuestro primer borrador encontró una trampa en la que es fácil caer. Supón que tu servidor define la variable HTTPS_PROXY para un scraper. Entonces Python requests también manda por defecto las llamadas a EveryInfra a través de ese proxy. Pagas tráfico residencial que no necesitabas y añades un salto más de latencia.
Esta vez probamos 14 configuraciones habituales de cliente el 09-11-2026 a las 00:25, hora de Singapur. Definimos HTTP_PROXY, HTTPS_PROXY y sus formas en minúsculas, todas apuntando a un proxy simulado local. Cada cliente llamó al endpoint gratuito del catálogo https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok&compact=1. Después miramos si el registro del proxy simulado mostraba un CONNECT a api.everyinfra.com:443. Las 14 peticiones devolvieron 200; la única diferencia fue si pasaron por el proxy.
| Cliente y configuración | Pasó por el proxy | Fuente |
|---|---|---|
| Python requests 2.34.2, por defecto | Sí | Documentación de Requests: variables de entorno |
requests, proxies={} | Sí | Un diccionario vacío no desactiva los proxies del entorno |
requests, Session.trust_env = False | No | Ignora las variables de entorno |
requests, con NO_PROXY=api.everyinfra.com | No | Excluye ese dominio |
| httpx 0.28.1, por defecto | Sí | Variables de entorno de httpx |
httpx, Client(trust_env=False) | No | Misma fuente |
| aiohttp 3.14.5, por defecto | No | Documentación de aiohttp: trust_env viene desactivado |
aiohttp, ClientSession(trust_env=True) | Sí | Misma fuente |
| Python urllib.request, por defecto | Sí | getproxies() lee las variables de entorno |
| curl 8.7.1, por defecto | Sí | Manual de curl: entorno |
curl, con --noproxy '*' | No | Misma fuente |
| fetch integrado de Node.js 26.11.1, por defecto | No | No lee las variables de entorno por defecto |
fetch de Node.js, con NODE_USE_ENV_PROXY=1 | Sí | Documentación de la línea de comandos de Node.js |
| Go 1.27.2 net/http, cliente por defecto | Sí | ProxyFromEnvironment |
De las 14 configuraciones, 8 pasaron por el proxy. La más sorprendente es proxies={}. Mucha gente cree que un diccionario vacío significa «sin proxy en esta llamada», pero en nuestra prueba siguió leyendo las variables de entorno. Cuando un scraper y una API de datos funcionan en la misma máquina, tienes tres opciones seguras.
La primera es dar al cliente de EveryInfra su propia sesión que ignore el entorno (trust_env=False en requests o httpx). La segunda es añadir NO_PROXY=api.everyinfra.com al entorno, que funciona para todos los clientes que respetan esa variable. La tercera es no definir variables de proxy globales y pasar el proxy solo en el código del scraper. La tercera es la más clara y la más difícil de romper cuando otra persona del equipo toma el relevo.
¿Por qué falla proxies={}? La causa está en el orden de mezcla de requests. Antes de cada petición, la sesión mezcla tus argumentos con el entorno. Cuando trust_env es verdadero, lee los proxies del entorno y rellena cada esquema que tu diccionario no tenga. Un diccionario vacío no tiene la clave https, así que el valor del entorno ocupa ese hueco.
Para desactivar el proxy de verdad, pasa {"http": None, "https": None} o desactiva trust_env. El 09-11-2026 a las 01:49, hora de Singapur, lo comprobamos con requests 2.34.2. Apuntamos HTTPS_PROXY a un puerto local sin ningún servicio. Con proxies={}, la petición lanzó ProxyError, así que sí intentó usar ese proxy. Con las dos claves en None, la misma petición al catálogo devolvió 200.
Antes de pasar a producción puedes revisar una máquina con una sola línea: requests.utils.get_environ_proxies("https://api.everyinfra.com"). Si devuelve un diccionario vacío, ese dominio no pasará por ningún proxy. La función integrada urllib.request.getproxies() lista todos los ajustes de proxy del entorno actual. Revisa con especial cuidado los contenedores y las tareas programadas, porque suelen heredar variables de entorno de una imagen o de la configuración del sistema, y quien escribió el código puede no saberlo.
6. Qué comprobar antes de comprar proxies residenciales
El negocio de los proxies residenciales ha tenido muchas noticias en los dos últimos meses, y afectan a quien compra. La tabla resume las principales. Después explicamos qué significan para un equipo que compra tráfico residencial para sus tareas de datos.
| Fecha | Fuente | Qué pasó |
|---|---|---|
| 02-07-2026 | Google Cloud Threat Intelligence | Acción contra una gran red de proxies residenciales; la red perdió millones de dispositivos |
| 02-11-2026 | Google Cloud Threat Intelligence | Desmantelamiento de la puerta trasera y botnet XCPE, más de 1.3 millones de cajas de TV Android |
| 04-11-2026 | Layer3 Intel | 236 salidas desde la red de la Casa Blanca (AS2650) a través de 28 servicios de proxy residencial |
| 05-11-2026 | Krebs on Security, The Register | Cobertura de prensa de las salidas desde la Casa Blanca |
| 09-11-2026 | Llamada a reddit/search | El hilo de r/technology sobre la noticia salió primero para «residential proxy», con 6550 votos |
El 02-11-2026, el equipo de inteligencia de amenazas de Google contó que había trabajado con otras empresas para desmantelar la puerta trasera y la botnet XCPE. Afectaba a más de 1.3 millones de cajas de TV Android que venían con malware de fábrica. Esos dispositivos se unían a redes de proxies residenciales como salidas sin que sus dueños lo supieran (blog de Google Cloud).
El 02-07-2026, Google ya había publicado una acción contra otra gran red de proxies residenciales. Decía que la red perdió millones de dispositivos y que muchas marcas de proxies residenciales revenden la misma red (blog de Google Cloud). El 04-11-2026, la empresa de seguridad Layer3 Intel publicó un informe de prueba (Layer3 Intel): entre el 5 de octubre y el 3 de noviembre salió 236 veces desde la red de la Casa Blanca (AS2650), con 6 direcciones y 28 servicios de proxy residencial.
El 05-11-2026, Krebs on Security y The Register cubrieron la historia. El 09-11-2026 llamamos a reddit/search con «residential proxy»: de las 10 filas, la primera era el hilo de r/technology sobre esta noticia, con 6550 votos positivos. Es decir, la noticia ya es de lo primero que ve cualquiera que busque el tema.
Para los equipos que compran proxies residenciales, estos hechos significan tres cosas. Primera: el origen de una IP de salida decide con quién compartes ese tráfico. Si una red incluye dispositivos infectados, la misma salida puede llevar relleno de credenciales y fraude publicitario, y la puntuación que el sitio da a esa IP también te afecta a ti. Segunda: los sitios y las empresas de seguridad detectan cada vez mejor las salidas de proxies residenciales. Bases como MaxMind ya tienen el campo is_residential_proxy, así que la idea de que «una IP residencial parece un usuario normal» pierde fuerza.
Tercera: un desmantelamiento puede quitar muchas salidas de una red de un día para otro, y una tarea que depende de una sola empresa de proxies necesita un plan alternativo. Así que, elijas la empresa que elijas, haz tres preguntas antes de comprar. ¿De dónde vienen las IP y si los dueños de los dispositivos aceptaron claramente compartir su ancho de banda? ¿La empresa verifica la identidad de sus clientes y qué usos prohíbe? ¿Qué reglas de reembolso y sustitución aplica tras un desmantelamiento o una caída?
| Pregunta al proveedor | Por qué importa | Qué guardar |
|---|---|---|
| ¿De dónde vienen las IP y hubo consentimiento claro de los dueños? | Las redes con dispositivos infectados comparten salida con fraude y ataques | La respuesta escrita del soporte |
| ¿Verifica la identidad de sus clientes y qué usos prohíbe? | Un proveedor sin controles atrae el tráfico que empeora la puntuación de sus IP | El enlace a los términos y la política de uso |
| ¿Qué pasa con reembolsos y sustituciones tras un desmantelamiento o una caída? | Una red puede perder muchas salidas de un día para otro | Las condiciones por escrito antes de pagar |
Los términos del servicio de 1024Proxy prohíben las actividades ilegales, el malware y causar daño a ordenadores o servicios de terceros. Sobre reembolsos, las preguntas frecuentes de su página de precios (guardada el 09-11-2026) dicen que los servicios de pago no se reembolsan salvo por problemas de calidad de la IP, y que algunos planes tienen prueba gratuita a través del soporte. Así que mide primero tu tasa de éxito con el tráfico de prueba; es más realista que comprar y pedir un reembolso. Una IP estática caducada vuelve al grupo y, tras un periodo de espera, otra persona puede tomarla y ya no podrás renovarla, así que renueva con antelación si la necesitas mucho tiempo. No encontramos en la web de 1024Proxy una página que explique cómo obtiene sus IP. Pregúntalo al soporte antes de comprar y guarda una copia de la respuesta. Es un paso normal con cualquier proveedor de este mercado, no una prueba especial para una empresa concreta.
7. Cuándo no necesitas tu propio proxy
Las secciones anteriores tratan de tu propio scraper y de tus propias salidas. A veces lo que necesitas son datos estructurados de una plataforma del catálogo de EveryInfra. Por ejemplo, la búsqueda de vídeos de TikTok y de YouTube, la búsqueda de publicaciones de Reddit, la búsqueda de productos de Amazon y los productos y tiendas de Shopee. En ese caso, llama a la API de datos directamente, sin proxy.
Tu petición va a api.everyinfra.com y EveryInfra se encarga del acceso a la plataforma objetivo. Las llamadas fallidas y los resultados vacíos no se cobran (sección de facturación de la documentación). El 09-11-2026 entre las 00:18 y las 00:19, hora de Singapur, llamamos desde Singapur a las mismas 5 plataformas de la sección 2. Abajo están el código exacto y los resultados.
import os
import requests

session = requests.Session()
session.trust_env = False  # ignora HTTP(S)_PROXY: esta llamada va directa, sin proxy

for platform, keyword in [("tiktok", "residential proxy"), ("youtube", "residential proxy"),
                          ("reddit", "residential proxy"), ("amazon", "usb c cable"),
                          ("shopee", "usb c cable")]:
    resp = session.post(
        "https://api.everyinfra.com/api/v1/social",
        headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        json={"platform": platform, "action": "search", "params": {"keyword": keyword}},
        timeout=120,
    )
    data = resp.json()
print(platform, resp.status_code, data.get("count"), data.get("billing", {}).get("charged_usd"))| Hora (09-11-2026, Singapur) | Capacidad | HTTP | Filas | Tamaño de respuesta | Duración | Cargo |
|---|---|---|---|---|---|---|
| 00:18:09 | tiktok/search, residential proxy | 200 | 10 | 24.9 KB | 3.7 s | $0.000556 |
| 00:18:13 | youtube/search, residential proxy | 200 | 10 | 26.8 KB | 7.5 s | $0.000556 |
| 00:18:20 | reddit/search, residential proxy | 200 | 10 | 10.9 KB | 4.7 s | $0.000556 |
| 00:18:30 | amazon/search, usb c cable | 200 | 10 | 24.3 KB | 38.2 s | $0.002236 |
| 00:19:09 | shopee/search, usb c cable | 200 | 20 (sitio de Indonesia, precios en IDR) | 11.7 KB | 9.9 s | $0.006403 |
| 00:19:18 | youtube/search, parámetro llamado query | 422 missing_param | — | — | 0.1 s | sin cargo |
| 00:19:19 | youtube/search, sin clave | 401 missing_key | — | — | 0.1 s | sin cargo |
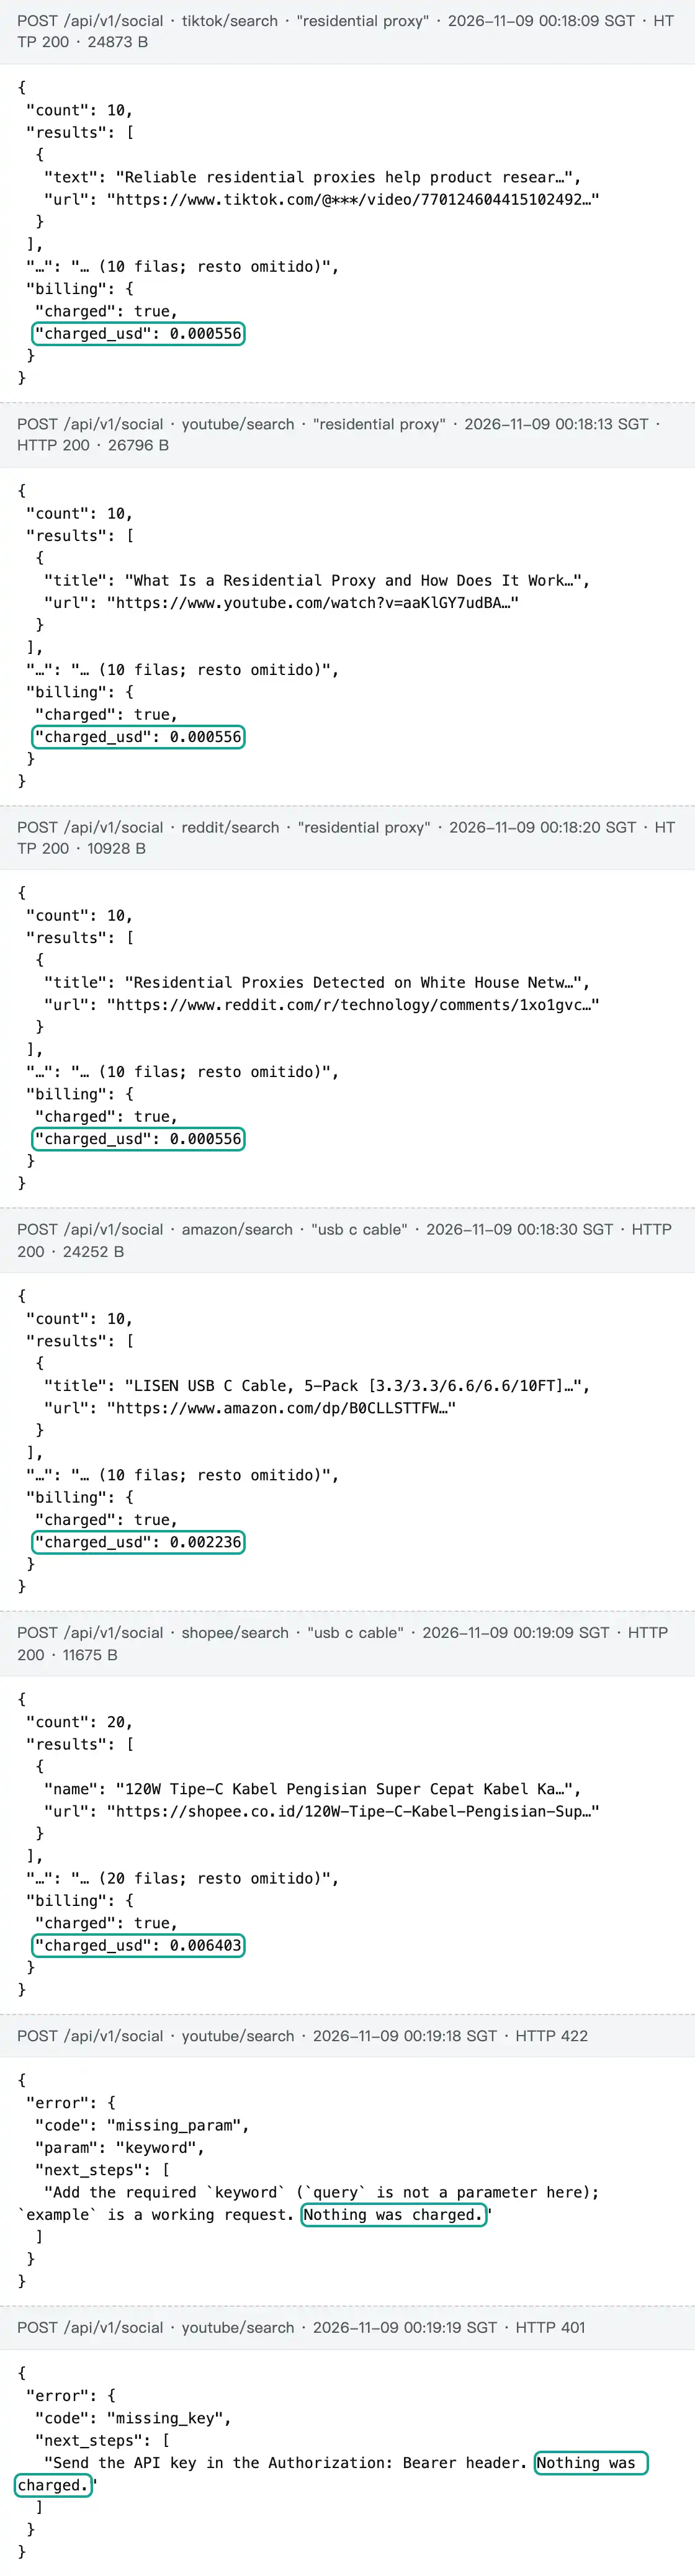
Las 5 llamadas correctas costaron $0.010307 en total, y los dos errores dijeron «Nothing was charged». Compáralo con la sección 2. Para la misma palabra clave, las páginas de búsqueda de TikTok, YouTube y Shopee que cargaron completas pesaban de 4.2 a 5.2 MB cada una. La API devuelve de 11 a 27 KB de JSON, entre 158 y 359 veces menos. Reddit se quedó en una verificación humana y Amazon en un 503: esas páginas pesaban poco, pero no dieron datos.
Cada fila de la API ocupa entre 0.6 y 2.7 KB y tiene nombres de campo fijos. Por ejemplo, youtube/search trae view_count, posted_at y search_rank, y reddit/search trae community, like_count y comment_count. Coinciden uno a uno con los response_fields del catálogo. Para un equipo que analiza precios o tendencias, esos campos fijos ahorran todo el trabajo de mantener selectores de HTML.
La llamada de Amazon tardó 38 segundos, la más lenta de las llamadas síncronas. El catálogo indica que cualquier capacidad acepta "mode":"async" en el cuerpo de la petición: recibes un job_id al momento y consultas el resultado después, algo que encaja con tareas por lotes. Busca primero en el catálogo gratuito los nombres de capacidad, los parámetros obligatorios y los precios, por ejemplo en las entradas de Amazon y Shopee. shopee/search usa por defecto el sitio de Indonesia, y el catálogo lista el parámetro opcional para otros sitios.
Si tu herramienta de IA admite MCP, no necesitas el bucle de arriba. El 09-11-2026 a las 00:29, hora de Singapur, mandamos tools/list a https://api.everyinfra.com/mcp sin clave. Devolvió 12 herramientas, y everyinfra_call_api es la entrada única para las capacidades de arriba. Listar herramientas no necesita clave; llamarlas sí. Añade la configuración de abajo a tu cliente con tu propia clave. Los pasos completos están en la página del servidor MCP remoto.
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Usa esta tabla para elegir un método para cada tarea:
| Tarea | Método | Motivo |
|---|---|---|
| Datos públicos de plataformas del catálogo (TikTok, YouTube, Reddit, Amazon, Shopee y otras) | Llamar directamente a la API de datos de EveryInfra, sin proxy | EveryInfra se encarga del acceso, devuelve JSON con campos con nombre y no cobra los fallos ni los resultados vacíos |
| Sitios fuera del catálogo, campos propios, datos en el HTML | Tu scraper con tráfico residencial rotativo de 1024Proxy (sesiones rotativas) | No hay una capacidad lista, y las páginas de solo HTML mantienen bajo el coste de tráfico |
| Páginas fuera del catálogo que necesitan navegador | Tu automatización de navegador con 1024Proxy, tras medir el éxito con el tráfico de prueba | Una página completa pesa 4–5 MB, y el coste sube rápido con una tasa de éxito baja |
| Trabajo con cuentas que piden inicio de sesión, paneles de tiendas | Navegador o script con ISP estático de 1024Proxy | Necesitas la misma IP durante mucho tiempo, y las sesiones fijas rotativas duran como máximo 120 minutos |
| Descargas grandes | Planes de tráfico ilimitado de 1024Proxy | Se cobran por puerto o por ancho de banda, no por GB |
Algunas páginas útiles: el inicio rápido muestra tu primera llamada. Los precios unitarios están en la página de precios y en la página de cada capacidad. Las páginas de la búsqueda por palabra clave de TikTok, la búsqueda de productos de Amazon y la de Shopee, que usa este artículo, listan los parámetros y los campos de respuesta.
Sobre tipos de proxy y una configuración de IPFoxy, consulta nuestro artículo anterior sobre por qué el scraping necesita IP de proxy. Sobre el coste real del tráfico de proxy, consulta cómo se cobra el tráfico de proxy. Para dar a tu propio scraper una salida residencial, revisa los planes en la web de 1024Proxy.
8. Resumen
La entrada de 1024Proxy sobre cómo obtiene la IA datos de internet, del 26-08-2026, propone un orden. Usa un conjunto de datos público cuando exista uno bueno. Usa una API cuando la fuente sea estable y tenga una buena interfaz. Recurre al scraping de páginas solo cuando lo anterior no basta. Las pruebas nuevas ponen cifras a ese orden. Las salidas de centro de datos casi siempre quedan marcadas en al menos una de dos bases, así que, si haces scraping por tu cuenta, una salida residencial es necesaria. Pero una salida residencial solo responde a «quién eres». No responde a «si pareces un navegador normal», y solo 1 de 5 páginas mostró resultados en el navegador.
En páginas que traen los datos en el HTML, tu propio scraper con un proxy residencial puede costar diez veces menos en tráfico que una API, pero solo con una tasa de éxito suficiente. En las cargas de solo HTML de la página de búsqueda de YouTube, la tasa de éxito debe superar cerca del 29 % en el tramo de 1 TB y cerca del 71 % en el tramo más pequeño para que el tráfico cueste menos que la API. Todas estas cifras dependen del momento y de las condiciones: otra plataforma, otra hora del día u otro país de salida pueden cambiarlas.
Lo más seguro es repetir estas pruebas con tus propias páginas objetivo y con las salidas que piensas comprar. Cuenta el éxito por los resultados que aparecen en la página. Calcula el coste por cada 1000 páginas con éxito a partir del precio del tráfico. Y después decide qué peticiones van a un proxy y cuáles a una API.
Preguntas frecuentes
¿Qué es un proxy residencial rotativo?
Es un proxy cuya salida está en líneas de banda ancha de hogares y que cambia de IP en cada petición, o al terminar una sesión de duración fija. En 1024Proxy, la sesión fija dura entre 1 y 120 minutos, y sin el parámetro de sesión cada petición recibe una IP nueva. Encaja con el scraping de páginas públicas, donde no necesitas mantener una cuenta iniciada. Para medir si te sirve, usa la tasa de éxito de la sección 4 y no el código HTTP.
¿Existe un proxy residencial gratis?
La página de inicio de 1024Proxy dice que puedes pedir al soporte 1 GB de tráfico de prueba, y lista además un plan inicial de $0.99 durante los 7 primeros días tras el registro (consultado el 09-11-2026). Con los bytes de la sección 4, 1 GB alcanza para unas 3000 cargas de solo HTML de la búsqueda de YouTube, o unas 230 cargas completas en navegador. Es suficiente para medir la tasa de éxito en tu página objetivo antes de pagar un plan.
¿Qué significa proxy residencial ilimitado?
«Proxy residencial ilimitado» suele referirse a planes que no cobran por GB. En 1024Proxy hay dos: el tráfico ilimitado por puerto, desde 2 puertos durante 3 días por $5.00, y el tráfico ilimitado por ancho de banda, desde 100 Mbps durante 30 días por $1,035. También la IP residencial rotativa por número de IP no limita el tráfico mientras la usas. Compensan cuando tus páginas son pesadas y el volumen es alto, porque una página completa de 4 a 5 MB dispara la factura por GB.
¿Proxy residencial estático o proxy ISP?
Un proxy residencial estático cubre la misma necesidad que un proxy ISP: una IP fija durante mucho tiempo. 1024Proxy lo llama «ISP estático», con periodos de 7, 30 o 90 días y precio por IP según el país. Nuestra muestra advierte que una dirección de operador no siempre es residencial en las bases de IP: solo 15 de 42 direcciones de banda ancha recibieron la etiqueta Residential. Cuando recibas la IP, consúltala en ip-api o proxycheck para ver si sale como Business o como centro de datos.
¿Proxy residencial o VPN?
Una VPN suele mandar todo el tráfico del dispositivo por un solo túnel, y su salida suele estar en un centro de datos: proxycheck etiquetó 38 de nuestras 40 direcciones de nube como VPN. Un proxy residencial reenvía tráfico petición a petición desde una salida doméstica, y puedes elegir país, ciudad o incluso ASN. Para recoger datos se usa un proxy y no una VPN, porque necesitas controlar la salida y la rotación.
¿Necesito un proxy para llamar a la API de datos de EveryInfra?
No; de hecho, conviene mantener el proxy lejos de ella. Tu petición va directa a api.everyinfra.com y EveryInfra se encarga del acceso a la plataforma objetivo. Si la máquina define HTTPS_PROXY para un scraper, sigue la tabla de la sección 5: desactiva las variables de entorno o añade NO_PROXY. Si no lo haces, estas llamadas también contarán como tráfico de proxy.
Referencias
- Página de inicio de 1024Proxy (precios de partida, tarjetas de funciones, ofertas de prueba, revisada 2026-11-09): https://1024proxy.com/?kwd=hyj-eyf
- 1024Proxy, página de precios de IP residencial rotativa (SOCKS5) (más de 195 países, precio por IP, consultada 2026-11-09): https://1024proxy.com/pricing/socks5
- 1024Proxy, página de tráfico residencial rotativo (precios por tramo, segmentación, sesiones, protocolos, consultada 2026-11-09): https://1024proxy.com/subject/residential
- 1024Proxy, página de ISP estático (precio por IP según país, 7/30/90 días, consultada 2026-11-09): https://1024proxy.com/subject/static
- 1024Proxy, página de tráfico ilimitado (tramos por puerto y por ancho de banda, consultada 2026-11-09): https://1024proxy.com/subject/unlimited
- 1024Proxy, quiénes somos: https://1024proxy.com/about-us
- 1024Proxy, términos del servicio: https://1024proxy.com/terms/
- Blog de 1024Proxy, guía de IP residenciales con doble ISP, 2026-10-29: https://1024proxy.com/blog/dual-isp-residential-ip-guide
- Blog de 1024Proxy, cómo comprobar la reputación de una IP tras comprarla, 2026-10-14: https://1024proxy.com/blog/how-to-check-ip-reputation/
- Blog de 1024Proxy, cómo obtiene la IA datos de internet, 2026-08-26: https://1024proxy.com/blog/ai-web-data-collection-methods/
- Centro de ayuda de 1024Proxy, visión general: https://help.1024proxy.com/1024/1024proxy
- Centro de ayuda de 1024Proxy, protocolos: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/network-protocol
- Centro de ayuda de 1024Proxy, API de tráfico residencial rotativo: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/api
- Centro de ayuda de 1024Proxy, lista de IP permitidas: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/ip-whitelist
- Centro de ayuda de 1024Proxy, control de sesiones: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/session-management
- Centro de ayuda de 1024Proxy, inicio de sesión del residencial rotativo: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/username-and-password-authentication
- Centro de ayuda de 1024Proxy, inicio de sesión del ISP estático: https://help.1024proxy.com/1024/1024proxy/long-term-static-isp/username-password-authentication
- Centro de ayuda de 1024Proxy, ajustes de ubicación: https://help.1024proxy.com/1024/1024proxy/dynamic-residential-traffic/location-configuration
- ARIN, Autonomous System Numbers: https://www.arin.net/resources/guide/asn/
- RFC 1930, Guidelines for creation, selection, and registration of an Autonomous System (AS), IETF, 1996: https://www.rfc-editor.org/rfc/rfc1930.html
- IPinfo, datos de la API IP ASN (campo
typedel ASN): https://ipinfo.io/developers/ip-asn-api-data - ip-api.com, documentación de la API JSON (campo
hosting): https://ip-api.com/docs/api:json - ip-api.com, documentación del servicio por lotes: https://ip-api.com/docs/api:batch
- proxycheck.io, documentación de la API (cuota gratuita): https://proxycheck.io/api/
- MaxMind, campos de la base GeoIP Anonymous IP: https://dev.maxmind.com/geoip/docs/databases/anonymous-ip/
- AWS, ip-ranges.json (generado 2026-11-08): https://ip-ranges.amazonaws.com/ip-ranges.json
- Documentación de AWS, AWS IP address ranges: https://docs.aws.amazon.com/vpc/latest/userguide/aws-ip-ranges.html
- Documentación de AWS, How AWS Wavelength works: https://docs.aws.amazon.com/wavelength/latest/developerguide/how-wavelengths-work.html
- Google Cloud, cloud.json (generado 2026-11-08): https://www.gstatic.com/ipranges/cloud.json
- Documentación de Google Cloud, preguntas frecuentes de Compute Engine (rangos de IP): https://cloud.google.com/compute/docs/faq#find_ip_range
- Oracle Cloud, public_ip_ranges.json (actualizado 2026-10-28): https://docs.oracle.com/en-us/iaas/tools/public_ip_ranges.json
- Documentación de Oracle Cloud, IP Address Ranges: https://docs.oracle.com/en-us/iaas/Content/General/Concepts/addressranges.htm
- DigitalOcean, archivo de geolocalización de IP: https://digitalocean.com/geo/google.csv
- Akamai/Linode, geofeed: https://geoip.linode.com/
- RFC 8805, A Format for Self-Published IP Geolocation Feeds, IETF, 2020: https://www.rfc-editor.org/rfc/rfc8805.html
- Documentación de RIPEstat, announced-prefixes: https://stat.ripe.net/docs/data-api/api-endpoints/announced-prefixes
- Documentación de Cloudflare WAF, IP Access rules: https://developers.cloudflare.com/waf/tools/ip-access-rules/
- Lenguaje de reglas de Cloudflare, campo ip.src.asnum: https://developers.cloudflare.com/ruleset-engine/rules-language/fields/reference/ip.src.asnum/
- Documentación de Cloudflare, Bot score: https://developers.cloudflare.com/bots/concepts/bot-score/
- Documentación de AWS WAF, ASN match rule statement: https://docs.aws.amazon.com/waf/latest/developerguide/waf-rule-statement-type-asn-match.html
- Documentación de Google Cloud Armor, referencia del lenguaje de reglas (origin.asn): https://cloud.google.com/armor/docs/rules-language-reference
- RFC 9110, HTTP Semantics, 403 Forbidden, IETF, 2022: https://www.rfc-editor.org/rfc/rfc9110.html#name-403-forbidden
- RFC 9110, HTTP Semantics, 407 Proxy Authentication Required, IETF, 2022: https://www.rfc-editor.org/rfc/rfc9110.html#name-407-proxy-authentication-re
- RFC 9110, HTTP Semantics, CONNECT, IETF, 2022: https://www.rfc-editor.org/rfc/rfc9110.html#name-connect
- RFC 6585, sección 4, 429 Too Many Requests, IETF, 2012: https://www.rfc-editor.org/rfc/rfc6585.html#section-4
- RFC 5737, IPv4 Address Blocks Reserved for Documentation, IETF, 2010: https://www.rfc-editor.org/rfc/rfc5737.html
- RFC 3986, sección 3.2.1, URI User Information, IETF, 2005: https://www.rfc-editor.org/rfc/rfc3986.html#section-3.2.1
- RFC 7617, The 'Basic' HTTP Authentication Scheme, IETF, 2015: https://www.rfc-editor.org/rfc/rfc7617.html
- Chrome DevTools Protocol, dominio Network (encodedDataLength): https://chromedevtools.github.io/devtools-protocol/tot/Network/
- Documentación de Requests, Proxies: https://requests.readthedocs.io/en/latest/user/advanced/#proxies
- Documentación de httpx, Environment Variables: https://www.python-httpx.org/environment_variables/
- Documentación de aiohttp, Proxy support: https://docs.aiohttp.org/en/stable/client_advanced.html#proxy-support
- Documentación de Python, urllib.request.getproxies: https://docs.python.org/3/library/urllib.request.html#urllib.request.getproxies
- Manual de curl (variables de entorno): https://curl.se/docs/manpage.html
- Documentación de Node.js, NODE_USE_ENV_PROXY: https://nodejs.org/api/cli.html#node_use_env_proxy1
- Documentación de Go, net/http ProxyFromEnvironment: https://pkg.go.dev/net/http#ProxyFromEnvironment
- Blog de inteligencia de amenazas de Google Cloud, Shutting the Door on the XCPE Botnet, 2026-11-02: https://cloud.google.com/blog/topics/threat-intelligence/shutting-the-door-on-the-xcpe-botnet
- Blog de inteligencia de amenazas de Google Cloud, Google's Continued Disruption of Malicious Residential Proxy Networks, 2026-07-02: https://cloud.google.com/blog/topics/threat-intelligence/google-continued-disruption-residential-proxy-networks
- Layer3 Intel, Residential Proxies Detected on White House Network, 2026-11-04: https://layer3intel.com/blog/residential-proxies-white-house-network
- Krebs on Security, Want to Rent an Internet Address at the White House?, 2026-11-05: https://krebsonsecurity.com/2026/11/want-to-rent-an-internet-address-at-the-white-house/
- The Register, The White House is apparently a popular residential proxy exit spot, 2026-11-05: https://www.theregister.com/security/2026/11/05/the-white-house-is-apparently-a-popular-residential-proxy-exit-spot/5307969
- Reddit r/proxies, I need a static residential proxy, 2026-10-08: https://www.reddit.com/r/proxies/comments/1x0xj70/i_need_a_static_residential_proxy/
- Catálogo de capacidades de EveryInfra (todas las plataformas, versión compacta, consultado 2026-11-09 00:17 hora de Singapur): https://api.everyinfra.com/api/v1/social/catalog?compact=1
- Catálogo de capacidades de EveryInfra (TikTok): https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- Catálogo de capacidades de EveryInfra (YouTube): https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- Catálogo de capacidades de EveryInfra (Reddit): https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- Catálogo de capacidades de EveryInfra (Amazon): https://api.everyinfra.com/api/v1/social/catalog?platform=amazon
- Catálogo de capacidades de EveryInfra (Shopee): https://api.everyinfra.com/api/v1/social/catalog?platform=shopee
Referencia BL-107