¿Cuánto tráfico proxy usa una página de Amazon?
Medimos los bytes de 40 solicitudes a páginas de producto de Amazon y de 6 cargas completas en navegador, les pusimos el precio por GB de IPFoxy y comparamos el costo de 1.000 páginas con el de una API de datos. El resultado depende de cómo descargas, qué plan compras y con qué frecuencia aciertas.
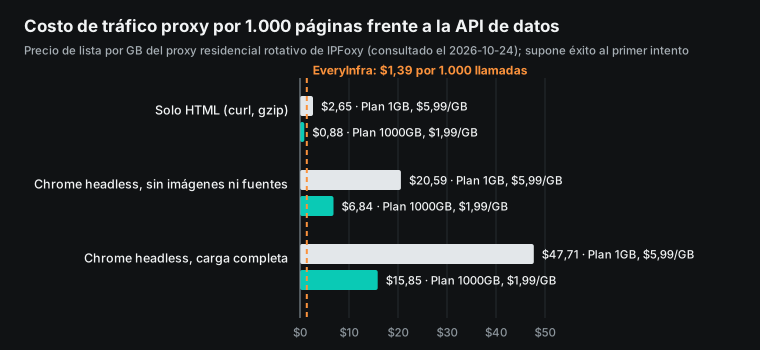
Los proxies residenciales rotativos se cobran por GB. Por eso, los bytes que descarga una página fijan lo que cuesta esa página en tráfico proxy. El 24 de octubre de 2026, de 18:30 a 18:41 (hora de Singapur), medimos 40 solicitudes a páginas de producto de Amazon Estados Unidos y 6 cargas completas en navegador. Con solo el HTML, la mediana fue de 0,44 MB por página. Con una carga completa en navegador headless, la mediana fue de 7,96 MB: 18 veces más. Con los precios de lista de los proxies residenciales rotativos de IPFoxy, el tráfico de 1.000 páginas cuesta entre $0,88 y $47,71. La misma página a través de una API de datos cuesta $1,39 por cada 1.000 llamadas.
Este artículo pone en la misma escala el costo del tráfico proxy y el costo de una API de datos. Cuál sale más barato depende de cómo descargas, qué plan compras y con qué frecuencia aciertan tus solicitudes. Cada cifra lleva su fuente y los datos originales se pueden descargar.
Por qué medir los bytes primero
IPFoxy vende sus proxies residenciales rotativos por tráfico. El 24 de octubre, su página de precios mostraba seis planes: 1GB, 10GB, 50GB, 100GB, 500GB y 1000GB. El precio por GB baja de $5,99 a $1,99, y la vigencia va de 30 a 180 días. Por encima de 1000GB hay un plan a medida «desde $0,60/GB» (precios del proxy residencial rotativo de IPFoxy). Su pool cubre más de 200 países y regiones (ubicaciones de IPFoxy). En un producto que se cobra por tráfico, costo = bytes descargados × precio. El precio está en la web. Los bytes hay que medirlos.
No hay una única respuesta a «cuánto pesa una página». El Web Almanac 2025 de HTTP Archive define el peso de una página como todos los bytes que el navegador descarga para mostrarla. También indica que las imágenes son lo que más pesa (Web Almanac 2025: Page Weight). Pero un script de recolección de datos no siempre baja imágenes. Entre descargar solo el HTML y dejar que el navegador cargue la página entera hay un orden de magnitud. Por eso medimos tres métodos habituales.
Criterios escritos antes de medir
Antes de medir, fijamos tres reglas:
- La unidad de comparación es «los datos de una página de producto». Se cumple si cada método obtiene al menos 3 páginas de producto reales (el título es el nombre del producto, no una página de bloqueo).
- Contamos los bytes transferidos, no el tamaño descomprimido, porque el proxy cobra el tráfico transferido. Para el HTML sumamos
size_downloadysize_headerde curl (manual de curl, --write-out; Everything curl: variables de write-out). Para el navegador sumamosNetwork.loadingFinished.encodedDataLengthde cada solicitud, del Chrome DevTools Protocol (dominio Network de CDP). - Usamos 1 GB = 10⁹ bytes (prefijos binarios según NIST). Si un proveedor cuenta 1 GB como 2³⁰ bytes, cada costo de abajo baja un 7 % aproximadamente.
Resultado: los tres métodos cumplen la regla 1 (16 páginas HTML y 3 páginas por cada método de navegador). Las reglas 2 y 3 se aplican en todo lo que sigue.
Prueba 1: bytes por método
Medimos desde una conexión doméstica de banda ancha en Singapur, sin proxy. Los productos salen de una sola búsqueda: la API de búsqueda por palabra clave de Amazon con air fryer, primeros 20 ASIN (18:30, 31,6 segundos, cobro de $0,001389).
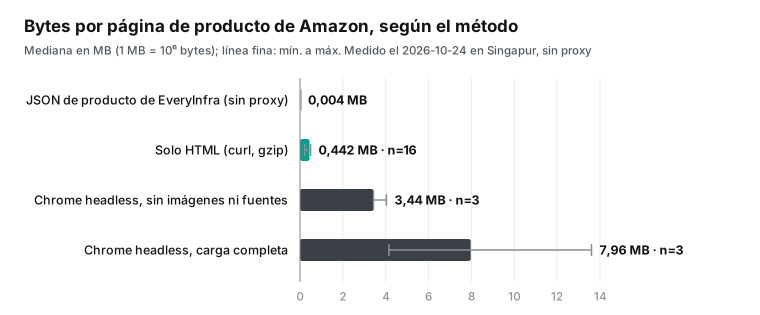
Solo HTML. Pedimos /dp/<ASIN> con curl, cabeceras normales de navegador y Accept-Encoding: gzip, deflate, br (MDN: Accept-Encoding). Dejamos 4 segundos entre solicitudes e hicimos dos rondas de 20. Amazon respondió con gzip (RFC 1952), no con Brotli (RFC 7932). En las 16 páginas de producto reales, la mediana transferida fue de 441.688 bytes, con un mínimo de 213.178 y un máximo de 496.482. Descomprimidas, las páginas ocupaban de 1,08 a 2,68 MB.
Navegador headless, carga completa. Abrimos 3 páginas de producto con el nuevo modo headless de Chrome (documentación de Chrome headless), sin caché, y esperamos 15 segundos por página. Las tres páginas usaron 13,60, 4,15 y 7,96 MB, con entre 224 y 270 solicitudes cada una. En la primera, las imágenes sumaron 7,03 MB (52 %) y los scripts 3,02 MB. En DevTools, «tamaño transferido» y «tamaño del recurso» son cifras distintas; aquí usamos la primera (referencia del panel Network de Chrome DevTools).
Navegador headless, sin imágenes ni fuentes. Muchos scripts bloquean las imágenes; Playwright y Puppeteer explican cómo hacerlo (Playwright: Network; Puppeteer: interceptación de solicitudes). Con imágenes y fuentes bloqueadas mediante Network.setBlockedURLs de CDP, las tres páginas usaron 4,03, 3,44 y 3,43 MB. Casi todo lo demás eran scripts: unos 3,0 MB, el 87 %.
| Método | Muestra | Mediana transferida por página | Rango |
|---|---|---|---|
| Solo HTML (curl, gzip) | 16 páginas | 0,442 MB | 0,213–0,496 MB |
| Chrome headless, sin imágenes ni fuentes | 3 páginas | 3,44 MB | 3,43–4,03 MB |
| Chrome headless, carga completa | 3 páginas | 7,96 MB | 4,15–13,60 MB |
| JSON de producto de EveryInfra (sin proxy) | 1 llamada | 0,004 MB | — |
Las dos filas de navegador tienen solo 3 páginas. En dos páginas, CDP registró el documento principal con 0 bytes. Por eso esas dos filas son cotas inferiores, no valores exactos.
Prueba 2: sin proxy, ¿qué tienda ves?
Las mismas solicitudes muestran otra cosa: la IP de salida decide qué muestra la página.
- Ronda 1, sin cookies: 19 de 20 páginas de producto devolvieron HTTP 200, pero el contenido era una página intermedia de 3.781 bytes con el texto «Click the button below to continue shopping». Solo 1 fue una página de producto real. Las 3 páginas de búsqueda (
/s?k=) devolvieron 503. - La ronda 2 empezó con una visita a la portada para obtener cookies. Las 5 primeras siguieron siendo páginas intermedias. Las 15 siguientes fueron páginas reales. En total, 16 de 40 solicitudes trajeron una página real: el 40 %.
- Las 16 páginas reales mostraban Singapur como lugar de entrega. En 2 de ellas, el producto no se podía enviar a esa ubicación.
- En el navegador,
amazon.com/s?k=air+fryerterminó en una página titulada «Amazon.sg : air fryer», la tienda de Singapur.
Así que, para ver precios, entrega y resultados de búsqueda como los ve un comprador de Estados Unidos, la solicitud tiene que salir de una IP de Estados Unidos. Para eso sirven los proxies residenciales. La página de soluciones de IPFoxy cita el comercio electrónico, la recolección de datos y la verificación de anuncios entre sus usos principales (soluciones de IPFoxy). Su blog también tiene una guía sobre recolección de datos de e-commerce (IPFoxy: guía de recolección de datos de e-commerce). Las páginas de bloqueo son pequeñas (4.206 bytes con cabeceras). Cuestan solicitudes y tiempo, no tráfico.
Las cuentas de 1.000 páginas de producto
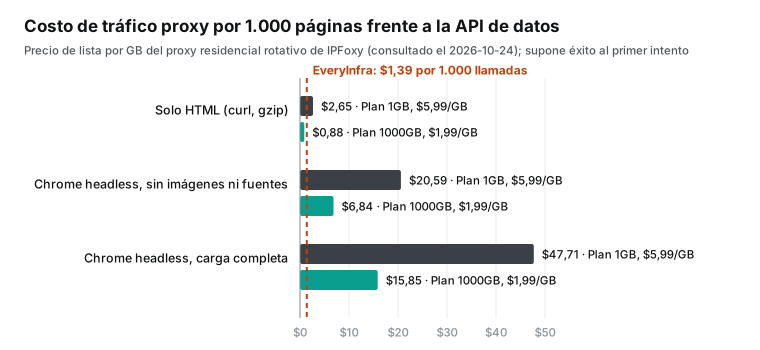
Multiplicamos las medianas de la prueba 1 por 1.000 y por el precio por GB de cada plan de IPFoxy. Suponemos que cada página sale bien al primer intento. No contamos reintentos, el saludo del túnel del proxy ni los bytes de subida.
| Método | Plan 1GB $5,99/GB | Plan 10GB $4,99/GB | Plan 100GB $2,99/GB | Plan 1000GB $1,99/GB |
|---|---|---|---|---|
| Solo HTML | $2,65 | $2,20 | $1,32 | $0,88 |
| Navegador, sin imágenes ni fuentes | $20,59 | $17,15 | $10,28 | $6,84 |
| Navegador, carga completa | $47,71 | $39,74 | $23,81 | $15,85 |
La API de detalle de producto de Amazon devuelve la misma página por $0,001389 la llamada, es decir, $1,39 por cada 1.000 llamadas (catálogo de capacidades, consultado a las 18:29). Las llamadas fallidas o vacías no se cobran. A las 18:37 la llamamos una vez para B0CYJDVT31: devolvió 20 campos en 9,1 segundos, con un cuerpo JSON de 3.569 bytes. Si solo necesitas campos de listado (precio, valoración, número de valoraciones, marca), una búsqueda devuelve 20 productos, así que 1.000 productos cuestan unos $0,07.
La tasa de éxito que necesitas
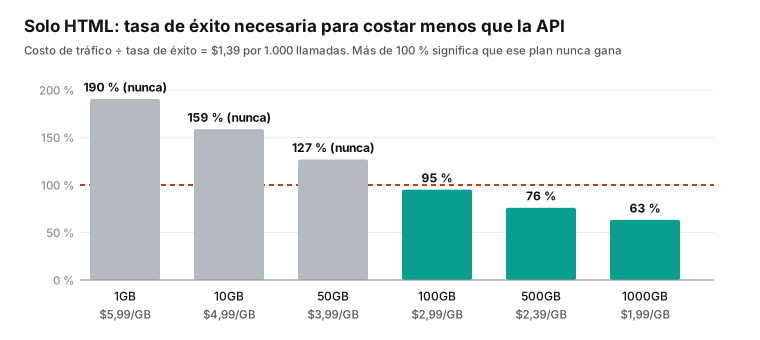
La tabla supone un 100 % de éxito. En la práctica hay fallos, y cada fallo exige reintentar. Si la tasa de éxito es s, el costo de tráfico por página buena es aproximadamente «costo de tráfico ÷ s» (una página fallida pesa unos 4 KB, así que la ignoramos). Con solo HTML, para costar menos que la API de datos necesitas como mínimo:
- planes de 1GB, 10GB y 50GB: 190 %, 159 % y 127 %. Esos planes nunca salen más baratos.
- plan de 100GB: 95 %.
- plan de 500GB: 76 %.
- plan de 1000GB: 63 %.
Sin proxy, desde banda ancha en Singapur, obtuvimos páginas reales en el 40 % de las solicitudes. Con IP residenciales de Estados Unidos la tasa será otra. No teníamos cuenta de IPFoxy, así que no la medimos y no damos una cifra. Usa tu propia tasa de éxito en la fórmula de arriba.
Estas cuentas no incluyen el trabajo de las personas. Si recolectas páginas por tu cuenta, tienes que escribir parsers, cambiar el código cuando cambia el diseño de la página y gestionar páginas de bloqueo y reintentos. Una API de datos devuelve nombres de campo fijos, así que ese trabajo desaparece. Pero una API de datos solo cubre las plataformas y los campos de su catálogo. Para el resto sigues recolectando por tu cuenta.
Quién hace qué: IPFoxy o una API de datos
Con estas cifras, nuestra recomendación es:
- Usa IPFoxy para páginas que hay que abrir como usuario de un país concreto. Por ejemplo: entrega y precio final para un comprador de Estados Unidos, tu propia cuenta de vendedor o los anuncios locales. Úsalo también para sitios que no están en el catálogo de una API de datos y para páginas que necesitan un navegador real. Las IP residenciales estáticas sirven para asociar una tienda o una cuenta durante mucho tiempo; el precio de lista empieza en $7,99 al mes (precios del proxy residencial estático de IPFoxy).
- Usa una API de datos para plataformas y campos que ya están en el catálogo. Encaja sobre todo en trabajos grandes con campos fijos que terminan en una hoja de cálculo o una base de datos. Llamar a la API de datos no necesita proxy: pasar por un proxy solo añade tráfico proxy.
Para hacer las dos cosas en un mismo script, consulta la sección «Uso con proxies de IPFoxy» de nuestra documentación. El ejemplo en Python usa requests 2.34.2 (PyPI: requests). Tu propia solicitud sale por el proxy. La solicitud a EveryInfra va directa, con trust_env = False (Requests, uso avanzado: proxies; API de Requests: Session.trust_env). La dirección del proxy tiene la forma usuario:contraseña@host:puerto, y el centro de ayuda de IPFoxy explica la configuración en Python (IPFoxy: proxy rotativo con Python). Su ejemplo usa la biblioteca estándar urllib.request, que por defecto también lee los proxies de las variables de entorno (documentación de urllib.request). En Scrapy, pon proxy en el meta de la solicitud (Scrapy: HttpProxyMiddleware).
No teníamos cuenta de IPFoxy, así que probamos la parte del proxy con un proxy simulado en local. El simulador abre un túnel con el método HTTP CONNECT (RFC 9110, sección 9.3.6; MDN: CONNECT). Además comprueba las credenciales Basic de la cabecera Proxy-Authorization (RFC 7617; MDN: Proxy-Authorization). Con la contraseña correcta, el ejemplo llegó a ipinfo.io a través del simulador y después obtuvo los datos de producto de EveryInfra. Con una contraseña incorrecta, el simulador devolvió 407 (MDN: 407) y el ejemplo se detuvo antes de llamar a EveryInfra, sin ningún cobro. También pusimos HTTPS_PROXY apuntando al simulador. Su registro solo mostró la solicitud a ipinfo.io: la de EveryInfra no pasó por él.
Cómo citar estos datos
- Datos originales: amazon-page-weight-2026-10-24.csv (en GitHub: repositorio de ejemplos de EveryInfra, amazon-page-weight-2026-10-24.csv; copia en este sitio:
https://everyinfra.com/articles/proxy-traffic-cost-amazon-product-pages/amazon-page-weight-2026-10-24.csv), 51 filas. Cada fila es una solicitud o una carga completa. Las columnas son tipo de página, ASIN, método, hora, estado HTTP, si es página real, bytes transferidos, número de solicitudes y una nota. - Momento de la lectura: 24 de octubre de 2026, de 18:30 a 18:41, hora de Singapur (UTC+8). Los precios de IPFoxy se consultaron el mismo día.
- Cómo comprobarlo: el HTML con curl 8.7.1 y
--write-out '%{size_download} %{size_header}'; el navegador con Chrome 155 en modo headless y CDP, desde un script de Node.js 26 que usa elWebSocketintegrado (objetos globales de Node.js). El script y el que genera los gráficos están en nuestra carpeta de ejemplos de GitHub, enlazada desde /docs#with-proxy. - Cita sugerida: EveryInfra, «¿Cuánto tráfico proxy usa una página de Amazon?», 24-10-2026, https://everyinfra.com/es/blog/proxy-traffic-cost-amazon-product-pages (datos consultados el 24-10-2026, de 18:30 a 18:41 SGT).
Cuándo no se cumplen estos resultados
- La muestra es pequeña: 16 páginas HTML reales y 3 páginas por cada método de navegador, todas de una sola categoría (freidoras de aire). Las páginas más largas (más reseñas, más variantes) pesan más. El informe mensual de HTTP Archive muestra que el peso de las páginas cambia con el tiempo (HTTP Archive: informe Page Weight). Conviene repetir la medición dentro de un año.
- Sin proxy en el camino: con proxy, las cabeceras, el saludo del túnel y las redirecciones añaden algunos bytes, y la tasa de éxito cambia.
- Precios de lista: la web de IPFoxy muestra descuentos por registro (del 17 % al 23 % a partir del plan de 10GB). No los aplicamos. Consulta el precio vigente en la web de IPFoxy.
- El cumplimiento normativo queda fuera de este artículo: solo medimos bytes. El robots.txt de Amazon no bloquea las páginas de producto
/dp/para rastreadores genéricos. Pero sí bloquea todo el sitio para varios rastreadores con nombre, como Scrapy y GPTBot (robots.txt de Amazon). Sus condiciones de uso (actualizadas el 14-08-2026) limitan la minería de datos y los robots en el apartado «License and Access» (Amazon Conditions of Use). Lee las condiciones de un sitio antes de recolectar datos de él.
Costo de la prueba: 3 llamadas a EveryInfra, $0,004167 en total (1 búsqueda y 2 detalles de producto). Otras 3 solicitudes devolvieron 429 por el límite de frecuencia de la misma clave y no se cobraron. IPFoxy es socio nuestro. Los enlaces a IPFoxy de este artículo no llevan parámetros de referido. Por eso no los marcamos como enlaces de referido (reglas de Google para enlaces pagados y de referido: Califica tus enlaces salientes). Nuestra página sobre este socio es IPFoxy, proxies globales. Las cifras vienen de las dos webs el día en que las consultamos.
Para seguir leyendo
- Plataforma: API de scraping de Amazon
- Capacidades: API de detalle de producto de Amazon, API de búsqueda por palabra clave de Amazon
- Documentación: Uso con proxies de IPFoxy, Precios
Referencias
- Precios del proxy residencial rotativo, IPFoxy, consultado el 24-10-2026. https://www.ipfoxy.com/pricing/rotating/
- Precios del proxy residencial estático, IPFoxy, consultado el 24-10-2026. https://www.ipfoxy.net/pricing/residential/
- How to use Rotating proxy through Python?, centro de ayuda de IPFoxy, 18-11-2025. https://www.ipfoxy.com/help/docs/bn3BDn
- Soluciones, IPFoxy, consultado el 24-10-2026. https://www.ipfoxy.net/solution/
- Ubicaciones del proxy, IPFoxy, consultado el 24-10-2026. https://www.ipfoxy.net/country/
- Guía de recolección de datos de e-commerce (en chino), blog de IPFoxy, consultado el 24-10-2026. https://www.ipfoxy.net/blog/use-cases/6929
- Dominio Network (loadingFinished, setBlockedURLs), Chrome DevTools Protocol, consultado el 24-10-2026. https://chromedevtools.github.io/devtools-protocol/tot/Network/
- Chrome Headless mode, Chrome for Developers, consultado el 24-10-2026. https://developer.chrome.com/docs/chromium/headless
- Network features reference, Chrome for Developers, consultado el 24-10-2026. https://developer.chrome.com/docs/devtools/network/reference
- Manual de curl (--write-out), proyecto curl, consultado el 24-10-2026. https://curl.se/docs/manpage.html
- Write out, Everything curl, consultado el 24-10-2026. https://everything.curl.dev/usingcurl/verbose/writeout.html
- Advanced Usage (Proxies), documentación de Requests, consultado el 24-10-2026. https://requests.readthedocs.io/en/latest/user/advanced/
- Developer Interface (Session.trust_env), documentación de Requests, consultado el 24-10-2026. https://requests.readthedocs.io/en/latest/api/
- requests 2.34.2, PyPI, publicado el 14-05-2026. https://pypi.org/project/requests/
- urllib.request, documentación de Python, consultado el 24-10-2026. https://docs.python.org/3/library/urllib.request.html
- RFC 9110, HTTP Semantics, IETF, 06-2022. https://www.rfc-editor.org/rfc/rfc9110
- RFC 7617, The 'Basic' HTTP Authentication Scheme, IETF, 09-2015. https://www.rfc-editor.org/rfc/rfc7617
- RFC 1952, GZIP file format specification version 4.3, IETF, 05-1996. https://www.rfc-editor.org/rfc/rfc1952
- RFC 7932, Brotli Compressed Data Format, IETF, 07-2016. https://www.rfc-editor.org/rfc/rfc7932
- CONNECT request method, MDN, consultado el 24-10-2026. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Methods/CONNECT
- Proxy-Authorization header, MDN, consultado el 24-10-2026. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Proxy-Authorization
- 407 Proxy Authentication Required, MDN, consultado el 24-10-2026. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/407
- Accept-Encoding header, MDN, consultado el 24-10-2026. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Accept-Encoding
- Web Almanac 2025: Page Weight, HTTP Archive, 15-01-2026. https://almanac.httparchive.org/en/2025/page-weight
- Informe Page Weight, HTTP Archive, consultado el 24-10-2026. https://httparchive.org/reports/page-weight
- Network, documentación de Playwright, consultado el 24-10-2026. https://playwright.dev/docs/network
- Request Interception, documentación de Puppeteer, consultado el 24-10-2026. https://pptr.dev/guides/network-interception
- Downloader Middleware (HttpProxyMiddleware), documentación de Scrapy, consultado el 24-10-2026. https://docs.scrapy.org/en/latest/topics/downloader-middleware.html
- Prefixes for binary multiples, NIST, consultado el 24-10-2026. https://physics.nist.gov/cuu/Units/binary.html
- robots.txt, Amazon, consultado el 24-10-2026. https://www.amazon.com/robots.txt
- Conditions of Use, Amazon, actualizado el 14-08-2026. https://www.amazon.com/gp/help/customer/display.html?nodeId=508088
- Developers, IPinfo, consultado el 24-10-2026. https://ipinfo.io/developers
- Global objects (WebSocket), documentación de Node.js, consultado el 24-10-2026. https://nodejs.org/api/globals.html
- Catálogo de capacidades de EveryInfra, GET /api/v1/social/catalog, consultado el 24-10-2026 a las 18:29. https://api.everyinfra.com/api/v1/social/catalog
- Qualify your outbound links to Google, Google Search Central, consultado el 24-10-2026. https://developers.google.com/search/docs/crawling-indexing/qualify-outbound-links
- Datos originales amazon-page-weight-2026-10-24.csv, repositorio de ejemplos everyinfra-agent-plugins de EveryInfra, 24-10-2026. https://github.com/everyinfra/everyinfra-agent-plugins/blob/main/examples/proxy-plus-data-api/data/amazon-page-weight-2026-10-24.csv
Referencia BL-36