ChatGPT scheduled tasks y MCP: radar semanal de demanda
Diseñamos un radar semanal con tareas programadas de ChatGPT y el servidor MCP de EveryInfra para leer Reddit y Quora: 0,007226 USD por semana. La primera llamada pide una aprobación.
Sí se puede, y los datos son baratos: un «radar de demanda» que sale cada lunes cuesta 0,007226 USD en tarifas de la API de EveryInfra, unos 0,38 USD en 52 semanas. Lo que hay que prever no es el dinero, sino la aprobación. El 2026-10-26 a las 17:23 (hora de Singapur) leímos la lista de herramientas del servidor MCP remoto de EveryInfra: de 25 herramientas, las dos que traen datos, everyinfra_call_api y everyinfra_search, llevan readOnlyHint=false y destructiveHint=true, porque cada llamada cobra. La guía para desarrolladores de OpenAI Add custom MCP server dice que ChatGPT admite herramientas de lectura y de escritura; una herramienta sin readOnlyHint cuenta como escritura, y las escrituras piden aprobación por defecto. Así que la primera llamada de cada chat muestra un aviso: eliges permitir y puedes pedir que lo recuerde en ese chat. El artículo sobre tareas programadas dice que una acción que pide aprobación deja la tarea en pausa.
Frente a la pantalla es un clic más. Para que corra sin nadie delante, o abres las aprobaciones de esta app en un espacio Business o Enterprise, o lo partes en dos: otro programador de tareas trae los datos y ChatGPT solo los lee y escribe el informe.
En este artículo, un «radar de demanda» es un informe corto que corre cada lunes por la mañana. Usa palabras clave y comunidades fijas. Mira en Reddit y Quora de qué se queja la gente y qué pregunta esa semana. Elige los 5 posts más fuertes de cada tipo, con enlace y un resumen de una línea. Sirve a gerentes de producto, equipos de marca que venden en América Latina o España y a quien planifica contenidos. Responde a una sola pregunta: «¿de qué habló la gente esta semana?». No pronostica ventas ni decide quién tiene razón.


La parte que casi nadie mira es ese control de permisos. Una tarea programada de ChatGPT no es un guion fijo. A la hora indicada, el modelo vuelve a leer tus instrucciones y llama a las herramientas por su cuenta. Antes de cada llamada, ChatGPT revisa las anotaciones de la herramienta y tu ajuste de permisos. Después llama o te pregunta antes. Según la guía para desarrolladores de OpenAI, una herramienta que no está marcada como de solo lectura muestra el aviso la primera vez que se llama en cada chat, y un clic en permitir la deja pasar. Si estás frente a la pantalla, «te pregunta» es un clic más. Un lunes a las 9:00 sin nadie mirando, «te pregunta» significa que la tarea se queda parada. Cada sección de abajo responde a una pregunta: ¿en qué plan y con qué ajuste necesita ese control a una persona, y cómo evitas que pare una tarea programada?
Respuesta corta: hasta dónde llegan las chatgpt scheduled tasks en cada plan
La tabla junta los límites de la documentación de OpenAI que importan para este trabajo. Cada celda viene del centro de ayuda de OpenAI tal como lo leímos el 2026-10-26. No tenemos una cuenta de ChatGPT para esta prueba, así que la tabla muestra lo que dicen los documentos, no lo que ejecutamos.
| Plan | Tareas activas | Repetición más rápida | MCP propio | Herramienta de datos (no solo lectura) en una tarea programada |
|---|---|---|---|---|
| Free, Go | 3 | Una vez al día, en franjas como mañana o noche | El centro de ayuda no lo lista; un usuario del foro dice que Free aún necesita el modo desarrollador | No documentado; no conviene depender de ello |
| Plus | 5 | Cada hora, a horas exactas | El centro de ayuda no lo lista | No documentado; no conviene depender de ello |
| Pro (100 / 200 / 500 USD al mes) | 15 | Cada hora, a horas exactas | Sí; las preguntas frecuentes del centro de ayuda dicen que solo con permisos de lectura | La guía para desarrolladores admite lectura y escritura, con aprobación para escrituras; una aprobación pendiente pausa la tarea |
| Business | 10 | Cada hora, a horas exactas | Solo administradores y propietarios | Disponible; puede pedir aprobación, y eso pausa la tarea |
| Enterprise, Edu | Enterprise 15, Edu 10 | Cada hora, a horas exactas | Los administradores conceden «Create plugins with MCPs» por rol | Igual, con control por acción |
Los límites de tareas, la repetición y las franjas de Free salen de la sección «Review scheduled task limits» de Scheduled tasks in ChatGPT. El alcance del MCP propio sale de las preguntas frecuentes de Connecting custom MCP servers in ChatGPT. Los precios de Pro salen de About ChatGPT Pro tiers. Plus cuesta 20 USD al mes según What is ChatGPT Plus?. El centro de ayuda no dice si las cuentas Free pueden añadir servidores MCP propios. Una respuesta en el foro del 2026-10-07 dice que Free aún debe activar el modo desarrollador en «Security and login». Es un informe de usuario, así que lo marcamos como «sin confirmar».
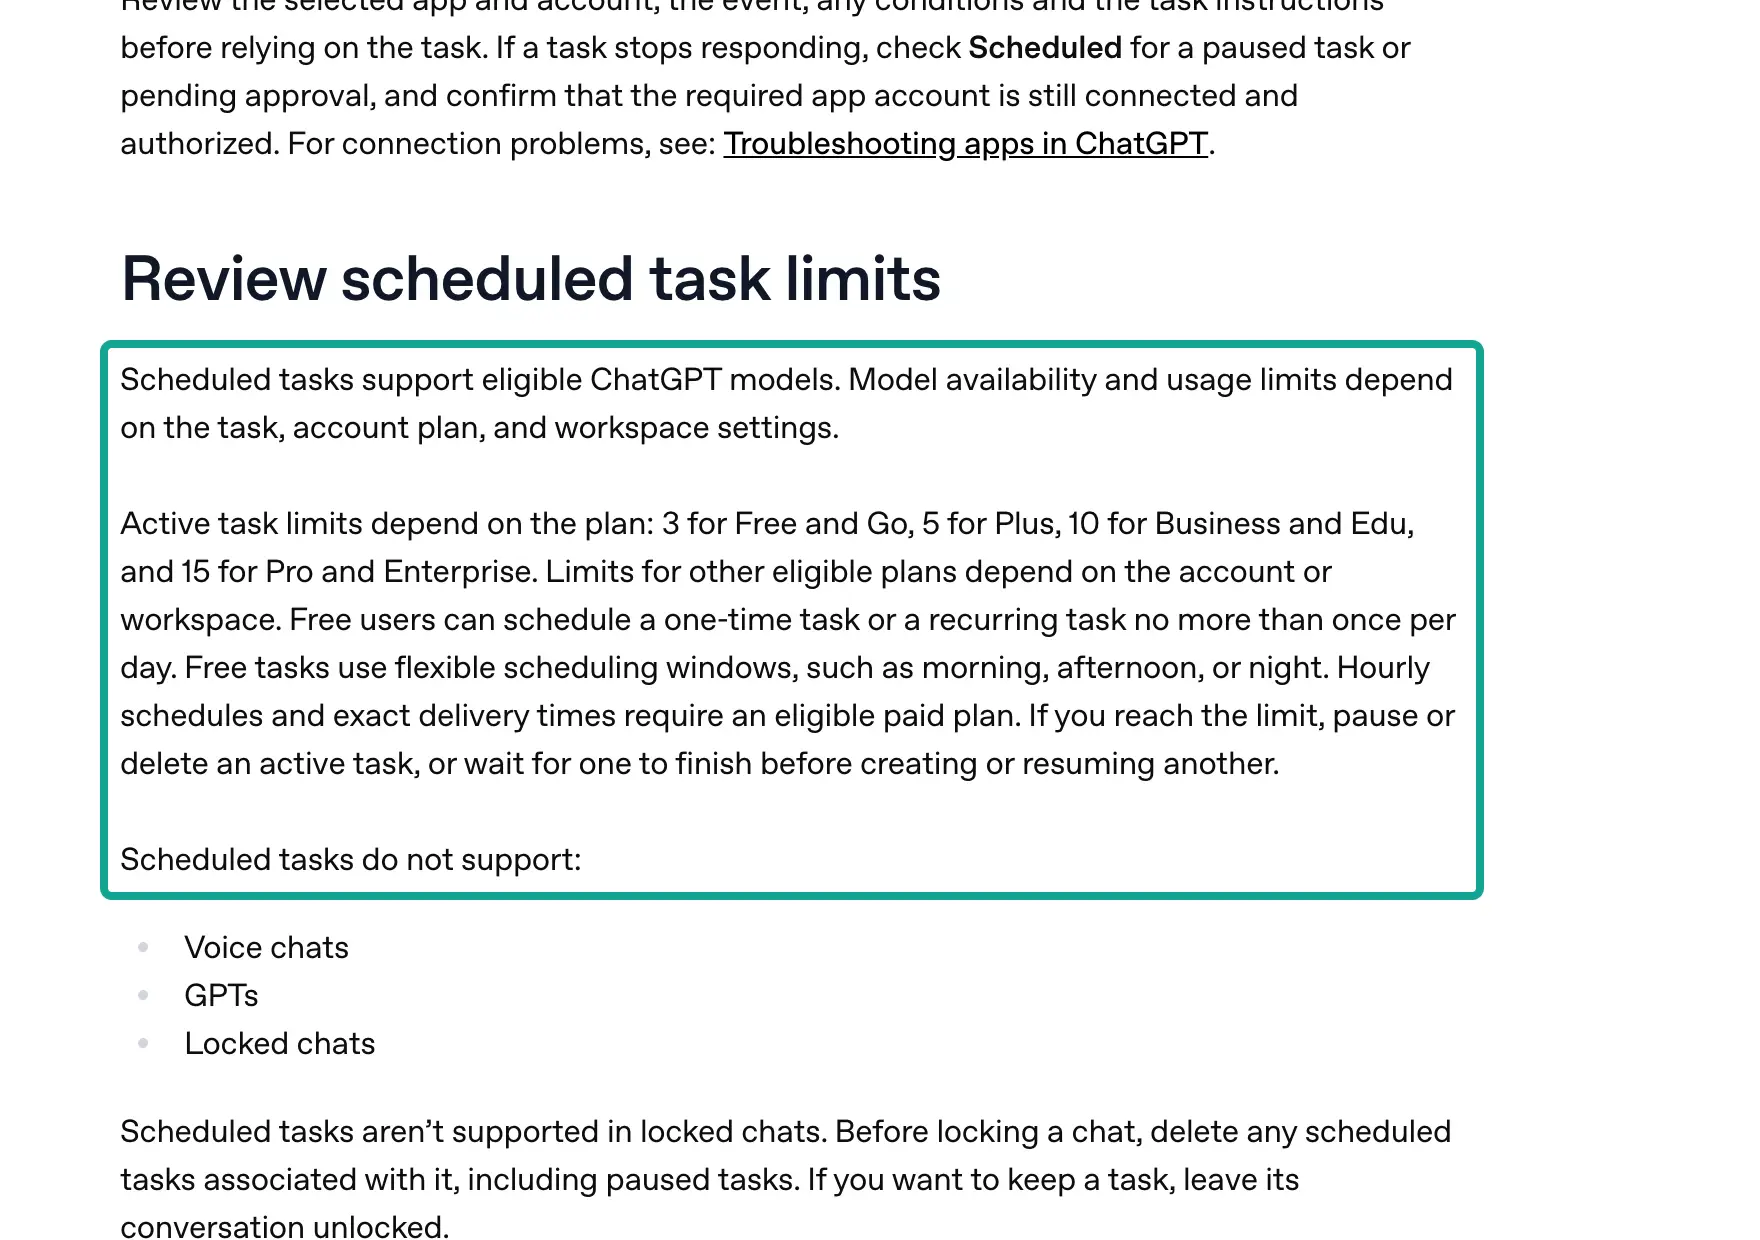
De la tabla salen dos decisiones. Primero, en Plus o Pro el camino fácil no es «ChatGPT llama a nuestra herramienta de datos», sino el diseño partido de la sección «Tres diseños». En un espacio Business o Enterprise donde el administrador acepte abrir las acciones de esta app, la conexión MCP directa es el camino más corto. Segundo, un radar semanal nunca toca el límite de repetición en un plan de pago. El número que importa es el de tareas activas: Plus tiene 5, así que con una tarea por categoría llenas el plan a la quinta.
Una ejecución, seis pasos
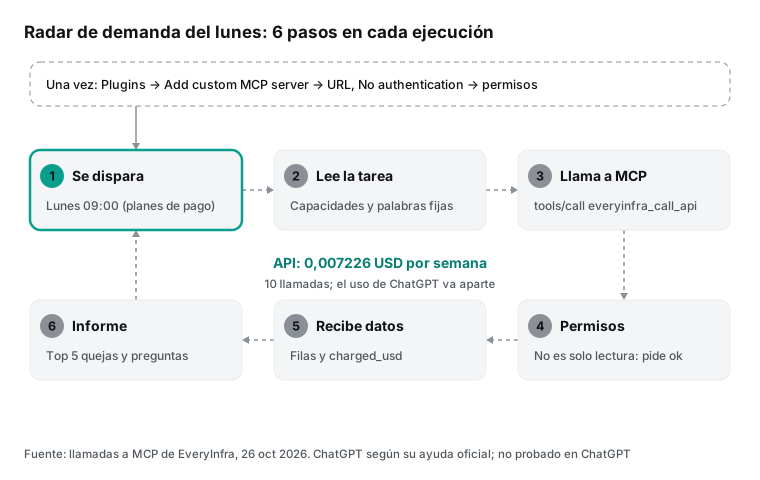
Los pasos 1 y 6 son de ChatGPT. Los pasos 3 y 5 son de EveryInfra. Los pasos 2 y 4 deciden si el trabajo sale igual cada semana. El paso 2 necesita valores fijos. En cada ejecución el modelo vuelve a leer tus instrucciones; si dejan margen para elegir, puede escoger otras palabras clave, otro orden u otro límite cada semana, y con eso cambian el costo y los resultados. La página para desarrolladores sobre tareas programadas da el mismo consejo: nombra en el texto de la tarea la habilidad o herramienta que debe usar cuando el flujo no deba depender de la elección automática, y prueba el texto en un chat normal antes de programarlo. El paso 4 tiene su propia sección más abajo.
Paso 1: añadir un chatgpt custom mcp connector (ya sin modo desarrollador)
El 2026-10-01, el responsable de la plataforma de plugins de OpenAI escribió en el foro oficial que conectar servidores MCP propios ya no exige entrar en el «modo desarrollador». Cualquier usuario elegible abre la página Plugins, pulsa «+» y elige «Add custom MCP server». El permiso de espacio de trabajo que antes se llamaba «Developer mode» cambió de nombre; hoy el centro de ayuda lo llama «Create plugins with MCPs». La página Connect and test your plugin enumera los pasos: nombre y descripción; en Connection, la URL pública HTTPS con la ruta /mcp; configurar la autenticación; aceptar el aviso de riesgo; elegir «Create as a plugin», y revisar las herramientas que encuentra ChatGPT.
Conviene pensar primero en la autenticación. El capítulo de autenticación pide a los servidores MCP que necesitan cuentas usar OAuth 2.1 y publicar metadatos en /.well-known/oauth-protected-resource. Una guía de terceros, la página de ChatGPT de AnythingMCP, registra tres opciones en el formulario: «OAuth», «No authentication» y «OAuth or no authentication», sin un campo para una clave en la cabecera. A las 17:42 (hora de Singapur) enviamos un GET a cada ruta de descubrimiento de api.everyinfra.com:
| Ruta de descubrimiento | Estado | Qué significa para ChatGPT |
|---|---|---|
/.well-known/oauth-protected-resource | 404 | OAuth no encuentra metadatos |
/.well-known/oauth-protected-resource/mcp | 404 | Igual |
/.well-known/oauth-authorization-server | 404 | Igual |
POST /mcp con User-Agent curl/8.5.0 | 200, 0,119 s | No bloqueamos la petición de comprobación de ChatGPT |
Así que en ChatGPT eliges «No authentication» y pones la clave en la URL: https://api.everyinfra.com/mcp?key=TU_CLAVE. No lo probamos dentro de ChatGPT; lo sostienen dos hechos. Cuando llamamos a nuestro servidor MCP sin clave a las 17:30 (hora de Singapur), el propio error decía «header Authorization: Bearer or ?key= query param». Además, la pasarela de EveryInfra acepta ambas formas para MCP. La última fila la probamos a propósito: el 2026-09-03 un desarrollador informó en el foro oficial que la petición de comprobación de ChatGPT usaba el User-Agent curl/8.5.0; su cortafuegos la bloqueó como un script y ChatGPT solo mostró «does not implement OAuth». Enviamos nuestro initialize con ese mismo User-Agent y recibimos 200.
Una clave en la URL tiene un costo. El RFC 6750, sección 2.3 dice que las URL con tokens suelen acabar en los registros y que no se debe usar ese método salvo que la cabecera no pueda llevar el token; la sección 5.3 también pide no pasar tokens en las URL de páginas. ChatGPT guarda la URL, y los miembros del espacio que ven la configuración de la app también la ven. Nuestro consejo es una clave aparte para ChatGPT con tres límites: solo capacidades reddit/* y quora/* (scope_mode=selected); un tope de gasto en USD (spend_limit_usd, activo desde el 2026-10-26), de modo que al llegar al tope la API responda 403 key_spend_limit_reached sin cobrar; y una fecha de caducidad. Los tres campos están en nuestro documento OpenAPI. Con la receta de este artículo, un año de API cuesta menos de 0,40 USD; un tope de 2 USD cubre el año con margen y limita la pérdida si la URL se filtra.
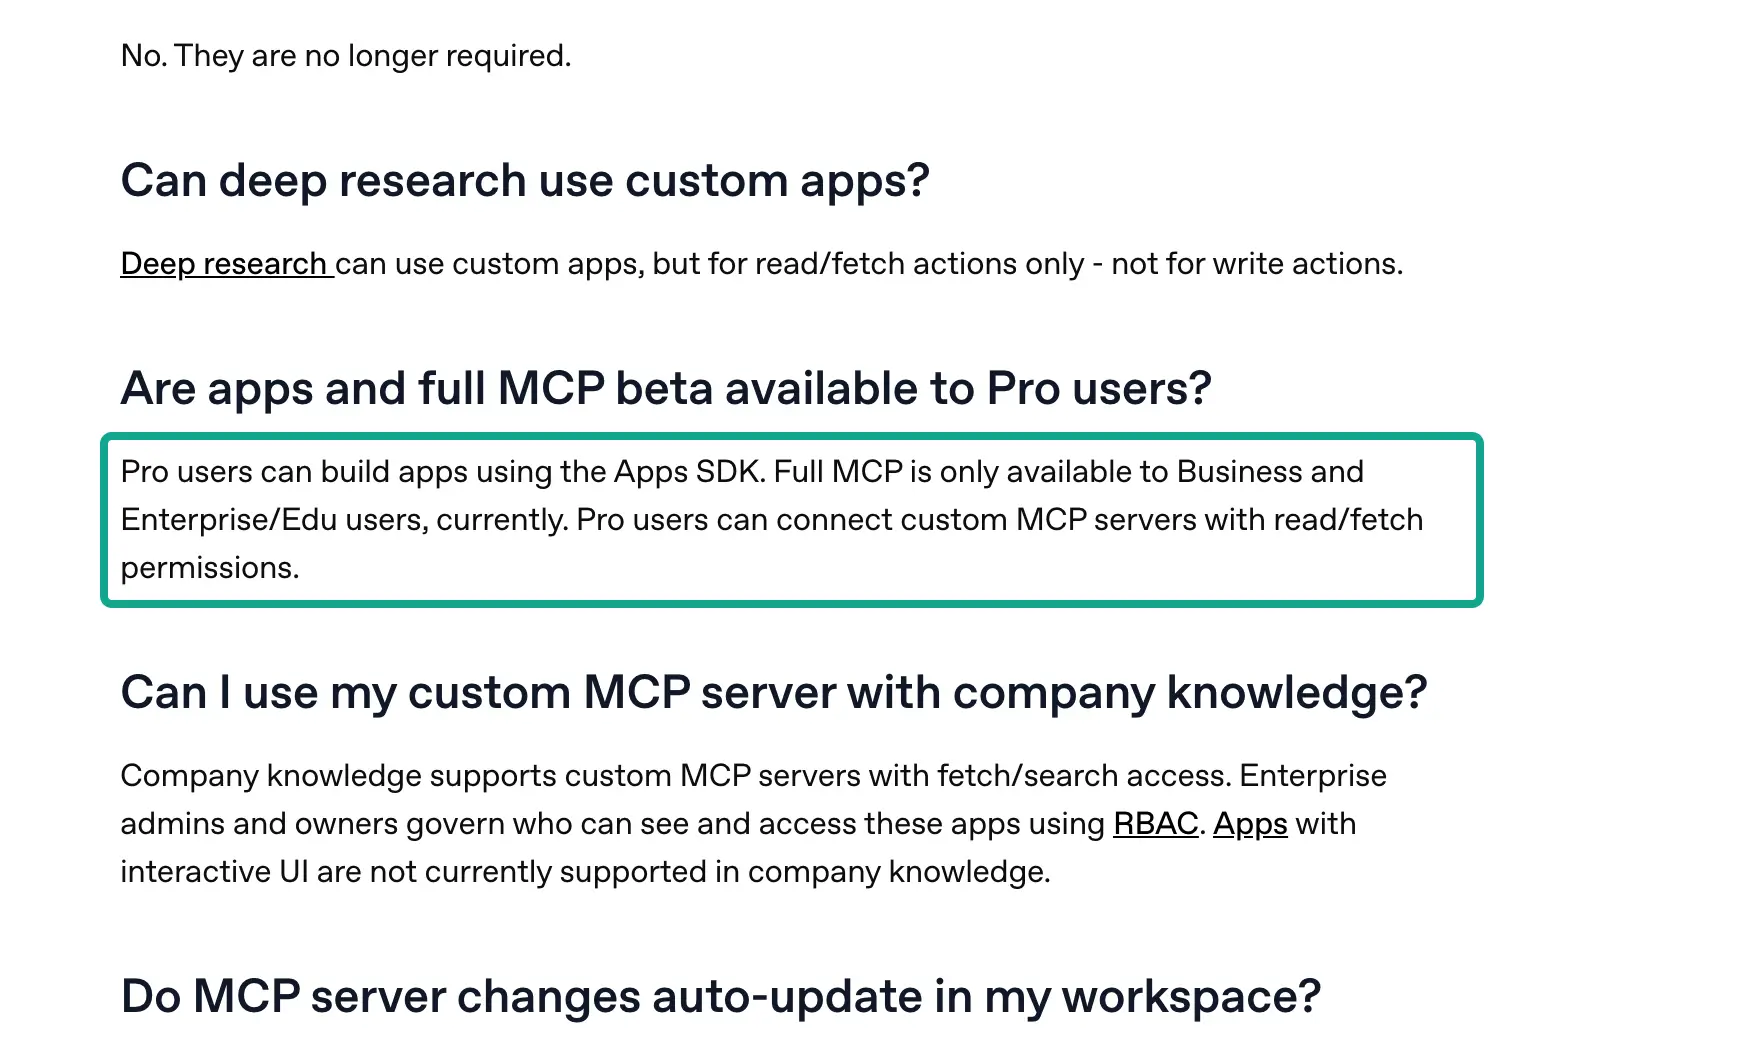
Esa frase no coincide con la guía para desarrolladores de OpenAI. Add custom MCP server empieza diciendo que ChatGPT admite herramientas de lectura y de escritura de tu servidor. Su sección «Reviewing and confirming tool calls» dice que ChatGPT usa readOnlyHint para reconocer las herramientas de solo lectura, y que las que no lo llevan cuentan como escrituras. Las escrituras piden aprobación por defecto, y puedes recordar la aprobación de una herramienta para un chat; un chat nuevo o una recarga vuelven a preguntar. Con esa regla, nuestra herramienta de datos funciona en ChatGPT: la primera llamada de cada chat muestra un aviso y eliges permitir. No queda bloqueada. No lo probamos con una cuenta Pro. Si en Pro ves otra cosa, fíate de lo que ves.
Un viaje real de ida y vuelta: qué envía ChatGPT y qué devolvemos
Cuando ChatGPT llama a una herramienta de un servidor MCP propio, envía una sola petición JSON-RPC tools/call. El 2026-10-26 a las 17:34:47 (hora de Singapur) enviamos esa misma petición con curl. Lo único distinto: la clave iba en la cabecera Authorization, no en la URL.
curl -s https://api.everyinfra.com/mcp \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":4,"method":"tools/call",
       "params":{"name":"everyinfra_call_api",
                 "arguments":{"platform":"reddit","action":"search",
                              "params":{"keyword":"robot vacuum keeps getting stuck","sort":"top","limit":10}}}}'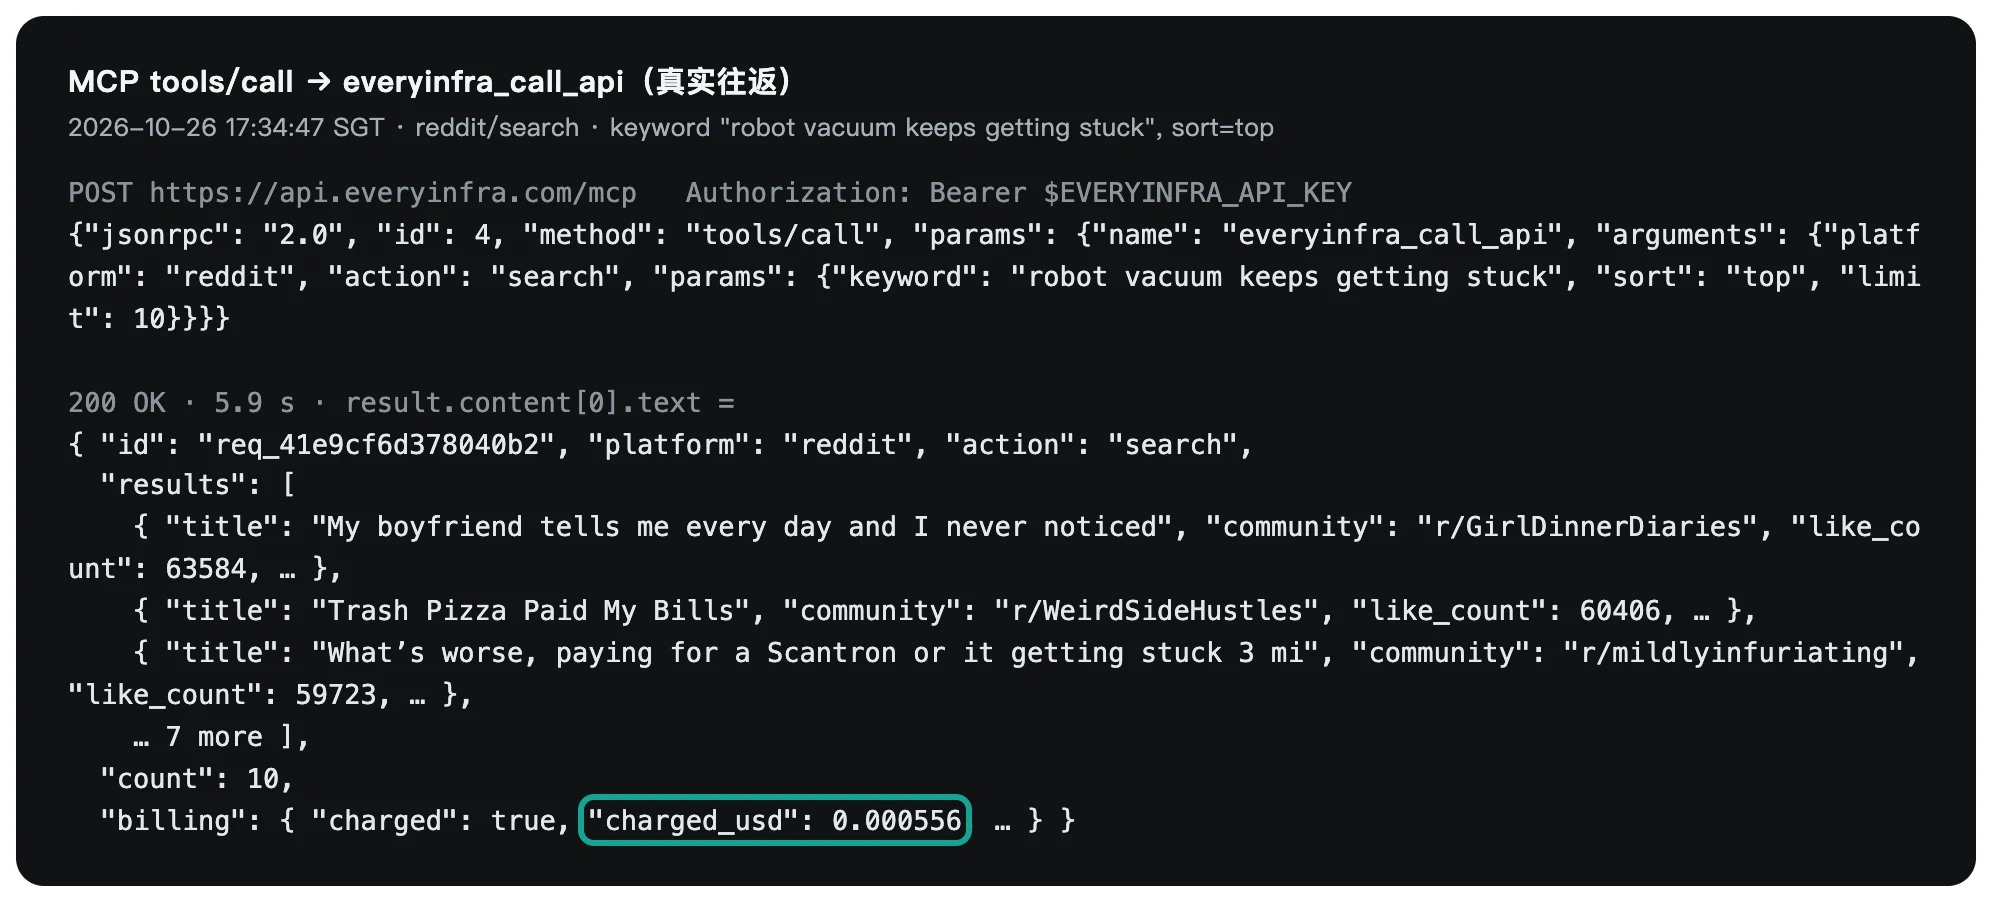
La llamada tardó 5,9 segundos, devolvió 10 filas y costó 0,000556 USD, igual al price_usd de reddit/search en el catálogo de capacidades. Las 10 claves de cada fila (id, url, title, text, author_username, community, like_count, comment_count, posted_at, platform) están todas en response_fields del catálogo; no aparece ningún campo fuera de él. Pero ninguno de los 10 resultados menciona «vacuum». El primero es un post de citas con 63.584 puntos. El catálogo explica por qué: la ventana de tiempo de reddit/search es fija, el último mes, y sort=top ordena por puntuación. Una frase de cinco palabras encaja con un post cuando coincide cualquiera de ellas. El resultado son los posts con más puntos del mes en todo Reddit que por casualidad contienen «stuck» o «getting».
A las 17:35:11 (hora de Singapur) enviamos la misma frase con sort=relevance. Los 10 resultados mencionaban «vacuum» y 2 contenían las cinco palabras. La API funcionó; el problema fue el parámetro que eligió el modelo. En un chat ves un mal resultado y lo corriges. En una tarea programada nadie mira, y el modelo puede pagar cada semana por los posts equivocados. Por eso el paso 2 debe fijar sort, usar frases de 2 o 3 palabras y pedir que el informe liste, por cada llamada, cuántas filas volvieron y cuántas encajan. Un vistazo basta para ver si los datos de la semana salieron mal.
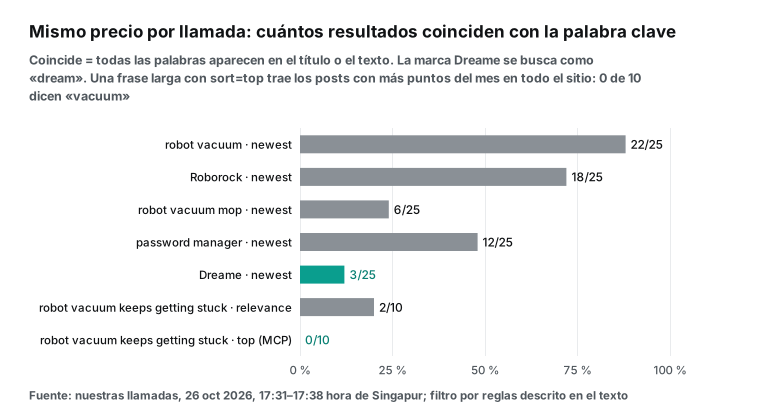
La otra barra verde azulada es Dreame, una marca de robots aspiradores muy presente en tiendas de Chile, México o España. A las 17:31:36 (hora de Singapur), solo 3 de sus 25 resultados hablaban de Dreame. El resto eran sueños contados en r/Dreams y anuncios de ficción, porque la búsqueda trató «Dreame» como «dream». Roborock, un nombre que no parece una palabra común, salió mucho mejor: 18 de 25. Si el nombre de tu marca se parece a una palabra común en inglés, la búsqueda por palabra clave se llena de ruido. Usa la comunidad de la propia marca con reddit/subreddit_posts (Dreame tiene r/Dreame_Tech) o añade a la palabra clave un término de la categoría. Lo curioso es que la búsqueda en español sí encontró a Dreame: con «aspiradora robot», un usuario chileno publicó el 2026-10-16 y el 2026-10-19, en r/RobotVacuums y r/VacuumCleaners, una queja porque la marca, según él, no tiene un plan de servicio posventa para el mercado chileno. Es justo el tipo de queja que una marca quiere ver el lunes, y en inglés no aparece.
Por qué las herramientas de datos piden aprobación: las anotaciones de 25 herramientas
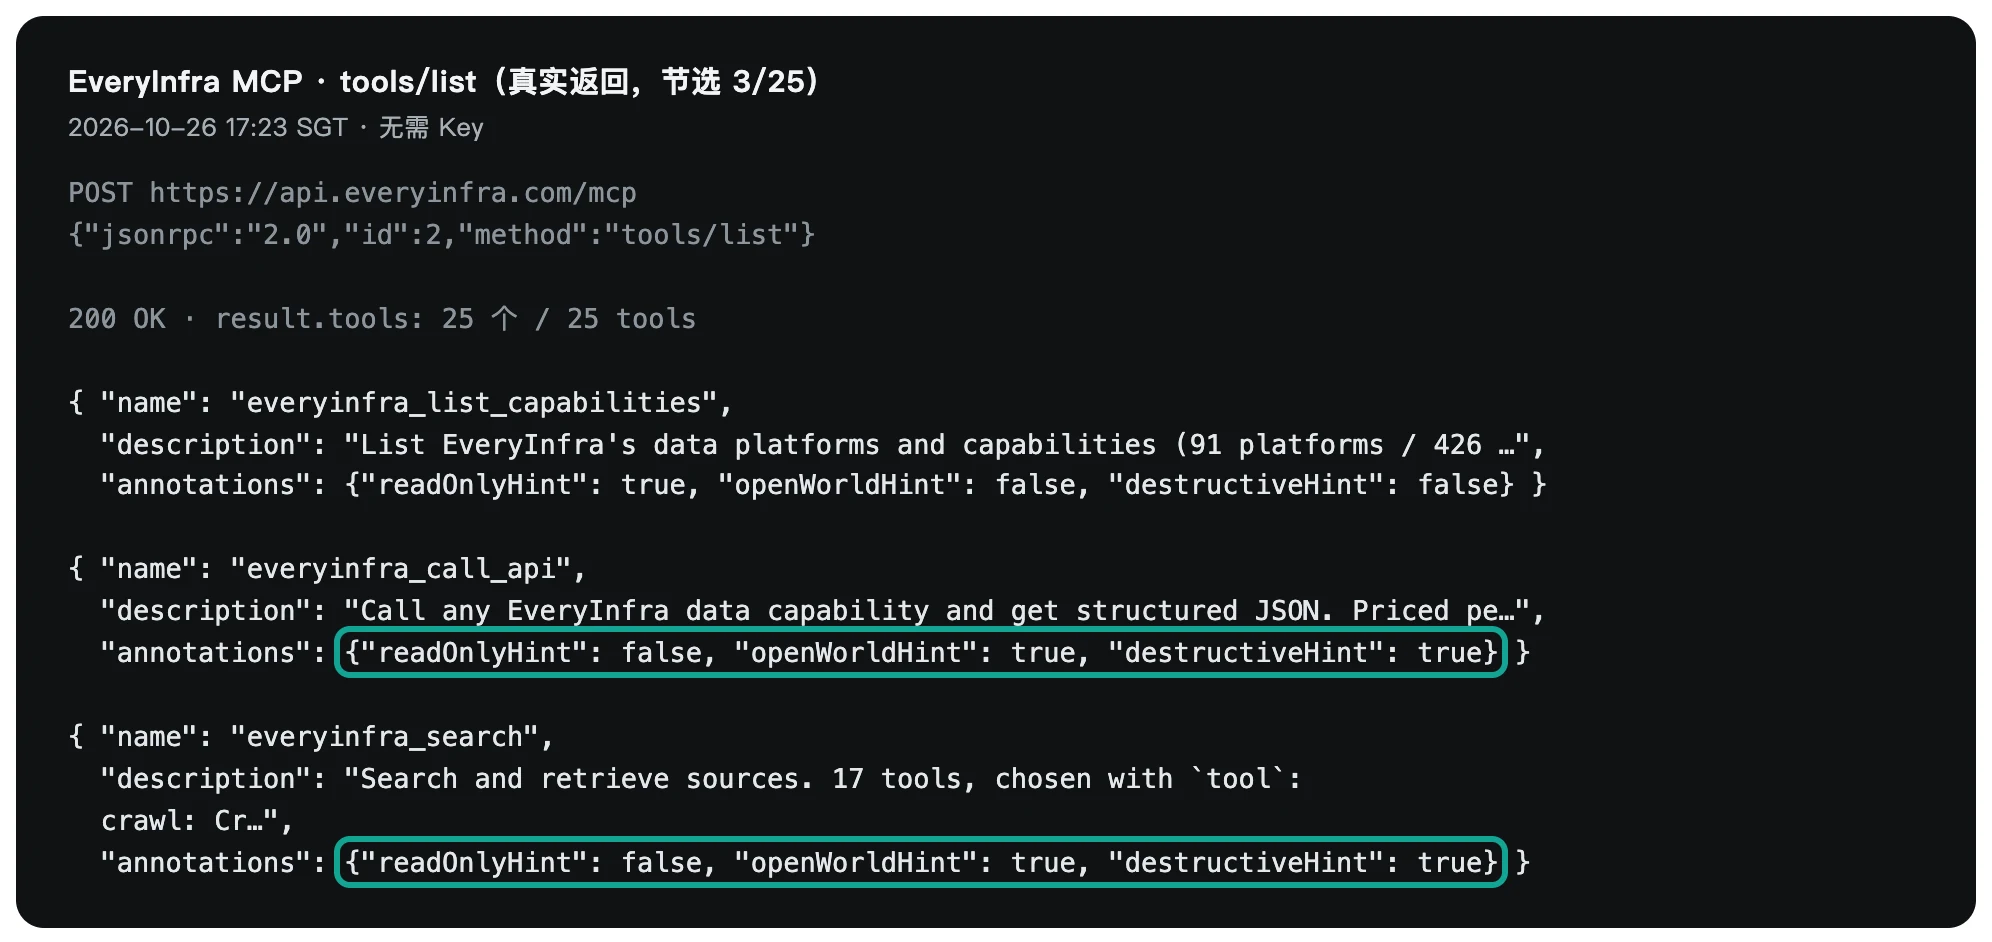
La especificación MCP da a cada herramienta unas pocas anotaciones. La definición de ToolAnnotations en la versión 2025-11-25 dice que readOnlyHint en true significa que la herramienta no modifica su entorno, y que el valor por defecto es false. destructiveHint solo tiene sentido cuando la herramienta no es de solo lectura, y su valor por defecto es true. openWorldHint indica que la herramienta trata con un mundo abierto de entidades externas, y por defecto también es true. La documentación de plugins de OpenAI pide poner readOnlyHint en true solo cuando la herramienta no puede cambiar el estado, y dice que las anotaciones ayudan a ChatGPT y a Codex a elegir cuándo confirmar. Una anotación no hace nada por sí sola, pero el programa anfitrión la usa para decidir cuándo preguntar. Un ejemplo: Codex tiene el ajuste MCP default_tools_approval_mode; con el valor writes, pide confirmación para las herramientas no marcadas como de solo lectura, según la página de MCP de OpenAI. ChatGPT funciona igual: Add custom MCP server dice que usa readOnlyHint para reconocer las herramientas de solo lectura, trata las demás como escrituras y pide aprobación para las escrituras por defecto.
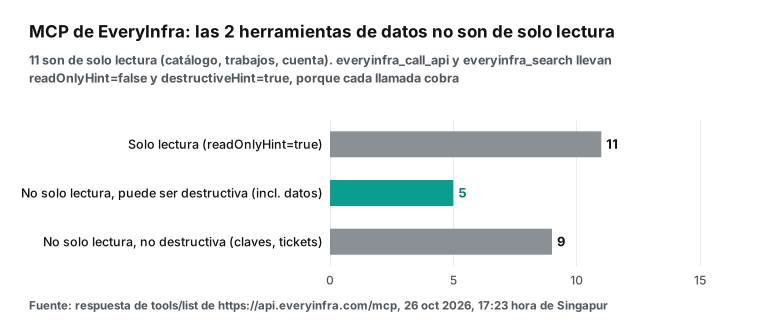
De nuestras 25 herramientas, 11 son de solo lectura: listar capacidades, leer un trabajo, listar tipos de CAPTCHA, leer la cuenta, leer el consumo, leer los registros de peticiones, leer la facturación, listar claves, listar tickets, obtener un enlace de recarga y leer un ticket. Las otras 14 no lo son, y 5 de ellas pueden ser destructivas. Dos de esas 5 son las de datos, everyinfra_call_api y everyinfra_search. Las otras 3 no tienen que ver con este trabajo (una de ellas borra una clave). ¿Por qué las herramientas de datos no dicen «solo lectura»? No cambian nada en Reddit, pero sacan dinero de tu monedero, y eso cambia el entorno. Nuestra regla es simple: una herramienta que llega a sitios externos lleva openWorldHint=true, y una llamada de pago siempre lleva destructiveHint=true. Nos parece lo correcto. Si una herramienta que gasta dinero dijera «solo lectura», el anfitrión la dejaría correr sin preguntar, y si el modelo entra en un bucle por error, no tendrías ocasión de pararlo.
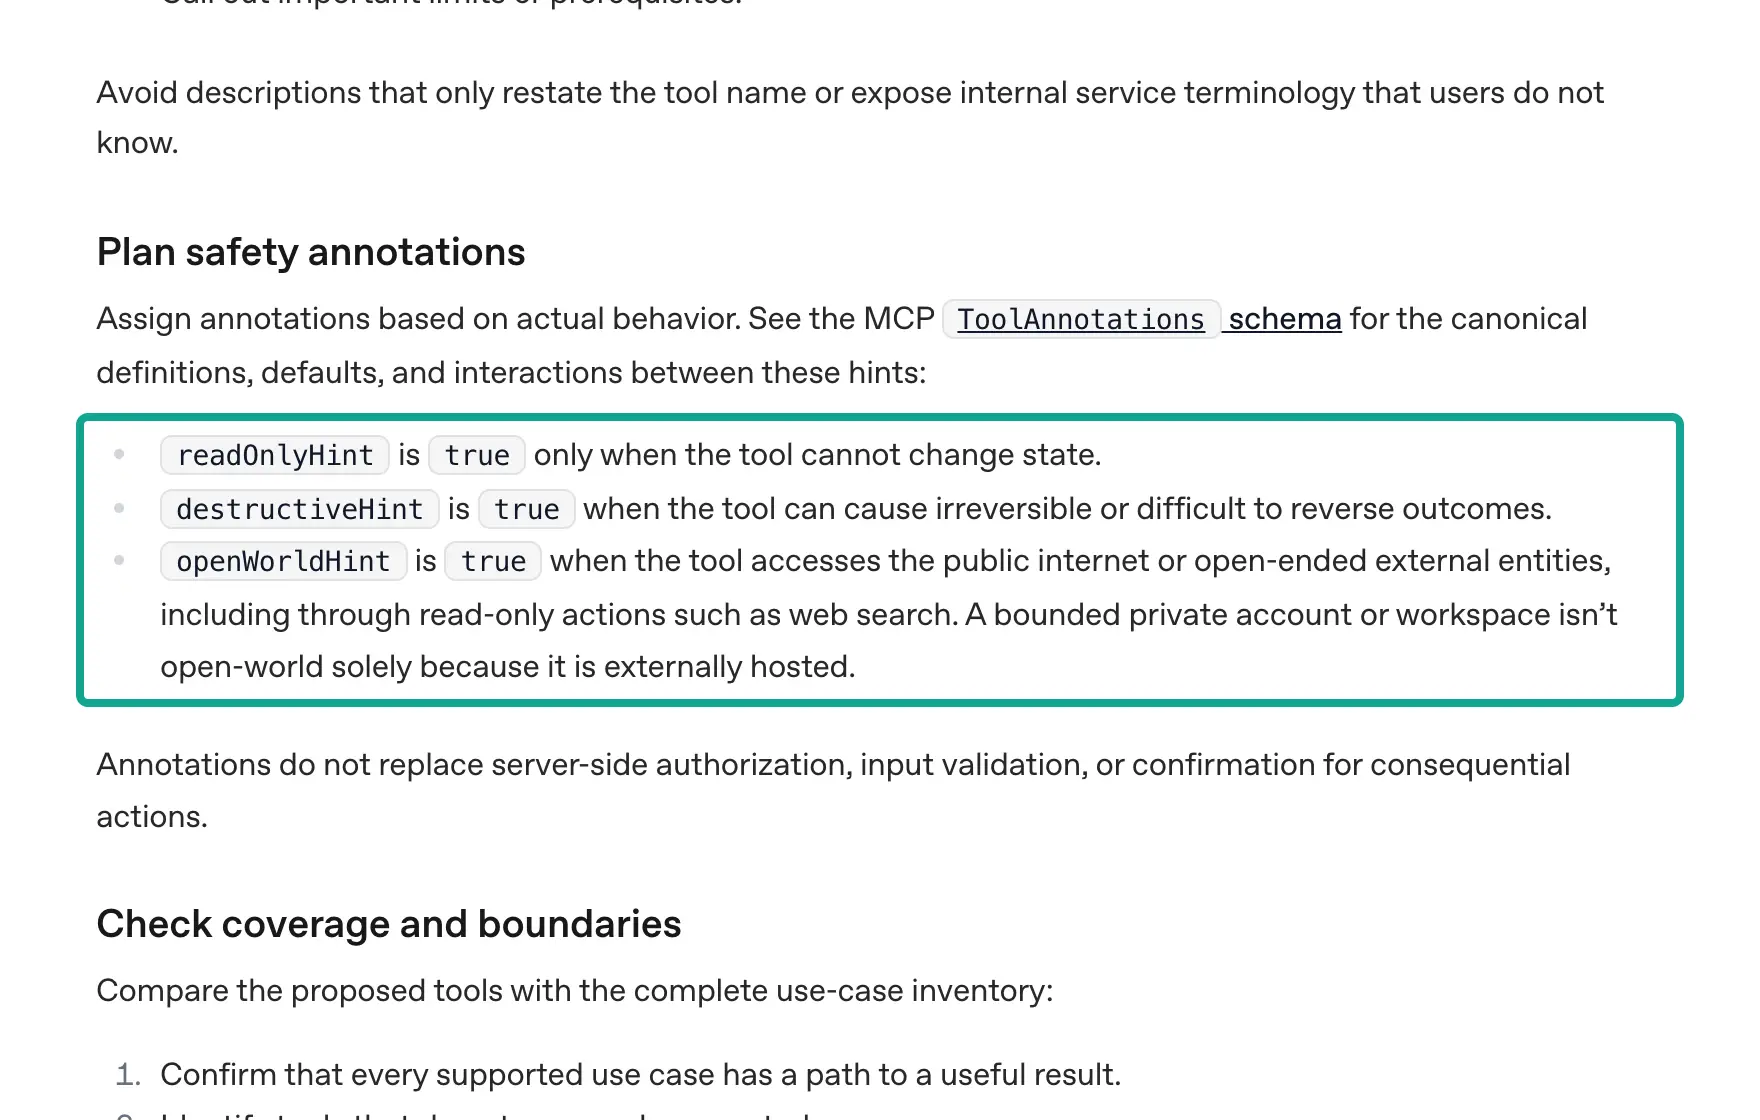
Por encima de las anotaciones está tu propio ajuste de permisos en ChatGPT. Managing app permissions in ChatGPT lista cuatro niveles. «Always ask» pregunta antes de leer y antes de cambiar. «Allow read actions» lee sin preguntar, pero pregunta antes de cambiar. «Allow low-risk actions» aprueba las acciones de bajo riesgo; las de más riesgo pueden pedir aprobación o rechazarse. «Allow all actions» ejecuta las acciones admitidas sin más preguntas, pero solo puede fijarse para una app o una cuenta concreta; los selectores generales de la cuenta y del espacio de trabajo no lo ofrecen. La misma página dice que el botón «Always allow» no se ofrece a miembros de espacios gestionados ni para acciones que necesitan una revisión de seguridad adicional. El registro de cambios de plugins muestra que estos ajustes de «cuándo preguntar» entraron en vigor el 2026-06-12.
| Tu ajuste | Qué hace nuestra herramienta de datos (no es de solo lectura, puede ser destructiva) | Resultado en una tarea programada |
|---|---|---|
| Always ask | Pregunta cada vez; eliges permitir | La tarea te espera |
| Allow read actions | No es una lectura, así que pregunta | Igual |
| Allow low-risk actions (por defecto) | Marcada como destructiva, así que probablemente no es de bajo riesgo: pregunta | Igual |
| Allow all actions (solo para una app) | Sin más preguntas para las acciones admitidas | Puede correr sola; usuarios del foro informan de ejecuciones programadas bloqueadas aun así por los controles de seguridad |
La segunda y la tercera columna son nuestra lectura de los documentos; ChatGPT no publica la regla de «bajo riesgo». En un chat normal, con cualquier nivel, lo máximo es un aviso en la primera llamada: eliges permitir, lo recuerdas para ese chat y ese chat no vuelve a preguntar. Las tareas programadas añaden algo más, y de eso tratan los informes del foro de abajo.
El 2026-10-04, un usuario publicó en el foro de OpenAI un informe de regresión. Su tarea semanal lee Gmail, investiga y decide qué correo enviar. Gmail estaba en «Allow all actions» y el texto de la tarea daba aprobación permanente. En el paso que envía el correo y escribe en Google Sheets, la llamada se bloqueó con «This tool call was blocked by OpenAI's safety checks». Listó fallos entre el 2026-09-30 y el 2026-10-03. El 2026-10-05, otro usuario pegó el mismo tipo de texto de tarea en un chat normal y las 8 escrituras en Trello salieron bien; en la ejecución programada, se bloquearon. Hasta el 2026-10-08 seguían llegando respuestas con escrituras en GitHub que unos días funcionaban y otros no, mientras leer y ordenar el correo seguía funcionando. Otro informe del 2026-10-06 al 2026-10-08 es peor: tras una escritura bloqueada en GitHub, tareas que corrían cada hora pasaron a desactivadas unos 64 o 65 segundos después de la ejecución, y la siguiente no llegó a ocurrir. Son informes de usuarios y OpenAI no ha dado una conclusión en esos hilos. Los documentos de OpenAI dicen que las escrituras piden aprobación y después se ejecutan; no dicen que una tarea programada no pueda escribir. Lo que muestran estos informes es que algunos usuarios vieron escrituras aprobadas bloqueadas por los controles de seguridad en ejecuciones programadas. ChatGPT trata nuestra herramienta de datos como escritura. Así que, si el radar tiene que correr solo y de forma fiable, no metas la obtención de datos dentro de la tarea programada.
Tres diseños: cuál te conviene
En ChatGPT la herramienta de datos pide aprobación, y en una ejecución programada no hay nadie para darla. Así que tienes tres opciones: abrir la puerta en un espacio que lo permita, sacar la obtención de datos de ChatGPT para que ChatGPT solo lea, o no usar las tareas programadas de ChatGPT.
| Diseño | Para quién | Cómo | Costo y riesgo |
|---|---|---|---|
| A. MCP directo | Espacios Business o Enterprise | El administrador crea y publica la app, fija «Allow all actions» para ella y ejecuta la tarea una vez a mano en un chat normal | Usuarios del foro informan de que los controles de seguridad aún pueden bloquear la ejecución programada; la clave va en la URL, así que usa una clave limitada |
| B. Partido: datos fuera, ChatGPT lee | Plus, Pro, cuentas personales | El lunes a las 08:00, cron, n8n o GitHub Actions llama a nuestra API REST y escribe un archivo en Google Drive o GitHub. A las 09:00, la tarea de ChatGPT lee ese archivo con el conector de Drive o GitHub y escribe el informe | Un programador de tareas más; ChatGPT solo lee, que es el caso más estable |
| C. Sin tarea programada de ChatGPT | Quien quiere automatizar todo y sabe escribir algo de código | Tu propio cron llama a la Responses API de OpenAI con la herramienta MCP remota (require_approval: "never", allowed_tools), o usas las tareas programadas en la nube de Claude Code | Pago por tokens; fuera de la interfaz de ChatGPT |
El diseño B sale de una respuesta en el mismo hilo del foro, de alguien que construye automatizaciones para empresas: la IA decide y escribe un registro estructurado, y un programa determinista que tú controlas hace la acción (respuesta del 2026-10-07). En un radar de demanda, la «acción» es traer los datos. Un programador de tareas puede llamar a EveryInfra sin aprobación humana, y el paso de ChatGPT solo lee un archivo, que es el lado estable de la línea. Ya probamos un flujo diario de n8n que llama a EveryInfra: cambia sus palabras clave, escribe la salida en Google Drive y tienes la primera mitad del diseño B. Para el diseño C, la guía de MCP de la Responses API explica cómo require_approval omite las aprobaciones y cómo allowed_tools importa solo las herramientas necesarias. Las tareas programadas en la nube de Claude Code están en los planes Pro, Max, Team y Enterprise y corren con el portátil cerrado. No probamos ninguno de esos dos caminos en este artículo; los listamos solo como opciones.
Qué debe traer el radar: tres grupos de llamadas reales
Un radar solo sirve si sus datos son «de esta semana» y «de esta categoría». El 2026-10-26, entre las 17:31 y las 17:41 (hora de Singapur), corrimos tres grupos con una sola clave de prueba. El grupo uno es de hardware: robots aspiradores (palabras clave «robot vacuum», «Roborock», «Dreame», «robot vacuum mop»; comunidad r/RobotVacuums). El grupo dos es una categoría SaaS: gestores de contraseñas (palabra clave «password manager»; comunidad r/PasswordManagers). El grupo tres usa palabras clave en español, pensando en quien vende en Chile, Colombia, Argentina, México o España. En total enviamos 32 peticiones. 22 se cobraron, por 0,016397 USD. Las otras 10 fueron pruebas de error planificadas, peticiones frenadas por el límite de frecuencia y resultados vacíos, y ninguna costó dinero.
La primera cuestión es el periodo que cubren los datos. El catálogo dice que la ventana de reddit/search es fija, el último mes, y que su max_limit es 25. Con sort=newest, 25 posts cubren solo horas: «robot vacuum» abarcó 15,6 horas, «Roborock» 24,4, «Dreame» solo 0,2 (contó cada post nuevo con «dream») y «password manager» 7,1. Si el lunes la tarea toma solo «los 25 más nuevos», ves de la tarde del domingo a la mañana del lunes y te pierdes de martes a sábado. Traer una comunidad es distinto. reddit/subreddit_posts con sort=top, date_range=past_week y limit=100 devolvió 100 posts de r/RobotVacuums en 166,3 horas y los 20 posts de la semana de r/PasswordManagers, del 2026-10-19 al 2026-10-26, en 160,1 horas. Ambos se acercan a una semana entera.
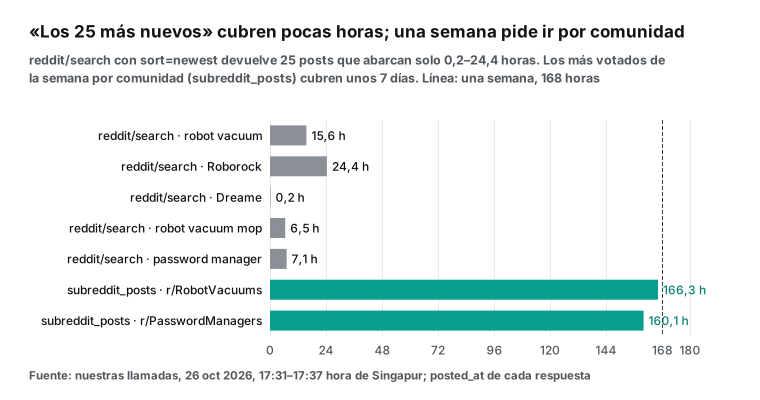
Así que el núcleo de este trabajo es reddit/subreddit_posts. Usa la búsqueda por palabra clave solo para descubrir comunidades que aún no conoces. Nuestro criterio previo para este punto contaba «cuántos de 25 posts caen en los últimos 7 días». Los 25 caían dentro, así que, según la línea original, la respuesta era «semanal basta». Pero esa línea medía lo que no era: los 25 posts estaban en los últimos 7 días porque todos estaban en las últimas horas. En nuestro registro de prueba anotamos este criterio como «mal diseñado». Sacamos la conclusión del periodo cubierto y no cambiamos el criterio original.
La segunda cuestión es qué contienen los posts de la semana. Hacemos un filtro previo con reglas fijas, escritas en la cabecera de nuestro guion de análisis. Un post es una «pregunta» cuando su título termina en signo de interrogación o empieza con palabras como how, what, which, best o anyone. Un post «tiene palabras de queja» cuando su título o los primeros 400 caracteres del cuerpo contienen palabras como stuck, broken, issue, avoid o return. En r/RobotVacuums, 49 de 100 posts son preguntas y 35 tienen palabras de queja. En r/PasswordManagers, 8 de 20 y 1 de 20. En la búsqueda «aspiradora robot», 4 de 8 y 1 de 8.
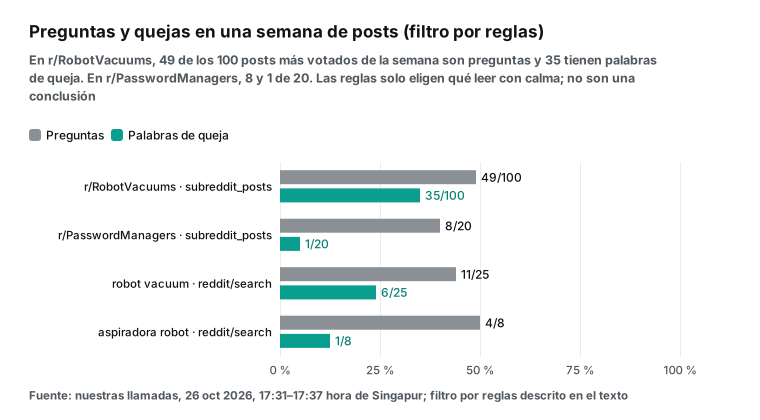
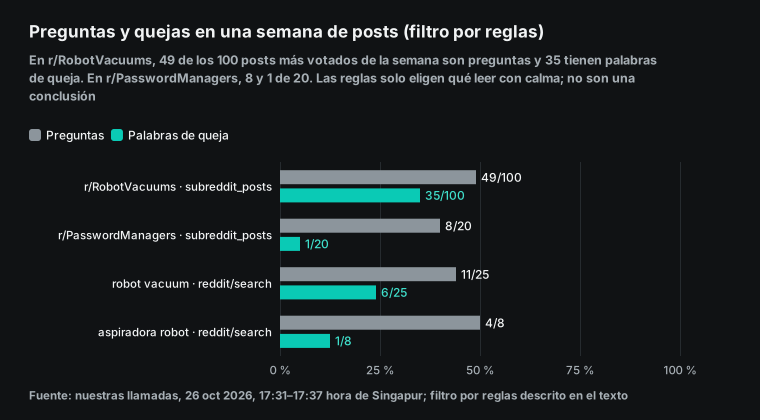
Las reglas solo eligen qué posts leer con atención; no son un hallazgo. En r/RobotVacuums, el post con más comentarios de la semana (53) es «Help me convince my spouse to buy a robot vacuum!!», una pregunta que en realidad trata de objeciones de compra. El segundo, «Anyone HAPPY with their robot after a year?» (31 comentarios), parece una pregunta, pero sus comentarios están llenos de quejas sobre la duración de los equipos. El post con más puntos (32) es «Lol avoid Eureka», una queja directa contra una marca. La tarea de ChatGPT debe hacer la clasificación real, porque un modelo lee bien la jerga y entiende «molesto por qué». Nuestras reglas hacen un solo trabajo: mostrar si las preguntas o las quejas subieron esta semana respecto a la anterior.
La tercera cuestión son los comentarios. Llamamos a reddit/comments con limit=50 en tres posts de r/RobotVacuums. Devolvieron 30, 29 y 22 comentarios. En el grupo de gestores de contraseñas, con limit=100, volvieron 73 y 49. La API devuelve los comentarios de primer nivel y no despliega las respuestas, como explicamos en por qué los comentarios de Reddit parecen incompletos. Los detalles valen la pena. En el hilo de «¿alguien está contento después de un año?», un usuario dice que compró varios modelos insignia de marcas distintas y que ninguno duró una semana, todos con fallos eléctricos. En el hilo «Does good obstacle avoidance actually exist?», el comentario más votado dice que nunca dejaría un robot funcionando sin estar en casa, y otro estima que incluso el mejor sistema solo evita el 90 % de los obstáculos. En «¿qué zonas aún limpias tú?», la respuesta más votada lista la parte alta del sofá, el techo y detrás de las puertas. Estas frases casi nunca salen en las reseñas de las tiendas. Son lo que un equipo de producto necesita: qué falla, qué no se cree y qué tarea sigue siendo manual.
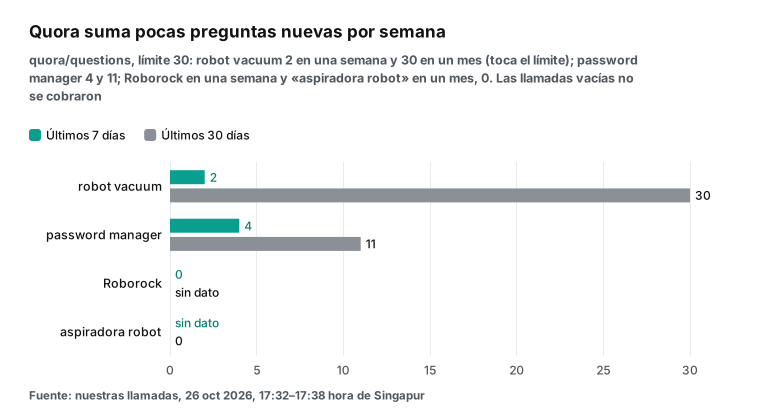
La cuarta cuestión es el volumen de Quora. quora/questions con date_range=past_week_last_7_days y limit=30 encontró 2 preguntas nuevas sobre «robot vacuum» en una semana y 30 en 30 días (el límite, así que la cifra real es mayor). «Roborock» tuvo 0 en una semana. Esa llamada no costó nada y la respuesta decía "reason": "empty_result_refunded". Para gestores de contraseñas hubo 4 en una semana y 11 en 30 días. Quora aporta «qué piensa la gente antes de comprar». El volumen es bajo, así que una consulta mensual basta.
El radar en español: cuatro trampas que vimos en las llamadas reales
Si vendes en América Latina o en España, el radar en inglés no te basta. La gente que compra un robot aspirador en Santiago o en Bogotá pregunta en sus propias comunidades, con sus propias palabras y sus propios precios. Por eso el tercer grupo de llamadas solo usó palabras clave en español, y fue el que más sorpresas dio.
La primera trampa es el orden de las palabras. reddit/search con «aspiradora robot» y sort=relevance devolvió, a las 17:38:05 (hora de Singapur), solo 8 posts, y 7 encajaban con la búsqueda. Venían de comunidades latinoamericanas: r/AskChile, r/RepublicadeChile, r/Colombia, r/chile y r/AskArgentina. En cambio, «robot aspirador» con sort=newest, a las 17:41:05 (hora de Singapur), devolvió 11 posts, casi todos de comunidades portuguesas como r/TudoCasa, r/CasualPT o r/TugaTech, porque en portugués de Portugal se dice «aspirador robot». Entre ellos había posts sobre insectos en la cama, cómo limpiar una terraza y un perro que orina fuera de su sitio. El español y el portugués comparten tantas palabras que el mismo par, en otro orden, cambia de país.
La segunda trampa es Quora. Con «aspiradora robot» en los últimos 30 días no hubo ningún resultado; la llamada se reembolsó sola. Con «robot aspirador» en el último año volvieron 5 preguntas, todas en inglés y sobre empresas de robótica «aspiring» (que aspiran a algo). Como el resultado no estaba vacío, costó 0,001389 USD. Quora en español apenas aparece en este tipo de búsqueda. Para un radar en español, deja Quora para la versión en inglés y pon el presupuesto en Reddit.
La tercera trampa son los posts duplicados. «Mejor aspiradora robot del mercado?» aparece dos veces, en r/AskChile (18 comentarios) y en r/RepublicadeChile (15 comentarios), publicado por la misma cuenta con dos minutos y medio de diferencia, el 2026-10-25. Si el informe cuenta posts, cuenta dos veces la misma pregunta. Si deduplicas solo por id o url, también la cuentas dos veces, porque son dos posts distintos. Para el radar en español, compara también el título normalizado (minúsculas, sin signos) y quédate con el que tiene más comentarios.
La cuarta trampa es el ruido de las comunidades generales. El post con más comentarios de la búsqueda fue «Es la segunda vez que tiendas me devuelven la plata y no deberían», en r/chile, con 89 comentarios y 105 puntos. Menciona un robot aspirador de pasada, pero trata de devoluciones de tiendas. Una comunidad nacional general atrae muchos comentarios sobre cualquier cosa, y un radar que ordena por número de comentarios la pondría primera. Ordena dentro de cada comunidad o exige que la palabra clave aparezca en el título.
| Llamada (hora de Singapur) | Parámetros | Filas | Encajan | Qué aprendimos | Cobro |
|---|---|---|---|---|---|
17:38:05 reddit/search | aspiradora robot, relevance, 25 | 8 | 7 | Comunidades de Chile, Colombia y Argentina | 0,000556 USD |
17:38:18 quora/questions | aspiradora robot, últimos 30 días, 30 | 0 | — | Reembolso automático | 0 USD |
17:40:05 reddit/comments | hilo de r/AskChile, limit 100 | 18 | — | Precio, marca, expectativas | 0,000556 USD |
17:41:05 reddit/search | robot aspirador, newest, 25 | 11 | pocos | Sobre todo comunidades portuguesas | 0,000556 USD |
17:41:21 quora/questions | robot aspirador, último año, 30 | 5 | 0 | Inglés, sin relación, y sí se cobra | 0,001389 USD |
Los 18 comentarios del hilo de r/AskChile muestran por qué vale la pena leer comentarios en español. Quien pregunta tiene un presupuesto de unas 200 «lucas» (200.000 pesos chilenos). La respuesta más concreta recomienda «cualquier Xiaomi que tenga mopa rotatoria». Otra persona dice que entró en una gran tienda en línea y vio «mucha opinión variada», y pide un modelo concreto. Un tercer comentario dice que «es un tema de expectativas»: hay amigos que las consideran malas porque esperan que limpien como una persona. Otro avisa que, si la base no se vacía sola, hay que vaciar el depósito un par de veces al día. Hay incluso un usuario que ofrece vender la suya porque la usó tres veces. En un solo hilo tienes el precio objetivo, la marca de referencia, la tienda donde se compara y la objeción principal. Un equipo de marca en Chile no encuentra eso en una encuesta.
Nuestro consejo práctico para el radar en español: una lista corta de palabras clave en el orden que usa tu mercado («aspiradora robot» en Chile, Colombia o México; «robot aspirador» también se usa en España, pero choca con el portugués), las comunidades nacionales de preguntas (r/AskChile, r/Colombia, r/mexico, r/argentina, r/spain) leídas con reddit/subreddit_posts y filtradas por palabra clave en el título, y la lectura de comentarios de los 3 hilos más activos. Antes de programar la tarea, prueba cada palabra clave por separado, en cada idioma. No traduzcas las palabras del inglés y esperes que funcionen.
Cómo escribir el texto de la tarea
Con estas cifras, el texto de la tarea puede ser estricto. Abajo va un ejemplo de configuración para una tarea programada de ChatGPT. No lo ejecutamos en ChatGPT. Importan tres partes. Cada llamada nombra su plataforma, su acción y sus parámetros, para que el modelo no elija. El informe lista al final las llamadas y su costo. Y cuando una llamada falla o se bloquea, el modelo no reintenta con otros parámetros: anota la llamada prevista para que tú la ejecutes a mano.
Ejecutar cada lunes a las 09:00 (America/Santiago). Usar solo everyinfra_call_api del plugin @EveryInfra. Hacer las llamadas en este orden, sin cambiar parámetros ni añadir llamadas.
1. platform=reddit, action=subreddit_posts, params={subreddit: "RobotVacuums", sort: "top", date_range: "past_week", limit: 100}
2. platform=reddit, action=subreddit_posts, params={subreddit: "AskChile", sort: "top", date_range: "past_week", limit: 100}
3. platform=reddit, action=search, params={keyword: "aspiradora robot", sort: "relevance", limit: 25}
4. platform=quora, action=questions, params={keyword: "robot vacuum", date_range: "past_week_last_7_days", limit: 30}
5. Del paso 1, tomar los 3 posts con mayor comment_count; del paso 3, los 2 con mayor comment_count cuyo título contenga "aspiradora". Para cada uno, llamar platform=reddit, action=comments, params={url: <url del post>, limit: 100}
Salida, en español:
- "Quejas de esta semana": top 5. Resumen de una línea, enlace al post, número de comentarios. Describir el problema; no nombrar a usuarios concretos.
- "Preguntas de esta semana": top 5, mismo formato.
- Comparar con el informe de la semana pasada. Deduplicar por url y por título normalizado. Marcar los temas nuevos.
- Anexo: por cada llamada, filas devueltas, filas que contienen la palabra clave, billing.charged_usd y el total.
Si una llamada falla o se bloquea: no reintentar con otros parámetros. Anotar su platform, action y params en el anexo y seguir.
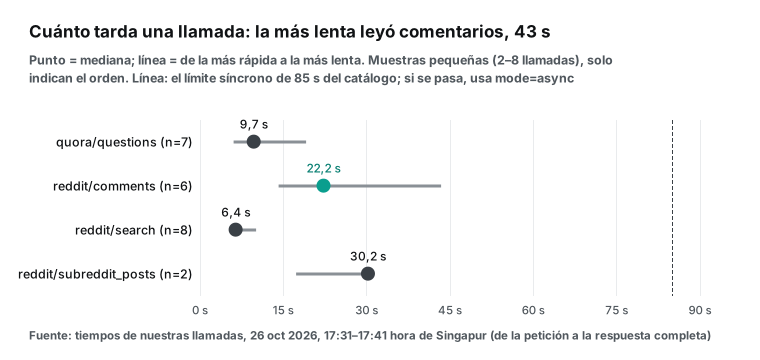
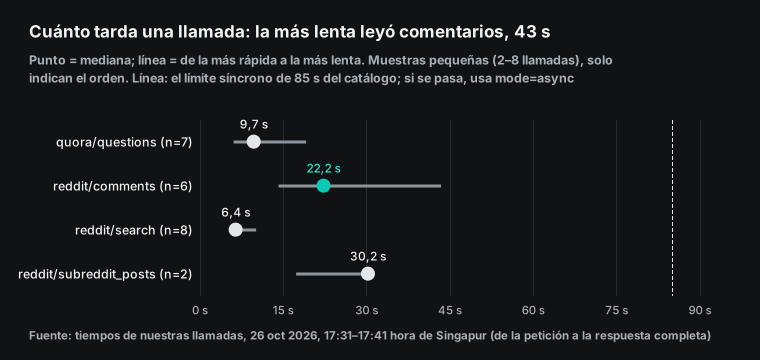
Este ejemplo hace 2 extracciones de comunidad, 1 búsqueda, 1 consulta de Quora y 5 lecturas de comentarios: 9 llamadas. Con los precios del catálogo cuesta 0,005837 USD por semana, algo menos que la receta de 10 llamadas de la sección de costos. El paso 2 lee la comunidad general de preguntas de Chile; el filtro por palabra clave se hace después, en el informe, sin llamadas extra. El paso 5 es la parte más lenta del radar. Nuestras 6 llamadas a reddit/comments entre las 17:33 y las 17:41 (hora de Singapur) tuvieron una mediana de 22,2 segundos, y la más lenta tardó 43,4. ChatGPT no publica un tiempo máximo para una llamada de herramienta. Los ajustes MCP de Codex usan por defecto un tool_timeout_sec de 60 segundos, una referencia útil. Nuestro catálogo fija un presupuesto de 85 segundos para llamadas síncronas. Por encima de eso, añade "mode": "async" al cuerpo de la petición y lee el resultado con everyinfra_get_job.
Un informe de muestra con los datos reales de esta semana
Para mostrar cómo es un buen informe, escribimos una muestra a mano. Usa los 100 posts más votados de la semana de r/RobotVacuums, tres hilos de comentarios, la búsqueda en español y la consulta de Quora de nuestra prueba de las 17:31 a las 17:41 (hora de Singapur). No lo escribió ChatGPT. Muestra qué debe contener un informe semanal y que cada línea debe apuntar a un post real.
| Sección | Elemento (comentarios) | Evidencia |
|---|---|---|
| Queja 1 | Equipos insignia de varias marcas que fallan en la primera semana por problemas eléctricos (hilo de 31) | Comentario de primer nivel en «Anyone HAPPY with their robot after a year?» |
| Queja 2 | Una marca concreta a evitar, con el post más votado de la semana (16 comentarios, 32 puntos) | Título del post |
| Queja 3 | La esquiva de obstáculos no basta para dejar el robot solo en casa (23) | Título y 22 comentarios de primer nivel |
| Queja 4 | La fregona de rodillo deja una franja sin fregar junto a las paredes (20) | Título del post |
| Queja 5 | Sin plan de servicio posventa en Chile para una marca conocida (3 + 3, en dos comunidades) | Dos posts en español |
| Pregunta 1 | «Ayúdenme a convencer a mi pareja de comprar un robot aspirador» (53) | Título |
| Pregunta 2 | ¿Qué zonas sigues limpiando tú aunque tengas robot? (30) | Título y 29 comentarios |
| Pregunta 3 | Comparación de cuatro modelos de gama alta antes de comprar (13) | Título |
| Pregunta 4 | Mejor aspiradora robot por unos 200.000 pesos chilenos (18 + 15) | Dos posts en Chile y 18 comentarios |
| Pregunta 5 | ¿Qué robot aspirador es «bueno, bonito y barato»? (7) | r/Colombia |
Destacan dos puntos. Primero, quejas y preguntas se mezclan mucho. Los hilos con más comentarios parecen preguntas, pero sus comentarios están llenos de quejas; por eso el informe no puede clasificar solo por el título. Los 0,00278 USD de las 5 lecturas de comentarios son el dinero mejor gastado del radar. Segundo, el valor del informe está en el cambio de una semana a otra. Una sola semana muestra temas viejos: duración, obstáculos, fregado y precio. Tras unas semanas, un tema que crece de golpe, como la falta de servicio en un país concreto, es la señal que buscan los equipos de producto y de marketing. Por eso probamos «correr otra vez más tarde: ¿qué cambió?» en una sección posterior.
Cuánto cuesta por semana
Usamos el price_usd del catálogo de capacidades leído a las 17:22 (hora de Singapur) del 2026-10-26. La receta semanal tiene 10 llamadas: 1 reddit/subreddit_posts, 2 reddit/search, 2 quora/questions y 5 reddit/comments.
| Capacidad | Precio por llamada | Llamadas por semana | Subtotal |
|---|---|---|---|
reddit/subreddit_posts | 0,000556 USD | 1 | 0,000556 USD |
reddit/search | 0,000556 USD | 2 | 0,001112 USD |
quora/questions | 0,001389 USD | 2 | 0,002778 USD |
reddit/comments | 0,000556 USD | 5 | 0,002780 USD |
| Total | 10 | 0,007226 USD |
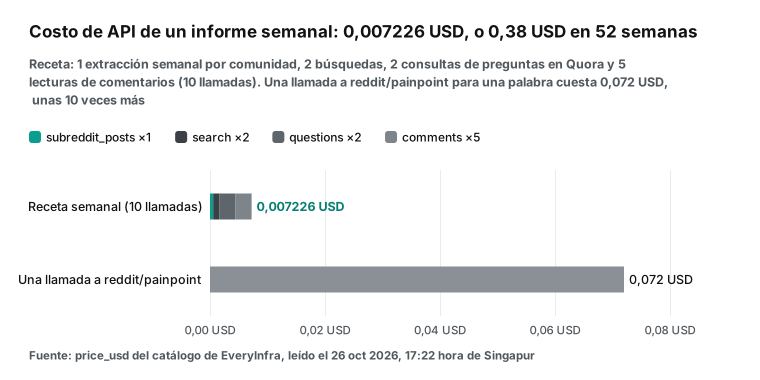
52 semanas cuestan 0,375752 USD. Tres categorías, con un radar cada una, cuestan unos 1,13 USD al año. Los resultados vacíos se reembolsan, así que la cifra real solo puede ser menor. Si quieres un resumen de quejas ya hecho, el catálogo también tiene reddit/painpoint, a 0,072 USD por llamada: busca posts por palabra clave, lee sus comentarios y devuelve el número de comentarios negativos y las palabras frecuentes. Una llamada cuesta lo mismo que 10 semanas de la receta. Úsala una vez para explorar una categoría nueva, no cada semana.
El costo propio de ChatGPT va aparte y no se puede convertir en una cifra semanal. El centro de ayuda dice que Work y Codex comparten una misma estructura de uso. La página de precios de ChatGPT da rangos de mensajes cada 5 horas para Plus (de 15 a 160 con GPT-6.1 Sol) y avisa que tareas parecidas pueden consumir cantidades muy distintas. En un post de r/codex del 2026-10-05, un usuario de Plus contó que su tarea diaria de las 7:00 corrió 13 minutos y consumió el 29 % de su cuota de 5 horas; el soporte de OpenAI le dijo que las tareas programadas corren en Work y comparten la cuota con Codex. A esa escala, el lado de ChatGPT de un radar de demanda pesa mucho más que los 0,007226 USD de la API.
Límites de frecuencia, resultados vacíos y fallos: qué pagas
En esta prueba encontramos cuatro tipos de «sin datos». Los cuatro costaron 0 USD, pero afectan de forma distinta a una tarea programada.
| Caso | Nuestra respuesta real | Cobro | Qué significa para una tarea programada |
|---|---|---|---|
| Sin clave | REST 401 missing_key; MCP devuelve isError: true y nombra las dos formas de enviar la clave | 0 USD | Si a la URL le falta ?key=, el modelo lee un error claro en vez de fallar en silencio |
| Parámetro erróneo | sort: "latest" da 422 con la lista allowed; sort: "newst" da 422 con did_you_mean: ["newest"] | 0 USD | El modelo puede corregirlo, pero un texto estricto nunca llega aquí |
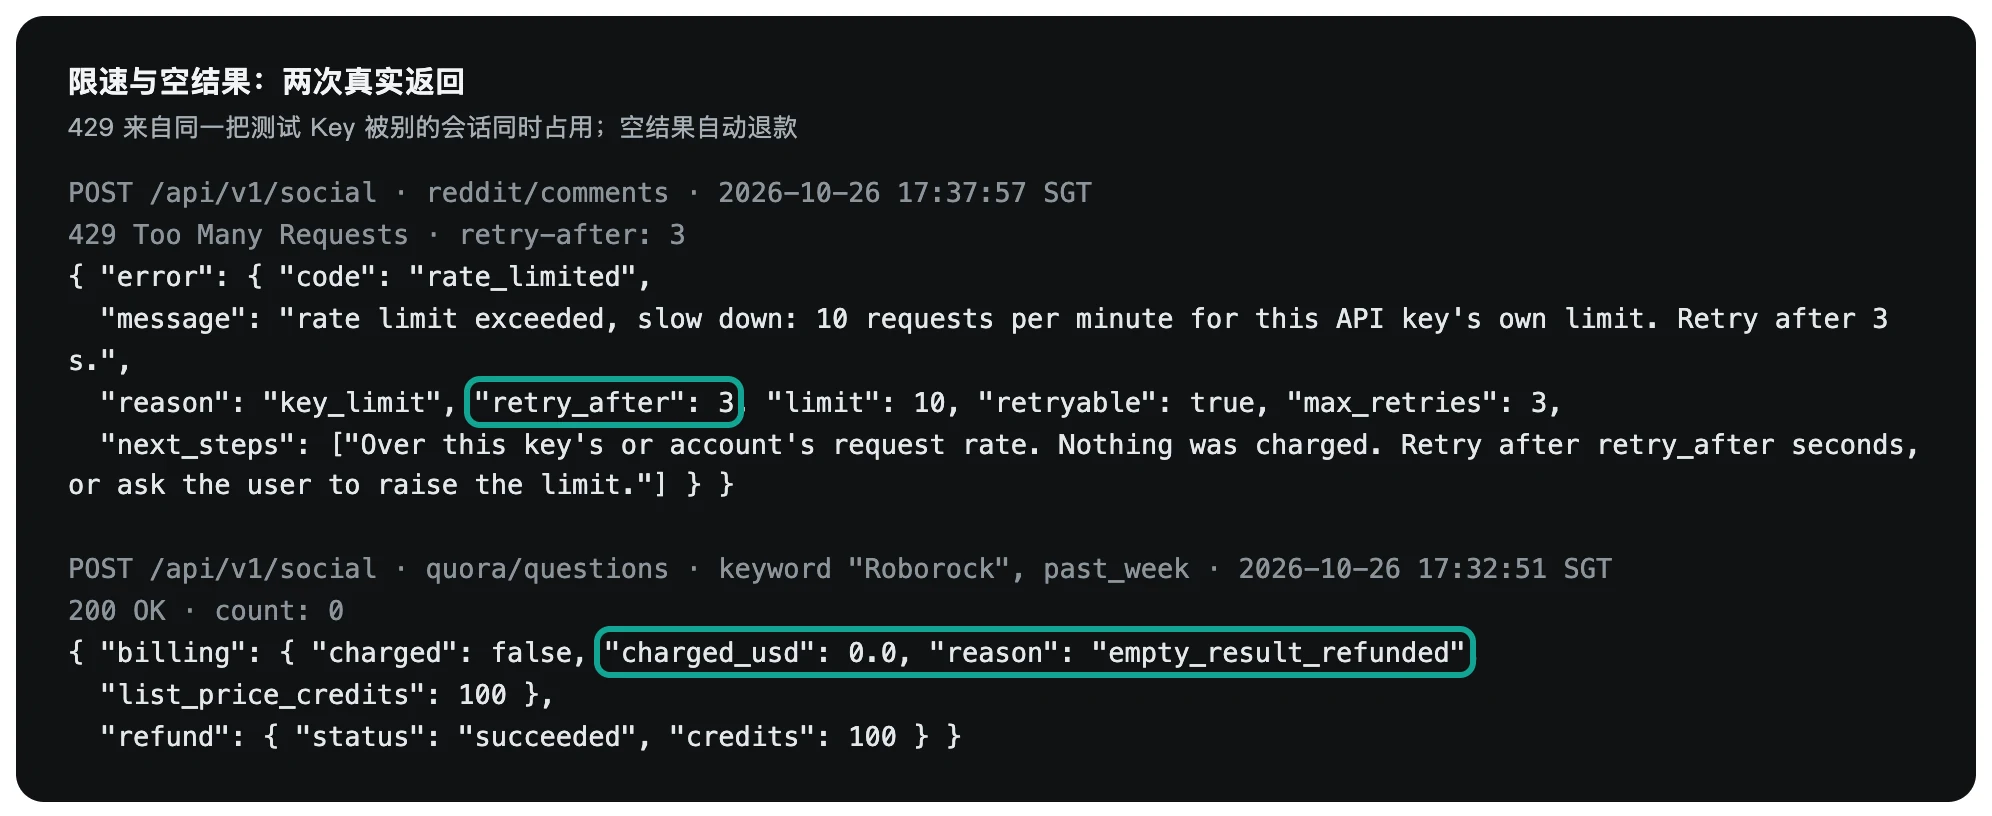
| Límite de frecuencia | 4 respuestas 429 desde las 17:37:57 (hora de Singapur), retry_after 3 s, limit 10 por minuto | 0 USD | Otras sesiones usaban la misma clave de prueba. Deja que el modelo espere unos segundos y reintente |
| Resultado vacío | quora/questions de «aspiradora robot», 0 en un mes, empty_result_refunded | 0 USD | Escribe «sin preguntas nuevas esta semana»; no es un fallo |
Un detalle importa. Topamos 4 veces con el límite porque otras sesiones usaban esta clave de prueba al mismo tiempo. El límite de 10 por minuto es un ajuste de esta clave, no el de las claves de producción. El documento OpenAPI da un límite de cuenta de 60 peticiones por minuto. Un radar hace 10 llamadas, así que normalmente no lo alcanza. Pero si varias tareas de categorías distintas comparten una clave y todas corren el lunes a las 09:00, sí pueden alcanzarlo. Sepáralas unos minutos.
chatgpt scheduled tasks not working: causas comunes y soluciones
En las sugerencias de búsqueda, «not working» es lo primero que aparece después de «chatgpt scheduled tasks». Juntamos los límites de los documentos de OpenAI con informes del foro. Para este trabajo importan nueve causas. Las cinco primeras tienen texto oficial. Las cuatro últimas son informes de usuarios, y las tratamos como tales.
| Síntoma | Causa | Fuente | Solución |
|---|---|---|---|
| La tarea no corrió y aparece «paused» | Una acción que pide aprobación pausa la tarea; las tareas que nadie abre pueden pausarse; borrar o archivar el chat pausa su tarea | Centro de ayuda: Scheduled tasks | Revisa en Scheduled si hay aprobaciones pendientes; abre el informe cada pocas semanas |
| No puedes crear una tarea nueva | Llegaste al límite de tareas activas (3/5/10/15) | La misma | Pausa o borra tareas que no uses |
| Una tarea de Free no llega a su hora | Free usa franjas como mañana o noche, como máximo una vez al día | La misma | Usa un plan de pago para horas exactas |
| La tarea no puede leer los archivos del proyecto | Las tareas creadas en un proyecto no abren sus archivos subidos | La misma | Pon el texto de referencia en la tarea, o en un lugar que lea un conector |
| No puedes crear una tarea en un GPT, en voz o en un chat bloqueado | Las tareas programadas no lo admiten | La misma | Créala en un chat normal o en Work |
| Las escrituras se bloquean (informes de usuarios) | «blocked by OpenAI's safety checks», mientras el mismo texto funciona en un chat normal; los documentos solo dicen que las escrituras piden aprobación | Informes del foro desde el 2026-10-04 | Saca la obtención de datos a un programador externo; ChatGPT solo lee (diseño B) |
| La tarea se desactiva tras una ejecución | Un minuto después de una escritura fallida, la tarea pasa a desactivada | Informe del foro, 2026-10-06 a 2026-10-08 | Igual; revisa el estado de la tarea cada semana |
| Al añadir un MCP propio sale «does not implement OAuth» | Un cortafuegos bloqueó la petición de comprobación, o el servidor no tiene OAuth | Informe del foro, 2026-09-03 | Con EveryInfra, elige «No authentication» |
| La tarea consume mucha cuota de Work | Las tareas programadas corren en Work y comparten la cuota con Codex | r/codex, 2026-10-05; página de precios | Mantén el texto corto y estricto; pide solo un resumen |
Un hilo de ayuda en r/ChatGPT con más de 30 respuestas mezcla varios de estos problemas. A un usuario, su tarea de cada hora dejó de escribir en GitHub y luego se apagó sola. A otro, su tarea de los lunes no apareció en la lista durante tres semanas. Un tercero preguntó por qué una tarea no corrió, y el modelo le respondió que sí había hecho el trabajo pero que él no podía verlo. Ese último caso es el preocupante: lo que un modelo cuenta de lo que hizo no es una prueba. Por eso nuestro texto pide al final del informe una lista de llamadas con su charged_usd. Si una llamada ocurrió, cuántas veces y cuánto costó debe salir de nuestros registros. Cada llamada tiene un request_id en la consola. Otro hilo llama paradoja a la pausa automática: una tarea que funciona bien no necesita atención, pero una tarea que no recibe atención puede pausarse por desuso. Envía el radar de los lunes a un lugar que de verdad leas; eso también es parte de la solución.
Correr otra vez dentro de la hora: cómo deduplicar de una semana a otra
Un radar semanal compara cada lunes con el anterior. Para saber qué cambia entre dos ejecuciones y con qué campo conviene deduplicar, repetimos tres llamadas del primer grupo con los mismos parámetros. Antes de la prueba fijamos la línea «al menos 45 minutos de separación». La primera repetición, de las 18:13:31 a las 18:14:28 (hora de Singapur), quedó entre 38,7 y 42,4 minutos después de la original, por debajo de esa línea; lo anotamos así en el registro de prueba. Por eso hicimos una segunda repetición, de las 18:21:02 a las 18:21:52 (hora de Singapur), entre 46,1 y 50,0 minutos después, que sí cumple la línea. Las 6 llamadas extra costaron 0,003336 USD. Con ellas, la prueba completa suma 38 peticiones, 28 cobradas, por 0,019733 USD.
| Llamada | Original (hora de Singapur) | Filas: original → 1.ª repetición → 2.ª repetición | Nuevas en la 2.ª | Desaparecidas en la 2.ª |
|---|---|---|---|---|
reddit/search robot vacuum, newest, 25 | 17:31:05 | 25 → 25 → 25 | 1 (un post de ofertas) | 1 (el más antiguo) |
reddit/subreddit_posts r/RobotVacuums, top, past_week, 100 | 17:32:11 | 100 → 24 → 100 | 1 (una pregunta nueva sobre umbrales de 3,8 cm) | 1 (el más votado de la semana) |
reddit/subreddit_posts r/PasswordManagers, top, past_week, 100 | 17:35:46 | 20 → 19 → 19 | 0 | 1 |
De la tabla salen tres lecciones. La primera: past_week es una ventana móvil de 168 horas que termina en el momento de la llamada, no una semana de calendario. El post más votado de r/RobotVacuums, «Lol avoid Eureka» con 32 puntos, se publicó el 2026-10-19 a las 10:09 UTC. A las 18:13 (hora de Singapur), es decir, a las 10:13 UTC del 2026-10-26, ya había cumplido 7 días y salió de la ventana. En r/PasswordManagers pasó lo mismo con un post publicado el 2026-10-19 a las 10:06 UTC. Si la tarea corre siempre a la misma hora, cada post cae exactamente en una semana. Si un lunes la tarea corre más tarde (por ejemplo, porque estaba en pausa y la reanudaste), pierdes los posts del borde; si corre antes, verás algunos dos veces.
La segunda lección: deduplica por id o url, no por título. Entre ejecuciones, los posts que se mantienen conservan el mismo id y la misma url, aunque cambien sus puntos y su número de comentarios. Guarda la lista de id de la semana anterior en el informe, o en el archivo del diseño B, y marca como «nuevo» lo que no esté en ella. El título normalizado solo sirve como segundo filtro, para los posts publicados dos veces en comunidades distintas, como el de r/AskChile y r/RepublicadeChile.
La tercera lección es la más inesperada: el número de filas no es estable. Con los mismos parámetros, r/RobotVacuums devolvió 100 filas, luego 24 y luego 100 otra vez, en menos de 50 minutos. Las 24 de la primera repetición eran justo los posts con 5 puntos o más; faltaban los 76 posts con 0 puntos, que entre todos suman 16 comentarios. La respuesta de 24 filas llegó con estado 200 y se cobró igual. Para el radar casi no importa, porque los posts que entran en el informe estaban todos. Pero sí importa si cuentas posts para medir el volumen de la semana. Por eso el anexo del informe debe listar las filas devueltas por llamada: si una extracción de comunidad devuelve menos de la mitad de filas que la semana anterior, repite esa llamada una vez antes de concluir que la comunidad se calmó.
Hay un efecto más, propio de cualquier ranking por votos. Un post publicado el domingo por la noche llega a la ejecución del lunes con pocas horas de votos, y la semana siguiente ya está fuera de la ventana. Así que los posts de los últimos días de la semana tienden a quedar abajo. Si eso te preocupa, añade al informe una lista corta de «posts de las últimas 24 horas con más comentarios», sin llamadas extra: sale de la misma extracción, filtrando por posted_at.
Referencia de campos: cada campo que usa el informe
Comprobamos los campos de estas capacidades uno por uno contra response_fields del catálogo. La tabla solo lista los que usa el radar. Páginas de plataforma y de capacidad: API de datos de Reddit, API de datos de Quora, reddit/search, reddit/subreddit_posts, reddit/comments y quora/questions.
| Capacidad | Campo | Significado | Uso en el radar |
|---|---|---|---|
reddit/search, reddit/subreddit_posts | id, url | ID y enlace del post | Deduplicar y comparar con la semana anterior |
| Las mismas | title, text | Título y cuerpo | Entrada para clasificar |
| Las mismas | community | Nombre de la comunidad sin el prefijo r/ | Ver dónde se concentra la conversación |
| Las mismas | like_count, comment_count | Puntos y número de comentarios | Ordenar posts; elegir qué comentarios leer |
| Las mismas | posted_at | Hora de publicación | Comprobar que el post es de esta semana; lista de las últimas 24 horas |
| Las mismas | flair | Etiqueta del post | Algunas comunidades la usan para «recomendación» o «ayuda» |
reddit/comments | text, like_count, posted_at | Texto, puntos y hora del comentario | Leer el detalle de una queja |
quora/questions | title, url, posted_at | Título, enlace y hora de la pregunta | «Preguntas de esta semana» |
| La misma | answer_count, follower_count | Respuestas y seguidores | Ver si alguien responde |
Las dos capacidades de Reddit también devuelven author_username, pero el radar no lo necesita. La Responsible Builder Policy de Reddit prohíbe inferir rasgos sensibles, como salud o política, a partir de los datos, y prohíbe intentar volver a identificar a los usuarios. La línea «no nombrar a usuarios concretos» del texto de la tarea existe por eso. Para detectar el post duplicado de Chile basta con comparar author_username dentro del cálculo, sin escribirlo en el informe.
Los mismos datos sin ChatGPT
Para el programador de tareas del diseño B, o para mirar los datos a mano primero, llama a la API REST. Los parámetros son los mismos que en MCP, sin el envoltorio JSON-RPC:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"search",
       "params":{"keyword":"aspiradora robot","sort":"relevance","limit":25}}'
A las 17:38:05 (hora de Singapur) esta petición devolvió 8 posts en 6,1 segundos y costó 0,000556 USD. El catálogo da un max_limit por capacidad: reddit/search es 25 (los valores mayores se recortan a 25); reddit/subreddit_posts y reddit/comments, 100; quora/questions, 200. El cobro es por llamada, no por fila, así que un limit completo dentro del tope da más datos por el mismo dinero. Los primeros pasos completos están en el inicio rápido. Sobre MCP en general, mira nuestra prueba de aceptación del MCP remoto y la página del servidor MCP.
Dónde deja de funcionar este enfoque
Primero, no probamos ningún comportamiento de ChatGPT. Solo podemos escribir lo que decían los documentos el 2026-10-26. OpenAI cambia a menudo las reglas de planes y permisos (casi todas las páginas del centro de ayuda que citamos mostraban «actualizado hace unas horas»), así que vuelve a comprobarlas antes de depender de ellas. Segundo, dos páginas de OpenAI no coinciden sobre si Pro puede llamar a la herramienta de datos: las preguntas frecuentes del centro de ayuda dicen que el MCP propio de Pro solo tiene permisos read/fetch, y la guía para desarrolladores dice que admite lectura y escritura, con aprobación para las escrituras. Seguimos la guía para desarrolladores y no probamos Pro. Tercero, nuestras reglas de preguntas y quejas son un filtro previo. Una muestra de 20 o 100 posts dice que hay «muchas», no qué proporción. Para proporciones, corre varias semanas y revisa muestras a mano cada semana. Cuarto, Reddit deja de ofrecer RSS el 2026-11-13 y piensa cerrar su API pública antes de marzo de 2027 (TechCrunch, 2026-09-30; original en el post de r/modnews). Un radar basado en RSS tiene que cambiar; explicamos cómo sustituir el seguimiento por RSS de Reddit. Quinto, el radar dice de qué habla la gente, no qué tamaño tiene un mercado. Los usuarios de Reddit y Quora no son todos compradores, y en América Latina Reddit pesa menos que otras redes. Contrasta lo que encuentres con tus datos de ventas y de atención al cliente.
Cambios recientes
- 2026-08-25: las tareas programadas pueden responder a eventos de apps y compartirse (notas de versión de ChatGPT). Plus y Pro pueden iniciar tareas de Work ante mensajes nuevos de Gmail o Slack o cambios en pull requests de GitHub; Free puede tener 3 tareas activas. Para ti: un radar por horario no cambia, pero puedes compartir un radar terminado con un compañero que conecte sus propias apps.
- 2026-09-29: los plugins compatibles pueden iniciar automatizaciones desde eventos MCP (mismas notas; página para desarrolladores: MCP Events). Necesita MCP 2.0 (versión de protocolo 2026-07-28) y que el servidor envíe eventos por webhook. Para ti: EveryInfra es una API de consulta y no envía eventos; para «avísame de posts nuevos» sigues consultando por horario.
- 2026-10-01: el MCP propio ya no necesita modo desarrollador (respuesta del personal de OpenAI en el foro). Los servidores se añaden desde la página Plugins y el permiso del espacio cambió de nombre. Para ti: las guías antiguas que piden buscar un interruptor «Developer mode» están desfasadas.
- Desde el 2026-10-04: informes de usuarios sobre escrituras bloqueadas en tareas programadas (foro oficial; OpenAI aún no ha respondido). Las lecturas no se ven afectadas. Para ti: los documentos dicen que las escrituras piden aprobación y después se ejecutan, pero para una herramienta que gasta dinero o cambia datos sin nadie mirando, sacarla de ChatGPT es la opción más estable.
- 2026-09-30: Reddit anuncia el fin del RSS el 2026-11-13 y el registro de apps antes del 2027-01-12 (r/modnews). Para ti: un radar que sigue comunidades por RSS debe cambiar antes del 13 de noviembre.
- 2026-10-26: las claves de EveryInfra pueden tener un tope de gasto en USD (
spend_limit_usdykey_spend_limit_reacheden el documento OpenAPI). Para ti: limita la clave antes de ponerla en una URL de ChatGPT.
Preguntas frecuentes
¿chatgpt tasks y chatgpt scheduled tasks son lo mismo? Sí, son dos nombres de una misma función. La interfaz antigua decía «Tasks». Hoy el título del centro de ayuda es «Scheduled tasks in ChatGPT», y la entrada es la página Scheduled de la barra lateral. Admite tareas únicas, recurrentes y de seguimiento. Fuente: las sugerencias de búsqueda muestran «chatgpt tasks» junto a «chatgpt scheduled tasks» (leídas el 2026-10-26); centro de ayuda.
chatgpt scheduled tasks not working: ¿qué reviso primero? Abre la página Scheduled y busca «paused» o una aprobación pendiente. El centro de ayuda dice que una acción que pide aprobación pausa la tarea y que las tareas que nadie abre pueden pausarse. Luego mira si creaste la tarea en un proyecto, un GPT, un chat de voz o un chat bloqueado. Si la tarea escribe datos, busca «blocked by OpenAI's safety checks» en la ejecución (un caso que han informado usuarios del foro). Fuente: sugerencias «chatgpt scheduled tasks not working» y «chatgpt scheduled tasks not showing»; centro de ayuda; informe del foro.
¿Un chatgpt custom mcp connector todavía necesita el modo desarrollador? No. Desde el 2026-10-01, abre Plugins, pulsa «+» y elige «Add custom MCP server». En un espacio Business, solo administradores y propietarios pueden crearlo. En Enterprise y Edu, los administradores conceden el permiso por rol. Fuente: sugerencia «chatgpt custom mcp connectors»; respuesta del personal de OpenAI; centro de ayuda.
¿Cuál es el límite de chatgpt scheduled tasks? Tareas activas: 3 en Free y Go, 5 en Plus, 10 en Business y Edu, 15 en Pro y Enterprise. Los planes de pago pueden repetir cada hora; Free, como máximo una vez al día. Las tareas por eventos pueden correr hasta 30 veces por hora y 720 por día entre todas. Fuente: sugerencia «chatgpt scheduled tasks limit»; centro de ayuda.
¿Puede ChatGPT llamar a las herramientas de datos de EveryInfra si no están marcadas como de solo lectura? Sí. La guía para desarrolladores de OpenAI dice que ChatGPT admite herramientas de lectura y de escritura. Una herramienta sin readOnlyHint cuenta como escritura, y las escrituras piden aprobación por defecto: la primera llamada de cada chat muestra un aviso, eliges permitir y puedes recordarlo en ese chat. Un chat nuevo vuelve a preguntar. En una tarea programada no hay nadie para aprobar y la tarea se pausa; ejecútala una vez a mano en un chat normal antes de programarla. Fuente: Add custom MCP server; nuestras lecturas de tools/list del 2026-10-26 a las 17:23 y a las 20:04 (hora de Singapur).
¿Qué autenticación elijo para EveryInfra en ChatGPT? Elige «No authentication» y pon la clave en la URL con ?key=. No publicamos metadatos OAuth y las tres rutas de descubrimiento dan 404, así que OAuth falla. Usa una clave aparte, con capacidades limitadas y un tope de gasto en USD. Fuente: nuestra comprobación del 2026-10-26 a las 17:42 (hora de Singapur); página para desarrolladores sobre autenticación.
¿Cuánto cuesta un radar de demanda semanal? La tarifa de API de 10 llamadas es 0,007226 USD por semana, unos 0,38 USD al año. Los resultados vacíos se reembolsan. El plan de ChatGPT y el consumo de Work van aparte. Fuente: nuestro cálculo con los price_usd del catálogo de capacidades del 2026-10-26; los cobros reales coincidieron con el catálogo.
¿Sirve el radar para comunidades en español? Sí, con dos ajustes. Prueba cada palabra clave en el orden que usa tu mercado («aspiradora robot» trajo Chile, Colombia y Argentina; «robot aspirador» trajo sobre todo Portugal) y deja Quora para la versión en inglés, porque en español no devolvió nada útil. Fuente: nuestras llamadas del 2026-10-26 entre las 17:38 y las 17:41 (hora de Singapur).
Lecturas relacionadas
- Un informe diario en n8n que llama a EveryInfra: prueba del programador 2.45
- Aceptación del MCP remoto: de «herramientas encontradas» a «de verdad usable»
- Reddit cierra el RSS el 13 de noviembre: cómo cambiar tu seguimiento
- Por qué los comentarios de Reddit parecen incompletos
- Seguimiento de reputación en varias plataformas
- Investigación de quejas en Reddit: reddit/painpoint
- Precios
Referencias
- Scheduled tasks in ChatGPT, OpenAI Help Center, leído el 2026-10-26, <https://help.openai.com/en/articles/10291617-scheduled-tasks-in-chatgpt>
- ChatGPT Work and Codex, OpenAI Help Center, leído el 2026-10-26, <https://help.openai.com/en/articles/20001275>
- ChatGPT release notes (entradas del 2026-08-25, 2026-09-29 y 2026-10-20), OpenAI Help Center, <https://help.openai.com/en/articles/6825453-chatgpt-release-notes>
- Connecting custom MCP servers in ChatGPT, OpenAI Help Center, leído el 2026-10-26, <https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt>
- Managing app permissions in ChatGPT, OpenAI Help Center, <https://help.openai.com/articles/20001495>
- Connected apps in ChatGPT, OpenAI Help Center, <https://help.openai.com/en/articles/11487775-apps-in-chatgpt>
- About ChatGPT Pro tiers, OpenAI Help Center, <https://help.openai.com/articles/9793128>
- What is ChatGPT Plus?, OpenAI Help Center, <https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus>
- What is ChatGPT Go?, OpenAI Help Center, <https://help.openai.com/en/articles/11989085-what-is-chatgpt-go>
- ChatGPT Business release notes (tareas de equipo, 2026-09-29), OpenAI Help Center, <https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes>
- ChatGPT Enterprise and Edu release notes, OpenAI Help Center, <https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes>
- Regression: Scheduled Tasks safety checks block authorized Gmail sends and Google Sheets writes, OpenAI Developer Community, 2026-10-04 (informe de usuario), <https://community.openai.com/t/1403242>
- Developer Mode missing from Security & Login on ChatGPT Pro (respuesta del personal de OpenAI, 2026-10-01), OpenAI Developer Community, <https://community.openai.com/t/1402157>
- Feature Request: Use an Identifiable User-Agent for Custom MCP Server Validation, OpenAI Developer Community, 2026-09-03 (informe de usuario), <https://community.openai.com/t/feature-request-use-an-identifiable-user-agent-for-custom-mcp-server-validation/1394731>
- ChatGPT Scheduled Tasks fail to write to GitHub and automatically disable themselves, OpenAI Developer Community, 2026-10-08 (informe de usuario), <https://community.openai.com/t/chatgpt-scheduled-tasks-fail-to-write-to-github-and-automatically-disable-themselves-after-failed-executions-without-user-authorization/1404882>
- Connect and test your plugin, OpenAI Developers, <https://developers.openai.com/plugins/deploy/connect-chatgpt>
- Authentication, OpenAI Developers, <https://developers.openai.com/plugins/build/auth>
- Define tools (Plan safety annotations), OpenAI Developers, <https://developers.openai.com/plugins/plan/tools>
- Build an MCP server, OpenAI Developers, <https://developers.openai.com/plugins/build/mcp-server>
- Plugin UI changelog (App permission controls, 2026-06-12), OpenAI Developers, <https://developers.openai.com/plugins/changelog>
- MCP Events, OpenAI Developers, <https://developers.openai.com/plugins/build/mcp-events>
- Scheduled tasks (Codex), OpenAI Developers, <https://developers.openai.com/codex/app/automations>
- MCP and Connectors (Responses API), OpenAI Developers, <https://developers.openai.com/api/docs/guides/tools-connectors-mcp>
- Model Context Protocol, ChatGPT Learn, <https://learn.chatgpt.com/docs/extend/mcp>
- Pricing (ChatGPT Work and Codex), ChatGPT Learn, <https://learn.chatgpt.com/docs/pricing>
- Schema Reference: ToolAnnotations, Model Context Protocol 2025-11-25, <https://modelcontextprotocol.io/specification/2025-11-25/schema#toolannotations>
- Authorization, Model Context Protocol 2025-11-25, <https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization>
- RFC 6750: The OAuth 2.0 Authorization Framework: Bearer Token Usage, IETF, octubre de 2012, <https://www.rfc-editor.org/rfc/rfc6750>
- RFC 9728: OAuth 2.0 Protected Resource Metadata, IETF, <https://datatracker.ietf.org/doc/html/rfc9728>
- MCP Inspector, Model Context Protocol, <https://modelcontextprotocol.io/docs/tools/inspector>
- Continuing our infrastructure updates: What's changing in the coming months, r/modnews, 2026-09-30, <https://www.reddit.com/r/modnews/comments/1wubgvt/continuing_our_infrastructure_updates_whats/>
- Reddit is killing RSS feeds and ending public API access because of AI bots, TechCrunch, 2026-09-30 (secundaria; original en 31), <https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/>
- Responsible Builder Policy, Reddit Help, <https://support.reddithelp.com/hc/en-us/articles/42728983564564-Responsible-Builder-Policy>
- Scheduled tasks failing, r/ChatGPT (hilo de usuarios), <https://www.reddit.com/r/ChatGPT/comments/1x049yo/scheduled_tasks_failing/>
- Isn't this kind of a paradox for scheduled tasks?, r/ChatGPT (hilo de usuarios), <https://www.reddit.com/r/ChatGPT/comments/1wvnhp8/isnt_this_kind_of_a_paradox_for_scheduled_tasks/>
- Did ChatGPT Scheduled Tasks recently start consuming your Codex/Work usage allowance?, r/codex, 2026-10-05 (informe de usuario), <https://www.reddit.com/r/codex/comments/1wxxqwh/did_chatgpt_scheduled_tasks_recently_start/>
- Automate work with scheduled tasks, Claude Code Docs, <https://code.claude.com/docs/en/routines>
- ChatGPT Scheduled Tasks: What They Are and How to Use Them, Zapier, 2026-09-02 (secundaria), <https://zapier.com/blog/chatgpt-scheduled-tasks/>
- ChatGPT MCP: Connect MCP Servers to ChatGPT, AnythingMCP, 2026-09-25 (secundaria), <https://anythingmcp.com/guides/clients/chatgpt>
- Catálogo de capacidades de EveryInfra, leído el 2026-10-26, 17:22 hora de Singapur, <https://api.everyinfra.com/api/v1/social/catalog>
- Documento OpenAPI de EveryInfra, leído el 2026-10-26, 17:42 hora de Singapur, <https://api.everyinfra.com/openapi.json>
- Comunidad r/AskChile, <https://www.reddit.com/r/AskChile/>
- Add custom MCP server (sección «Reviewing and confirming tool calls»), OpenAI Developers, leído el 2026-10-26, 20:05 hora de Singapur, <https://developers.openai.com/api/docs/guides/custom-mcp-server>
Referencia BL-55