Alternativa a Apify Google Search Scraper: precio por 1000 páginas, medido desde México
1000 páginas de resultados cuestan 4,50 USD en Apify Free y 1,80 USD en Business. Solo resultados orgánicos, nuestra prueba desde México costó 0,694 USD.
La respuesta corta: por 1000 páginas de resultados orgánicos, el plan Free del scraper oficial de Apify cuesta 6,5 veces lo que nos costó EveryInfra en la prueba, y el plan Business cuesta 2,6 veces. Pero una página de Apify trae además PAA y búsquedas relacionadas, que nosotros no damos, y en Apify Store hay tres scrapers de terceros más baratos que nosotros.
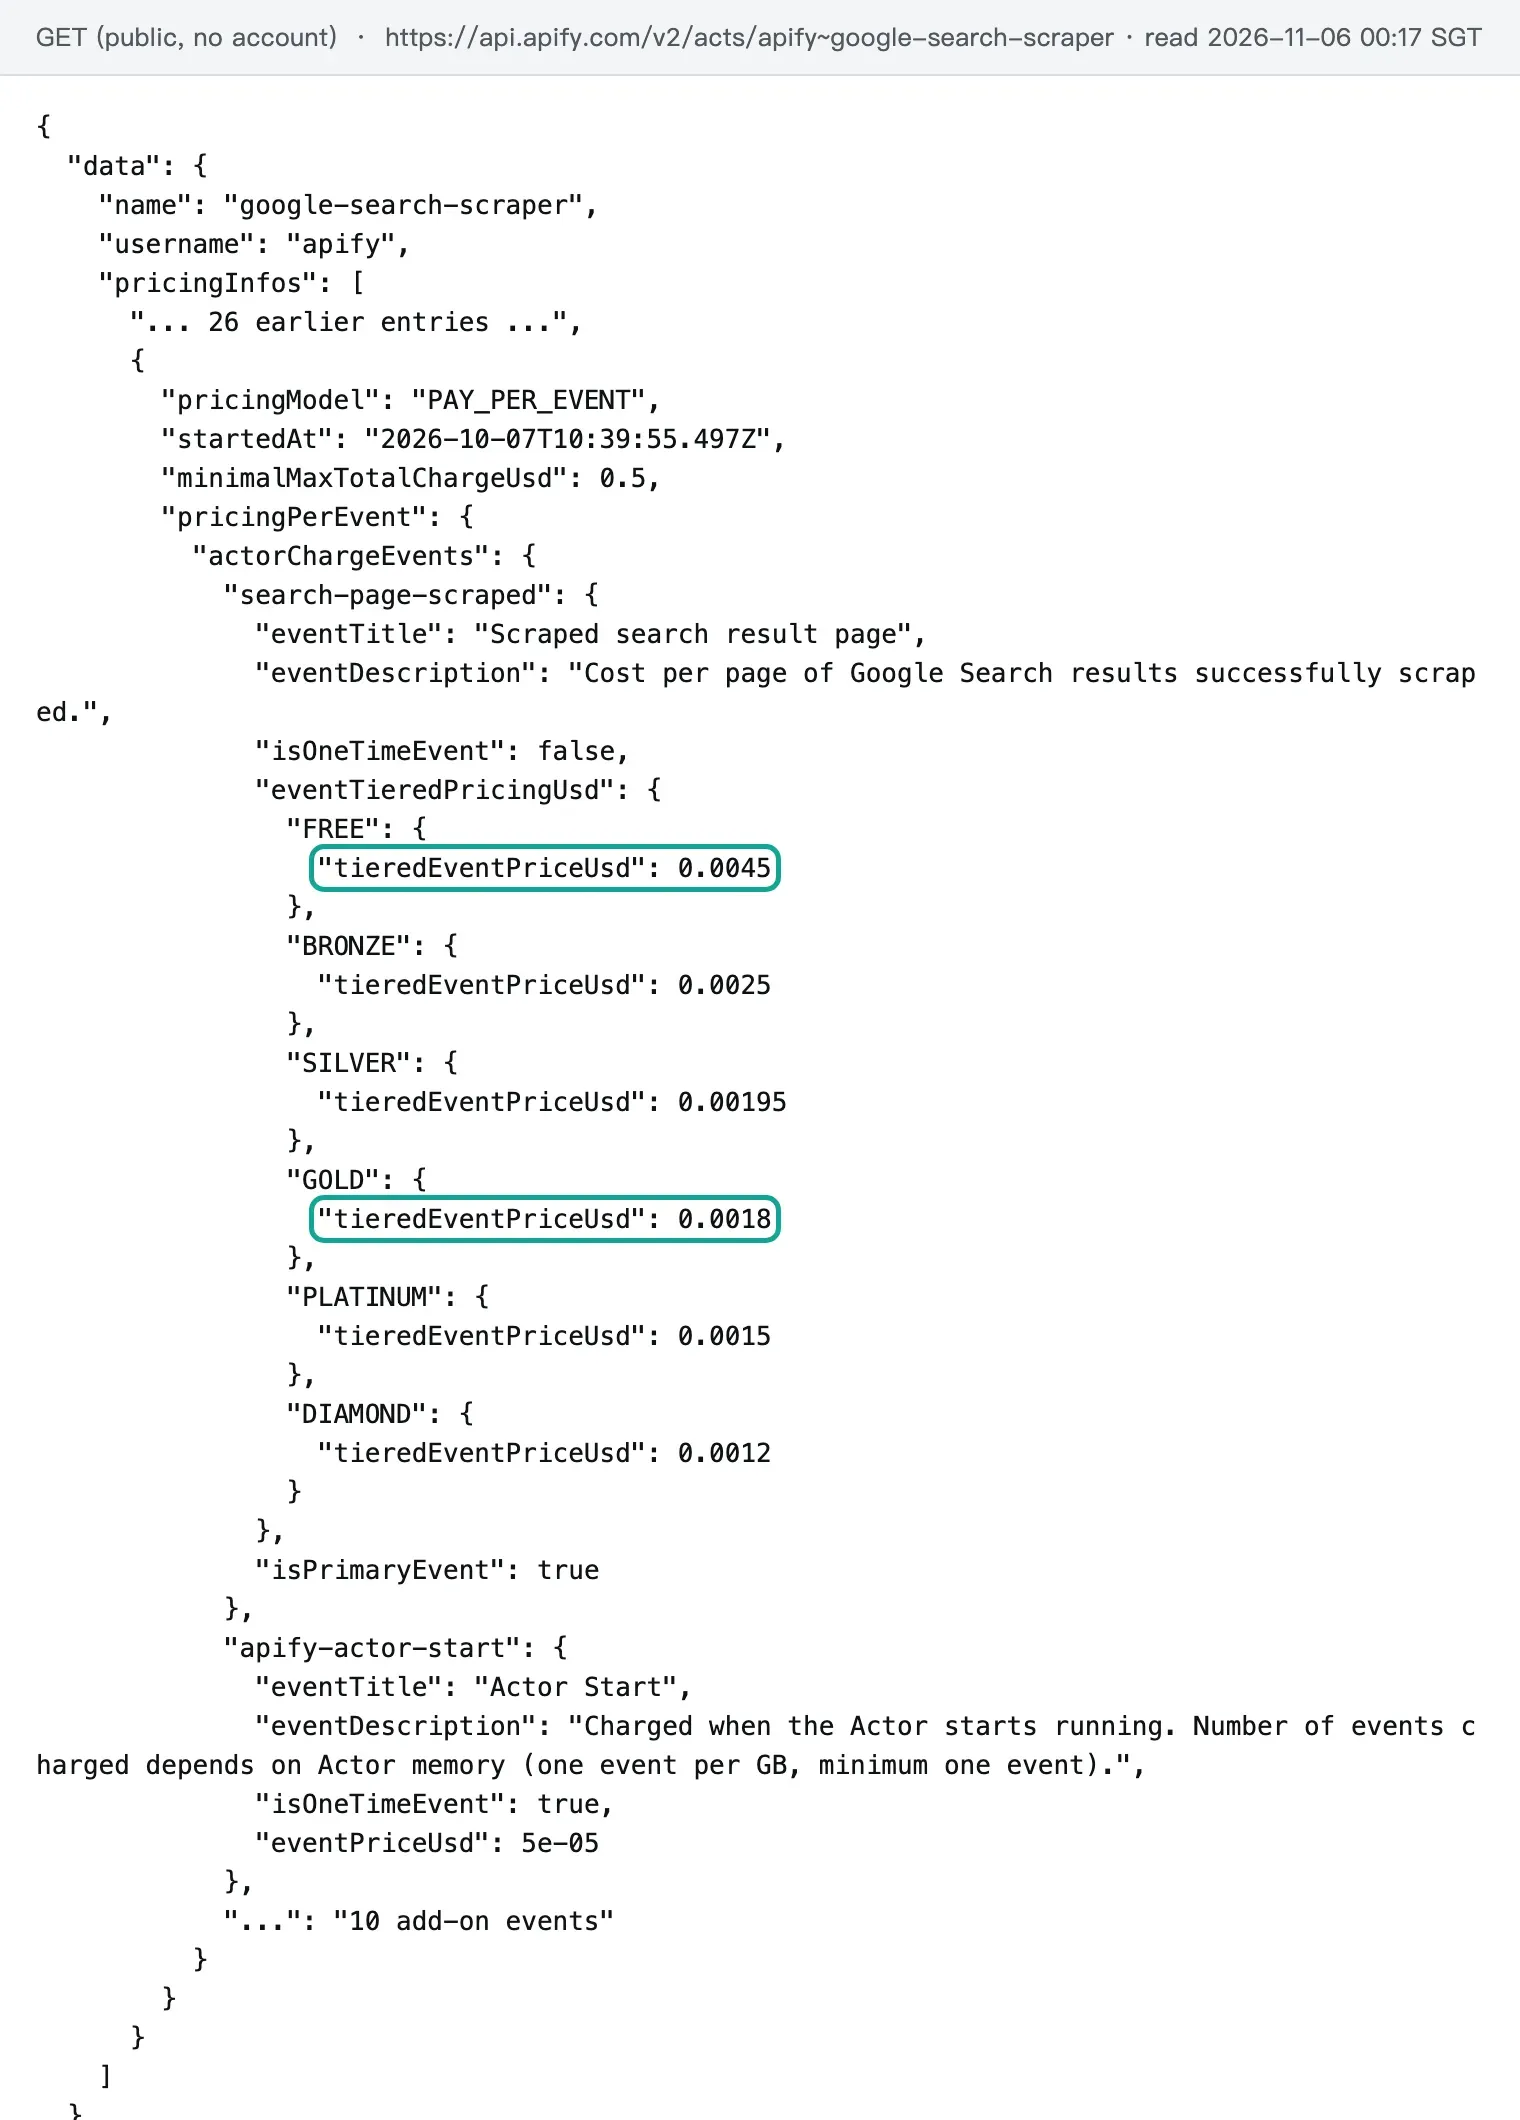
Si buscas en Google «apify google search scraper», casi siempre quieres saber una cosa: cuánto vas a pagar por cada página de resultados. Leímos los precios públicos el 5 de noviembre de 2026 a las 16:17 UTC (00:17 del 6 de noviembre, hora de Singapur). El scraper oficial de Apify cobra 4,50 USD por 1000 páginas en el plan Free, 2,50 USD en Starter (19 USD al mes) y 1,80 USD en Business (999 USD al mes).
Esa misma noche hicimos 18 llamadas reales a EveryInfra. Una de ellas fue una búsqueda en español con ubicación México: «mejores tenis para correr pie plano». Cada página de búsqueda web nos costó 0,000694 USD, es decir, 0,694 USD por 1000 páginas. Apify Free cuesta 6,5 veces esa cifra y Apify Business, 2,6 veces.
Hay dos límites claros. Una página de Apify incluye también las preguntas «Otras preguntas de los usuarios» (People Also Ask, PAA) y las búsquedas relacionadas. Nosotros devolvemos solo título, URL, fragmento y fecha. Además, en Apify Store hay tres scrapers de terceros que cuestan entre 0,45 USD y 0,60 USD por 1000 páginas, menos que nosotros. En este artículo comparamos precio, campos, filtros de país e idioma, cobro de errores, velocidad y uso con agentes de IA. Cuando Apify conviene más, lo decimos.
Primero, una precisión sobre la unidad. El evento principal del scraper oficial de Apify se llama «Scraped search result page» y cobra por página. La búsqueda web de EveryInfra cobra por llamada, y cada llamada devuelve una página de hasta 10 resultados. Por eso las dos cifras se comparan directo, sin conversión.
Del lado de Apify usamos solo material público: la página de Store, la página de precios, la documentación y el endpoint público api.apify.com/v2/acts/<id>, que no pide cuenta. No abrimos cuenta en Apify ni ejecutamos sus actors (así llama Apify a sus programas de scraping en la nube). Los números de Apify son precios de lista, no facturas nuestras. Los números de EveryInfra salen del campo charged_usd de cada respuesta real.
Una cosa más. La búsqueda web de EveryInfra es una búsqueda web general. El catálogo de herramientas lista sus parámetros. Comparamos el costo de lo mismo: una página de 10 resultados web con título, URL y fragmento. No afirmamos que las dos herramientas devuelvan la misma página de Google.
Tabla resumen: apify google search scraper frente a EveryInfra en 1000 páginas
El scraper oficial tiene seis niveles de precio. Free, Bronze, Silver y Gold corresponden a los planes Free, Starter, Scale y Business. Platinum y Diamond son solo para empresas. La documentación de Actors in Store explica que el plan define el nivel de descuento. Los precios unitarios salen del campo pricingInfos del endpoint público, con la entrada vigente desde el 7 de octubre de 2026.
| Opción | Unidad de cobro | Por 1000 páginas | Veces el precio de EveryInfra `web` | Qué trae una página |
|---|---|---|---|---|
| Apify oficial, Free | 0,0045 USD por página | 4,50 USD | 6,5 | Resultados orgánicos, PAA, búsquedas relacionadas. Anuncios y AI Overview aparte |
| Apify oficial, Starter (Bronze) | 0,0025 USD por página | 2,50 USD | 3,6 | Igual |
| Apify oficial, Scale (Silver) | 0,00195 USD por página | 1,95 USD | 2,8 | Igual |
| Apify oficial, Business (Gold) | 0,0018 USD por página | 1,80 USD | 2,6 | Igual |
| Apify oficial, Diamond (empresas) | 0,0012 USD por página | 1,20 USD | 1,7 | Igual |
EveryInfra búsqueda web | 0,000694 USD por llamada | 0,694 USD | 1 (base) | Título, URL, fragmento, fecha, hasta 10 resultados |
EveryInfra API de datos web/search | 0,001389 USD por llamada | 1,389 USD | 2 | Añade el campo rank |
EveryInfra web + suggest | 0,001388 USD por dos llamadas | 1,388 USD | 2 | Orgánicos más 10 sugerencias, sin PAA |
| Tercero más barato en Store (tercero F) | 0,00045 USD por página | 0,45 USD | 0,65 (35 % menos) | Orgánicos, PAA, búsquedas relacionadas, anuncios |
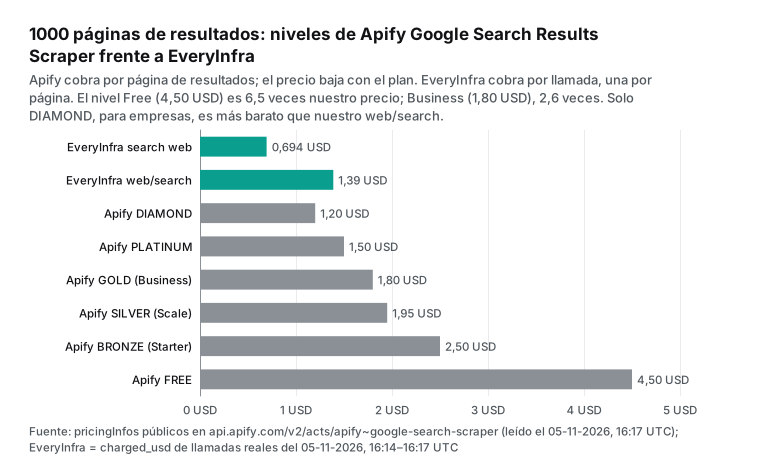
Lee la tabla con tres ideas en mente. La primera: el plan decide el precio en Apify. Entre Free y Business hay 2,5 veces de diferencia, y Business pide una cuota de 999 USD al mes, según la página de precios de Apify. Un freelancer o una agencia pequeña en Guadalajara o Bogotá casi siempre está en Free o Starter. Para ellos, Apify cuesta de 3,6 a 6,5 veces nuestro precio, no 2,6 veces.
La segunda: nuestras dos entradas difieren el doble. Para la misma consulta, la herramienta web de /api/v1/search costó 0,000694 USD. La capacidad web/search de /api/v1/social costó 0,001389 USD. Lo que se paga de más es el campo rank y el formato común de la API de datos, con modo asíncrono y el mismo cuerpo de petición que las 106 plataformas de nuestro catálogo. Si solo necesitas resultados web, usa la entrada barata.
La tercera: la última fila es un aviso honesto. Si solo miras el precio, Apify Store tiene scrapers más baratos que nosotros. Más abajo los revisamos uno por uno.
Precio de Apify Google Search Results Scraper: por página, seis niveles y diez extras
En Store, el scraper oficial se llama Google Search Results Scraper. Es la herramienta de búsqueda de Google más usada de la tienda. El endpoint público muestra 227 822 usuarios en total, unos 27 000 en los últimos 30 días y 11 769 en los últimos 7. Tiene 218 reseñas con una media de 4,65 y 134 millones de ejecuciones acumuladas. La versión más reciente, 0.0.476, salió el 2 de noviembre de 2026.
La etiqueta de la pestaña Pricing dice «from $1.80 / 1,000 scraped search result pages». O sea, la cifra que se ve primero es la de Business. Un usuario de Free paga 2,5 veces esa cifra.
El modelo es de pago por evento. El evento principal cobra por cada página de resultados que se extrae con éxito. Un evento de inicio cobra 0,00005 USD por GB de memoria. Con la memoria por defecto de 1 GB, eso es casi nada por ejecución. El README dice que cada página trae unos 10 resultados. Para obtener 100 resultados hay que poner maxPagesPerQuery en 10. Así que 1000 páginas equivalen a unos 10 000 resultados orgánicos.
Además del evento principal, el scraper tiene diez eventos extra. Cada uno se cobra solo si activas su opción. Aquí las diferencias entre niveles son mucho más grandes.
| Evento extra (por 1000) | Free | Starter | Scale | Business | Cuándo se cobra |
|---|---|---|---|---|---|
| Página de resultados (principal) | 4,50 USD | 2,50 USD | 1,95 USD | 1,80 USD | Cada página extraída |
| Anuncios | 6,50 USD | 5,00 USD | 4,00 USD | 3,50 USD | Cada página con la opción activa, haya o no anuncios |
| AI Overview completo | 3,00 USD | 2,00 USD | 1,50 USD | 1,00 USD | Cada consulta con AI Overview |
| Google AI Mode | 200 USD | 5,00 USD | 3,00 USD | 2,00 USD | Cada respuesta |
| ChatGPT, Copilot o Gemini | 200 USD | 5,00 USD | 4,00 USD | 3,00 USD | Cada respuesta |
| Perplexity | 200 USD | 13,00 USD | 10,00 USD | 9,00 USD | Cada respuesta |
| Página completa del sitio | 8,00 USD | 5,00 USD | 4,00 USD | 3,00 USD | Cada sitio de resultado extraído |
| Contactos de empresas | 100 USD | 5,00 USD | 5,00 USD | 4,00 USD | Cada contacto |
Hay un dato fácil de pasar por alto. Los cinco extras de búsqueda con IA cuestan 0,20 USD por respuesta en Free. En Starter cuestan de 0,005 a 0,013 USD: el precio de Free es de 15 a 40 veces el de Starter. La guía de precios de Apify para desarrolladores comenta este patrón. Dice que los precios altos en FREE impiden probar con suficientes datos y que solo tienen sentido contra el fraude o para cubrir costos de terceros, como llamadas a modelos de lenguaje, según Actor pricing and costs.
En la práctica, con una cuenta Free, 100 respuestas de IA cuestan 20 USD. Eso es cuatro veces el crédito gratis de 5 USD al mes. Pon un límite de gasto antes de probarlas.
Los anuncios también piden cuidado. La opción cobra por página, no por anuncio encontrado. Con la opción activa, una página en Free cuesta 11,00 USD por 1000 en lugar de 4,50 USD.
Los dos lados controlan el gasto de forma distinta. En Apify, el control es el parámetro maxTotalChargeUsd del endpoint que ejecuta un actor y devuelve su dataset. Sirve para poner un tope al gasto total de esa ejecución, según Run Actor synchronously and get dataset items.
EveryInfra no tiene un tope por ejecución porque cada llamada es una página a precio fijo. Una llamada nunca cuesta más de 0,000694 USD. El gasto total lo controlas con el saldo: la recarga mínima es de 10 USD y el saldo no vence, según nuestra página de precios.
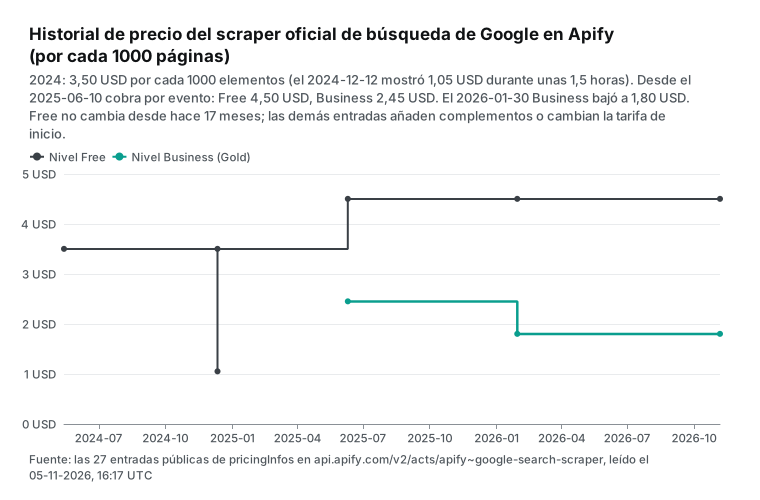
El endpoint público guarda también el historial: 27 entradas de precio. En mayo de 2024 el scraper cobraba 3,50 USD por 1000 elementos del dataset, y cada elemento era una página. El 12 de diciembre de 2024 una entrada mostró 1,05 USD, y hora y media después volvió a 3,50 USD. El 10 de junio de 2025 pasó al pago por evento, con Free en 4,50 USD y Business en 2,45 USD. El 30 de enero de 2026 Business bajó a 1,80 USD.
Las entradas siguientes añaden sobre todo extras: Copilot el 4 de mayo, Gemini el 14 de mayo, páginas completas el 22 de junio y AI Overview completo el 26 de junio de 2026. La tarifa de inicio bajó de 0,002 a 0,001 USD el 4 de marzo de 2026. El 7 de octubre de 2026 cambió a 0,00005 USD por GB. En 17 meses el precio de Free no bajó ni una vez. Todas las rebajas fueron para los planes de pago.
Qué trae cada página: los campos lado a lado
Comparar precios sin comparar campos es pesar dos cosas distintas en la misma báscula. El scraper oficial de Apify devuelve un registro por página. El ejemplo del README incluye searchQuery, organicResults, paidResults, paidProducts, peopleAlsoAsk, relatedQueries y aiModeResult. La búsqueda web de EveryInfra devuelve una lista de resultados con título, URL, fragmento y fecha. El campo location te dice si el país se aplicó y a qué nivel.
| Campo | Apify oficial | EveryInfra `web` | EveryInfra `web/search` |
|---|---|---|---|
| Título y URL orgánicos | Sí | Sí (title, url) | Sí (title, url) |
| Fragmento | Sí (description) | Sí (snippet) | Sí (text) |
| Fecha | Sí (date, si aparece) | Sí (published, si aparece) | Sí (published_at) |
| Posición | Sí (position) | No, usa el orden de la lista | Sí (rank) |
| Enlaces de sitio | Sí | No | sub_links en el catálogo |
| Otras preguntas de los usuarios (PAA) | Sí | No | No |
| Búsquedas relacionadas | Sí (relatedQueries) | No. Usa suggest para sugerencias | No |
| Anuncios y Shopping | Solo con el extra | No | No |
| AI Overview, AI Mode | Versión corta incluida. Completa y AI Mode aparte | No | No |
| Copia HTML de la página | Sí, por defecto | No | No |
La conclusión es directa. Si necesitas PAA, búsquedas relacionadas, anuncios o AI Overview, el scraper oficial de Apify los da en una sola página y nosotros no. En ese caso, comparar precios no tiene sentido.
Muchas tareas, sin embargo, solo necesitan el bloque orgánico. Por ejemplo: dar a un agente de IA una herramienta de búsqueda web, vigilar una lista de palabras clave, juntar enlaces sobre un tema o revisar si tu página aparece. Para esas tareas, la comparación de precio vale.
Otra diferencia importa en América Latina. Desde el 15 de octubre de 2026, el searchQuery.domain del scraper de Apify es siempre google.com, y el país va en el parámetro gl, según su changelog. La página que devuelve es una página de Google. La nuestra es una búsqueda web general, y la documentación no promete que coincida con una página concreta de Google. Si tu cliente te pide «el ranking de Google en Monterrey para tal palabra», usa una herramienta que diga claramente que extrae páginas de Google, como el scraper oficial de Apify.
Prueba 1: una búsqueda de México, «tenis» contra «zapatillas»
El 5 de noviembre de 2026 a las 16:15 UTC (00:15 del 6 de noviembre, hora de Singapur) mandamos esta búsqueda a la herramienta web: «mejores tenis para correr pie plano», con location=mx y after=2026-08-01. Costó 0,000694 USD y tardó 2,33 segundos. Devolvió 10 resultados. La respuesta dijo «Applied at country level: Mexico», o sea, el país se aplicó a nivel nacional.
Lo interesante está en los resultados. Usamos la palabra mexicana «tenis», pero cinco de los diez títulos dicen «zapatillas», la palabra de España. Solo dos títulos dicen «tenis»: una publicación de un grupo de Facebook y un hilo de Reddit. Dos resultados tienen dominio o nombre de España: top4running.es y bcnrunhub.com. Otros dos son guías en español de runrepeat.com que usan el vocabulario de España.
| Posición | Sitio | Fecha detectada | Palabra en el título |
|---|---|---|---|
| 1 | runrepeat.com/es (guía) | 2026-09-30 | zapatillas |
| 2 | support.runna.com/es | 2026-08-19 | zapatillas |
| 3 | facebook.com (publicación) | Sin fecha | Ninguna |
| 4 | top4running.es | 2026-08-11 | zapatillas |
| 5 | runrepeat.com/es (guía para caminar) | 2026-09-22 | zapatillas |
| 6 | facebook.com (grupo) | Sin fecha | tenis |
| 7 | youtube.com (video en inglés) | Sin fecha | Ninguna (shoes) |
| 8 | facebook.com (video) | Sin fecha | Ninguna |
| 9 | bcnrunhub.com | 2026-10-25 | zapatillas |
| 10 | reddit.com | Sin fecha | tenis |
¿Qué significa esto para ti? El filtro de país funciona, pero en español el contenido de España pesa mucho. Una búsqueda «de México» puede devolver guías escritas para lectores de Madrid o Barcelona. Si vendes tenis en México y quieres saber con quién compites, esa mezcla es justo lo que ve tu cliente, así que no la filtres sin pensar.
Si en cambio necesitas «solo contenido mexicano», tienes dos caminos. Con EveryInfra, puedes filtrar después por dominio (por ejemplo, .mx) o usar el parámetro site. Con Apify, puedes separar el idioma de la interfaz (languageCode) del idioma de los resultados (searchLanguage) y fijar una ciudad con un código UULE, según su esquema de entrada. Ese control fino es una ventaja real de Apify.
El filtro de fecha también funcionó, con un matiz. Cinco de los diez resultados tenían fecha, y las cinco eran posteriores al 1 de agosto. Los otros cinco (Facebook, YouTube y Reddit) no traían fecha. Es decir, after filtra por la fecha que el buscador detecta, y los resultados sin fecha pueden aparecer igual. Si necesitas «solo contenido nuevo de los últimos tres meses», vuelve a filtrar por fecha en tu código. El afterDate de Apify pasa la fecha al filtro de Google, así que tiene el mismo límite.
Prueba 2: diez páginas de una consulta, cuántas se repiten
Para medir la paginación usamos una consulta de Estados Unidos, la misma de la versión en inglés de este artículo: «best running shoes for flat feet», con location=us. Pedimos las páginas 1 a 10 con la herramienta web, entre las 16:14 y las 16:17 UTC (00:14 a 00:17, hora de Singapur). Las diez llamadas salieron bien y cada una costó 0,000694 USD, 0,00694 USD en total.
Las diez páginas devolvieron 95 resultados, una media de 9,5 por página. Por 1000 resultados devueltos, el costo fue de 0,0731 USD. Pero no todos eran nuevos.
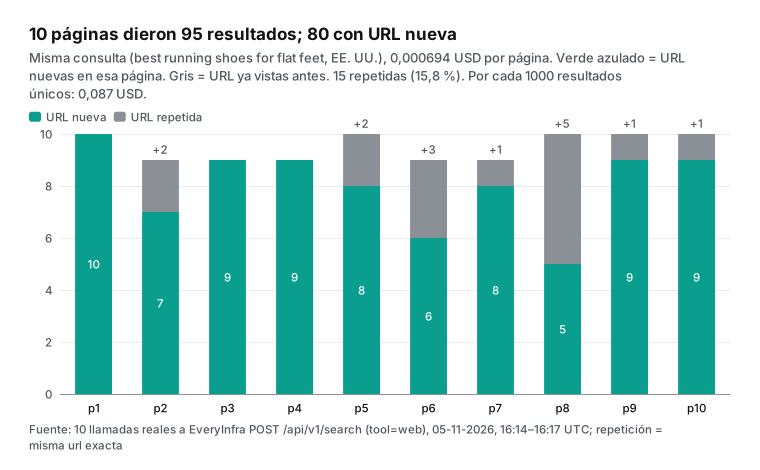
Comparamos la url exacta de cada resultado. De 95 resultados, solo 80 URL eran únicas: 15 repetidas, un 15,8 %. Las repeticiones se concentran en las páginas finales. La página 8 tuvo 5 repetidas de 10. Por 1000 resultados únicos, el costo fue de 0,087 USD, un 19 % más que por resultado devuelto.
| Página | Resultados | Nuevos | Repetidos |
|---|---|---|---|
| 1 | 10 | 10 | 0 |
| 2 | 9 | 7 | 2 |
| 3 | 9 | 9 | 0 |
| 4 | 9 | 9 | 0 |
| 5 | 10 | 8 | 2 |
| 6 | 9 | 6 | 3 |
| 7 | 9 | 8 | 1 |
| 8 | 10 | 5 | 5 |
| 9 | 10 | 9 | 1 |
| 10 | 10 | 9 | 1 |
| Total | 95 | 80 | 15 |
No ejecutamos Apify, así que no conocemos su tasa de repetición en diez páginas. Pero su forma de cobro decide quién paga las repeticiones. Cobra por página, así que una página con 5 repetidas cuesta lo mismo que una sin repetidas. Nosotros también cobramos por llamada. Las repeticiones cuestan igual en los dos lados; solo cambia el precio unitario.
Un dato de fondo: en septiembre de 2025 Google dejó de mostrar 100 resultados en una sola página (el parámetro num=100). Desde entonces, cualquier herramienta necesita diez páginas para obtener el top 100. Según Search Engine Land, el 77 % de los sitios perdió visibilidad de palabras clave en Search Console en ese momento. Por eso hoy es más común cobrar por página que por resultado.
Prueba 3: filtros de país, idioma, fecha y sitio
Quien sigue rankings cambia sobre todo cuatro parámetros: país, idioma, rango de fechas y sitio. Las dos herramientas los tienen, con otros nombres y otro nivel de detalle.
| Necesidad | Apify oficial | EveryInfra `web` | Resultado en la prueba |
|---|---|---|---|
| País | countryCode (el gl de Google). locationUule llega a ciudad | location: nombre de país o código de 2 letras. Una ciudad cuenta como su país | us y mx se aplicaron |
| Idioma | languageCode (interfaz) y searchLanguage (resultados) por separado | No hay parámetro aparte. Deciden el idioma de la consulta y el país | Consulta en español + mx: 10 resultados en español |
| Fechas | quickDateRange, afterDate, beforeDate | after, before | after=2026-08-01 aceptado |
| Sitio | site, relatedToSite, wordsInTitle y otros | site | site=apify.com: 10 resultados, todos de ese sitio |
| Páginas | maxPagesPerQuery | page, una por llamada | Ver prueba 2 |
| Resultados móviles | mobileResults | No | — |
A las 16:15 UTC (00:15, hora de Singapur) buscamos también «google search results scraper» con site=apify.com. Los diez resultados eran de apify.com. Incluían el scraper oficial, su página de API y la página temática de Store para Google. El resto eran scrapers parecidos de otros desarrolladores. Esa llamada nos dio la lista que usamos más abajo para comparar precios de terceros.
En idioma es donde más se separan. Apify distingue idioma de interfaz e idioma de resultados, y puede fijar una ciudad con UULE. Eso importa para rankings locales, como «dentista» más el nombre de una colonia. EveryInfra web trabaja a nivel país y lo dice en la respuesta. Si necesitas rankings por ciudad, Apify es mejor opción. Si el país te basta, sirven las dos.
Prueba 4: ¿las sugerencias sustituyen a las búsquedas relacionadas?
PAA y búsquedas relacionadas son lo que más piden los equipos de contenido. Nosotros no los devolvemos. Lo más cercano es la herramienta de sugerencias suggest. A las 16:14 UTC (00:14, hora de Singapur) la llamamos con la consulta en inglés. Costó 0,000694 USD y devolvió 10 términos en 1,17 segundos, del tipo «best running shoes for flat feet men», «women», «and plantar fasciitis» o «and knee pain».
Las sugerencias no son lo mismo que las búsquedas relacionadas del final de la página. Las sugerencias muestran lo que la gente escribe en la caja de búsqueda, así que añaden una palabra a la misma frase. Las búsquedas relacionadas y PAA salen de la página de resultados y a menudo plantean la pregunta de otra forma. Para ideas de cola larga, las sugerencias funcionan bien. Para preguntas reales con las que armar un FAQ, no alcanzan.
Para esa necesidad, conviene el scraper oficial de Apify o un scraper de Store con PAA. Con nuestras herramientas, orgánicos más sugerencias son dos llamadas por 0,001388 USD, o 1,39 USD por 1000 palabras clave (2000 llamadas). Sigue siendo menos que los 1,80 USD de Business en Apify, pero te falta un bloque. Haz la cuenta con tu caso.
Prueba 5: dos entradas, misma consulta, el doble de precio
La búsqueda web de EveryInfra tiene dos entradas, y esto es algo que debes vigilar de nuestro lado. A las 16:14 UTC (00:14, hora de Singapur) llamamos web/search en la API de datos, con la misma consulta y country=us. Devolvió 10 resultados en 2,32 segundos y costó 0,001389 USD. Veintidós segundos antes, la herramienta web del endpoint de búsqueda devolvió 10 resultados en 2,18 segundos por 0,000694 USD.
Los dos primeros resultados coincidieron. Después cambiaron el orden y algunos sitios. La diferencia de precio viene del catálogo: la API de datos lista web/search a 0,001389 USD en el catálogo de capacidades. Las herramientas del endpoint de búsqueda cuestan 0,000694 USD por consulta, según el archivo OpenAPI. La API de datos tiene modo asíncrono y un cuerpo de petición común para 106 plataformas. Si solo quieres resultados web, usa web a la mitad de precio. Todas las cifras de «0,694 USD por 1000 páginas» de este artículo son de esa entrada.
¿Se cobran los errores y los resultados vacíos?
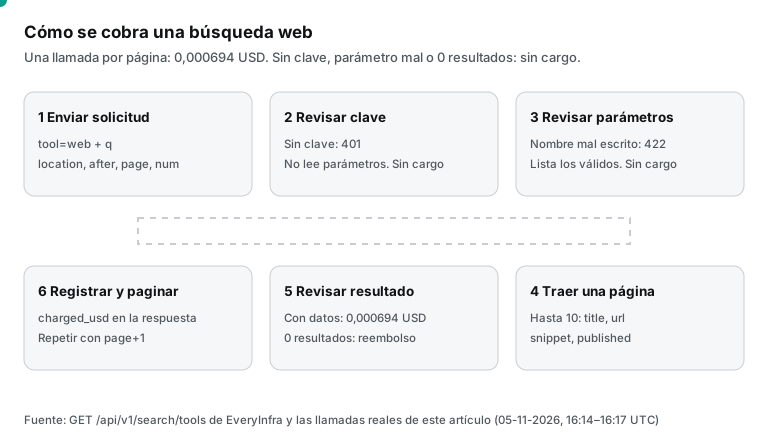
Con el cobro por llamada, el riesgo principal es pagar por llamadas que fallan. Mandamos tres peticiones que no pueden devolver resultados, una de cada tipo, y leímos las respuestas.
| Hora (UTC y hora de Singapur) | Petición | HTTP | Respuesta | Cobro |
|---|---|---|---|---|
| 16:15 UTC (00:15 hora de Singapur) | Sin clave | 401 | unauthorized, «Nothing was charged.» | 0 USD |
| 16:15 UTC (00:15 hora de Singapur) | País como country (web solo acepta location) | 422 | unknown_param, con la lista after, before, location, num, page, q, site | 0 USD |
| 16:15 UTC (00:15 hora de Singapur) | Palabras sin resultados | 200 | charged: false, reason: empty_result_refunded, reembolso succeeded | 0 USD |
| 16:14 UTC (00:14 hora de Singapur) | Petición normal | 200 | 10 resultados, charged_usd: 0.000694 | 0,000694 USD |
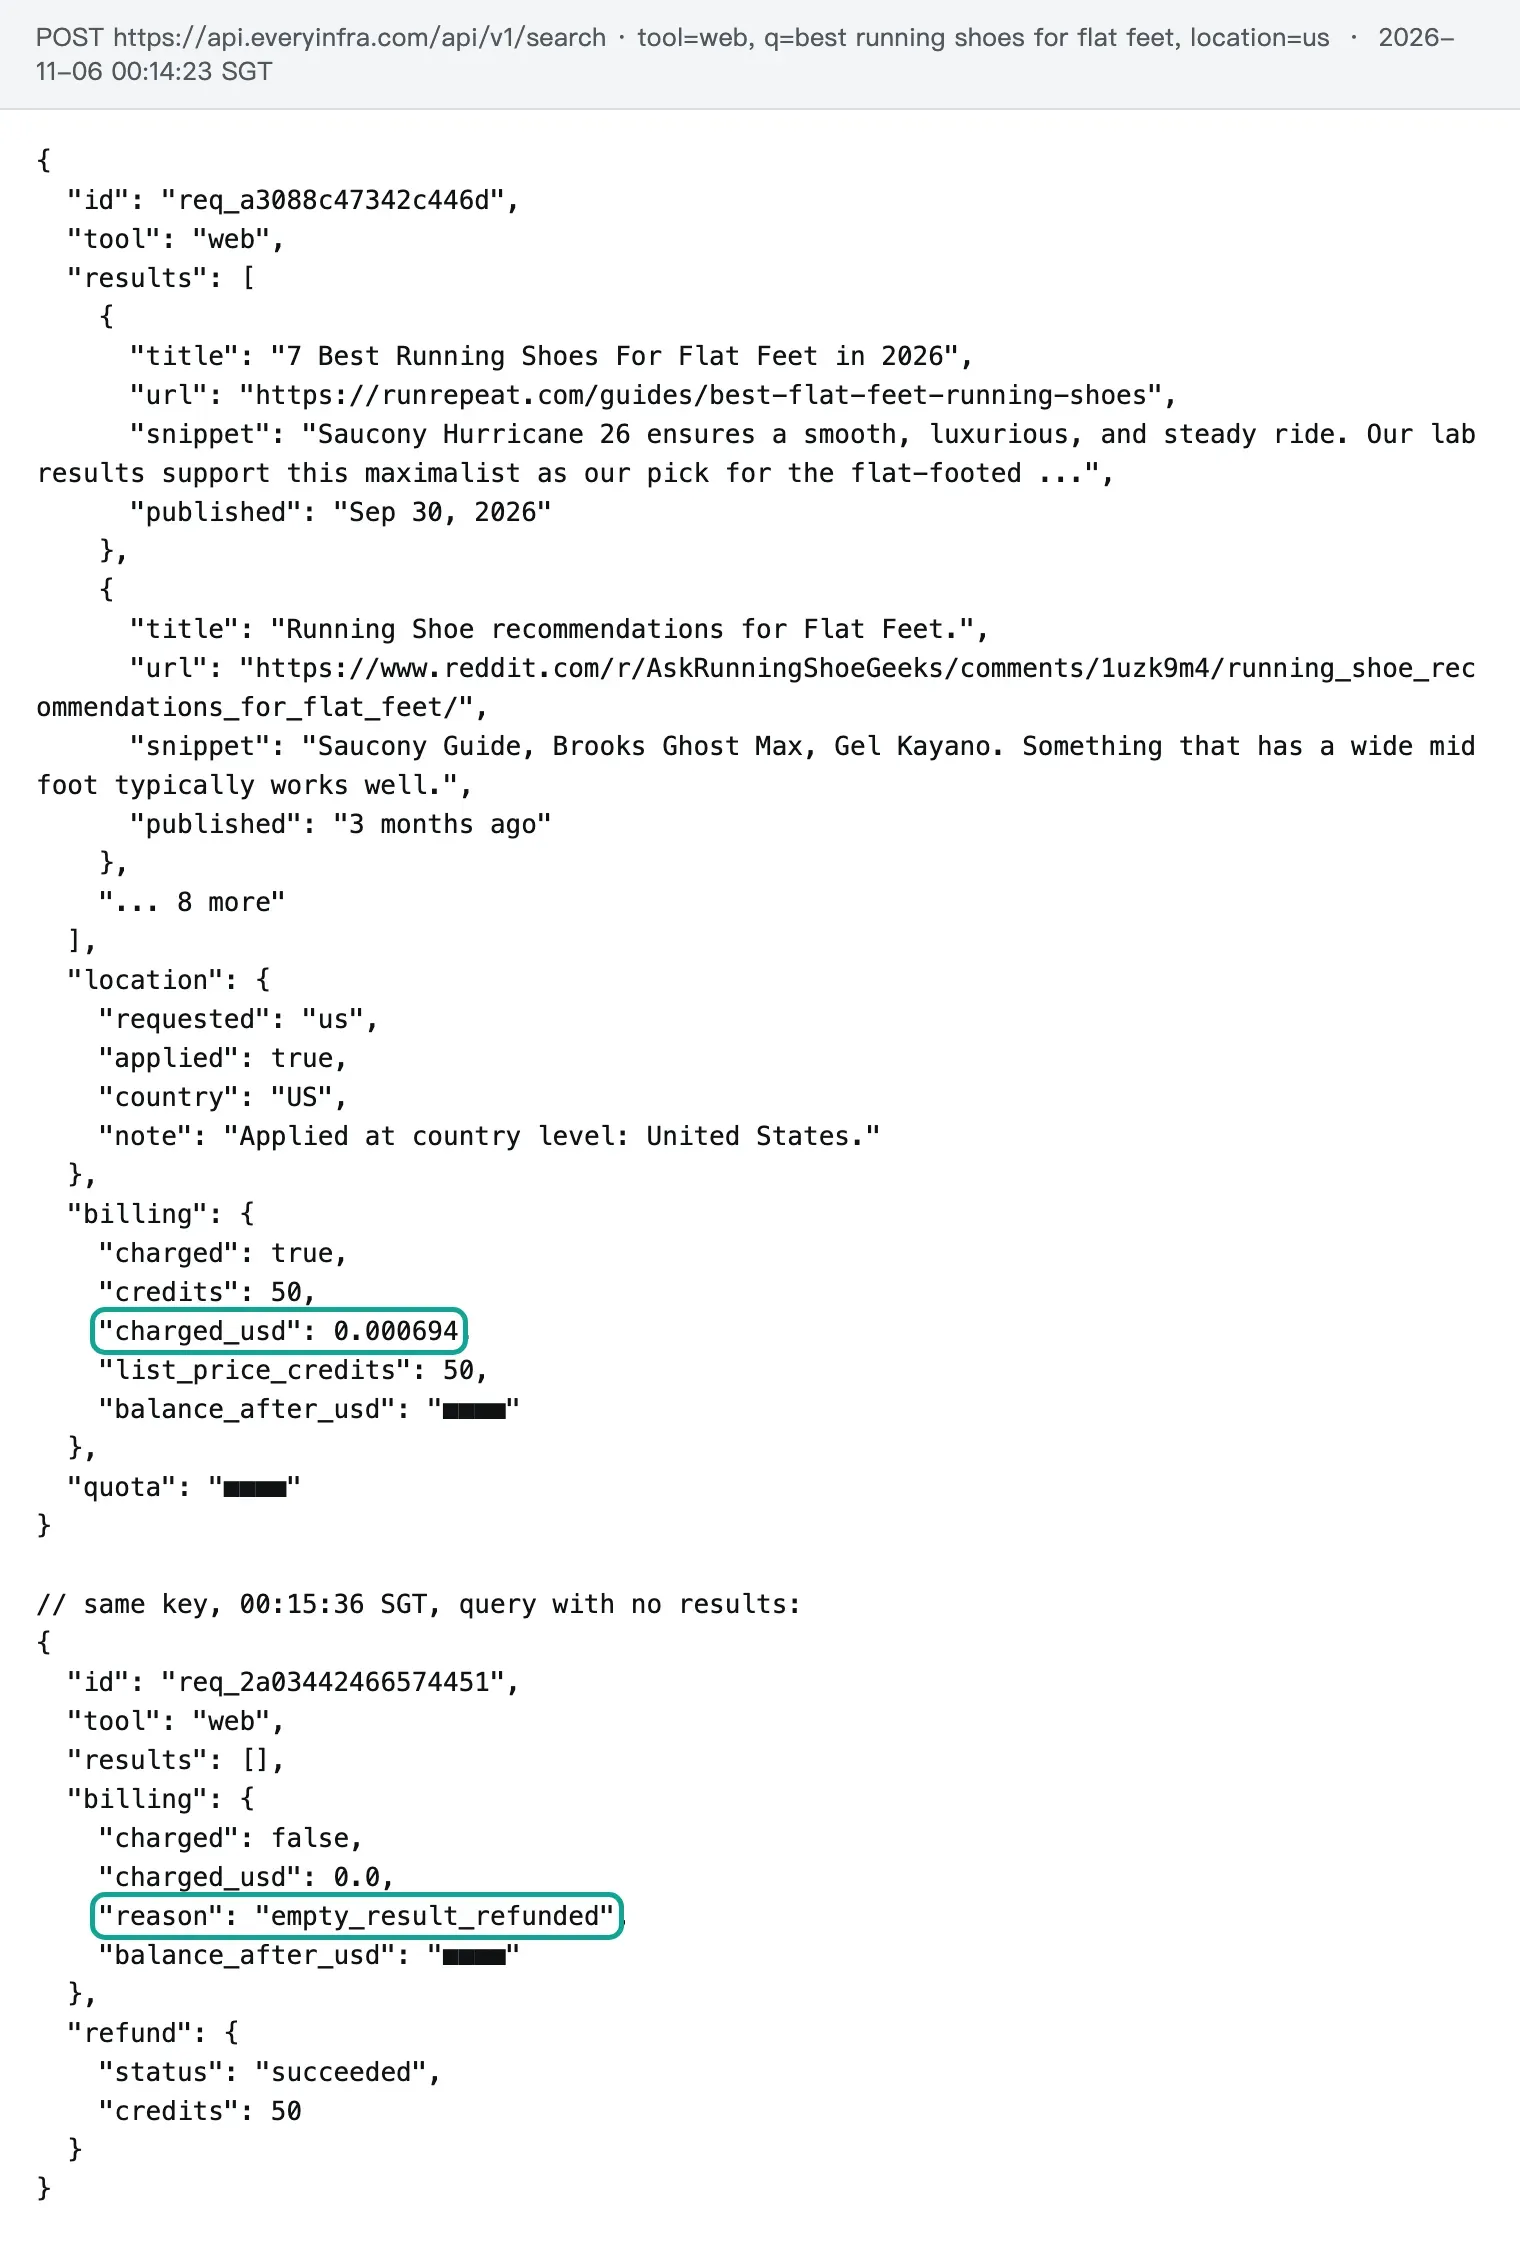
La llamada 422 merece un comentario. Mandamos country, un nombre parecido al countryCode de Apify. El endpoint la rechazó en 0,12 segundos y dijo cuáles son los parámetros válidos. El campo next_steps añadió «Nothing was charged». Esto ayuda a quien migra código desde Apify y a los agentes de IA que escriben sus propias llamadas. Un parámetro mal escrito no se ignora en silencio para cobrar igual. Nuestra guía de errores que el agente puede corregir solo explica cómo un agente lee este error y arregla la llamada.
Del lado de Apify, el material público dice lo siguiente. El evento principal cobra por página «extraída con éxito», así que las páginas que fallan no se cobran. El evento de inicio cobra al arrancar, pero su monto es mínimo. La excepción son los anuncios: con la opción activa, se cobra cada página, haya o no anuncios. La documentación y el README que leímos no dicen si un resultado vacío de Google cuenta como página extraída con éxito. Lo marcamos como «no indicado». Si concilias cobros, mira nuestro artículo sobre reembolsos de llamadas fallidas.
Velocidad: 2,6 segundos por llamada contra arrancar una ejecución
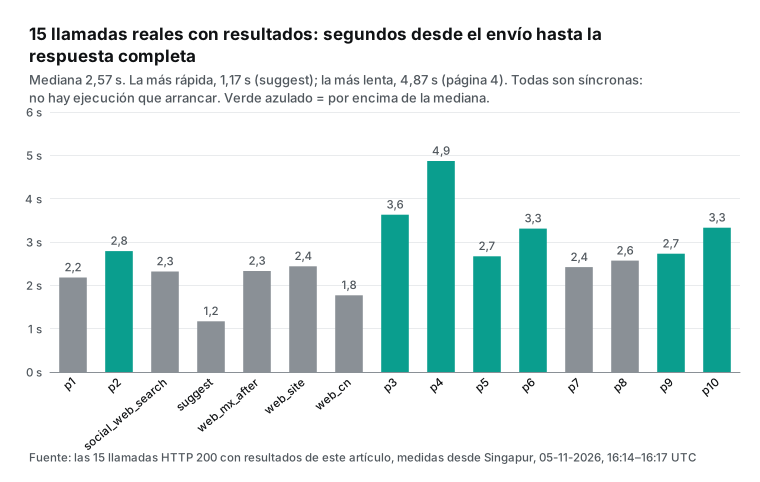
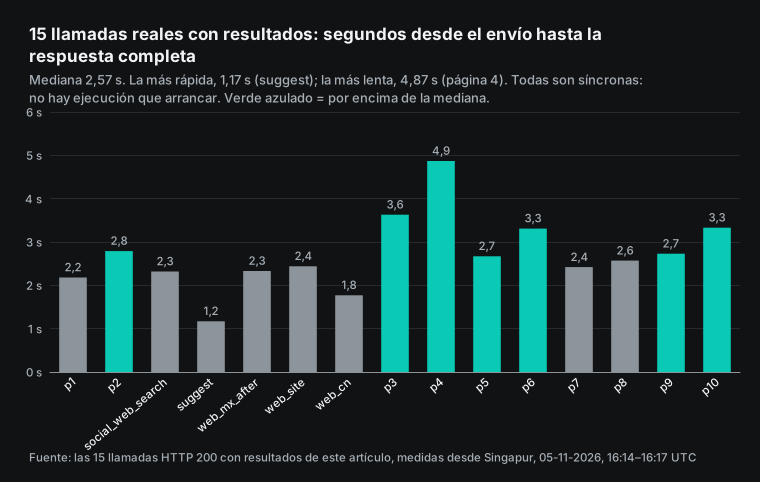
Medimos 15 llamadas con resultados desde un cliente en Singapur, de envío a respuesta completa, con el viaje de red incluido. Todas son síncronas: mandas la petición y esperas el resultado, sin cola ni paso de arranque. Desde Ciudad de México o Buenos Aires los tiempos pueden ser distintos, porque la distancia a nuestros servidores cambia.
| Medida (15 llamadas con resultados) | Segundos |
|---|---|
| Más rápida (sugerencias) | 1,17 |
| Mediana | 2,57 |
| Media | 2,70 |
| Más lenta (página 4) | 4,87 |
| Llamadas rechazadas (401 y 422) | 0,15 o menos |
Apify funciona de otra manera. Cada trabajo de búsqueda es una ejecución de un actor, y cada ejecución arranca primero un contenedor. Las opciones públicas por defecto son 1 GB de memoria y un tiempo máximo de 604 800 segundos. Una ejecución puede llevar muchas consultas. Su fuerte es el lote: mandas 1000 consultas en una ejecución y la plataforma se ocupa de la concurrencia, los reintentos y el dataset. Su punto débil es la consulta suelta, que también necesita una ejecución completa.
No ejecutamos Apify, así que no damos segundos medidos de su lado, ni repetimos cifras de velocidad de páginas de terceros que no podemos verificar. Para comparar velocidad, corre un lote pequeño de tus propias consultas en los dos lados y mide de la misma forma.
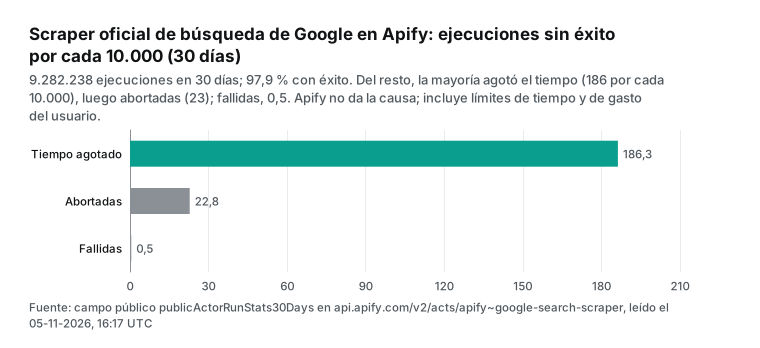
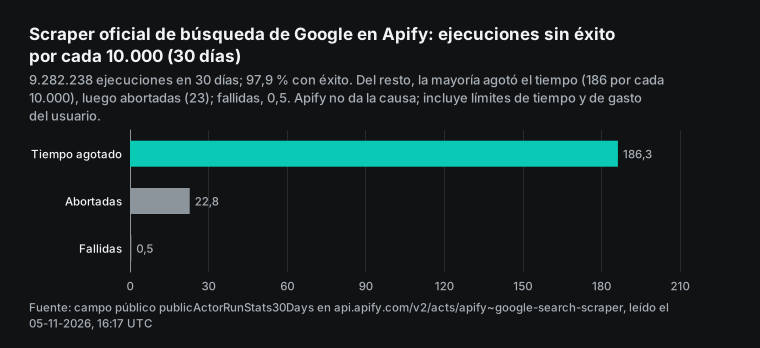
Sobre fiabilidad, Apify publica en su endpoint los resultados de ejecución de los últimos 30 días.
| Resultado de ejecución, 30 días | Ejecuciones | Porcentaje |
|---|---|---|
| Con éxito | 9 087 716 | 97,9 % |
| Tiempo agotado | 172 957 | 1,86 % |
| Abortadas | 21 143 | 0,23 % |
| Fallidas | 422 | 0,0045 % |
| Total | 9 282 238 | 100 % |
La mayoría de las que no terminaron bien agotaron el tiempo. Pero la estadística no da la causa: un tiempo máximo corto puesto por el usuario o un tope de gasto también cuentan. No se puede leer como «2,1 % de errores de la plataforma». Ninguna de nuestras 18 llamadas falló, pero 18 es muy poco para compararlo con 9 millones. Nuestra disponibilidad está publicada en la página de estado.
La factura del mes en cuatro volúmenes
El precio unitario es la mitad de la historia. La otra mitad es la cuota mensual. En Apify, la cuota del plan es uso prepagado: Starter cuesta 19 USD al mes, Scale 199 USD y Business 999 USD. El crédito se usa en el mismo mes y lo que sobra no pasa al siguiente, según el FAQ de la página de precios.
Una cuenta Free recibe 5 USD al mes y se detiene al gastarlos. Así que un mes de Apify cuesta el mayor importe entre la cuota del plan y el costo de las páginas. EveryInfra no cobra cuota: cobra por llamada, con recarga mínima de 10 USD y saldo que no vence.
| Páginas al mes | Plan más barato de Apify | Factura Apify | EveryInfra | Relación |
|---|---|---|---|---|
| 1000 | Free (lo cubren los 5 USD) | 0 USD | 0,69 USD | Apify cuesta menos |
| 10 000 | Starter | 25,00 USD | 6,94 USD | 3,6 veces |
| 100 000 | Scale (la cuota de 199 USD cubre 195 USD de uso) | 199 USD | 69,44 USD | 2,9 veces |
| 1 000 000 | Business | 1800 USD | 694,44 USD | 2,6 veces |
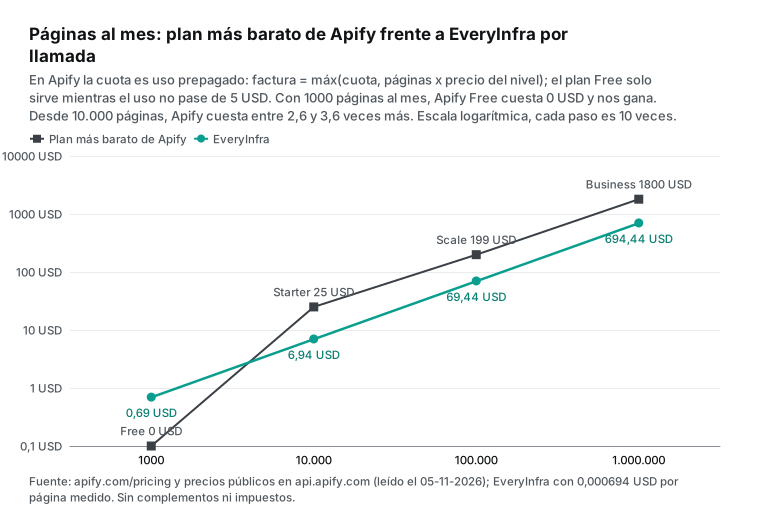
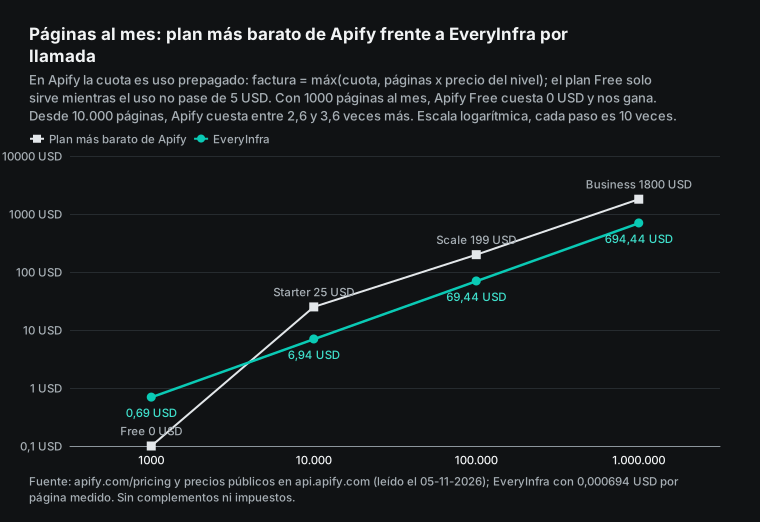
Conviene aclarar la primera fila. Si necesitas unas 1000 páginas al mes (hasta unas 1111), la cuenta Free de Apify te sale gratis con sus 5 USD. Eso es menos que nuestro precio. El README dice que 5 USD alcanzan para «over 1,000 Google Search results». En realidad, a unos 10 resultados por página, 5 USD compran unas 1111 páginas, unos 11 000 resultados.
Nuestra prueba gratuita es más pequeña. Das estrella a dos repositorios de GitHub y recibes 1 USD válido por 24 horas, según la guía de inicio. A 0,000694 USD por llamada son unas 1440 búsquedas, pero solo por un día.
Por encima de 10 000 páginas, las cuotas de Apify empiezan a pesar. Con 100 000 páginas, Starter costaría 250 USD, pero Scale cuesta solo su cuota de 199 USD. Con un millón de páginas, Business a 1800 USD sale más barato que Scale a 1950 USD. Nuestro costo es lineal en los cuatro volúmenes, y la diferencia se queda entre 2,6 y 3,6 veces.
Hay dos límites. La tabla no incluye extras: anuncios o AI Overview suman costo en Apify. Y hay límites de velocidad. Por defecto permitimos 60 peticiones por minuto por cuenta. Un millón de páginas al mes son unas 23 por minuto de media, así que alcanza.
Para hacer 100 000 páginas en una hora necesitas un paquete de 1800 por minuto o más; nuestra página de precios lista 180, 600 y 1800 por minuto. Una cuenta Free de Apify corre hasta 5 actors a la vez y Starter 32. Una sola ejecución también procesa muchas consultas en paralelo, así que Apify aguanta mejor los picos.
Tres usos en América Latina, tres facturas
Los precios unitarios cambian cuando los metes en trabajo real. Estos tres usos son los que más escuchamos. Usamos los precios públicos leídos el 5 de noviembre de 2026 (UTC) y nuestro precio medido, sin impuestos.
El primero es una agencia de SEO en Ciudad de México que sigue rankings. Vigila 200 palabras clave, revisa el top 30 (3 páginas) cada día, 30 días al mes. Son 18 000 páginas. En el scraper oficial de Apify ese volumen supera el crédito Free, así que necesitas Starter: 18 000 × 0,0025 = 45 USD. Si además quieres los anuncios, son 18 000 × 0,005 = 90 USD más, 135 USD en total.
Con EveryInfra son 18 000 × 0,000694 = 12,50 USD, sin anuncios. Las dos opciones necesitan quitar URL repetidas para el informe. Si el cliente quiere «el ranking de Google en Guadalajara», la ubicación UULE de Apify es algo que no tenemos, y entonces pagas 3,6 veces por esa función.
El segundo es un asistente de IA para una fintech en Bogotá. Responde 300 preguntas al día, hace 2 búsquedas por pregunta y lee solo la página 1. Son 18 000 llamadas al mes. Lo clave aquí no es el precio unitario, sino si una llamada devuelve los resultados.
La herramienta MCP call-actor de Apify devuelve un ID de ejecución y de almacenamiento, y el agente tiene que pedir el dataset con otra herramienta. La herramienta everyinfra_search devuelve la lista de resultados en una sola llamada. En precio, Apify Starter cuesta 45 USD y nosotros 12,50 USD. Si el asistente responde solo unas decenas de preguntas al mes, el crédito gratis de Apify basta.
El tercero es un equipo de contenido en Buenos Aires que planea temas. Tiene 200 palabras semilla y quiere PAA y búsquedas relacionadas para cada una, una vez al mes. Son 200 páginas. En una cuenta Free de Apify cuesta 0,90 USD del crédito, o sea, nada, y trae todos los campos. Con nosotros, orgánicos más sugerencias son 400 llamadas por 0,28 USD, sin PAA. Aquí Apify conviene más, sin discusión.
| Uso | Volumen al mes | Apify oficial | EveryInfra | Conviene |
|---|---|---|---|---|
| Rankings (200 palabras × top 30 × 30 días) | 18 000 páginas | Starter 45 USD, con anuncios 135 USD | 12,50 USD (sin anuncios) | Solo orgánicos: nosotros. Ciudad o anuncios: Apify |
| Búsqueda web para agente de IA | 18 000 llamadas | Starter 45 USD, dos pasos | 12,50 USD, un paso | Nosotros |
| Temas de contenido con PAA | 200 páginas | Free, 0 USD | 0,28 USD (sin PAA) | Apify |
Apify Store tiene más opciones: scrapers de terceros más baratos
Casi todos los que buscan «apify google search scraper» piensan en el oficial. Pero Apify Store es un mercado. Una búsqueda de «google search results scraper» en el endpoint de búsqueda de Store dio 4439 resultados, leídos el 5 de noviembre de 2026 a las 16:17 UTC (00:17 del 6 de noviembre, hora de Singapur). Tomamos los más usados en 30 días y pasamos cada precio a «por 1000 páginas de unos 10 resultados». Casi todos los autores externos son cuentas personales, así que la tabla los llama tercero A a F, de más a menos usuarios. Las Referencias al final enlazan cada página de Store.
| Scraper (autor oculto) | Usuarios, 30 días | Unidad de cobro | Free por 1000 páginas | Business por 1000 páginas | PAA |
|---|---|---|---|---|---|
| apify/google-search-scraper (oficial) | Unos 27 000 | Por página | 4,50 USD | 1,80 USD | Sí |
| Tercero A | 3596 | Por página | 0,50 USD | 0,50 USD | No indicado |
| Tercero B | 251 | Por consulta (10 resultados incluidos) | 2,00 USD | 1,94 USD | No indicado |
| Tercero C | 117 | Por página. PAA con extra de página completa | 0,60 USD | 0,40 USD | Extra a 5,50 USD por 1000 |
| Tercero D | 100 | Por página + 0,001 USD por ejecución | 6,00 USD | 6,00 USD | Sí |
| Tercero E | 69 | Por resultado, × 10 por página | 3,50 USD | 3,50 USD | No indicado |
| Tercero F | 43 | Por página | 0,45 USD | 0,45 USD | Sí, con relacionadas y anuncios |
EveryInfra web | — | Por llamada (una página) | 0,694 USD | 0,694 USD | No |
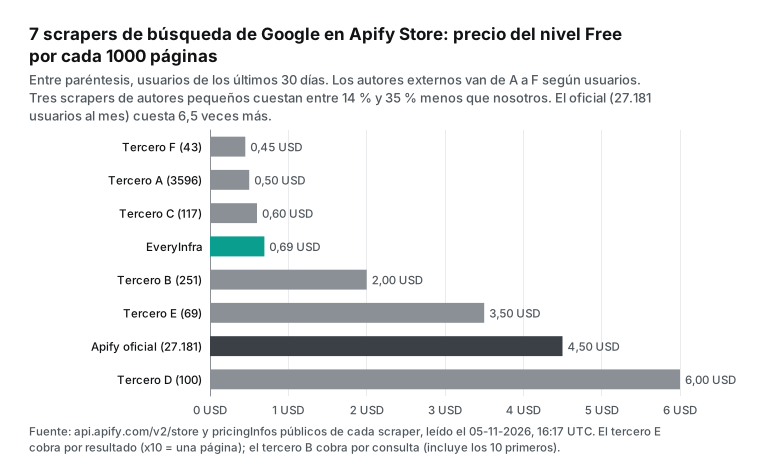
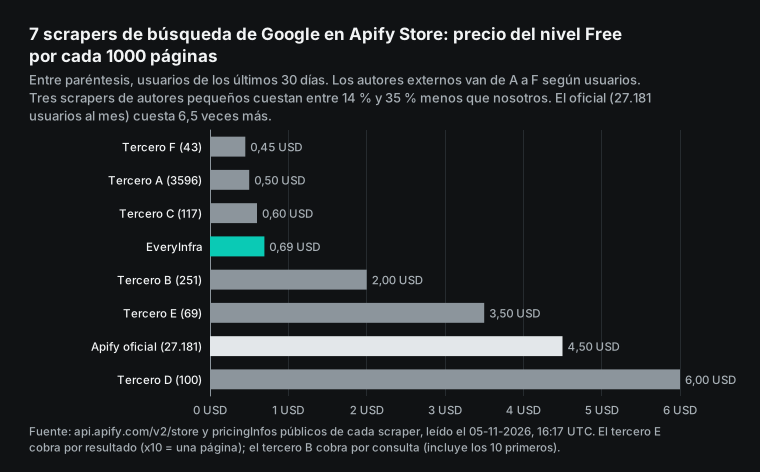
Esta tabla le quita la mitad a la frase fácil «somos más baratos que Apify». El tercero A cobra 0,50 USD por 1000 páginas y tuvo 3596 usuarios y 4,69 millones de ejecuciones en 30 días. No es poca cosa. El tercero F cobra 0,45 USD e incluye PAA, búsquedas relacionadas y anuncios, sin tarifa de inicio, según su página de Store (referencia 25). Los dos cuestan menos por página y traen más campos que nosotros.
Pero tienen su costo. El tercero F tuvo solo 43 usuarios en 30 días, y de sus 94 714 ejecuciones fallaron 24 841, un 26,2 %. El oficial está en 2,1 %. Casi todas las ejecuciones del tercero A salieron bien, pero su página dice que incluye 100 búsquedas gratis al mes y que después hace falta un plan de pago de Apify, de 19 USD al mes o más. Con unos miles de páginas al mes, esa cuota anula el precio de 0,50 USD. Con cientos de miles de páginas al mes, estos scrapers sí salen más baratos.
Al revisar precios encontramos tres casos donde el texto de Store y el precio del endpoint no coinciden. La descripción del evento del tercero D dice «$1.50 per 1,000 pages», pero el eventPriceUsd es 0,006, o sea 6,00 USD por 1000 páginas. El título del tercero E dice «only $0.25 per 1,000 results», pero el campo de precio es 0,00035 USD por resultado, 0,35 USD por 1000. Y la tabla de la página del tercero A pone al oficial en 3,50 USD por 1000, un precio que terminó el 10 de junio de 2025. Lo que pagas es el campo del endpoint; revisa la pestaña Pricing antes de ejecutar.
Además, el tercero B cambió su precio el 4 de noviembre de 2026: pasó de un precio único a niveles por plan. Los precios de Store cambian seguido. Las cifras de este artículo valen para el 5 de noviembre de 2026 (UTC).
Puedes revisar un precio de Store tú mismo, sin cuenta de Apify. Toma la parte «autor/nombre» de la URL de Store, cambia la barra por una tilde y abre api.apify.com/v2/acts/autor~nombre. Mira el último elemento de la lista pricingInfos. startedAt es la fecha en que empezó ese precio. Dentro de pricingPerEvent, cada evento tiene eventPriceUsd (precio único) o tieredEventPriceUsd por nivel de plan. El evento con isPrimaryEvent: true es el cobro principal. Multiplica el precio unitario por 1000 y lee la descripción del evento para ver si un evento es una página o un resultado. Con esta revisión de un minuto encuentras cualquier diferencia entre el título de Store y el cobro real.
curl -s https://api.apify.com/v2/acts/apify~google-search-scraper \
  | jq '.data.pricingInfos[-1] | {startedAt, events: .pricingPerEvent.actorChargeEvents | map_values(.eventPriceUsd // .eventTieredPricingUsd)}'
Hacerlo tú mismo: cuánto cuesta un scraper de Google propio
Las sugerencias «scrape from google search» y «python scrape google» muestran que mucha gente piensa en escribir el suyo. Hay herramientas abiertas. La biblioteca Crawlee, de la propia Apify, funciona con Playwright, Puppeteer y HTTP simple, en Node.js y Python. Para llamar herramientas hechas, el cliente de Python y el nodo de n8n de Apify también son de código abierto.
Lo difícil no es el código, sino mantenerlo vivo. Desde enero de 2025, Google Search pide JavaScript, así que una petición HTTP simple no recibe la página de resultados. Necesitas un navegador sin interfaz, y eso consume memoria. La documentación de Apify dice que cada 4096 MB de memoria dan un núcleo completo de CPU, según uso y recursos.
También tienes que lidiar con bloqueos de IP, o sea, con proxies. La documentación de proxies de Apify lista proxies de centro de datos, residenciales y SERP. El proxy SERP es solo para páginas de resultados de Google. Cuesta 2,50 USD por 1000 peticiones en Free y Starter y 1,70 USD en Business, según la página de precios. Devuelve el HTML crudo de la página, según la documentación del proxy SERP.
Solo el proxy ya cuesta de 1,70 a 2,50 USD por 1000 páginas. Es casi el precio completo del scraper oficial en el mismo nivel. Y eso sin contar el análisis del HTML, la resolución de enlaces /goto ni las páginas alteradas que midió Nozzle.
Para un proyecto personal de unos miles de páginas al mes, hacer tu propio scraper es buena forma de aprender. Por encima de eso, las herramientas hechas cuestan menos y se rompen menos.
Conectar un agente de IA: MCP en los dos lados
Mucha gente busca un scraper de Google para darle búsqueda web a un agente de IA. Los dos servicios tienen un servidor MCP remoto, pero funcionan distinto.
El servidor MCP de Apify está en mcp.apify.com. Se recomienda entrar con OAuth, aunque también vale un token de API. Para usar solo la búsqueda de Google, agrega ?tools=apify/google-search-scraper a la URL, según la documentación de Apify MCP. Lo importante está en la descripción de su herramienta call-actor: espera entre 0 y 45 segundos y devuelve el estado de la ejecución y los ID de almacenamiento, no los resultados. El agente tiene que llamar otra herramienta para leer los datos.
{
  "mcpServers": {
    "apify": { "url": "https://mcp.apify.com?tools=apify/google-search-scraper" },
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
El servidor MCP de EveryInfra está en api.everyinfra.com/mcp. Puedes listar sus herramientas sin clave. A las 16:22 UTC (00:22, hora de Singapur) mandamos tools/list y recibimos 12 herramientas. everyinfra_search es el endpoint de búsqueda de este artículo: pones tool en web y q, location y page en params. Una llamada devuelve los resultados y el cobro, sin segundo paso.
Si el agente manda un parámetro mal escrito, recibe el 422 con la lista de parámetros válidos y puede corregirse. Puedes conectar los dos servidores al mismo cliente. Deja que el agente use Apify para PAA, AI Overview y rankings por ciudad. Usa nuestra búsqueda para resultados orgánicos baratos en muchas páginas, o para datos de Reddit, YouTube y otras plataformas. Nuestra página del servidor MCP tiene la configuración para cada cliente. La guía sobre cómo elige un agente su herramienta de búsqueda explica en qué es buena cada forma de buscar.
Una llamada HTTP directa también es corta. Esta es la petición exacta de la prueba con México, con la clave leída de una variable de entorno:
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"mejores tenis para correr pie plano","location":"mx","after":"2026-08-01","num":10}}'
# Devuelve los campos results (hasta 10: title, url, snippet, published), location y billing.charged_usd
En Apify, lo mismo se hace con su endpoint síncrono, dentro de la sección de ejecución de actors de la API v2 de Apify. Mandas un POST a /v2/acts/apify~google-search-scraper/run-sync-get-dataset-items con queries, maxPagesPerQuery y countryCode (por ejemplo, mx), y puedes agregar maxTotalChargeUsd como tope. Las dos piden una sola petición HTTP. La diferencia: una petición de Apify puede llevar muchas consultas y páginas, ideal para lotes; nosotros devolvemos una página por llamada, ideal para trabajo bajo demanda.
Migrar desde Apify: mapa de parámetros y campos
Si tu código ya llama el scraper oficial de Apify y solo usa resultados orgánicos, el cambio es pequeño. Algunos nombres cambian:
# Entrada de Apify -> parámetros de la herramienta web de EveryInfra
APIFY_A_EVERYINFRA = {
    "queries": "q",                 # Apify acepta varias consultas; nosotros una por llamada.
    "maxPagesPerQuery": "page",     # Apify pide cuántas páginas; nosotros llamamos página por página, desde 1.
    "countryCode": "location",      # Los códigos de 2 letras (mx, co, ar) sirven tal cual.
    "site": "site",
    "afterDate": "after",
    "beforeDate": "before",
}
# Salida: organicResults[].title/url/description/date -> results[].title/url/snippet/published
# Sin campo de posición: usa el índice de la lista + (page-1)*10
Ojo con tres puntos. Primero, languageCode y searchLanguage no tienen equivalente. Si los mandas, recibes un 422 sin cobro, así que quítalos.
Segundo, no tenemos peopleAlsoAsk, relatedQueries ni paidResults. El código que dependa de ellos tiene que seguir con Apify o aceptar que faltan. Tercero, en Apify un registro es una página; en EveryInfra un registro es un resultado. Cambia tu almacenamiento de «página» a «resultado».
Cuándo conviene más Apify
| Caso | Por qué conviene Apify | Fuente |
|---|---|---|
| Necesitas PAA, búsquedas relacionadas, anuncios, AI Overview o AI Mode | El scraper oficial los da en una página y los precios de los extras son públicos. Nosotros no tenemos esos campos | README |
| Necesitas rankings por ciudad | Códigos UULE e idiomas de interfaz y resultados por separado. Nosotros llegamos a país | esquema de entrada |
| Necesitas unas 1000 páginas al mes | El crédito Free de 5 USD lo cubre: 0 USD contra nuestros 0,69 USD | página de precios |
| Quieres la plataforma | Versiones fijas, hasta 100 programaciones por cuenta, datasets exportables a JSON, CSV y Excel, webhooks al terminar y nodo de n8n. Nosotros tenemos trabajos asíncronos y webhooks, pero no ese panel | ejecuciones y versiones, programaciones, datasets, almacenamiento, webhooks, n8n |
| Trabajos grandes a medida | Una ejecución acepta miles de consultas y puede guardar cada página de resultado en Markdown. Puedes copiar el código a tu propio actor | Actor pricing and costs |
| Un agente debe pagar sin cuenta | Desde octubre de 2026, un agente compra un token temporal con tope de gasto por x402 o MPP, desde 1 USD y válido 14 días. Nosotros pedimos registro y recarga | pagos de agentes |
Nosotros convenimos en otros casos: solo necesitas resultados orgánicos, más de 10 000 páginas al mes y no quieres cuota mensual. O quieres una sola clave para búsqueda web y para 106 plataformas, como Reddit o YouTube. O quieres que un agente reciba los resultados en una sola llamada. O quieres que un parámetro mal escrito devuelva un error y no un cobro silencioso.
Límites legales: los resultados de Google cada vez cuestan más de obtener
Con cualquier proveedor, conviene saber tres cosas. La primera: extraer es más difícil. Google Search empezó a pedir JavaScript en enero de 2025, quitó num=100 en septiembre de 2025 y pasó los enlaces de resultados a redirecciones google.com/goto en agosto de 2026. Un análisis de Search Engine Land dice que estos pasos vuelven los datos SEO de terceros menos fiables, y el changelog del scraper oficial muestra las correcciones del 30 de octubre y del 2 de noviembre de 2026.
La segunda: cuidado con los datos alterados. La empresa de seguimiento de rankings Nozzle encontró que, desde el 13 de septiembre de 2026, el 8,0 % de las páginas que recogía parecían normales pero tenían resultados cambiados, frente a 0,17 % antes, según el reporte de PPC Land. Esto afecta a cualquier herramienta que recoja resultados de forma automática, Apify y nosotros incluidos. Compara los datos nuevos con tu historial y no actúes por un solo salto grande.
La tercera: los límites legales todavía se mueven. Google demandó a SerpApi en diciembre de 2025, y en julio de 2026 un tribunal federal aceptó la moción para desestimar, con permiso para enmendar (las referencias 39 y 40 enlazan el expediente y la resolución). Eso no vuelve ningún método «legal» o «ilegal». Las reglas de México, Colombia, Argentina o España sobre datos personales también cuentan, y el FAQ del README de Apify recomienda tener en cuenta los Términos de Servicio de Google. Consulta a un abogado sobre tu caso; este artículo no da asesoría legal.
Cambios recientes (septiembre a noviembre de 2026)
| Fecha | Cambio | Qué significa |
|---|---|---|
| 04-11-2026 | Un autor externo (el tercero B de la tabla) pasó su scraper de Google a precios por nivel de plan | Los precios de Store cambian en días. Revisa la pestaña Pricing el día que ejecutes |
| 02-11-2026 | El scraper oficial de Apify sacó la versión 0.0.476, con mejor resolución de enlaces /goto. El 30-10-2026 arregló site:. Desde el 26-10-2026 admite la pestaña de videos cortos (udm=39) y el texto completo de AI Overview | El scraper sigue los cambios de Google, así que sus usuarios deben vigilar cambios de campos |
| 15-10-2026 | Google añadió más enlaces y contexto de fuentes en AI Mode y AI Overviews, según el blog de Google | Quien solo lee resultados orgánicos pierde esas fuentes. Es la parte por la que Apify cobra extras |
| 08-10-2026 | Apify publicó su documentación de pagos de agentes (x402, MPP) | Apify apuesta por agentes de IA que pagan por llamada sin cuenta |
| 07-10-2026 | El scraper oficial cambió su tarifa de inicio de 0,001 USD por ejecución a 0,00005 USD por GB | Las ejecuciones pequeñas cuestan menos. El precio por página no cambió |
| Desde 13-09-2026 | Nozzle midió páginas de resultados alteradas en el 8,0 % de los casos. Search Engine Roundtable lo reportó el 12-10-2026 | Contrasta todos los datos de búsqueda con tu historial |
Una fecha más importa. La API de Búsqueda Personalizada de Google (Custom Search JSON API) ya no acepta clientes nuevos, y los actuales deben migrar antes del 1 de enero de 2027. Da 100 consultas gratis al día y luego cobra 5 USD por 1000, según la documentación oficial. Las Bing Search APIs de Microsoft se retiraron el 11 de agosto de 2025, según el aviso de Microsoft. Las API oficiales de búsqueda se achican, y por eso Store suma scrapers de Google cada mes.
Cómo verificamos estas cifras
Cada precio de Apify sale de una respuesta cruda de un endpoint público. Para el scraper oficial leímos api.apify.com/v2/acts/apify~google-search-scraper. Para los terceros leímos el endpoint de búsqueda de Store y el endpoint acts de cada uno. Leímos todo el 5 de noviembre de 2026 a las 16:17 UTC (00:17 del 6 de noviembre, hora de Singapur). El «precio vigente» es la última entrada de pricingInfos con fecha de inicio anterior a ese momento. Cuando el texto de Store y el precio del endpoint no coinciden, usamos el del endpoint y lo decimos.
No entramos a Apify ni ejecutamos ningún actor. Por eso no tenemos valores medidos de velocidad, repeticiones ni cobro de resultados vacíos en Apify; el texto los marca como «no indicado» o «según el desarrollador».
Las cifras de EveryInfra salen de 18 llamadas reales con una clave de prueba, del 5 de noviembre de 2026, de 16:14:23 a 16:17:20 UTC (00:14 a 00:17 del 6 de noviembre, hora de Singapur). Un script calculó a partir de las respuestas crudas los precios por 1000, la tasa de repetición y la mediana de tiempo.
| Tipo de llamada | Llamadas | Cobro por llamada | Total |
|---|---|---|---|
web en el endpoint de búsqueda | 13 | 0,000694 USD | 0,009022 USD |
suggest | 1 | 0,000694 USD | 0,000694 USD |
web/search en la API de datos | 1 | 0,001389 USD | 0,001389 USD |
| Resultado vacío (reembolsado) | 1 | 0 USD | 0 USD |
| Parámetro mal escrito (422) | 1 | 0 USD | 0 USD |
| Sin clave (401) | 1 | 0 USD | 0 USD |
| Todas | 18 | — | 0,011105 USD |
Límites: la prueba de paginación usó una consulta en inglés, y la tasa de repetición cambia con cada consulta. La prueba de México fue una sola consulta. Los tiempos se midieron desde Singapur. Los precios de Store cambian seguido y nuestras cifras valen solo para el momento en que los leímos.
La página del producto de búsqueda web lista todos los parámetros de nuestra búsqueda. Cómo se suma el precio de Apify explica cuotas, precios por evento y proxies de Apify en general. Este artículo compara solo el scraper de búsqueda de Google de Apify y no repite esos textos.
Empezar: de una prueba a una ejecución diaria
Paso 1: abre la categoría de búsqueda web en el mercado y busca «Web search». Puedes probar una consulta sin código y ver el formato de respuesta. También puedes leer la página del producto de búsqueda web.
Paso 2: regístrate desde la guía de inicio y obtén una clave. Da estrella a dos repositorios de GitHub y recibes 1 USD de prueba válido por 24 horas, unas 1440 búsquedas.
Paso 3: pon el curl o la configuración MCP de arriba en tu script o en tu cliente de IA, y programa una ejecución diaria. Si necesitas otras fuentes, el catálogo tiene bing/search, duckduckgo/search y google_news/search, en las páginas de Bing, DuckDuckGo y Google News. La búsqueda web de la API de datos es web/search, en la página de búsqueda web. Para comparar más opciones, mira el resumen de alternativas y alternativas a Apify.
Preguntas frecuentes
¿Cuánto cuesta Apify Google Search Scraper?
Cobra por página de resultados. Leímos los precios públicos el 5 de noviembre de 2026 (UTC). Por 1000 páginas, Free cuesta 4,50 USD y Starter (19 USD al mes) 2,50 USD. Scale (199 USD) cuesta 1,95 USD y Business (999 USD) 1,80 USD. Los niveles de empresa Platinum y Diamond cuestan 1,50 y 1,20 USD.
Cada ejecución tiene además una tarifa de inicio mínima. Anuncios, AI Overview, AI Mode y otros extras se cobran aparte. El crédito Free de 5 USD al mes alcanza para unas 1111 páginas. (La pregunta viene de las sugerencias «apify google search scraper» y «apify precios». Precios en la pestaña Pricing.)
¿Apify Google Search Results Scraper trae «Otras preguntas de los usuarios» y búsquedas relacionadas?
Sí. El scraper oficial devuelve peopleAlsoAsk y relatedQueries dentro del precio de la página, sin costo extra. La búsqueda web de EveryInfra no tiene esos dos campos. Lo más cercano es suggest, que son sugerencias de la caja de búsqueda, no preguntas de la página de resultados. (La pregunta viene de la sugerencia «apify google search results scraper».)
¿Hay una API de búsqueda de Google oficial?
Existe la API de Búsqueda Personalizada de Google (Custom Search JSON API), pero ya no acepta clientes nuevos y deja de funcionar el 1 de enero de 2027. Da 100 consultas gratis al día y luego cobra 5 USD por 1000. Por eso muchos equipos usan scrapers como el de Apify o API de búsqueda web como la nuestra. (La pregunta viene de las sugerencias «api de búsqueda de google» y «api de búsqueda personalizada de google».)
¿Es legal hacer scraping de Google?
Este artículo no da asesoría legal. Hay hechos claros. El FAQ del README de Apify dice que extraer datos públicos es en general legal. También dice que hay que respetar los datos personales y la propiedad intelectual, y tener en cuenta los Términos de Servicio de Google.
La demanda de Google contra SerpApi de diciembre de 2025 fue desestimada en julio de 2026, con permiso para enmendar. Cada país tiene además sus propias leyes de datos personales. Consulta a un abogado sobre tu caso. (La pregunta viene de la sugerencia «scraping google es legal».)
¿Cómo hago scraping en Google con Python?
Para llamar una API basta un POST con requests, con la misma estructura del curl de arriba. Apify tiene un cliente oficial de Python para ejecutar lotes y leer datasets. Un scraper propio de páginas de Google en Python tiene que resolver JavaScript, enlaces /goto y bloqueos frecuentes desde 2025. Mantenerlo cuesta mucho, y por eso la mayoría usa una herramienta hecha. (La pregunta viene de las sugerencias «python scrape google» y «scraping en google».)
¿Apify es confiable?
Según los datos públicos, el scraper oficial de búsqueda de Google tiene 218 reseñas con media de 4,65. Tuvo 9,28 millones de ejecuciones en 30 días, y el 97,9 % salió bien. El servidor MCP de Apify excluye por defecto los actors que piden permisos completos; los dos niveles de permiso están en la documentación de permisos. Ojo con los extras en Free, que cuestan 0,20 USD por respuesta de IA: pon un tope de gasto antes de probarlos. (Datos del endpoint público y de la documentación de MCP.)
Referencias
- Metadatos públicos de Google Search Results Scraper (pricingInfos, stats), Apify, leído 2026-11-05 UTC
- Página de Store y README de Google Search Results Scraper, Apify, leído 2026-11-05 UTC
- Pestaña Pricing de Google Search Results Scraper, Apify, leído 2026-11-05 UTC
- Esquema de entrada de Google Search Results Scraper, Apify, leído 2026-11-05 UTC
- Changelog de Google Search Results Scraper, Apify, 2026-11-02
- Versión pública 0.0.476 (esquema, README, changelog), Apify, 2026-11-02
- Precios de Apify, Apify, leído 2026-11-05 UTC
- Actors in Store, documentación de Apify, leído 2026-11-05 UTC
- Actor pricing and costs, documentación de Apify, leído 2026-11-05 UTC
- Run Actor synchronously and get dataset items, documentación de la API de Apify, leído 2026-11-05 UTC
- Servidor MCP de Apify, documentación de Apify, leído 2026-11-05 UTC
- Configurador del servidor MCP de Apify, Apify, leído 2026-11-05 UTC
- Código de apify-mcp-server, GitHub, leído 2026-11-05 UTC
- Let your AI agent pay for Actor runs, documentación de Apify, 2026-10-08
- Programaciones de actors y tareas, documentación de Apify, leído 2026-11-05 UTC
- Dataset, documentación de Apify, leído 2026-11-05 UTC
- Integración con webhooks, documentación de Apify, leído 2026-11-05 UTC
- Integración con n8n, documentación de Apify, leído 2026-11-05 UTC
- Límites, documentación de Apify, leído 2026-11-05 UTC
- Uso y recursos de actors, documentación de Apify, leído 2026-11-05 UTC
- Proxy SERP de Google, documentación de Apify, leído 2026-11-05 UTC
- Endpoint de búsqueda de Store: google search results scraper, Apify, leído 2026-11-05 UTC
- Tercero A: página de Store de Google Search Results (SERP) Scraper, Apify Store, leído 2026-11-05 UTC
- Metadatos públicos del tercero A, Apify, leído 2026-11-05 UTC
- Tercero F: página de Store de Google Search Results Scraper & SERP API, Apify Store, leído 2026-11-05 UTC
- Tercero B: página de Store de Google Search Results Scraper (SERP), Apify Store, leído 2026-11-05 UTC
- Metadatos públicos del tercero B (precio nuevo desde 2026-11-04), Apify, leído 2026-11-05 UTC
- Tercero C: página de Store de Google Search Results Scraper, Apify Store, leído 2026-11-05 UTC
- Tercero D: página de Store de Google Search Results Scraper, Apify Store, leído 2026-11-05 UTC
- Otro tercero: página de Store de Google Search Scraper («Organic SERP, PAA & Related»), Apify Store, leído 2026-11-05 UTC
- Catálogo de herramientas de búsqueda de EveryInfra, EveryInfra, leído 2026-11-05 UTC
- Catálogo de capacidades de EveryInfra, EveryInfra, leído 2026-11-05 UTC
- OpenAPI de EveryInfra, EveryInfra, leído 2026-11-05 UTC
- Especificación de Model Context Protocol 2025-06-18, MCP, 2025-06-18
- Custom Search JSON API, Google for Developers, actualizado 2026-02-18
- Galería de elementos visuales de la Búsqueda de Google, Google Search Central, leído 2026-11-05 UTC
- Términos de Servicio de Google, Google, leído 2026-11-05 UTC
- Bing Search APIs Retiring on August 11, 2025, Microsoft Learn, leído 2026-11-05 UTC
- Expediente Google LLC v. SerpApi, LLC, CourtListener, desde 2025-12-19
- Resolución que acepta la moción para desestimar en Google LLC v. SerpApi LLC, texto del tribunal en FindLaw, 2026-07-20
- Why we're taking legal action against SerpApi, Google, 2025-12-19
- More ways to connect with the web from Search, Google, 2026-10-15
- Google is making third-party SEO data harder to trust, Search Engine Land, 2026-09-24
- 77% of sites lost keyword visibility after Google removed num=100, Search Engine Land, 2025-09-18
- Google feeds rank trackers swapped results on 8% of pages, Nozzle finds, PPC Land, 2026-10-19
- Código de Crawlee, GitHub, leído 2026-11-05 UTC
- Código de apify-client-python, GitHub, leído 2026-11-05 UTC
- Código de n8n-nodes-apify, GitHub, leído 2026-11-05 UTC
- RFC 9110 HTTP Semantics, 422 Unprocessable Content, IETF, 2022-06
- Permisos de actors, documentación de Apify, leído 2026-11-05 UTC
- Almacenamiento, documentación de Apify, leído 2026-11-05 UTC
- Ejecuciones y versiones de actors, documentación de Apify, leído 2026-11-05 UTC
- API v2 de Apify, documentación de Apify, versión 2026-11-04
- Introducción y guía de robots.txt, Google Search Central, leído 2026-11-05 UTC
- Proxy, documentación de Apify, leído 2026-11-05 UTC
Referencia BL-99