Alternativa a Serper API: precios, plan gratis y pruebas
Precios de Serper API frente a EveryInfra: 1,00 frente a 0,694 USD por 1000 búsquedas, créditos que caducan a los 6 meses y 35 llamadas reales.
Por 1000 búsquedas web, el paquete de entrada Starter de Serper tiene un precio público de 1,00 USD. EveryInfra cobró 0,694 USD por 1000 en nuestra prueba: 35 llamadas reales el 26 de octubre de 2026, de 13:37 a 13:43 hora de Singapur, de las que se cobraron 29. Es 1,44 veces más barato. Los créditos de Serper caducan a los seis meses y el paquete mínimo es de 50 USD, así que con 1000 búsquedas al mes se pagan en realidad 8,33 USD por 1000, 12 veces nuestro precio. Todo esto vale solo por debajo de unas 300 000 búsquedas al mes: por encima de esa cifra, los dos paquetes grandes de Serper cuestan menos que nosotros, y lo decimos tal cual.
En este artículo, «alternativa a Serper API» quiere decir una API de pago por llamada que recibe una palabra clave y devuelve una página de resultados web: título, enlace, fragmento y posición, y además noticias, lugares, compras, imágenes y resultados académicos. Comparamos solo cuatro cosas: el precio por 1000 llamadas, cómo cuenta cada lado una llamada, qué pasa cuando una llamada falla o no encuentra nada, y cuántos pasos hacen falta para empezar. No comparamos los nombres de los campos de las dos respuestas. Nuestros campos están en nuestro propio catálogo de herramientas de búsqueda.


La respuesta corta en una tabla
La tabla tiene dos tipos de cifras. Las primeras son los precios y reglas públicos de Serper, tomados de la sección de precios de serper.dev, que leímos el 26 de octubre de 2026 a las 13:32 hora de Singapur; guardamos una copia del texto de la página en archivo. Las segundas son lo que devolvió nuestra API en llamadas reales ese mismo día. No abrimos cuenta en Serper, no compramos créditos y no usamos ninguna clave de Serper. Cuando una regla solo se ve tras iniciar sesión, la tabla dice «no figura en la página».
| Aspecto | Serper (página pública) | EveryInfra (medido) |
|---|---|---|
| Precio por 1000 llamadas | 1,00 / 0,75 / 0,50 / 0,30 USD según el paquete | 0,694 USD, un solo nivel |
| Pago mínimo | 50 USD (Starter, 50 000 créditos) | 10 USD (recarga mínima) |
| Caducidad | Créditos válidos 6 meses | El saldo no caduca |
| Uso gratis | 2500 consultas, sin tarjeta | 1 USD de prueba (unas 1440 búsquedas), válido 24 horas, con una estrella en GitHub |
| Más de 10 resultados por llamada | 2 créditos, según usuarios | Hasta 10 por página, una llamada por página; page para más |
| Cuándo se cobra | En cada respuesta correcta | Solo si hay resultados; las vacías se reembolsan |
| 401, 422, 429 | No figura en la página | No se cobran; la respuesta dice «Nothing was charged» |
| Reembolso | Total en 7 días desde la primera compra si se usó menos del 20 % | El saldo se queda; no hay caducidad que reembolsar |
| Tipos de resultado | Search, Images, News, Maps, Places, Videos, Shopping, Scholar, Patents, Autocomplete | web, news, places, shopping, media (imágenes y vídeos), scholar (artículos y patentes), suggest y 10 más |
| Límite de ritmo | 50 por segundo en Starter, hasta 300 por segundo en Ultimate | 10 por minuto en nuestra clave de prueba; depende de la cuenta |
| MCP | Sin servidor propio en la página; hay servidores de terceros en GitHub | Punto MCP remoto propio con una herramienta, everyinfra_search |
Dos filas de esta tabla no aparecen en la columna de precio, pero deciden la factura real: la de caducidad y la de «más de 10 resultados». Las secciones siguientes desmontan el precio de Serper, explican de dónde sale el nuestro y comprueban cada celda con cinco grupos de llamadas reales.
Precios de Serper API: cuatro paquetes prepagados, válidos seis meses
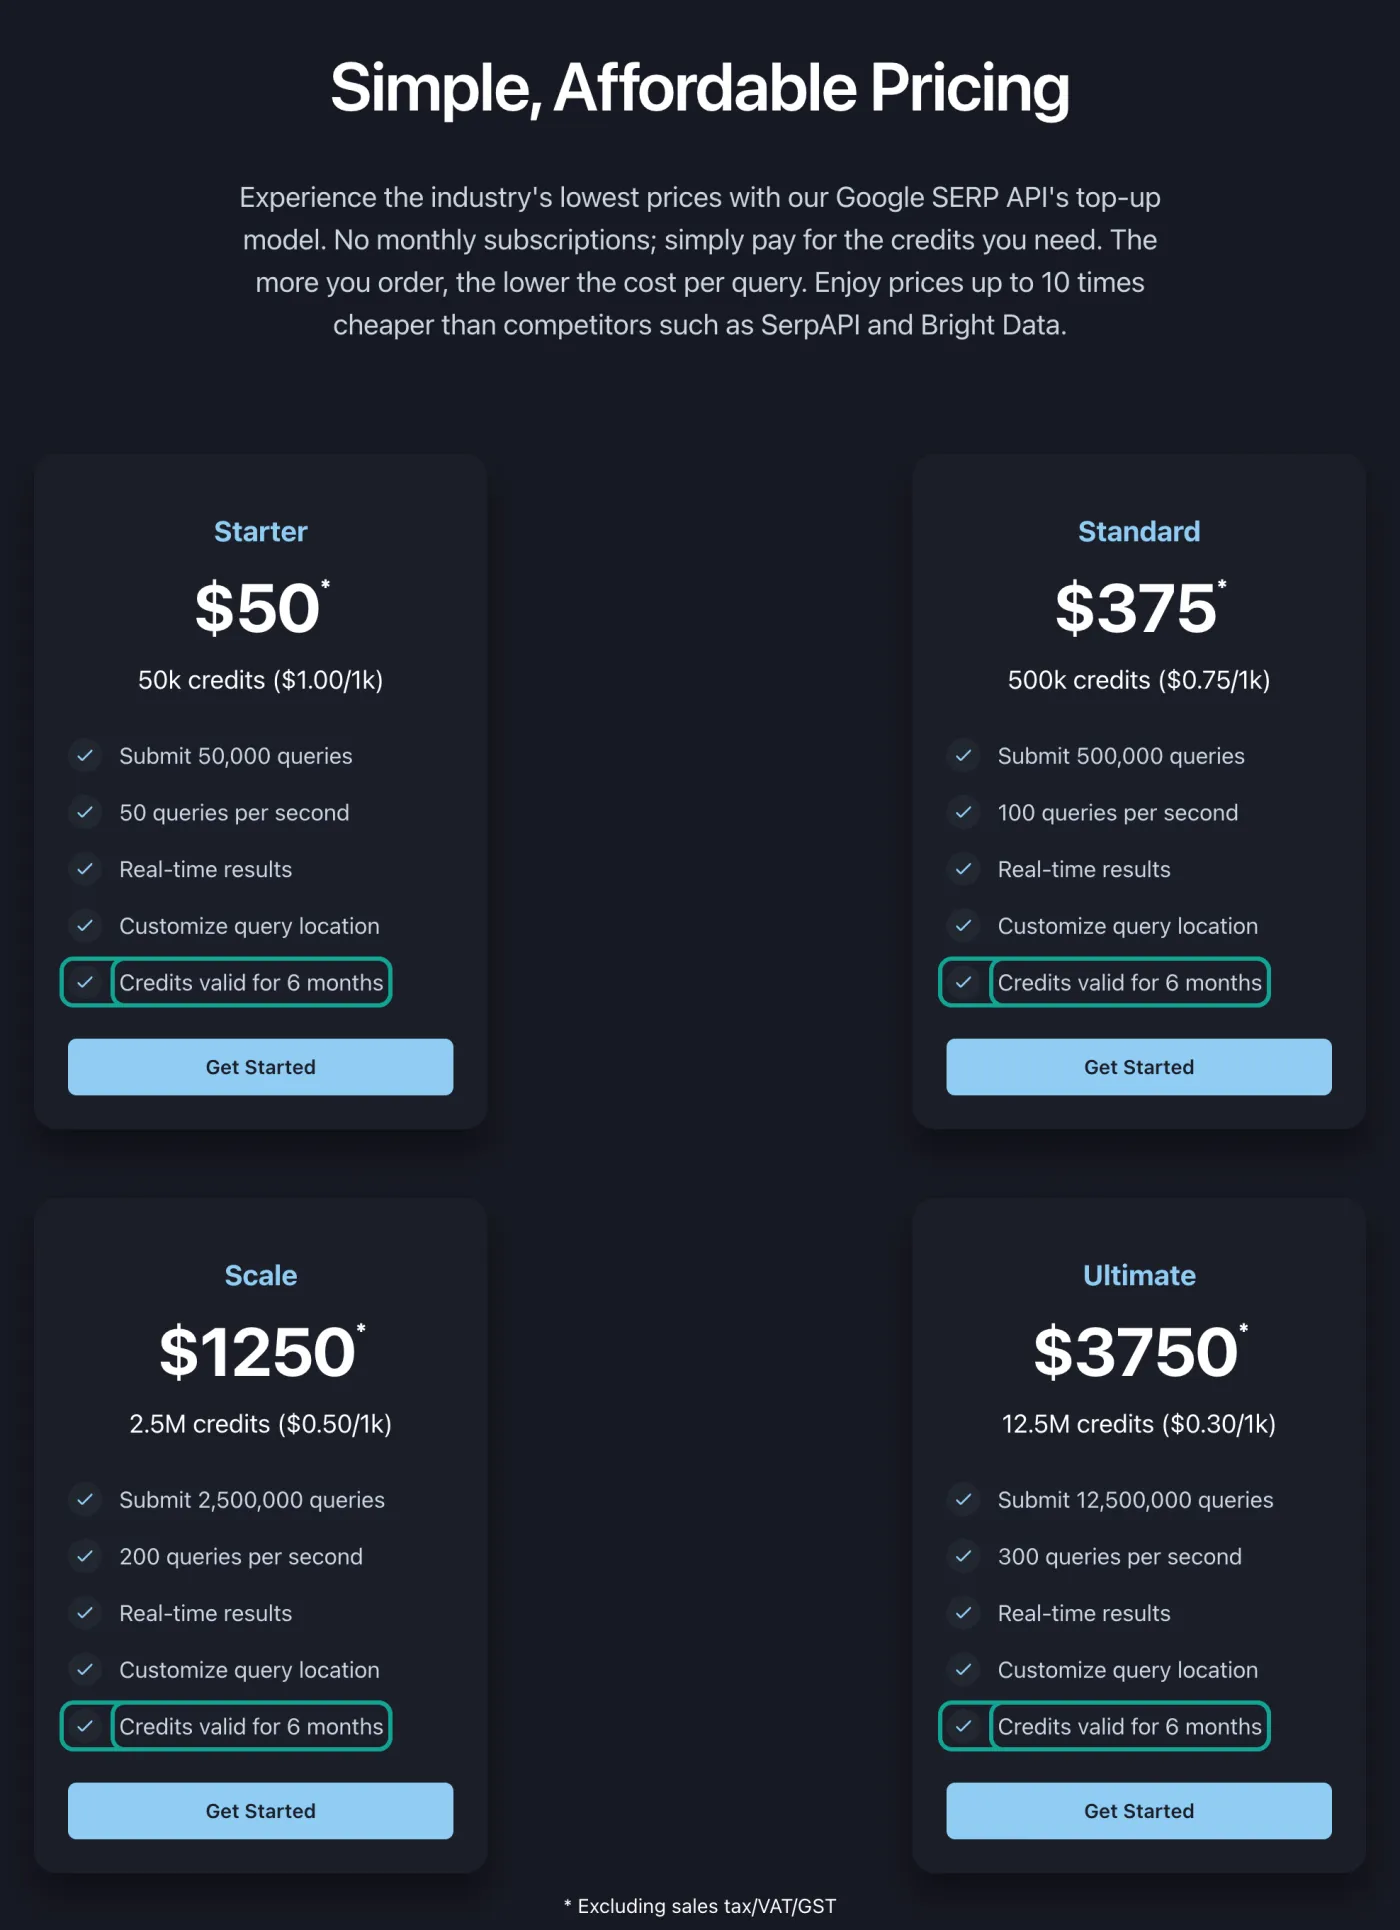
Serper vende paquetes prepagados. La página dice «No monthly subscriptions; simply pay for the credits you need»: sin suscripción, se compran créditos y se usan. Hay cuatro paquetes. Starter cuesta 50 USD por 50 000 créditos, es decir 1,00 USD por 1000, a 50 consultas por segundo. Standard cuesta 375 USD por 500 000 créditos, 0,75 USD por 1000, a 100 por segundo. Scale cuesta 1250 USD por 2,5 millones de créditos, 0,50 USD por 1000, a 200 por segundo. Ultimate cuesta 3750 USD por 12,5 millones, 0,30 USD por 1000, a 300 por segundo.
Las cuatro tarjetas terminan con la misma línea: «Credits valid for 6 months». Una nota bajo las tarjetas aclara que los precios no incluyen impuesto sobre ventas, IVA ni GST. Si estás en España o en México, esto importa: el precio de la tarjeta no es el que pagas. La captura de abajo muestra las cuatro tarjetas con esa línea marcada.
Las preguntas frecuentes de la misma página dan tres reglas más sobre dinero. Primera, cuándo se descuentan créditos: «cada vez que se reciben respuestas correctas a las consultas»; cuando el saldo llega a cero, Serper deja de aceptar consultas nuevas. Segunda, reembolsos: devolución total en los 7 días posteriores a la primera compra si se usó menos del 20 % de los créditos. Los términos del servicio dicen lo mismo en su sección Refund Policy, y la página de términos indica una actualización del 29 de mayo de 2024. Tercera, pago: Visa, Mastercard, American Express, Discover y PayPal.
Hay una regla que no está en las tarjetas, pero que los usuarios repiten. Una llamada que pide más de 10 resultados cuesta 2 créditos. Un usuario de Hacker News escribió que Serper cuenta «10 resultados como 1 crédito, y de 20 a 100 resultados como 2 créditos» (hilo de Hacker News). Así, 10 resultados por llamada cuestan 1 USD por 1000 llamadas, y 100 resultados por llamada, 2 USD. No tenemos cuenta en Serper y no podemos comprobar esta regla hoy, así que en este artículo es un dato de usuarios y los gráficos lo separan de los precios de la página.
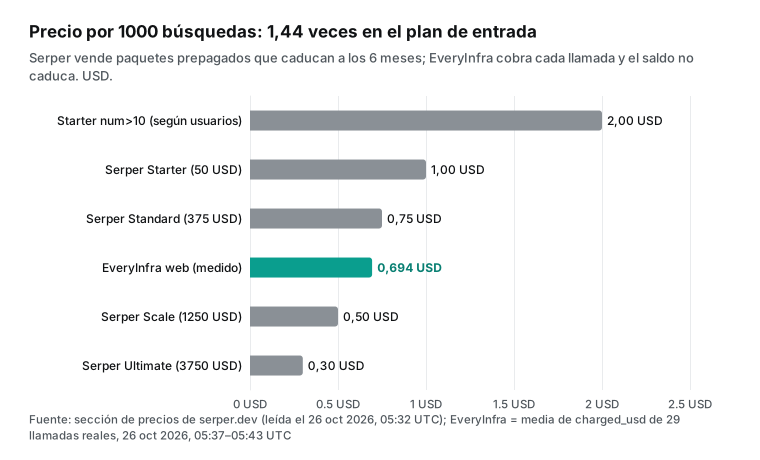
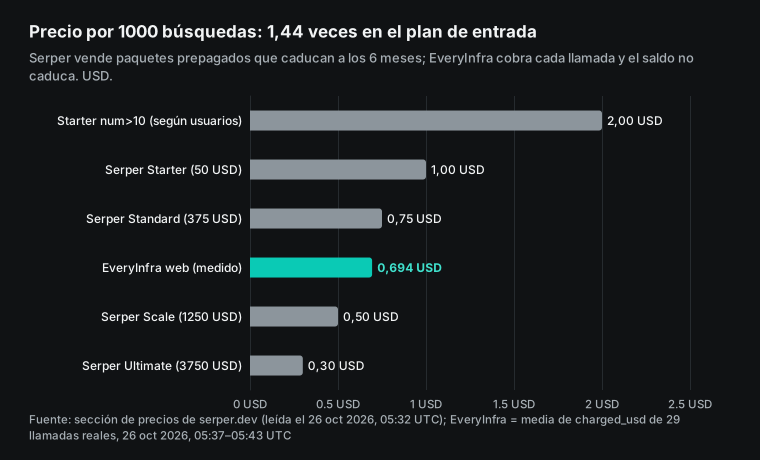
Por tanto, el precio real de Serper por 1000 depende de tres cosas: el paquete que compras, la parte que usas en seis meses y el número de resultados por llamada. Las tarjetas solo muestran la primera. La segunda es la línea pequeña al final de cada tarjeta. La tercera vive en los foros. Un usuario en un hilo de Reddit sobre APIs de resultados lo resumió así: Serper parece barato hasta que traduce los créditos a su carga de trabajo real (hilo en r/WebScrapingInsider).
Cuánto sube el precio por la caducidad: el coste real según el volumen
Esta sección es un cálculo nuestro. Supongamos que haces V búsquedas al mes. Los créditos de Serper caducan a los seis meses, así que cada seis meses debes comprar al menos 6V créditos. Probamos todas las combinaciones de los cuatro paquetes, tomamos la más barata y la dividimos entre 6V: ese es el precio que de verdad pagas por 1000. EveryInfra no caduca, así que nuestro precio se queda en 0,694 USD. Nuestro guion lee los cuatro precios del texto guardado de la página, sin copiar ninguna cifra a mano; guion y página quedan en archivo.
La tabla muestra el resultado. Un proyecto pequeño, de 1000 búsquedas al mes, necesita igualmente un paquete Starter: usa 6000 créditos en seis meses y caducan 44 000, lo que da 8,33 USD por 1000. Con 5000 al mes, el precio real es 1,67 USD. Solo con 8333 al mes exactos, cuando agotas un Starter en seis meses, pagas el 1,00 USD de la tarjeta. Con unas 83 000 al mes agotas un Standard, a 0,75 USD, que sigue siendo un 8 % más que nuestro precio. Los dos lados se igualan en 300 000 al mes, cuando agotas un paquete Scale de 1250 USD en seis meses.
| Búsquedas al mes | Necesarias en 6 meses | Paquetes Serper más baratos | Precio real Serper por 1000 | EveryInfra por 1000 | Serper ÷ EveryInfra |
|---|---|---|---|---|---|
| 1000 | 6000 | 1 Starter (50 USD) | 8,33 USD | 0,694 USD | 12,0 veces |
| 5000 | 30 000 | 1 Starter (50 USD) | 1,67 USD | 0,694 USD | 2,4 veces |
| 20 000 | 120 000 | 3 Starter (150 USD) | 1,25 USD | 0,694 USD | 1,8 veces |
| 83 333 | unas 500 000 | 1 Standard (375 USD) | 0,75 USD | 0,694 USD | 1,08 veces |
| 300 000 | 1,8 millones | 1 Scale (1250 USD) | 0,694 USD | 0,694 USD | 1,0 veces |
| 500 000 | 3 millones | Standard + Scale (1625 USD) | 0,54 USD | 0,694 USD | 0,78 veces |
| 2 083 333 | 12,5 millones | 1 Ultimate (3750 USD) | 0,30 USD | 0,694 USD | 0,43 veces |
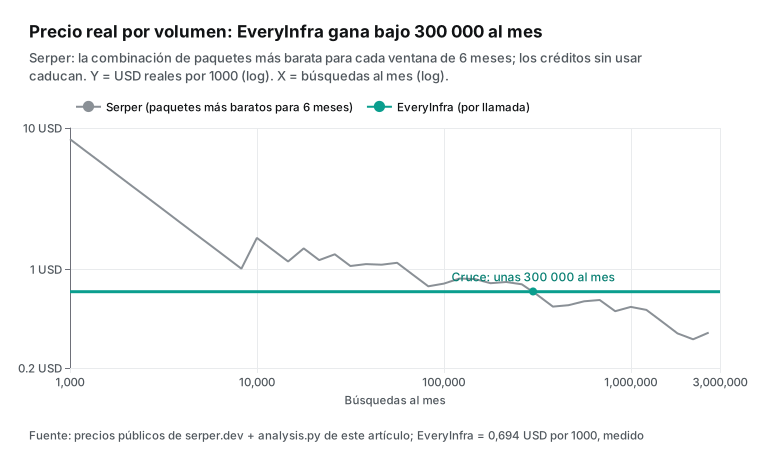
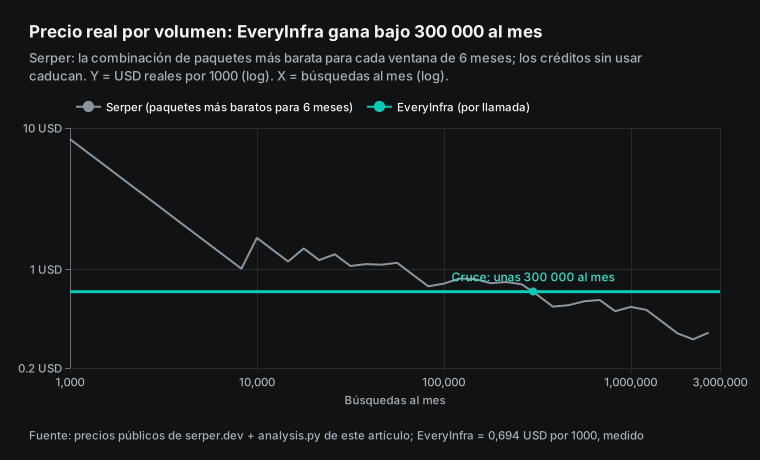
El cálculo tiene tres límites. Primero, supone una compra cada seis meses; si compras un Starter cada mes, un proyecto de 1000 al mes paga 50 USD mensuales y el precio real sube, no baja. Segundo, usa solo los cuatro precios públicos, sin precios privados para grandes clientes ni impuestos. Tercero, el cruce sale del precio de Scale: 1250 USD divididos entre nuestros 0,000694 USD por llamada son 1,8 millones de llamadas en seis meses, o 300 000 al mes. Ultimate necesita 5,4 millones en seis meses para ganarnos. Standard y Starter nunca nos ganan, porque sus precios de tarjeta, 0,75 y 1,00 USD, ya superan 0,694 USD.
De dónde sale el precio de EveryInfra
EveryInfra cobra la búsqueda por llamada. El precio está en el catálogo público de herramientas de búsqueda, que se puede leer sin clave. Su lista billing.tiers tiene tres niveles. Estándar cuesta 0,000694 USD por llamada, 0,694 USD por 1000, y ahí está casi todo. Profundo cuesta 0,001389 USD, para el modo profundo de la búsqueda semántica. Verificación cruzada cuesta 0,002778 USD, porque ejecuta varias búsquedas a la vez. La herramienta web está en el nivel estándar. El mismo precio aparece en nuestra página de precios y en la página del producto de búsqueda.


No nos quedamos en la cifra del catálogo: la contrastamos con las respuestas reales. Cada respuesta cobrada trae un objeto billing con charged y charged_usd. En nuestra prueba, las 29 llamadas cobradas tenían charged_usd igual a 0,000694. La media por 1000 da 0,694 USD, igual que el catálogo. Un precio fijo por llamada permite calcular la factura antes de ejecutar nada: una ronda de 10 palabras clave cuesta 0,00694 USD y una de 10 000 palabras clave, 6,94 USD.
Esta es la solicitud. La clave sale de una variable de entorno y nunca se escribe en un archivo.
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"mejores tenis para correr 2026","num":10,"location":"mx"}}'
La herramienta web tiene 7 parámetros. q es la consulta. site limita los resultados a un dominio, igual que escribir site: en la consulta. location es la región: nombre del país o código de dos letras, y una ciudad cuenta como su país. after y before dejan solo resultados posteriores o anteriores a una fecha. page es la página de resultados, desde 1. num es el número de resultados por página, hasta 10, con 10 por defecto; un valor mayor devuelve 10 sin error. Cada resultado tiene title, url y snippet, y además published cuando hay fecha. El catálogo da a cada herramienta units: 1 y price_usd: 0.000694: una solicitud es una unidad de cobro, sea cual sea el num.
Si necesitas controlar mejor país e idioma, nuestro catálogo de datos tiene la capacidad web/search, con los parámetros country y language, a 0,001389 USD por llamada, el nivel estándar de datos. Aparece en el catálogo de datos. Es una segunda entrada, junto a la herramienta web, y encaja cuando hay que filtrar resultados por idioma, por ejemplo español de México frente a español de España.
¿Por 1000 llamadas o por 1000 resultados?
Hasta aquí hemos contado llamadas, pero muchos equipos cuentan resultados: un rastreador de posiciones quiere el top 30 y un equipo de investigación, los 50 primeros. El número de resultados por llamada fija la factura, y el propio buscador limita ese número.
En nuestra prueba, la herramienta web de EveryInfra devolvió de media 9,3 resultados por llamada, es decir 0,0746 USD por 1000 resultados (0,0694 USD con páginas completas de 10). En el lado de Serper hay dos casos y mostramos ambos. En el primero, una llamada sigue trayendo unos 10 resultados, como ocurre desde que Google retiró num=100: entonces Starter cuesta 0,10 USD por 1000 resultados, o 0,20 USD con num=100 a 2 créditos, entre 1,3 y 2,7 veces nuestro precio. En el segundo, Serper sí devuelve 100 resultados con num=100: entonces cuesta 0,02 USD por 1000 resultados, 3,7 veces menos que nosotros.
No podemos saber cuál de los dos casos es el real hoy, porque no tenemos cuenta en Serper, y el comentario de Hacker News citado arriba es anterior al cambio de Google. Si tu trabajo necesita resultados profundos por palabra clave, prueba esto primero: con los créditos gratis de Serper, haz una llamada con num=100 y cuenta los resultados orgánicos y los créditos gastados. La prueba no cuesta nada y convierte una suposición en un dato. Nuestra parte de la respuesta está en la sección siguiente: una página trae hasta 10 resultados y cobra una llamada, y para más hay que pedir más páginas con page.
Los cinco grupos de prueba, de un vistazo
| Grupo | Hora (Singapur) | Herramientas | Llamadas | Cobradas | Resultado principal |
|---|---|---|---|---|---|
| 1. num y página | 13:37–13:42 | web | 5 | 5 | 9–10 resultados por página, hasta 10 |
| 2. País, sitio, fecha | 13:38–13:40 | web | 5 | 5 | Sitios locales por país; site dio 3 resultados |
| 3. Posiciones | 13:41–13:43 | web | 10 | 10 | 96 resultados, 0,00694 USD, mediana 2,07 s |
| 4. Tipos de resultado | 13:39–13:40 | otras 8 herramientas | 9 | 9 | 10 resultados cada una; read dio 1 página |
| 5. Casos de cobro | 13:38–13:41 | web | 6 | 0 | Vacía, 422, 401 y 3 × 429, todas gratis |
En total son 35 llamadas y 29 cobradas. Tres llamadas recibieron primero un 429 y las enviamos otra vez: los reintentos cuentan en los grupos 2, 3 y 4, y los tres 429 cuentan en el grupo 5. Registramos cada llamada con su hora, estado, segundos, resultados y cobro, y guardamos el registro en archivo.
Prueba 1: num y página, resultados por llamada y llamadas cobradas
Empezamos por los parámetros que fijan el precio por resultado. El 26 de octubre de 2026, a las 13:37, 13:38 y 13:42 hora de Singapur, enviamos cinco llamadas. num=10, num=100 y página 2 usaron la consulta «best running shoes 2026»; num=20 y página 3 usaron «best crm software for small business», de la prueba 3. Una página trae hasta 10 resultados: num=10 devolvió 9 y num=20 devolvió 10; num=100 devolvió la misma página, las 9 URL de num=10. Las páginas 2 y 3 devolvieron 10 cada una, sin repetir ningún resultado de la página 1 de la misma consulta. Las cinco llamadas se cobraron una vez cada una, a 0,000694 USD. El catálogo ahora también fija en 10 el máximo de num para web (news, scholar y forum también 10, places 20, shopping 40). A las 16:04 SGT lo comprobamos otra vez: num=100 devolvió 9 resultados sin error y page=2 devolvió 10, sin URL repetidas entre las dos páginas.
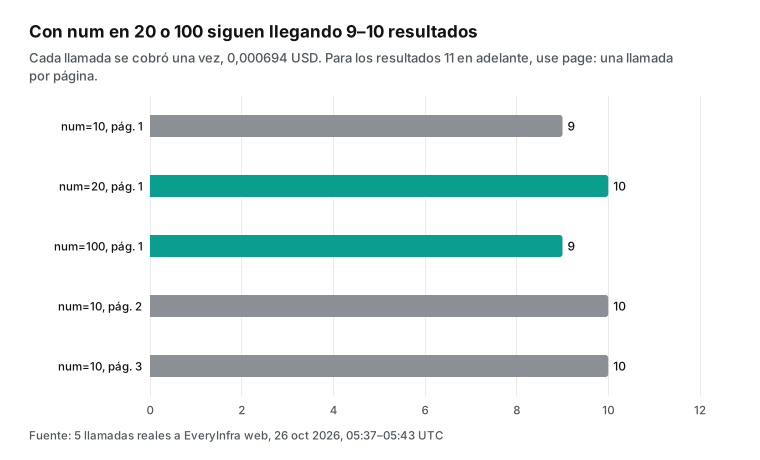
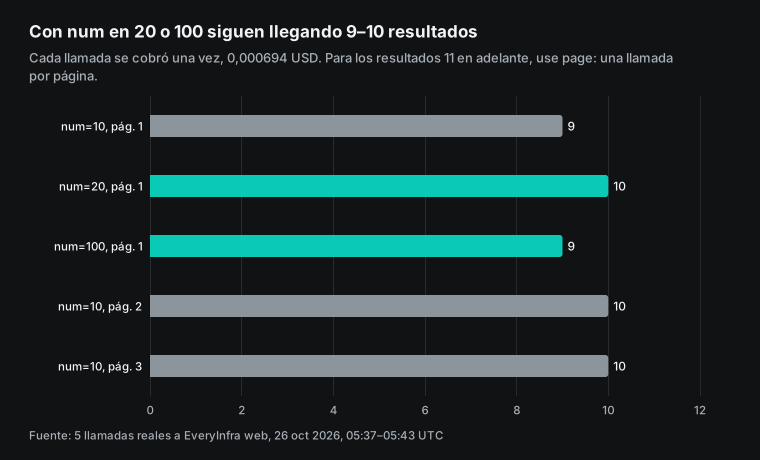
¿Por qué una página trae como máximo 10 resultados? Porque cambió el buscador. En septiembre de 2025, Google dejó de mostrar 100 resultados por página mediante un parámetro de la URL; un portavoz de Google dijo a Search Engine Land que ese parámetro «no es algo que admitamos formalmente» (Search Engine Land, 18 de septiembre de 2025). La propia Custom Search JSON API de Google limita num a valores de 1 a 10. Hoy casi cualquier API necesita paginar para pasar del resultado 10.
Esto afecta al precio. Si Serper sigue cobrando 2 créditos por encima de 10 resultados y una página solo trae unos 10, una llamada con num=100 paga el doble por casi los mismos resultados. No podemos probarlo en Serper. Nuestro lado está claro: una página trae hasta 10 resultados y cobra una llamada. Para 30 resultados se piden 3 páginas y se paga 3 veces, 0,002083 USD en total. En las 20 llamadas web cobradas de esta prueba obtuvimos 186 resultados, 9,3 por llamada: 0,0746 USD por 1000 resultados, o 0,0694 USD con páginas completas.
Prueba 2: país y resultados locales, con México como ejemplo
El segundo grupo prueba el parámetro de región. Escribimos cada consulta en el idioma local y pusimos location en el país correspondiente. «mejores tenis para correr 2026» fue a México a las 13:38 hora de Singapur; «beste laufschuhe 2026» fue a Alemania a las 13:38; una consulta en chino sobre zapatillas fue a Taiwán a las 13:38. La llamada de México devolvió 10 resultados que mezclan sitios en inglés, como runnersworld.com y runrepeat.com, con sitios en español, como runnea.com, correrjuntos.com y sprintersports.com, además de YouTube, Reddit y TikTok. La de Alemania trajo medios alemanes como stern.de y faz.net y tiendas como alltricks.de y sport-conrad.com. La de Taiwán trajo adidas.com.tw, salomon.com.tw y medios de Hong Kong.
Para un lector en México hay un detalle útil: la palabra «tenis» es la forma local de decir zapatillas deportivas, y los resultados la tomaron bien. Si la misma consulta se escribe con «zapatillas», como en España, conviene repetir la prueba con location en España y comparar. El parámetro de región cambia los resultados, pero es una preferencia y no un filtro. El catálogo lo dice claro: location influye en el origen de los resultados, pero no garantiza que todos estén en ese país.
La página de Serper dice que se puede fijar la ubicación de la búsqueda por país e idioma. El código del envoltorio de LangChain muestra los parámetros habituales: gl para el país, hl para el idioma, tbs para el rango de tiempo y type para el tipo de resultado; los valores por defecto son gl=us y hl=en. Nuestra herramienta web no tiene un parámetro aparte para el idioma de la interfaz: el idioma lo marca la consulta y el país, location. Para filtrar por idioma, usa web/search, descrito en la sección anterior.
En este grupo también probamos los límites de sitio y fecha. A las 13:38 hora de Singapur, site=serper.dev con la consulta «pricing» devolvió solo 3 resultados, todos de serper.dev; el primer fragmento listaba los cuatro precios, igual que nuestra copia guardada de la página. A las 13:40, after=2026-10-01 con «search api pricing» devolvió 10 resultados, y los 9 que tenían fecha eran de octubre: el más antiguo, del 2026-10-06, y el más reciente decía «3 days ago», es decir, el 2026-10-23 contando desde el día de la prueba. Así, site y after reducen de verdad el conjunto, no solo lo reordenan: el menor número de resultados es la prueba. Para monitorizar, after deja solo las páginas nuevas, lo que cuesta menos que traerlo todo y quitar duplicados.
| Tarea | Parámetro de Serper (según envoltorios públicos) | Herramienta de EveryInfra | Nota |
|---|---|---|---|
| Resultados de un país | gl | location (nombre o código de dos letras) | Ambos son preferencia, no filtro |
| Resultados en un idioma | hl | No en web; language en web/search | Etiquetas de idioma según RFC 5646, por ejemplo es-MX |
| Ventana de tiempo | tbs | after, before (fechas) | Fechas normales, sin códigos cortos |
| Un solo sitio | site: en la consulta | parámetro site o site: | site=serper.dev dio 3 resultados |
| Página siguiente | page | page | Una llamada por página |
| Resultados por llamada | num (2 créditos por encima de 10, según usuarios) | Hasta 10 por página, una llamada por página, page para más | Unos 9–10 por página en la prueba |
Prueba 3: posiciones de 10 palabras clave, coste y velocidad
El tercer grupo copia el trabajo más común: un equipo de contenidos o SEO revisa cada día el top 10 de una lista de palabras clave. El 26 de octubre de 2026, de 13:41 a 13:43 hora de Singapur, revisamos 10 palabras clave en inglés con location en Estados Unidos, desde «best crm software for small business» hasta «best air purifier». Las 10 llamadas funcionaron, devolvieron 96 resultados en total, costaron 0,00694 USD y tuvieron una mediana de 2,07 segundos.
Esos 96 resultados también dicen algo que interesa a un equipo SEO. Venían de 64 dominios distintos y 58 traían fecha. reddit.com apareció en el top 10 de las 10 palabras clave: tercero en 9 de ellas y segundo en la otra. nytimes.com y youtube.com aparecieron en 5 palabras cada uno. Las 10 URL en primera posición eran de 10 sitios distintos, casi todos webs de producto o de reseñas. Es decir, en consultas del tipo «best + categoría», un hilo de foro ocupa casi siempre un puesto del top 3. Si sigues posiciones, no basta con mirar la tuya: cuenta también cuántos puestos ocupan foros y vídeos en la misma página, porque empujan hacia abajo a los resultados orgánicos. Revisar estas 10 palabras una vez al día son 300 llamadas al mes, 0,21 USD.
Llevemos la ronda a escala real con un ejemplo cercano: una agencia SEO en Ciudad de México que revisa 500 palabras clave al día, solo la primera página. Son 15 000 llamadas al mes. En EveryInfra, 15 000 × 0,000694 = 10,42 USD. En Serper necesita 90 000 créditos en seis meses; lo más barato son 2 paquetes Starter, 100 USD, es decir 16,67 USD al mes o 1,11 USD por 1000. Si la agencia quiere el top 30 de cada palabra clave, en nuestro lado son 3 páginas: 45 000 llamadas al mes y 31,25 USD. En Serper, si envía num=30 una vez y cuesta 2 créditos como dicen los usuarios, necesita 30 000 créditos al mes y 180 000 en seis meses; lo más barato son 4 Starter, 200 USD, unos 33,33 USD al mes. Los dos lados quedan cerca. La lección es escribir primero su patrón exacto de consultas y comparar después.
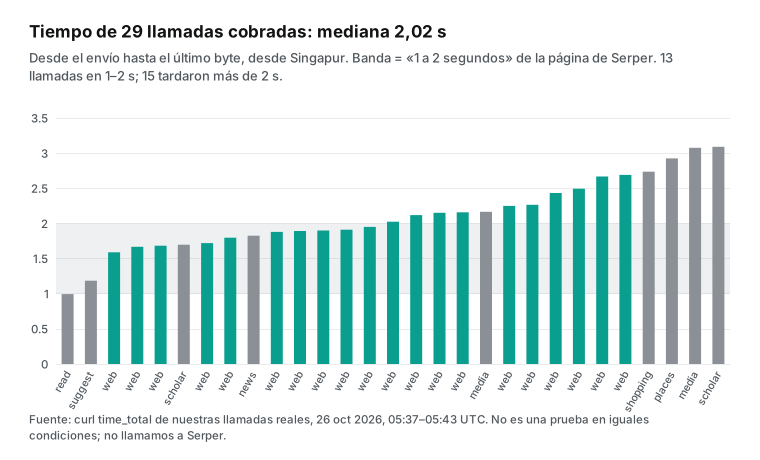
Damos la velocidad tal como la medimos. En las 29 llamadas cobradas, del envío al último byte, la mediana fue 2,02 segundos y el percentil 90, 2,77 segundos; la más rápida tardó 0,99 segundos y la más lenta, 3,09; 15 llamadas tardaron más de 2 segundos. Medimos desde una máquina en Singapur, así que el tiempo incluye la red; desde Ciudad de México o Madrid el tiempo será distinto. La página de Serper dice que los resultados llegan «en 1 o 2 segundos», y en 2 a 4 cuando hace falta un reintento. No llamamos a Serper, así que no es una prueba en igualdad de condiciones. Si tu aplicación espera la búsqueda dentro de una respuesta de chat, prueba los dos lados con 50 de tus consultas reales antes de decidir.
Tres usuarios reales, tres facturas mensuales
La curva de arriba usa unas abstractas «V búsquedas al mes». Aquí van tres trabajos reales. Una sola función genera cada cifra: EveryInfra es el número de llamadas cobradas por 0,000694 USD; Serper es la combinación más barata de los cuatro paquetes para seis meses de uso, dividida entre seis.
| Trabajo | Llamadas al mes | EveryInfra al mes | Serper al mes (paquetes más baratos) | Relación |
|---|---|---|---|---|
| Asistente de IA de un desarrollador, unas 100 búsquedas al día | 3000 | 2,08 USD | 8,33 USD (1 Starter, 36 % usado en 6 meses) | 4,0 veces |
| Agencia que revisa la página 1 de 500 palabras clave al día | 15 000 | 10,42 USD | 16,67 USD (2 Starter) | 1,6 veces |
| La misma agencia, top 30 de cada palabra clave (3 páginas) | 45 000 | 31,25 USD | 50,00 USD (6 Starter) | 1,6 veces |
| Monitorización de marca, con un 15 % de resultados vacíos como supuesto | 200 000 | 118,05 USD | 158,33 USD (4 Starter + 2 Standard) | 1,34 veces |
| Lo mismo, sin resultados vacíos | 200 000 | 138,89 USD | 158,33 USD | 1,14 veces |
La primera fila es la que más dice. Un asistente de IA que busca unas 100 veces al día necesita 3000 llamadas al mes. En EveryInfra son algo más de 2 USD al mes. En Serper, el paquete mínimo es de 50 USD; en seis meses usa 18 000 créditos y caducan 32 000, así que paga 8,33 USD al mes. Para este usuario el problema no es el precio unitario, sino pagar 50 USD y ver cómo caducan. Las 2500 consultas gratis de Serper cubren las primeras semanas, pero el primer pago después de eso es de 50 USD.
El «15 % vacío» de la cuarta fila es un supuesto nuestro, no una medición: en nuestras 35 llamadas solo una salió vacía, y la provocamos a propósito. La monitorización de marca sigue marcas nuevas, modelos de producto y temas de nicho, así que no encuentra nada mucho más a menudo que una búsqueda corriente. Nosotros reembolsamos los resultados vacíos, de modo que un 15 % de llamadas vacías baja la factura de 138,89 a 118,05 USD. La página de Serper dice que los créditos se descuentan en las respuestas correctas, pero no dice si una respuesta vacía cuenta como correcta; por eso la tabla cobra todas las llamadas en el lado de Serper, que es el límite superior. Si Serper no cobra las vacías, la cuarta fila vuelve al 1,14 de la quinta.
Prueba 4: noticias, lugares, compras, imágenes, académicos y otros tipos de resultado
Al elegir una API de búsqueda no basta con los resultados web: también hay que ver si llegan los otros tipos que usa tu producto. La tabla los agrupa por tipo de resultado. La columna «Lo lista Serper» solo dice si ese tipo aparece en la lista de resultados de la página de Serper. Las tres últimas son nuestras llamadas, una por tipo con la herramienta de EveryInfra, entre las 13:39 y las 13:40 hora de Singapur; cada una se cobró a 0,000694 USD.
| Resultado que necesitas | Lo lista Serper | Herramienta de EveryInfra | Resultados | Qué llegó |
|---|---|---|---|---|
| Web | Sí | web | 9–10 | Título, URL, fragmento, fecha |
| Noticias | Sí | news | 10 | Noticias sobre la API de búsqueda de DeepSeek; la más nueva, de hace 1 día |
| Lugares y mapas | Sí | places | 10 | Cafeterías de Singapur con nota, número de valoraciones, dirección, teléfono, coordenadas y horario |
| Compras | Sí | shopping | 10 | Zapatillas con precio, tienda y nota |
| Imágenes | Sí | media (kind=image) | 10 | Títulos y URL de imágenes |
| Vídeos | Sí | media (kind=video) | 10 | Títulos y URL de vídeos |
| Artículos académicos | Sí | scholar | 10 | Títulos, URL y fragmentos de artículos |
| Patentes | Sí | scholar (kind=patents) | 10 | Títulos, URL y fragmentos de patentes |
| Autocompletado | Sí | suggest | 10 | 10 sugerencias para «serper api» |
| Texto de una página | No está en su lista | read | 1 | El texto de una URL |
Sobre lugares, una nota más. El primer resultado de places fue una cafetería de Singapur con 4,7 de nota y 2324 valoraciones, con dirección, teléfono y coordenadas. Si necesitas todas las reseñas de un local, una herramienta de búsqueda no basta: usa google_maps_reviews/search y las capacidades de reseñas del catálogo de datos, a 0,001389 USD por llamada en el nivel estándar de datos; la página de la plataforma es la API de reseñas de Google Maps. Para resultados locales en Corea y Rusia, usa naver/search y yandex/search.
Dos llamadas de este grupo ayudaron a escribir el artículo. La primera fue suggest: a las 13:40 hora de Singapur le preguntamos por «serper api» y devolvió 10 sugerencias, entre ellas «serper api pricing», «serper api free tier» y «serper api key free», que coincidían con lo que habíamos encontrado con otra herramienta antes de escribir y que fijaron el título y las preguntas frecuentes. La segunda fue news, sobre «DeepSeek search API»: las 10 noticias tenían entre 1 día y 1 semana, lo que encaja con el lanzamiento de DeepSeek del 17 de octubre de 2026, que es la primera entrada de la sección de cambios recientes.
La llamada de shopping también merece una mirada. Las 10 zapatillas llegaron con precio, tienda y nota; la primera era unas Nike Revolution 8 de DICK'S Sporting Goods a 74,99 USD. Pero su url apunta a la página de producto del propio buscador, no a la tienda. Si construyes comparadores de precios, ten esto en cuenta: para stock, tallas y reseñas de la tienda, lee la página de producto con una capacidad de comercio electrónico del catálogo de datos y no te fíes solo del precio de un resultado de búsqueda.
Prueba 5: resultados vacíos, límite de ritmo, parámetro erróneo y sin clave
Aquí es donde más se diferencian los dos lados. La página de Serper dice que los créditos se descuentan en cada respuesta correcta, pero no define qué es correcta. ¿Una respuesta 200 con cero resultados lo es? La página no lo dice. En nuestro lado la regla va en cada respuesta, y esto es lo que medimos.
El 26 de octubre de 2026, a las 13:40 hora de Singapur, buscamos una frase que no existe. La respuesta fue 200 sin resultados; su billing decía charged: false, charged_usd: 0.0 y reason: empty_result_refunded, y refund.status era succeeded. En el mismo minuto enviamos gl, un parámetro que web no acepta: la respuesta fue 422, el mensaje listaba los 7 parámetros que web acepta y terminaba con «Nothing was charged». Una llamada sin clave devolvió 401 y también decía que no se había cobrado nada.
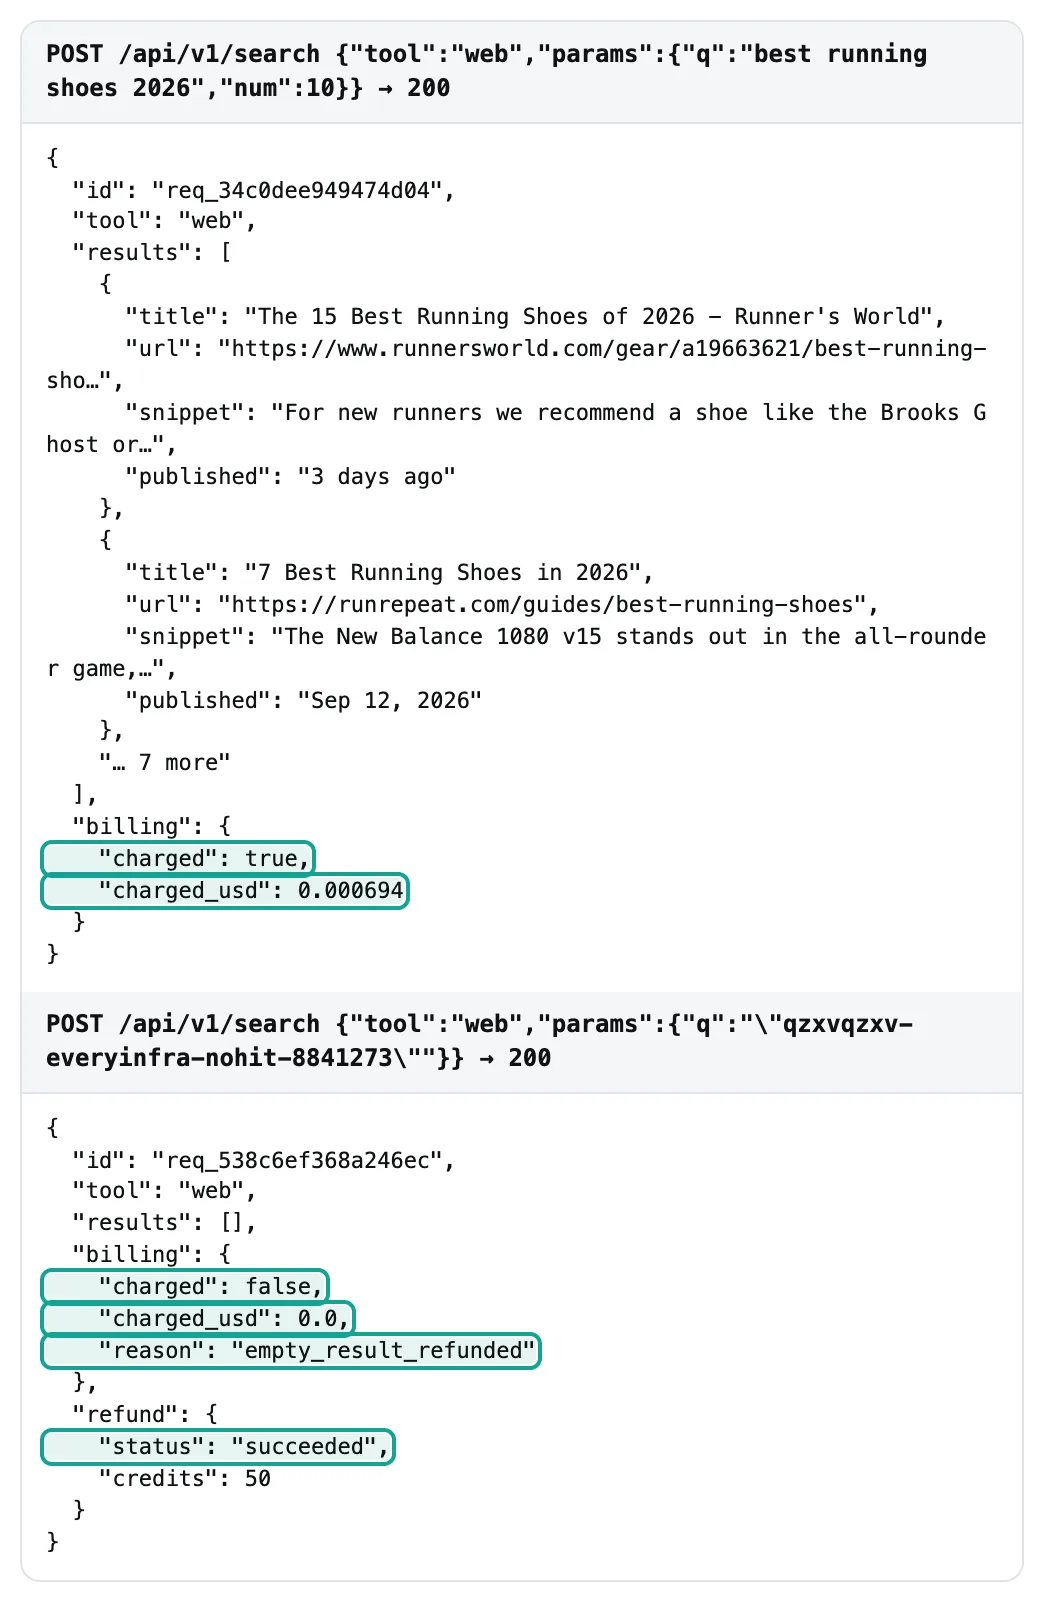
También topamos con un límite sin querer. Nuestra clave de prueba admite 10 llamadas por minuto y recibimos un 429 a las 13:38, 13:39 y 13:41 hora de Singapur; la respuesta decía «10 requests per minute for this API key's own limit. Retry after 7s» y, otra vez, «Nothing was charged». La RFC 6585 define el 429 como demasiadas solicitudes en un tiempo dado y la RFC 9110 define el 401. Copiamos el cuerpo de una de las respuestas 429 desde la terminal y lo guardamos en archivo.
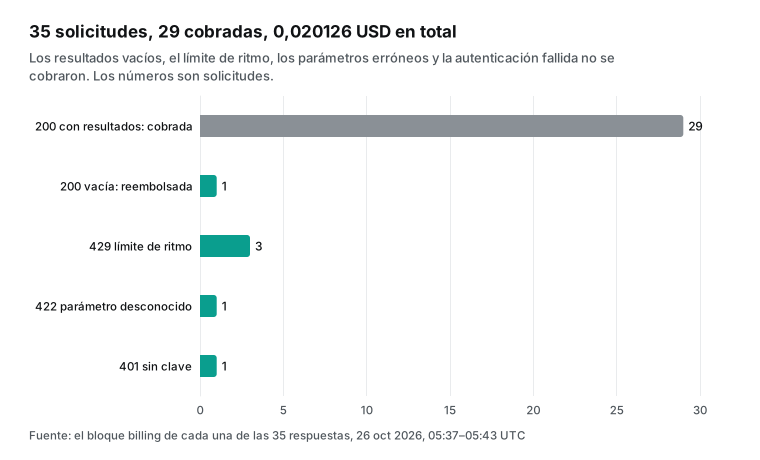
¿Por qué comparar esta fila aparte? Cuando Google cerró la Custom Search JSON API a clientes nuevos, un usuario de r/googlecloud pidió un reemplazo para 60 000 llamadas al mes. Una respuesta, de alguien que dijo llevar una API de búsqueda parecida, aconsejaba: pregunta a cada proveedor cómo cuenta una solicitud y si los reintentos, los resultados vacíos y las páginas extra se cobran, porque eso cambia el coste real. En monitorización los vacíos son frecuentes: una marca nueva, una palabra rara o un rango de fechas estrecho pueden no devolver nada. En nuestras 35 llamadas, 6 no se cobraron, un 17 %.
Cómo empezar: del registro al primer resultado
| Paso | Serper | EveryInfra |
|---|---|---|
| 1 | Registrarse en serper.dev y recibir 2500 consultas gratis, sin tarjeta | Registrarse gratis en everyinfra.com |
| 2 | Copiar la clave de API del panel | Copiar la clave de la consola; para la prueba, dar una estrella a everyinfra-agent-plugins en GitHub y pedir 1 USD |
| 3 | Agotadas las gratis, comprar al menos el Starter de 50 USD | Recargar al menos 10 USD; el saldo no caduca |
| 4 | Enviar la clave en la cabecera X-API-KEY (ver LangChain y otros envoltorios) | Enviar Authorization: Bearer a /api/v1/search |
| 5 | Conectar herramientas de IA con LangChain, CrewAI o Haystack, o con un servidor MCP de terceros | Conectar herramientas de IA con el punto MCP propio y un bloque de configuración |
| Uso gratis | Serper | EveryInfra |
|---|---|---|
| Cantidad | 2500 consultas | 1 USD, unas 1440 búsquedas |
| Validez | No figura en la página | 24 horas |
| Tarjeta | No | No |
| Mejor uso | Semanas dentro de un producto real | Una tarde de pruebas con todas las herramientas y errores |
El uso gratis de Serper es mayor, y 2500 consultas bastan para probar una idea nueva: es una ventaja real. Nuestra prueba de 1 USD equivale a unas 1440 búsquedas y hay que usarla en 24 horas, así que sirve más para «hacer funcionar una ejecución hoy» que para «usarla un mes». Si quieres ver resultados primero en el navegador, usa la prueba de un clic de la página de la herramienta de búsqueda web, con parámetros de ejemplo ya puestos. Los pasos completos están en el inicio rápido, y todas las capacidades y precios, en el mercado.
Después del uso gratis, el primer pago cambia aún más. En Serper son al menos 50 USD, y lo que no uses en seis meses caduca; en EveryInfra son al menos 10 USD, y el saldo se queda. Para un equipo que aún valida una idea, esto permite recargar 10 USD, trabajar un mes, ver el volumen real y decidir después, sin adivinar seis meses de uso. Para un equipo grande y estable la diferencia importa poco y manda el precio unitario: en ese caso, vuelve a la tabla de volumen mensual y mira de qué lado del cruce estás.
Pasar de Serper: cuatro cambios en el código
Si hoy usas Serper, pasar a EveryInfra requiere cuatro cambios. Para cada uno explicamos el motivo y lo que verás si te equivocas.
| Cambio | Desde (envoltorios de Serper) | Hacia (EveryInfra) | Si te equivocas |
|---|---|---|---|
| Dirección y clave | Una URL por tipo, X-API-KEY | /api/v1/search, Authorization: Bearer | 401, sin cobro |
| Parámetros | gl, hl, tbs, type | location, after, before, tool | 422 con la lista permitida, sin cobro |
| Resultados | Campos del proveedor | title, url, snippet, published | Errores de lectura en tu código |
| Cobro y reintentos | Los créditos paran en cero | charged_usd por llamada, retry_after en 429 | Más 429 si reintenta enseguida |
El primer cambio es la dirección y la clave. Los envoltorios de Serper ponen la clave en la cabecera X-API-KEY y usan una URL por tipo de resultado. Nosotros tenemos una sola URL, /api/v1/search, la clave va en Authorization: Bearer y el tipo de resultado va en el campo tool del cuerpo. Si pones la clave en la cabecera equivocada, recibes un 401, no pagas nada y el mensaje dice qué falta.
El segundo cambio son los nombres de parámetros: gl pasa a location, tbs pasa a dos fechas, after y before, type=news pasa a tool: "news" y type=places a tool: "places". El error típico es dejar un parámetro antiguo, por ejemplo gl. No lo ignoramos en silencio ni cobramos la llamada igualmente: devolvemos un 422, listamos los 7 parámetros que acepta web y decimos que no se cobró nada. La llamada 17 de esta prueba fue ese error, a propósito. Esto ayuda sobre todo a los agentes de IA: el modelo lee los valores permitidos en el error y corrige solo su siguiente llamada.
El tercer cambio es la lectura de resultados. Cada resultado nuestro trae title, url y snippet, y a veces published; places añade nota, dirección, coordenadas y más. El catálogo de herramientas de búsqueda lista todos los campos. Te sugerimos una capa propia de tipos de datos en tu código: convierte la respuesta de cualquier proveedor a esa capa antes de que la lea el resto del código. Así podrás cambiar de proveedor sin tocar lo demás.
El cuarto cambio es la lógica de cobro y reintentos. Serper deja de aceptar consultas cuando el saldo llega a cero; nosotros también, pero el saldo no caduca. Cada respuesta nuestra trae charged_usd, así que puedes registrar cada cobro y cuadrar el total con la factura a fin de mes. Ante un 429, espera los segundos de retry_after y reintenta; no reenvíes enseguida, o recibirás más 429. Tras estos cuatro cambios, ejecuta 20 consultas reales en los dos lados y compara número de resultados y tiempos antes de mover todo.
Conectar herramientas de IA: MCP, LangChain y n8n
Serper tiene muchos envoltorios listos en los marcos de IA, otra ventaja real: LangChain, la SerperDevTool de CrewAI y la SerperDevWebSearch de Haystack lo incluyen, y basta una variable de entorno para empezar. En MCP, la página de serper.dev no muestra un servidor propio; GitHub tiene servidores de terceros como mcp-server-serper y serper-mcp-server, que se ejecutan en tu propia máquina.
EveryInfra ofrece un punto MCP remoto propio que sigue la especificación MCP para Streamable HTTP, así que no hay que instalar nada en local; si MCP es nuevo para ti, la introducción a MCP explica las piezas. La búsqueda es una sola herramienta, everyinfra_search, con tool y params, igual que la API REST, y su descripción indica que las búsquedas fallidas o vacías no dejan cobro final. En clientes con MCP remoto, como Claude y Cursor, la configuración es:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
Una vez conectado, pide al cliente «usa everyinfra_search con la herramienta web para mejores tenis para correr, México, página 2» y enviará la misma solicitud que el curl de arriba. Para elegir herramienta de búsqueda en código, consulta la guía de selección de herramientas de búsqueda para agentes; para que una IA corrija sus parámetros a partir de los códigos de error, consulta errores de API que se corrigen solos; para cuadrar reembolsos con cobros, consulta conciliación de reembolsos por fallos. En n8n, si no hay un nodo listo, envía el mismo JSON con el nodo HTTP Request; la documentación de n8n de su nodo de herramienta SerpApi muestra una disposición de parámetros parecida.
Pruébalo tú en una tarde
Una tabla de precios solo acorta la lista; la decisión final debe salir de tus propias consultas. Proponemos tres pasos, cada uno con una regla de aprobado que se escribe antes de ver los resultados. Primero, toma al azar 50 consultas reales de tus registros, con los países, idiomas y tipos de resultado que más usas; no elijas solo palabras populares, porque las raras y largas muestran mejor los vacíos y las desviaciones por región. Segundo, ejecuta las 50 en los dos lados y anota tiempo, número de resultados, si se cobró y cuánto; en Serper bastan las 2500 consultas gratis y en nuestro lado la prueba de 1 USD, porque 50 llamadas cuestan 0,035 USD.
Tercero, compara con tus reglas, no con el marketing de nadie. Por ejemplo: cuántos de los 10 primeros coinciden con lo que ves a mano en el navegador; el percentil 90 del tiempo; cuántas vacías hubo y si se cobraron; el coste total. Escribe antes las reglas, por ejemplo «al menos 7 de 10 coinciden, percentil 90 bajo 3 segundos, vacías gratis», y no las cambies al ver los datos. Este guion de Python ejecuta nuestro lado; imprime el número de resultados, el tiempo y el cobro de cada llamada, y lee la clave de una variable de entorno:
import json, os, time, urllib.request

def search(q, **params):
    body = json.dumps({"tool": "web", "params": {"q": q, **params}}).encode()
    req = urllib.request.Request(
        "https://api.everyinfra.com/api/v1/search", data=body, method="POST",
        headers={"Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
                 "Content-Type": "application/json", "User-Agent": "price-test/1.0"})
    t0 = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        d = json.load(r)
    return len(d.get("results", [])), round(time.time() - t0, 2), d["billing"]["charged_usd"]

for q in ["best crm software for small business", "best air purifier"]:
    print(q, search(q, num=10, location="us"))
    time.sleep(7)  # la clave de prueba admite 10 llamadas por minuto
Ejecutamos el guion tal cual el 26 de octubre de 2026 a las 14:00 hora de Singapur: cada consulta devolvió 10 resultados, en 2,84 y 2,02 segundos, y cada una se cobró a 0,000694 USD. Estas dos llamadas no forman parte de las 35 anteriores y las registramos aparte. Fíjate en la cabecera User-Agent: la solicitud por defecto de Python a veces la bloquea la protección de un sitio, y el 403 que vuelve no significa que la clave esté mal. La pausa de 7 segundos mantiene la clave de prueba por debajo de 10 llamadas por minuto; el límite de tu cuenta puede ser mayor y se ve en la consola.
Cuándo conviene más Serper
Estos son cinco casos en los que Serper encaja mejor, dichos sin rodeos. Primero, volumen muy alto: si haces más de 300 000 búsquedas al mes y gastas los créditos en seis meses, Serper Scale a 0,50 USD y Ultimate a 0,30 USD cuestan entre un 28 % y un 57 % menos que nuestros 0,694 USD, y la diferencia crece con el volumen. Segundo, mucha concurrencia: Ultimate admite 300 consultas por segundo por defecto, y la página dice que son entre 15 000 y 18 000 búsquedas por minuto; nuestros límites dependen de la cuenta y la clave de prueba solo admitía 10 por minuto, así que para lotes grandes comprueba antes tu límite en la consola.
Tercero, si ya usas los envoltorios de LangChain, CrewAI o Haystack y tu código depende de los parámetros y la forma de respuesta de Serper, cualquier cambio implica código nuevo, y si gastas unas decenas de dólares al mes, el trabajo de migrar puede costar más de lo que ahorras. Aun así, esos envoltorios también cambian: el código de SerperDevWebSearch en Haystack avisa de que en Haystack 3.0 sale del paquete principal y pasa al paquete aparte serperdev-haystack, y el repositorio crewAI-tools, donde estaba SerperDevTool de CrewAI, se archivó el 10 de noviembre de 2025. Cuando tengas que tocar esas dependencias de todos modos, es buen momento para comparar precios. Cuarto, si necesitas controlar con precisión el idioma de la interfaz: Serper tiene hl, y nuestra herramienta web no tiene parámetro de idioma aparte, así que necesitarás web/search del catálogo de datos, que cuesta el doble por llamada.
Quinto, si necesitas los bloques extra de la página de resultados. La respuesta de ejemplo de la página de Serper incluye, junto a los resultados orgánicos, el panel de conocimiento (knowledgeGraph), «otras preguntas de los usuarios» (peopleAlsoAsk) y búsquedas relacionadas (relatedSearches). En nuestra prueba, la herramienta web devolvió solo título, URL, fragmento y fecha de los resultados orgánicos; las sugerencias requieren una llamada a suggest, y noticias, lugares y compras tienen su propia herramienta. Si tu producto necesita todos esos bloques en una llamada, por ejemplo una instantánea completa de la página de resultados, una API como Serper es más directa.
Hay dos caminos más fuera de estos dos proveedores. Uno es alojarlo tú, por ejemplo con SearXNG, un metabuscador de código abierto (código en GitHub); no tiene tarifa por llamada, pero tú mantienes el servidor y gestionas bloqueos y resultados inestables. El otro son proveedores que cuentan de otra manera: en el mismo hilo de Hacker News, otro usuario escribió que Bright Data cobra una solicitud de 100 resultados como una sola solicitud, a 1,5 USD por 1000, y las preguntas frecuentes de Bright Data explican cómo cobra desde que Google quitó el parámetro num. Cada proveedor cuenta «una llamada» a su manera, y ahí fallan casi todas las comparaciones.
EveryInfra encaja mejor en los demás casos: haces menos de 300 000 búsquedas al mes; tu volumen sube y baja y no quieres que caduquen créditos prepagados; muchas consultas no encuentran nada; quieres conectar herramientas de IA por MCP remoto; o también necesitas datos de plataformas con la misma clave, como reseñas de Google Maps, Naver y Yandex, además de la API de búsqueda web. También tenemos páginas comparativas con SerpApi y DataForSEO.
Otras opciones: precios públicos por 1000
Serper no es la única opción. Estos son los precios públicos que leímos el 26 de octubre de 2026, todos en USD por 1000 solicitudes. Las unidades no son iguales en todas partes: las herramientas de búsqueda de los proveedores de modelos cobran además el contenido como tokens, Exa cobra aparte por encima de 10 resultados y SerpApi es un plan mensual. Lee la tabla como orden de magnitud, no como una lista equivalente.
| Servicio | Por 1000 (USD) | Condiciones de cobro (puntos clave de la fuente) |
|---|---|---|
| Serper Ultimate / Scale / Standard / Starter | 0,30 / 0,50 / 0,75 / 1,00 | Prepago, válido 6 meses |
EveryInfra web (medido) | 0,694 | Por llamada, solo con resultados, sin caducidad |
| DeepSeek Search API | 0,75 | Solo 200 con resultados; vacías y tiempos agotados gratis |
| Exa Lite Search | 4 | Hasta 10 resultados; 1 USD por 1000 extra por encima |
| Google Custom Search JSON API | 5 | Solo clientes actuales; termina el 2027-01-01 |
| Herramienta web search de OpenAI | 10 | Más tokens del contenido al precio del modelo |
| Herramienta web search de Claude | 10 | No se cobra si hay error; más tokens |
| Gemini con Google Search | 14 | Las primeras 5000 al mes gratis |
| SerpApi Starter | 25 | 25 USD al mes por 1000 búsquedas |
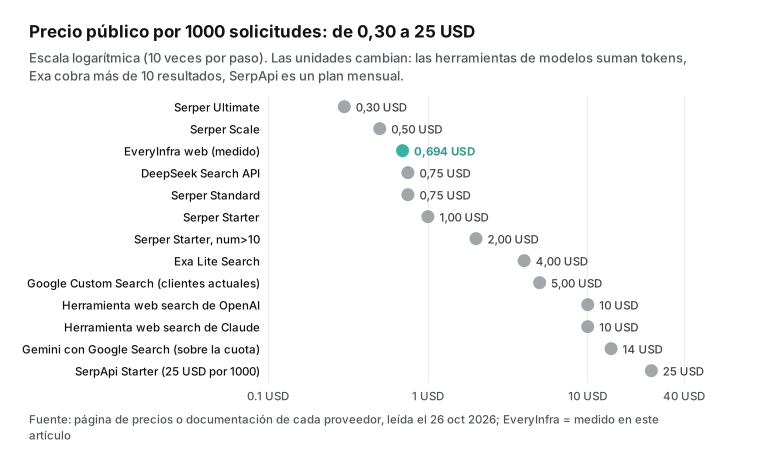
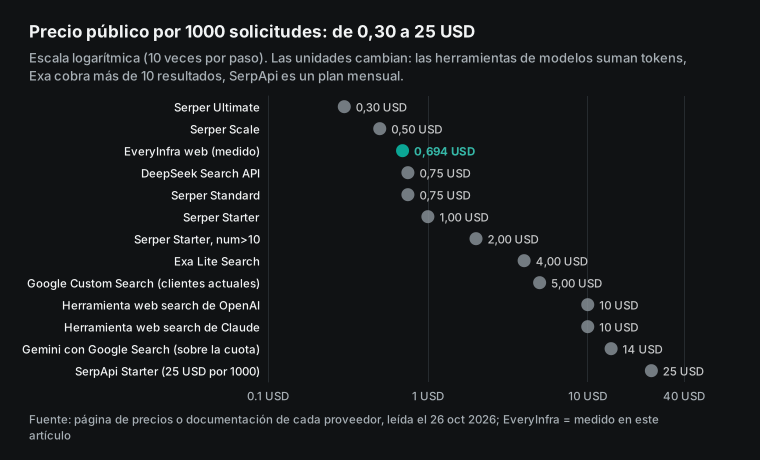
Para decidir sobre Serper, la fila más útil es la de DeepSeek: la API de búsqueda que abrió el 17 de octubre de 2026 tampoco cobra los vacíos ni los tiempos agotados, a 0,75 USD por 1000 (notas de versión de DeepSeek, 2026-10-17). Sirve como otro punto de comparación.
Cambios recientes
| Fecha | Hecho | Qué significa para ti |
|---|---|---|
| 2026-10-02 | Cloudflare Web Search API en AI Gateway | Los proveedores de búsqueda se vuelven piezas intercambiables |
| 2026-10-13 | SerpApi Extract API | Compara también el precio de leer páginas |
| 2026-10-17 | DeepSeek Search API a 0,75 USD por 1000 | Los vacíos gratis se vuelven la norma |
| 2027-01-01 | Termina Google Custom Search JSON API | Habrá migraciones antes de fin de año |
DeepSeek abrió su API de búsqueda (2026-10-17). La guía Search & Fetch de DeepSeek fija 0,75 USD por 1000 solicitudes correctas, y el parámetro count solo cambia el número de resultados, no el precio. Search Engine Journal informó el 2026-10-19 que cada resultado trae además un nivel de autoridad de la página. Según PPC Land, las búsquedas hechas con DeepSeek desde Claude Code y Codex son gratis hasta el 31 de octubre de 2026; la fuente original es la guía citada. Qué significa: los precios bajos y el cobro solo con resultados se vuelven el estándar básico; pregunta por ambos a cada proveedor.
Cloudflare lanzó una Web Search API (2026-10-02). La documentación de Cloudflare dice que un parámetro en AI Gateway cambia entre varios proveedores de búsqueda, y cada búsqueda se descuenta del crédito de AI Gateway al precio de lista del proveedor, sin recargo. Qué significa: las APIs de búsqueda se vuelven piezas intercambiables; ata tu código a una capa propia, no a la forma de respuesta de un proveedor.
SerpApi lanzó una Extract API (2026-10-13). En su entrada de blog, SerpApi anunció que ahora también extrae cualquier página web pública, no solo páginas de resultados, y su documentación dice que el modo de rastreo cobra un crédito por página extraída. Qué significa: búsqueda y lectura de páginas se juntan en un producto, así que compara también el precio de leer páginas; la herramienta read de EveryInfra cuesta 0,000694 USD por llamada.
La Google Custom Search JSON API termina el 2027-01-01. La página de resumen de Google dice que la API no acepta clientes nuevos y que los actuales deben migrar antes del 1 de enero de 2027; para ellos, las primeras 100 consultas al día son gratis y luego cuesta 5 USD por 1000. Antes, Microsoft retiró las Bing Search APIs el 11 de agosto de 2025 (Microsoft Learn); su reemplazo sugerido es Grounding with Bing Search dentro de los agentes de Azure, que no entrega los resultados en bruto. Qué significa: ningún gran buscador vende ya resultados en bruto directamente, así que las APIs de terceros son la opción principal; espera una ola de migraciones antes de fin de año.
Límites: cuándo no valen estos resultados
Primero, la muestra es pequeña: 35 llamadas con 10 herramientas y 4 países bastan para comprobar precios y reglas de cobro, pero no para juzgar la calidad de los resultados ni la estabilidad a largo plazo, y los 29 tiempos salen de una tarde en una máquina en Singapur. Segundo, todo lo del lado de Serper sale de páginas públicas y mensajes de usuarios; «2 créditos por encima de 10 resultados» es un dato de usuarios, y donde la página calla, como en los vacíos, no hemos supuesto nada.
Tercero, comparamos precios de lista sin impuestos: la página de Serper dice que sus precios no incluyen impuesto sobre ventas, IVA ni GST, y nuestra página de recarga tiene su propia nota; en México o España el IVA cambia el importe final. Cuarto, nuestros límites de ritmo dependen de la cuenta, y las 10 llamadas por minuto de este artículo son solo la configuración de la clave de prueba. Quinto, los precios cambian: leímos los de Serper el 26 de octubre de 2026 a las 13:32 hora de Singapur y el nuestro sale del catálogo del mismo día. Si cualquiera de los dos cambia, hay que repetir el cálculo: leer de nuevo la página de serper.dev y nuestro catálogo, y poner los nuevos precios en el método de la sección de caducidad; todas las cifras de tablas y gráficos cambian con ellos. Volveremos a leer ambos precios antes de publicar.
Un último punto: este artículo no compara las posiciones que devuelve cada lado para la misma palabra clave. Comparamos precios, cobro, tipos de resultado y pasos de arranque. Para comparar resultados, ejecuta 50 consultas reales tuyas en los dos lados y lee las respuestas en bruto.
Preguntas frecuentes
¿Cuánto es el plan gratis de Serper API y caduca?
La pregunta sale de las sugerencias de Google «serper api free tier» y «serper dev free tier». La página principal de Serper dice «Get 2,500 free queries», sin tarjeta, y no da caducidad para las consultas gratis; los créditos de pago valen 6 meses. La prueba de EveryInfra es de 1 USD, unas 1440 búsquedas, que se pide tras dar una estrella a nuestro repositorio de GitHub y vale 24 horas.
¿Cómo funcionan los precios de Serper API? ¿Pedir 100 resultados cuesta el doble?
La pregunta sale de las sugerencias «serper api pricing» y «serper dev pricing». Se prepaga uno de cuatro paquetes, 50, 375, 1250 o 3750 USD, es decir de 1,00 a 0,30 USD por 1000, válidos 6 meses. La regla de «2 créditos por encima de 10 resultados» viene de un usuario de Hacker News y no figura en las tarjetas de precios. En EveryInfra una página trae hasta 10 resultados y cobra una llamada; para más, use page.
¿Hay una alternativa más barata a Serper para resultados de Google?
La pregunta sale de las sugerencias «serper api alternative free» y «serper alternatives». Depende del volumen. Por debajo de 300 000 búsquedas al mes, contando la caducidad de 6 meses, los 0,694 USD por 1000 de EveryInfra son menos de lo que realmente pagas en Serper, y cuanto menor es tu volumen, mayor es la diferencia; por encima de 300 000 al mes, Scale y Ultimate de Serper cuestan menos. DeepSeek, a 0,75 USD por 1000, está en la misma franja.
¿Qué diferencia hay entre Serper y SerpApi?
La pregunta sale de la sugerencia «serper api vs serpapi». Según las dos páginas públicas: Serper vende créditos prepagados a entre 0,30 y 1,00 USD por 1000; SerpApi vende planes mensuales, Starter a 25 USD al mes por 1000 búsquedas, con más buscadores y tipos de resultado y una cláusula de cobertura legal en Estados Unidos. Nuestra página comparativa con SerpApi tiene una tabla más larga.
¿Serper tiene límite de ritmo?
La pregunta sale de la sugerencia «serper dev rate limit». Sí, según el paquete: 50 por segundo en Starter, 100 en Standard, 200 en Scale y 300 en Ultimate, y la página dice que se puede pedir más. En EveryInfra el límite depende de la cuenta; si te pasas, recibes un 429 con retry_after y no pagas nada.
¿Se cobran las llamadas fallidas, los resultados vacíos o los reintentos?
La pregunta sale de una respuesta, de alguien que dijo llevar una API parecida, en el hilo de r/googlecloud. Serper dice que los créditos se descuentan en cada respuesta correcta. En nuestra prueba, EveryInfra devolvió charged: false para un resultado vacío y lo reembolsó, y las respuestas 401, 422 y 429 decían «Nothing was charged».
¿Qué puede reemplazar a la Google Custom Search API?
La pregunta sale del mismo mensaje de r/googlecloud, cuyo autor hace entre 40 000 y 60 000 llamadas al mes y presupuestaba unos 5 USD por 1000. Con las cifras de este artículo, 60 000 llamadas cuestan 41,67 USD al mes en EveryInfra; en Serper, 360 000 llamadas en seis meses caben en un Standard de 375 USD, es decir 62,50 USD al mes.
Referencias
- Página principal de Serper (precios y preguntas frecuentes), serper.dev, leída el 2026-10-26. https://serper.dev/
- Términos del servicio de Serper (Refund Policy), serper.dev, actualizados el 2024-05-29. https://serper.dev/terms
- Hilo sobre resultados y créditos de Serper, Hacker News. https://news.ycombinator.com/item?id=43921687
- «Picking ONE Google SERP API in 2026», Reddit r/WebScrapingInsider. https://www.reddit.com/r/WebScrapingInsider/comments/1sesvvq/picking_one_google_serp_api_in_2026_feels_less/
- «Google Custom Search API is closing», Reddit r/googlecloud. https://www.reddit.com/r/googlecloud/comments/1qp4mlz/google_custom_search_api_is_closing_need/
- Resumen de Custom Search JSON API, Google for Developers. https://developers.google.com/custom-search/v1/overview
- Method: cse.list, Google for Developers. https://developers.google.com/custom-search/v1/reference/rest/v1/cse/list
- Retirada de Bing Search APIs el 2025-08-11, Microsoft Learn. https://learn.microsoft.com/en-us/lifecycle/announcements/bing-search-api-retirement
- Grounding with Bing Search, Microsoft Learn. https://learn.microsoft.com/en-us/azure/ai-foundry/agents/how-to/tools/bing-grounding
- Guía Search & Fetch, documentación de la API de DeepSeek. https://api-docs.deepseek.com/guides/search
- Lanzamiento de DeepSeek-V4.1-Flash-1017 con la API Search y Fetch, DeepSeek, 2026-10-17. https://api-docs.deepseek.com/news/news261017
- «DeepSeek Opens Its In-House Search Engine To Developers», Search Engine Journal, 2026-10-19. https://www.searchenginejournal.com/deepseek-opens-its-in-house-search-engine-to-developers/593526/
- «DeepSeek prices web search for AI agents at $0.75 per 1,000 calls», PPC Land (secundaria; fuente original en la 11). https://ppc.land/deepseek-prices-web-search-for-ai-agents-at-0-75-per-1-000-calls/
- Documentación de Cloudflare Web Search API, Cloudflare, actualizada el 2026-10-02. https://developers.cloudflare.com/web-search/
- «Introducing the SerpApi Extract API», blog de SerpApi, 2026-10-13. https://serpapi.com/blog/introducing-extract-api/
- Documentación de Extract API, SerpApi. https://serpapi.com/extract-api
- Precios de SerpApi, serpapi.com. https://serpapi.com/pricing
- «Google Search confirms it does not support the results per page parameter», Search Engine Land, 2025-09-18. https://searchengineland.com/google-search-confirms-it-does-not-support-the-results-per-page-parameter-462244
- Precios de Exa, exa.ai. https://exa.ai/pricing
- Precios, documentación de la plataforma de OpenAI. https://platform.openai.com/docs/pricing
- Web search tool, documentación de Claude. https://docs.claude.com/en/docs/agents-and-tools/tool-use/web-search-tool
- Gemini Developer API pricing, Google AI for Developers. https://ai.google.dev/gemini-api/docs/pricing
- GoogleSerperAPIWrapper, LangChain Reference. https://reference.langchain.com/python/langchain-community/utilities/google_serper/GoogleSerperAPIWrapper
- Código de google_serper.py, langchain-community, GitHub. https://github.com/langchain-ai/langchain-community/blob/main/libs/community/langchain_community/utilities/google_serper.py
- SerperDevTool, documentación de CrewAI. https://docs.crewai.com/v1.15.28/en/tools/search-research/serperdevtool
- SerperDev, documentación de Haystack. https://docs.haystack.deepset.ai/reference/integrations-serperdev
- mcp-server-serper, GitHub. https://github.com/marcopesani/mcp-server-serper
- serper-mcp-server, GitHub. https://github.com/garylab/serper-mcp-server
- Especificación de Model Context Protocol 2025-11-25. https://modelcontextprotocol.io/specification/2025-11-25
- Introducción a MCP, modelcontextprotocol.io. https://modelcontextprotocol.io/docs/getting-started/intro
- Catálogo de herramientas de búsqueda de EveryInfra (sin clave), leído el 2026-10-26. https://api.everyinfra.com/api/v1/search/tools
- Catálogo de capacidades de datos de EveryInfra (sin clave), leído el 2026-10-26. https://api.everyinfra.com/api/v1/social/catalog
- RFC 6585: Additional HTTP Status Codes (429), IETF. https://www.rfc-editor.org/rfc/rfc6585
- RFC 9110: HTTP Semantics (401, 422), IETF. https://www.rfc-editor.org/rfc/rfc9110
- RFC 5646: Tags for Identifying Languages, IETF. https://datatracker.ietf.org/doc/html/rfc5646
- Documentación de SearXNG. https://docs.searxng.org/
- SearXNG, GitHub. https://github.com/searxng/searxng
- Preguntas frecuentes de SERP API, documentación de Bright Data. https://docs.brightdata.com/scraping-automation/serp-api/faqs
- Nodo SerpApi Tool, documentación de n8n. https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolserpapi/
- Código de SerperDevWebSearch, Haystack, GitHub. https://github.com/deepset-ai/haystack/blob/main/haystack/components/websearch/serper_dev.py
- serper_dev_tool.py (crewAI-tools, archivado el 2025-11-10), GitHub. https://github.com/crewAIInc/crewAI-tools/blob/main/crewai_tools/tools/serper_dev_tool/serper_dev_tool.py
Referencia BL-48