Serper API 대안: 요금, 무료 티어, 실제 테스트로 비교
Serper API와 EveryInfra의 요금을 비교합니다. 검색 1,000건당 $1.00 대 $0.694, 6개월 후 크레딧 만료, 무료 티어, 실제 호출 35건과 빈 결과 환불을 다룹니다.
웹 검색 1,000건 기준으로 Serper의 입문용 Starter 팩 정가는 $1.00입니다. EveryInfra는 테스트에서 1,000건당 $0.694를 과금했습니다. 2026년 10월 26일 싱가포르 시간 13:37~13:43에 실제 호출 35건을 보냈고, 그중 29건이 과금되었습니다. 1.44배 저렴한 셈입니다. Serper 크레딧은 6개월 후 만료되고 가장 작은 팩이 $50이므로, 월 1,000건을 검색하면 실제로는 1,000건당 $8.33을 내게 되어 EveryInfra 가격의 12배가 됩니다. 이 내용은 모두 월 약 300,000건 미만일 때만 성립합니다. 그 이상에서는 Serper의 대용량 팩 두 개가 EveryInfra보다 저렴합니다.
이 글에서 ‘Serper API 대안’은 키워드를 받아 웹 검색 결과 한 페이지를 반환하는 호출당 과금 API를 뜻합니다. 각 결과에는 제목, 링크, 스니펫, 순위가 있습니다. 이런 유형의 API는 대부분 뉴스, 장소, 쇼핑, 이미지, 학술 검색 결과도 반환합니다. 비교 항목은 네 가지뿐입니다. 먼저 1,000건당 가격과 각 서비스가 호출을 세는 방식입니다.
그리고 실패하거나 결과가 비어 있는 호출의 비용과 시작 절차입니다. 두 응답의 필드 이름은 비교하지 않습니다. EveryInfra의 필드는 검색 도구 카탈로그에서 확인할 수 있습니다.


한눈에 보는 결론: 표 하나로 정리
표에는 두 종류의 숫자가 있습니다. 첫째는 serper.dev 요금 섹션에 공개된 Serper의 가격과 규칙입니다. 2026년 10월 26일 싱가포르 시간 13:32에 확인했으며, 페이지 텍스트 사본을 보관하고 있습니다.
둘째는 같은 날 실제 호출에서 EveryInfra API가 반환한 값입니다. Serper 계정을 만들거나 크레딧을 구매하거나 Serper 키를 사용하지는 않았습니다. 로그인 후에만 볼 수 있는 규칙은 표에 ‘페이지에 없음’으로 표시했습니다.
| 항목 | Serper(공개 페이지) | EveryInfra(실측) |
|---|---|---|
| 호출 1,000건당 가격 | 팩별 $1.00 / $0.75 / $0.50 / $0.30 | $0.694, 단일 가격 |
| 최소 결제 금액 | $50(Starter, 50,000크레딧) | $10(최소 충전 금액) |
| 유효 기간 | 크레딧 6개월간 유효 | 잔액 만료 없음 |
| 무료 사용 | 쿼리 2,500건, 신용카드 불필요 | $1 체험용 크레딧(검색 약 1,440건), 24시간 유효, GitHub 스타로 받기 |
| 호출 한 번에 결과 10개 초과 | 사용자 보고 기준 2크레딧 | 페이지당 최대 10개, 페이지마다 호출 1건, 더 받으려면 page 사용 |
| 과금 시점 | 성공한 응답마다 | 결과가 반환될 때만 과금, 빈 결과는 환불 |
| 401, 422, 429 | 페이지에 명시 없음 | 과금되지 않음. 응답에 "Nothing was charged" 표시 |
| 환불 | 첫 구매 후 7일 이내, 사용량 20% 미만이면 전액 환불 | 잔액이 그대로 유지되며, 만료로 사라지는 금액이 없어 환불할 필요 없음 |
| 결과 유형 | 검색, 이미지, 뉴스, 지도, 장소, 동영상, 쇼핑, 학술, 특허, 자동 완성 | 웹, 뉴스, 장소, 쇼핑, 미디어(이미지 및 동영상), 학술(논문 및 특허), 검색어 추천 외 10개 |
| 요청 속도 제한 | Starter는 초당 50건, Ultimate는 초당 최대 300건 | 테스트 키 기준 분당 10건, 한도는 계정마다 다름 |
| MCP | 페이지에 공식 서버 없음, GitHub에 서드파티 서버 있음 | 도구 1개(everyinfra_search)를 제공하는 공식 원격 MCP 엔드포인트 |
이 표에서 두 행은 가격 열에 드러나지 않지만 실제 청구액을 좌우합니다. 바로 만료 행과 "결과 10개 초과" 행입니다. 이어지는 섹션에서는 먼저 Serper의 가격을 하나씩 뜯어보고, 다음으로 EveryInfra 가격의 근거를 보여 드린 뒤, 다섯 세트의 실제 호출로 각 칸을 검증합니다.
Serper API 요금: 유효기간 6개월인 선불 팩 4종
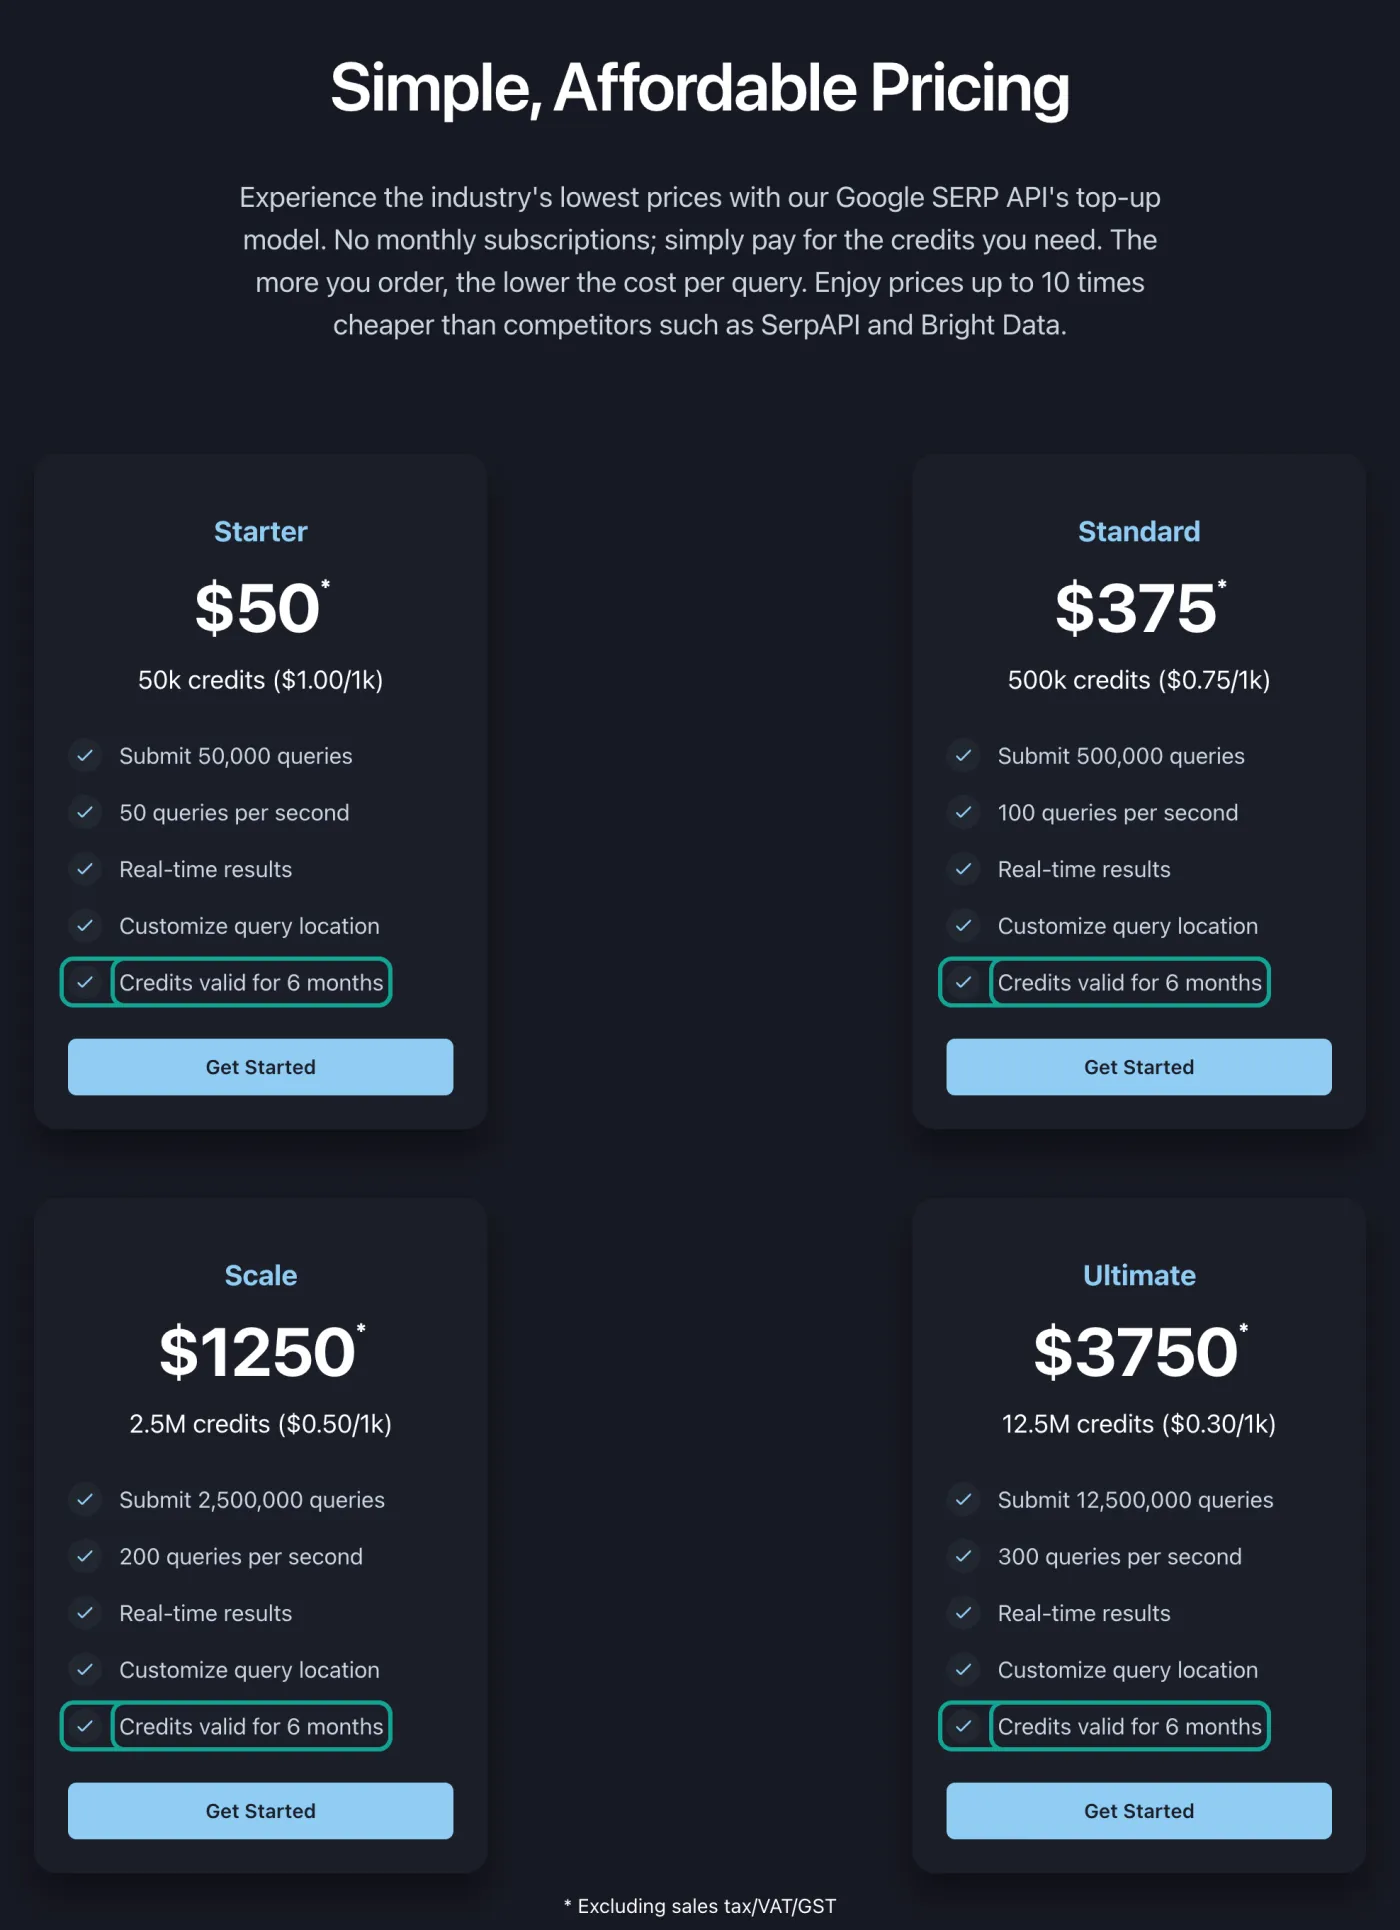
Serper는 선불 팩을 판매합니다. 요금 페이지에는 "월 구독 없이 필요한 크레딧만큼만 결제하세요"라고 적혀 있습니다. 팩은 네 가지입니다. Starter는 $50에 50,000 크레딧으로, 1,000 크레딧당 $1.00이며 초당 50쿼리를 처리합니다. Standard는 $375에 500,000 크레딧으로, 1,000 크레딧당 $0.75이며 초당 100쿼리입니다. Scale은 $1,250에 2.5백만 크레딧으로, 1,000 크레딧당 $0.50이며 초당 200쿼리입니다. Ultimate는 $3,750에 12.5백만 크레딧으로, 1,000 크레딧당 $0.30이며 초당 300쿼리입니다.
네 카드는 모두 "Credits valid for 6 months"(크레딧 유효기간 6개월)라는 같은 문구로 끝납니다. 카드 아래 안내문에는 가격에 판매세, VAT, GST가 포함되지 않는다고 적혀 있습니다. 아래 스크린샷은 이 문구를 표시한 네 카드입니다.
같은 페이지의 FAQ에는 비용과 관련된 규칙이 세 가지 더 있습니다. 첫째, 크레딧 차감 시점입니다. "쿼리에 대해 성공한 응답을 받을 때마다 계정 잔액에서 크레딧을 차감합니다." 잔액이 0이 되면 Serper는 새 쿼리를 처리하지 않습니다. 둘째, 환불입니다. 첫 구매 후 7일 이내이고 크레딧 사용량이 20% 미만이면 전액 환불받을 수 있습니다. 서비스 약관의 Refund Policy 섹션에도 같은 내용이 있으며, 약관 페이지에 표시된 업데이트 날짜는 2024년 5월 29일입니다. 셋째, 결제 수단은 Visa, Mastercard, American Express, Discover, PayPal입니다.
요금 카드에는 없지만 사용자들이 자주 언급하는 규칙이 하나 있습니다. 결과를 10개 넘게 요청하는 호출에는 2크레딧이 든다는 것입니다. Hacker News의 한 사용자는 Serper가 "결과 10개는 1크레딧, 20~100개는 2크레딧"으로 계산한다고 썼습니다(Hacker News 스레드). 따라서 호출당 결과가 10개면 호출 1,000건당 $1, 100개면 $2입니다. 저희는 Serper 계정이 없어 현재 이 규칙을 확인할 수 없습니다. 이 글에서는 이 내용을 사용자 보고로 다루며, 차트에서도 페이지에 공시된 가격과 구분해 표시합니다.
따라서 Serper의 실제 1,000건당 가격은 세 가지 입력값으로 정해집니다. 구매한 팩, 6개월 안에 사용한 비율, 호출당 결과 수입니다. 요금 카드에는 첫 번째 입력값만 나옵니다. 두 번째 입력값은 각 카드 맨 아래의 작은 문구에 있습니다. 세 번째 입력값은 포럼에서나 찾을 수 있습니다. SERP API를 다룬 Reddit 스레드에서 한 사용자는 Serper가 "크레딧을 실제 워크로드에 대입해 보기 전까지는 저렴해 보인다"고 표현했습니다(r/WebScrapingInsider 스레드).
만료 때문에 얼마나 더 낼까? 월 사용량별 실제 가격
이 섹션은 저희가 직접 계산한 결과입니다. 한 달에 V건을 검색한다고 가정해 보겠습니다. Serper 크레딧은 6개월 후 만료되므로 6개월마다 최소 6V 크레딧을 구매해야 합니다. 네 팩의 모든 조합을 따져 가장 저렴한 조합을 고르고, 그 비용을 6V로 나눕니다.
이렇게 하면 실제로 내는 1,000건당 가격이 나옵니다. EveryInfra 크레딧은 만료되지 않으므로 가격이 $0.694로 유지됩니다. 계산 스크립트는 저장해 둔 페이지 텍스트에서 네 가격을 읽어 오므로 손으로 입력한 숫자가 없습니다. 스크립트와 페이지 텍스트는 보관하고 있습니다.
결과는 표와 같습니다. 월 1,000건을 검색하는 소규모 프로젝트도 Starter 팩 1개가 필요합니다. 6개월 동안 6,000 크레딧을 쓰고 44,000 크레딧은 만료됩니다. 1,000건당 $8.33인 셈입니다.
월 5,000건이면 실제 가격은 $1.67입니다. 6개월 동안 Starter 팩 1개를 정확히 다 쓰는 월 8,333건일 때만 카드에 적힌 $1.00을 냅니다. 월 약 83,000건이면 Standard 팩 1개를 다 써서 $0.75가 되는데, 이는 여전히 EveryInfra보다 8% 비쌉니다. 두 서비스의 가격은 6개월 동안 $1,250짜리 Scale 팩 1개를 다 쓰는 월 300,000건에서 같아집니다.
| 월 검색 수 | 6개월간 필요량 | 가장 저렴한 Serper 팩 | Serper 1,000건당 실제 가격 | EveryInfra 1,000건당 가격 | Serper ÷ EveryInfra |
|---|---|---|---|---|---|
| 1,000 | 6,000 | Starter 1개($50) | $8.33 | $0.694 | 12.0x |
| 5,000 | 30,000 | Starter 1개($50) | $1.67 | $0.694 | 2.4x |
| 20,000 | 120,000 | Starter 3개($150) | $1.25 | $0.694 | 1.8x |
| 83,333 | 약 500,000 | Standard 1개($375) | $0.75 | $0.694 | 1.08x |
| 300,000 | 1.8백만 | Scale 1개($1,250) | $0.694 | $0.694 | 1.0x |
| 500,000 | 3백만 | Standard + Scale($1,625) | $0.54 | $0.694 | 0.78x |
| 2,083,333 | 12.5백만 | Ultimate 1개($3,750) | $0.30 | $0.694 | 0.43x |
이 계산에는 세 가지 한계가 있습니다. 첫째, 6개월에 한 번 구매한다고 가정합니다. 대신 매달 Starter 팩을 산다면 월 1,000건 프로젝트는 매달 $50를 내므로 실제 가격은 내려가지 않고 오히려 올라갑니다. 둘째, 공개된 네 가지 가격만 사용합니다. Serper가 대형 고객에게 제공할 수 있는 별도 가격과 세금은 포함하지 않았습니다.
셋째, 교차 지점은 Scale 가격에서 결정됩니다. $1,250를 EveryInfra의 호출당 가격 $0.000694로 나누면 여섯 달 동안 1.8백만 건, 즉 월 300,000건입니다. Ultimate가 EveryInfra보다 저렴해지려면 여섯 달 동안 5.4백만 건이 필요합니다. Standard와 Starter는 정가가 각각 $0.75, $1.00으로 이미 $0.694보다 높기 때문에 EveryInfra보다 저렴해지는 경우가 없습니다.
EveryInfra 가격은 어떻게 정해지나
EveryInfra 검색은 호출당 과금됩니다. 가격은 API 키 없이 볼 수 있는 공개 검색 도구 카탈로그에 나와 있습니다. 카탈로그의 billing.tiers 목록에는 등급이 3개 있습니다. Standard는 호출당 $0.000694, 즉 1,000건당 $0.694이며 거의 모든 검색 도구가 여기에 속합니다.
Deep은 호출당 $0.001389로, 시맨틱 검색의 deep 모드에 적용됩니다. Cross-check는 여러 검색을 동시에 실행하므로 호출당 $0.002778입니다. web 도구는 Standard 등급에 속합니다. 같은 가격이 요금 페이지와 검색 제품 페이지에도 나와 있습니다.


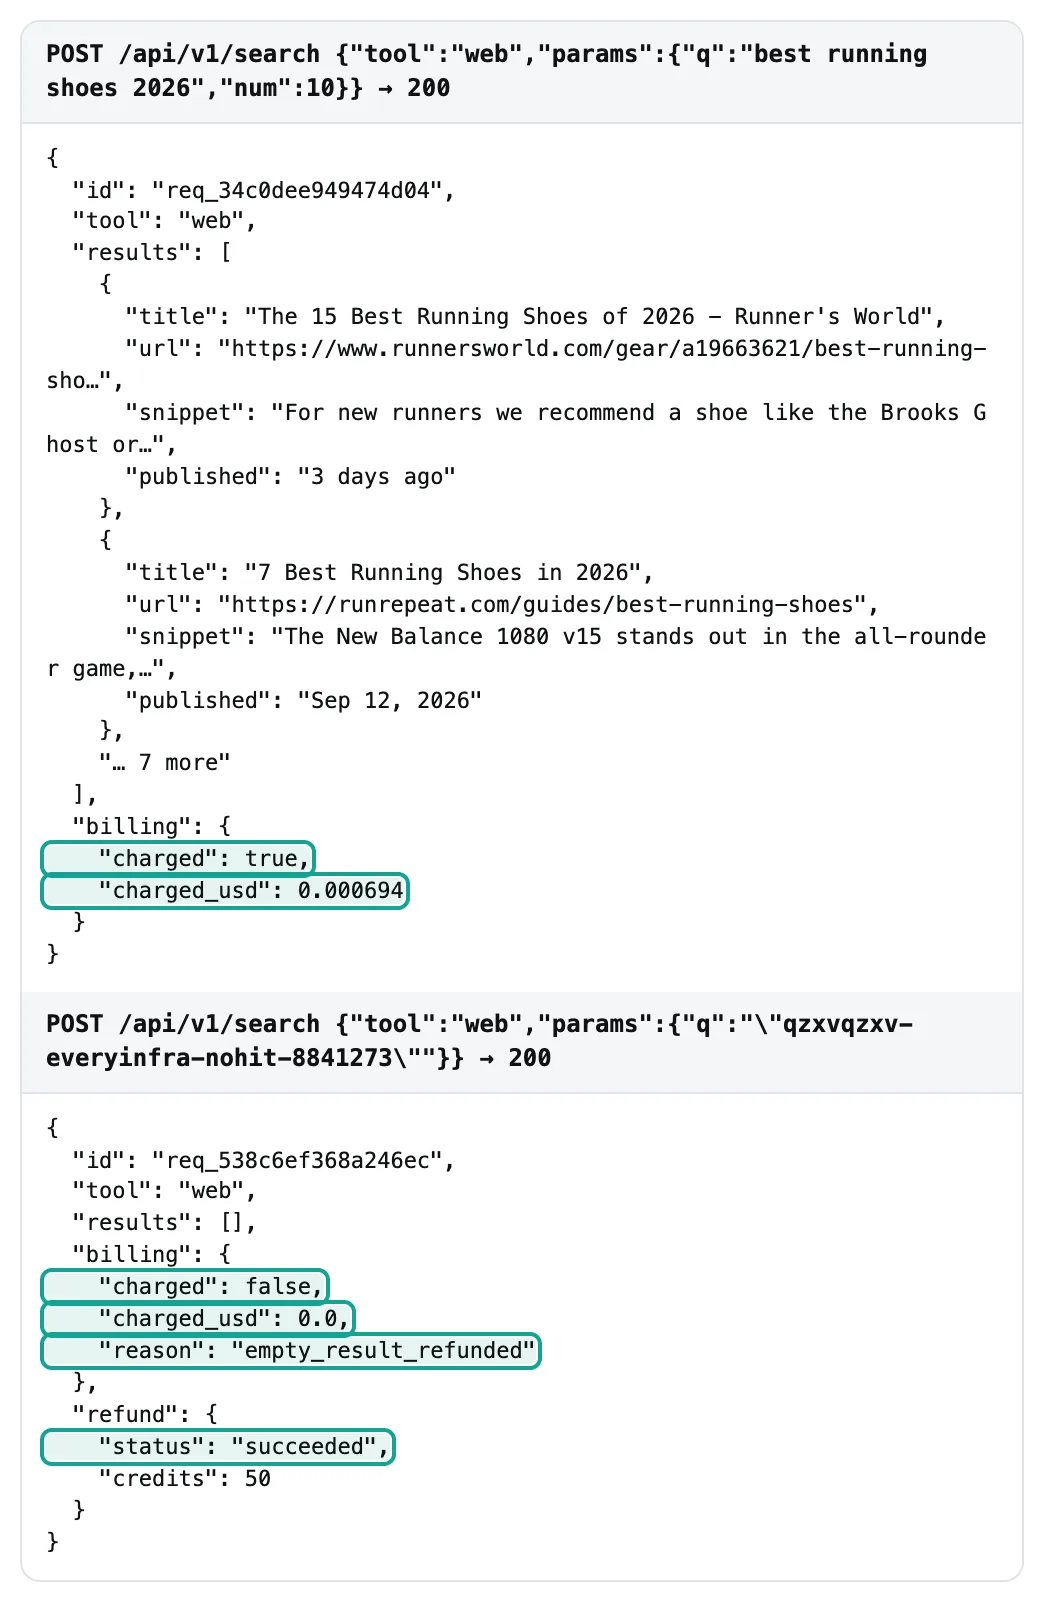
저희는 카탈로그의 숫자만 믿지 않고 실제 응답과 대조합니다. 과금된 모든 응답에는 charged와 charged_usd가 담긴 billing 객체가 있습니다. 테스트에서 과금된 호출 29건 모두 charged_usd가 0.000694였습니다.
평균에 1,000을 곱하면 $0.694로 카탈로그와 같습니다. 호출당 가격이 고정되어 있으면 실행하기 전에 청구액을 계산할 수 있습니다. 키워드 10개를 한 번 돌리면 $0.00694, 키워드 10,000개를 한 번 돌리면 $6.94입니다.
요청은 다음과 같습니다. API 키는 환경 변수에서 읽으며 파일에 기록하지 않습니다.
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"best running shoes 2026","num":10}}'
web 도구의 파라미터는 7개입니다. q는 쿼리입니다. site는 결과를 한 도메인으로 제한하며, 쿼리에 site:를 쓰는 것과 같습니다. location은 지역으로, 국가 이름이나 두 글자 국가 코드를 받으며 도시는 해당 국가로 처리됩니다. after와 before는 특정 날짜 이후 또는 이전의 결과만 남깁니다.
page는 결과 페이지 번호로 1부터 시작합니다. num은 페이지당 결과 수로 최대 10이며 기본값도 10입니다. 더 큰 값을 보내면 오류 없이 10개를 반환합니다. 각 결과에는 title, url, snippet이 있고, 날짜를 알 수 있으면 published도 포함됩니다. 카탈로그는 각 도구에 units: 1과 price_usd: 0.000694도 명시합니다. num 값과 관계없이 요청 1건이 과금 단위 1개입니다.
국가와 언어를 더 세밀하게 제어해야 한다면 데이터 카탈로그의 web/search 기능을 쓸 수 있습니다. country와 language 파라미터를 받으며, 표준 데이터 등급으로 호출당 $0.001389입니다. 데이터 카탈로그에서 확인할 수 있습니다. web 검색 도구와 별개인 또 하나의 경로로, 언어별로 결과를 걸러야 하는 작업에 적합합니다.
호출 1,000건당일까, 결과 1,000건당일까?
지금까지는 호출 수를 셌습니다. 하지만 많은 팀에게는 결과 수가 더 중요합니다. 순위 추적 도구는 상위 30개를, 리서치 팀은 상위 50개를 원합니다. 호출 1건에 담기는 결과 수가 청구액을 결정하며, 그 수는 검색 엔진 자체가 제한합니다.
테스트에서 EveryInfra web 도구는 호출당 평균 9.3개의 결과를 반환했습니다. 결과 1,000개당 $0.0746이며, 페이지마다 10개를 꽉 채우면 $0.0694입니다. Serper 쪽은 두 가지 경우가 있어 둘 다 제시합니다. 첫 번째는 Google이 num=100을 없앤 이후처럼 호출 1건이 여전히 약 10개의 결과를 반환하는 경우입니다.
이때 Starter 팩은 결과 1,000개당 $0.10이며, num=100에 2크레딧이 적용되면 $0.20입니다. EveryInfra 가격의 1.3~2.7배입니다. 두 번째는 Serper가 num=100에 실제로 결과 100개를 반환하는 경우입니다. 이때 가격은 결과 1,000개당 $0.02로, EveryInfra보다 3.7배 저렴합니다.
저희는 Serper 계정이 없어 현재 어느 쪽이 맞는지 알 수 없습니다. 앞서 인용한 Hacker News 댓글은 Google의 변경 이전에 작성되었습니다. 키워드마다 깊은 순위까지 결과가 필요하다면 먼저 테스트해 보세요. Serper의 무료 크레딧으로 num=100을 한 번 호출하고, 오가닉 결과 수와 사용된 크레딧을 세어 보면 됩니다.
이 테스트는 비용이 들지 않으며, 추측에 그치지 않고 사실을 확인할 수 있게 해 줍니다. EveryInfra 쪽의 답은 다음 섹션에 있습니다. 한 페이지에 결과가 최대 10개 담기고 호출 1건으로 과금되며, 더 많은 결과가 필요하면 page로 페이지를 더 요청합니다.
다섯 가지 테스트 세트 한눈에 보기
| 세트 | 시간(싱가포르) | 도구 수 | 호출 수 | 과금 | 주요 결과 |
|---|---|---|---|---|---|
| 1. num과 page | 13:37–13:42 | web | 5 | 5 | 페이지당 결과 9~10개, 최대 10개 |
| 2. 국가, 사이트, 날짜 | 13:38–13:40 | web | 5 | 5 | 국가별 현지 사이트, site는 결과 3개 |
| 3. 순위 확인 | 13:41–13:43 | web | 10 | 10 | 결과 96개, $0.00694, 중앙값 2.07초 |
| 4. 결과 유형 | 13:39–13:40 | 기타 도구 8개 | 9 | 9 | 각 10개씩, read는 1페이지 |
| 5. 과금 예외 상황 | 13:38–13:41 | web | 6 | 0 | 빈 결과, 422, 401, 429 3회: 모두 무료 |
합계는 호출 35건, 과금 호출 29건입니다. 호출 3건은 처음에 429를 받아 다시 보냈습니다. 재시도는 세트 2, 3, 4에, 429 세 건은 세트 5에 집계했습니다. 모든 호출의 시간, 상태, 소요 시간(초), 결과 수, 과금액을 기록했으며 로그를 보관하고 있습니다.
테스트 1: num과 page에 따라 호출당 결과 수와 과금 호출 수는 어떻게 달라지나
먼저 결과당 가격을 정하는 파라미터부터 살펴봅니다. 2026년 10월 26일 싱가포르 시간 13:37, 13:38, 13:42에 호출 5건을 보냈습니다. num=10, num=100, page=2는 "best running shoes 2026" 쿼리를, num=20과 page=3은 테스트 3의 "best crm software for small business" 쿼리를 사용했습니다. 결과는 다음과 같습니다. 한 페이지에는 결과가 최대 10개 담깁니다. num=10은 9개, num=20은 10개를 반환했습니다.
num=100은 num=10에서 반환된 URL 9개와 동일한 결과 한 페이지만 반환했습니다. 2페이지와 3페이지는 각각 10개를 반환했고, 같은 쿼리의 1페이지 결과와 겹치는 것은 없었습니다. 호출 5건에는 각각 $0.000694가 한 번씩 과금되었습니다. 현재 카탈로그에도 web의 num 최댓값이 10으로 나와 있습니다(news, scholar, forum도 10, places는 20, shopping은 40). 싱가포르 시간 16:04에 다시 확인한 결과, num=100은 오류 없이 결과 9개를, page=2는 10개를 반환했으며 두 페이지 사이에 겹치는 URL은 없었습니다.
왜 한 페이지는 결과 10개로 제한될까요? 검색 엔진이 바뀌었기 때문입니다. 2025년 9월 Google은 URL 파라미터로 페이지당 결과 100개를 보여 주던 방식을 중단했습니다. Google 대변인은 Search Engine Land에 이 파라미터가 "공식적으로 지원하는 기능이 아니다"라고 밝혔습니다(Search Engine Land, 2025년 9월 18일). Google의 Custom Search JSON API도 num을 1~10 범위로 제한합니다. 지금은 거의 모든 API에서 10번째 이후의 결과를 보려면 페이지를 넘겨야 합니다.
이는 가격에 영향을 줍니다. Serper가 여전히 결과 10개 초과 시 2크레딧을 과금하는데 한 페이지에 약 10개만 담긴다면, num=100 호출은 거의 같은 결과에 두 배를 내는 셈입니다. Serper에서는 이를 테스트할 수 없습니다.
EveryInfra 쪽은 명확합니다. 한 페이지에 결과가 최대 10개 담기고 호출 1건으로 과금됩니다. 결과 30개가 필요하면 3페이지를 요청해 3번 과금되며, 총 $0.002083입니다. 이번 테스트에서 과금된 web 호출 20건으로 결과 186개, 즉 호출당 9.3개를 얻었습니다. 결과 1,000개당 $0.0746이며, 페이지를 꽉 채우면 $0.0694입니다.
테스트 2: 국가 설정과 현지 결과
두 번째 세트는 지역 파라미터를 테스트합니다. 각 쿼리를 현지 언어로 작성하고 location을 해당 국가로 설정했습니다. 싱가포르 시간 13:38에 "beste laufschuhe 2026"은 독일로, 같은 13:38에 "mejores tenis para correr 2026"은 멕시코로 보냈습니다.
러닝화 추천을 묻는 중국어 쿼리는 13:38에 대만으로 보냈습니다. 독일 호출은 stern.de, faz.net 같은 독일 언론과 alltricks.de, sport-conrad.com 같은 독일 쇼핑몰을 포함해 결과 9개를 반환했습니다. 대만 호출은 adidas.com.tw, salomon.com.tw와 일부 홍콩 언론을 반환했습니다. 멕시코 호출에는 runnersworld.com 같은 영어 사이트와 runnea.com, sprintersports.com 같은 스페인어 사이트가 섞여 있었습니다.
즉 지역 파라미터는 결과를 바꾸지만, 필터가 아니라 선호 설정입니다. 카탈로그에도 분명히 적혀 있습니다. location은 결과의 출처 지역에 영향을 주지만, 모든 결과가 해당 국가의 것임을 보장하지는 않습니다. Serper 페이지에는 국가와 언어별로 검색 위치를 설정할 수 있다고 나와 있습니다. LangChain 래퍼 코드를 보면 실제로 쓰이는 파라미터를 알 수 있습니다. 국가는 gl, 언어는 hl, 기간은 tbs, 결과 유형은 type입니다.
기본값은 gl=us, hl=en입니다. EveryInfra web 도구에는 인터페이스 언어를 지정하는 별도 파라미터가 없습니다. 언어는 쿼리로, 국가는 location으로 지정합니다. 언어로 결과를 걸러야 한다면 앞 섹션에서 소개한 web/search를 사용하세요.
이 세트에서는 사이트와 날짜 제한도 테스트했습니다. 싱가포르 시간 13:38에 "pricing" 쿼리와 site=serper.dev로 검색하자 결과가 3개만 반환되었고 모두 serper.dev였습니다. 첫 번째 스니펫에는 네 팩의 가격이 나와 있었으며, 저장해 둔 페이지 사본과 같았습니다. 13:40에 "search api pricing" 쿼리와 after=2026-10-01로 검색하자 결과 10개가 반환되었습니다.
날짜가 있는 결과 9개는 모두 10월이었습니다. 가장 오래된 것은 2026년 10월 6일이었고, 가장 최근 것은 "3일 전"으로 표시되어 테스트 날짜 기준 2026년 10월 23일이었습니다. 즉 site와 after는 결과의 순서만 바꾸지 않고 실제로 범위를 좁힙니다. 결과 수가 줄어든 것이 그 증거입니다. 모니터링에서 after로 새 페이지만 받으면, 전부 가져와 직접 중복을 제거하는 것보다 비용이 적게 듭니다.
| 작업 | Serper 파라미터(공개 래퍼 기준) | EveryInfra 검색 도구 | 비고 |
|---|---|---|---|
| 특정 국가의 결과 | gl | location(국가 이름 또는 두 글자 코드) | 둘 다 필터가 아닌 선호 설정 |
| 특정 언어의 결과 | hl | web에는 없음, 데이터 카탈로그 web/search의 language | 언어 태그는 RFC 5646을 따름 |
| 기간 지정 | tbs | after, before(날짜) | 약어 코드 없이 일반 날짜 사용 |
| 특정 웹사이트만 | 쿼리에 site: | site 파라미터 또는 site: | site=serper.dev로 결과 3개 반환 |
| 다음 페이지 | page | page | 페이지당 호출 1건 |
| 호출당 결과 수 | num(사용자 보고에 따르면 10개 초과 시 2크레딧) | 페이지당 최대 10개, 페이지당 호출 1건, 더 필요하면 page 사용 | 테스트에서 페이지당 약 9~10개 |
테스트 3: 키워드 10개 순위 확인의 비용과 속도
세 번째 세트는 가장 흔한 작업을 그대로 재현합니다. 콘텐츠 팀이나 SEO 팀이 매일 키워드 목록의 상위 10개를 확인하는 작업입니다. 2026년 10월 26일 싱가포르 시간 13:41~13:43에 location을 미국으로 설정하고 영어 키워드 10개를 확인했습니다. 키워드는 "best crm software for small business"부터 "best air purifier"까지입니다. 호출 10건 모두 성공했습니다. 총 96개의 결과를 반환했고, 비용은 $0.00694, 응답 시간 중앙값은 2.07초였습니다.
결과 96개에서는 SEO 팀이 신경 쓰는 점도 드러납니다. 결과는 서로 다른 도메인 64곳에서 나왔고 58개에 날짜가 있었습니다. reddit.com은 키워드 10개 모두에서 상위 10위 안에 들었으며, 9개에서는 3위, 나머지 1개에서는 2위였습니다. nytimes.com과 youtube.com은 각각 키워드 5개에서 나타났습니다. 1위 URL 10개는 서로 다른 사이트 10곳에서 나왔고, 대부분 제품 사이트나 리뷰 사이트였습니다. 즉 "best + 카테고리" 쿼리에서는 포럼 스레드가 거의 매번 상위 3위 안의 한 자리를 차지합니다. 순위를 추적한다면 자사 순위만 보지 말고, 같은 페이지에서 포럼과 동영상이 몇 자리를 차지하는지도 세어 보세요. 이들이 자연 검색 결과를 아래로 밀어내기 때문입니다. 이 키워드 10개를 하루 한 번 확인하면 월 300회 호출, $0.21입니다.
이제 규모를 키워 보겠습니다. 매일 키워드 500개를 첫 페이지만 확인한다면 월 15,000회 호출입니다. EveryInfra의 청구액은 15,000 × $0.000694 = $10.42입니다. Serper에서는 6개월에 90,000크레딧이 필요합니다.
가장 저렴한 구매는 Starter 팩 2개, $100로, 월 $16.67, 1,000건당 $1.11입니다. 이번에는 키워드마다 상위 30개가 필요하다고 해 보겠습니다. EveryInfra에서는 3페이지를 요청하므로 월 45,000회 호출, $31.25입니다. Serper에서 num=30으로 한 번 보내고 사용자 보고대로 2크레딧이 든다면, 월 30,000크레딧, 6개월에 180,000크레딧이 필요합니다. 가장 저렴한 구매는 Starter 팩 4개, $200로 월 약 $33.33입니다.
두 서비스의 비용은 비슷합니다. 어느 한쪽이 항상 유리하다는 결론은 아닙니다. 먼저 실제 쿼리 패턴을 정확히 적어 본 뒤 비교하세요.
속도는 측정한 그대로 보고합니다. 과금된 호출 29건의 요청 전송부터 마지막 바이트 수신까지 걸린 시간은 중앙값 2.02초, 90번째 백분위수 2.77초였습니다. 가장 빠른 호출은 0.99초, 가장 느린 호출은 3.09초였습니다. 15건이 2초를 넘었습니다. 싱가포르에 있는 머신에서 측정했으므로 네트워크 왕복 시간이 포함되어 있습니다.
Serper 페이지에는 결과가 "1~2초 안에" 반환되며, 재시도가 필요하면 2~4초가 걸린다고 나와 있습니다. 저희는 Serper를 호출하지 않았으므로 동일 조건 테스트는 아닙니다. 앱이 채팅 응답 중에 검색 결과를 기다려야 하나요? 그렇다면 먼저 실제 쿼리 50개로 양쪽을 테스트해 보세요.
실제 사용자 세 유형의 월 청구액은 얼마일까
앞의 곡선은 추상적인 "월 V건 검색"을 기준으로 했습니다. 여기서는 실제 작업 세 가지를 살펴봅니다. 표의 모든 숫자는 함수 하나로 계산했습니다. EveryInfra는 과금 호출 수에 $0.000694를 곱한 값입니다. Serper는 6개월 사용량에 맞는 공개 팩 4종의 가장 저렴한 조합 가격을 6으로 나눈 값입니다.
| 작업 | 월 호출 수 | EveryInfra 월 비용 | Serper 월 비용(가장 저렴한 팩) | 배율 |
|---|---|---|---|---|
| 1인 개발자의 AI 어시스턴트, 하루 약 100회 웹 검색 | 3,000 | $2.08 | $8.33(Starter 1개, 6개월간 36% 사용) | 4.0x |
| 콘텐츠 팀이 매일 키워드 500개의 1페이지 확인 | 15,000 | $10.42 | $16.67(Starter 2개) | 1.6x |
| 같은 팀, 키워드별 상위 30개(3페이지) | 45,000 | $31.25 | $50.00(Starter 6개) | 1.6x |
| 브랜드 모니터링, 빈 결과 15% 가정 | 200,000 | $118.05 | $158.33(Starter 4개 + Standard 2개) | 1.34x |
| 같은 조건, 빈 결과 없음 | 200,000 | $138.89 | $158.33 | 1.14x |
가장 많은 것을 보여 주는 것은 첫 번째 행입니다. 하루 약 100회 검색하는 1인 개발자의 AI 어시스턴트는 월 3,000회 호출이 필요합니다. EveryInfra에서는 월 $2를 조금 넘습니다. Serper의 가장 작은 팩은 $50입니다.
6개월 동안 18,000크레딧을 쓰고 32,000크레딧이 만료되므로 월 $8.33를 내는 셈입니다. 이 사용자에게 문제는 단가가 아닙니다. $50를 낸 뒤 크레딧이 만료되는 것을 지켜봐야 한다는 점입니다. Serper의 무료 쿼리 2,500건으로 처음 몇 주는 충분하지만, 그 뒤 첫 결제는 $50입니다.
네 번째 행의 "빈 결과 15%"는 측정값이 아닌 저희의 가정입니다. 저희가 보낸 호출 35건 중 빈 결과는 1건뿐이었고, 그것도 일부러 만든 것이었습니다. 브랜드 모니터링은 새 브랜드명, 제품 코드, 틈새 주제를 추적하므로 일반 검색보다 결과가 없는 경우가 훨씬 잦습니다. EveryInfra는 빈 결과를 환불하므로, 빈 호출이 15%이면 청구액이 $138.89에서 $118.05로 줄어듭니다.
Serper 페이지에는 크레딧이 "성공한 응답"에 차감된다고 나와 있습니다. 빈 응답이 성공으로 간주되는지는 밝히지 않습니다. 그래서 표에서는 Serper 쪽 모든 호출을 과금했으며, 이는 상한값입니다. Serper가 빈 결과를 과금하지 않는다면 네 번째 행은 다섯 번째 행과 같은 1.14배로 돌아갑니다.
두 번째와 세 번째 행은 둘 다 Serper의 Starter 구간 안에 있으므로 비율이 같습니다. 호출이 3배면 팩도 3배입니다. 비율을 바꾸는 요인은 두 가지뿐입니다. 하나는 더 큰 팩 구간으로 넘어가는 것이고, 다른 하나는 6개월 안에 크레딧을 다 쓰는지 여부입니다. 따라서 선택하기 전에 최근 3개월 로그로 월 사용량과 그 변동 폭을 파악하세요. 어떤 가격표보다 많은 것을 알려 줍니다.
테스트 4: 뉴스, 장소, 쇼핑, 이미지, 학술 등 다른 결과 유형
검색 API를 고를 때 웹 결과만 따질 수는 없습니다. 제품에서 쓰는 다른 결과 유형도 필요합니다. 표는 결과 유형별로 정리했습니다. "Serper 목록 포함 여부" 열은 해당 유형이 Serper 홈페이지의 결과 목록에 있는지만 나타냅니다. 마지막 세 열은 싱가포르 시간 13:39~13:40에 EveryInfra 도구로 유형마다 한 번씩 직접 호출한 결과입니다. 호출마다 $0.000694가 과금되었습니다.
| 필요한 결과 | Serper 목록 포함 여부 | EveryInfra 도구 | 결과 수 | 반환 결과 |
|---|---|---|---|---|
| Web | 예 | web | 9–10 | 제목, URL, 스니펫, 날짜 |
| 뉴스 | 예 | news | 10 | DeepSeek 검색 API 관련 기사, 가장 최근 기사는 1일 전 |
| 장소와 지도 | 예 | places | 10 | 평점, 평점 수, 주소, 전화번호, 위도, 경도, 영업시간이 포함된 싱가포르 카페 |
| 쇼핑 | 예 | shopping | 10 | 가격, 판매처, 평점이 포함된 러닝화 |
| 이미지 | 예 | media(kind=image) | 10 | 이미지 제목과 URL |
| 동영상 | 예 | media(kind=video) | 10 | 동영상 제목과 URL |
| 논문 | 예 | scholar | 10 | 논문 제목, URL, 스니펫 |
| 특허 | 예 | scholar(kind=patents) | 10 | 특허 제목, URL, 스니펫 |
| 자동완성 | 예 | suggest | 10 | "serper api"에 대한 제안어 10개 |
| 페이지 텍스트 | 결과 목록에 없음 | read | 1 | URL 1개의 본문 텍스트 |
장소 결과에는 덧붙일 점이 있습니다. 첫 번째 places 결과는 2,324명이 평점 4.7을 준 싱가포르 카페로, 주소, 전화번호, 좌표가 포함되어 있었습니다. 한 장소의 리뷰를 모두 가져와야 한다면 검색 도구로는 부족합니다. 데이터 카탈로그의 google_maps_reviews/search와 리뷰 기능을 사용하세요. 표준 데이터 등급으로 호출당 $0.001389입니다. 플랫폼 페이지는 Google Maps 리뷰 API입니다. 한국과 러시아의 현지 결과가 필요하면 naver/search와 yandex/search를 사용하세요.
이 세트의 호출 중 두 건은 이 글을 쓰는 데에도 도움이 되었습니다. 첫 번째는 suggest입니다. 싱가포르 시간 13:40에 "serper api"를 조회해 "serper api pricing", "serper api free tier", "serper api key free" 등 제안어 10개를 받았습니다. 집필 전에 다른 도구로 찾은 제안어와 일치했으며, 이 글의 제목과 FAQ를 정하는 데 쓰였습니다.
두 번째는 "DeepSeek search API"로 검색한 news입니다. 기사 10개는 1일 전부터 1주 전 사이에 게시된 것으로, 2026년 10월 17일 DeepSeek 출시 시점과 맞았습니다. 이 기사들을 확인해 "최근 달라진 점" 섹션의 첫 번째 항목으로 정리했습니다.
shopping 호출도 살펴볼 만합니다. 러닝화 10개 모두 가격, 판매처, 평점이 포함되어 있었습니다. 첫 번째는 DICK'S Sporting Goods의 Nike Revolution 8로 $74.99였습니다. 하지만 이 결과의 url은 쇼핑몰이 아니라 검색 엔진 자체의 상품 페이지를 가리킵니다.
가격 비교 서비스를 만든다면 이 점에 유의하세요. 쇼핑몰 페이지의 재고, 사이즈, 리뷰가 필요하면 데이터 카탈로그의 이커머스 기능으로 상품 페이지를 읽으세요. 검색 결과에 나온 가격만으로 판단하지 마세요.
테스트 5: 빈 결과, 요청 속도 제한, 잘못된 파라미터, API 키 누락
두 서비스가 가장 크게 다른 부분입니다. Serper 페이지에는 크레딧이 "성공한 응답"마다 차감된다고 나와 있지만, 성공의 기준은 정의하지 않습니다. 결과가 0개인 200 응답은 성공일까요? 페이지에는 답이 없습니다. EveryInfra는 모든 응답에 규칙이 명시되어 있으며, 측정 결과는 다음과 같습니다.
2026년 10월 26일 싱가포르 시간 13:40에 존재하지 않는 문구를 검색했습니다. 응답은 결과 없는 200이었습니다. billing에는 charged: false, charged_usd: 0.0, reason: empty_result_refunded가 있었고 refund.status는 succeeded였습니다. 같은 1분 안에 web이 받지 않는 파라미터인 gl을 보냈습니다.
응답은 422였습니다. 메시지에는 web이 받는 파라미터 7개가 나열되었고, 마지막에 "Nothing was charged"라고 적혀 있었습니다. API 키 없이 보낸 호출은 401을 반환했으며, 역시 과금되지 않았다고 표시했습니다.
의도치 않게 한도에도 걸렸습니다. 테스트 키는 분당 10회 호출까지 허용하며, 싱가포르 시간 13:38, 13:39, 13:41에 429를 받았습니다. 응답에는 "10 requests per minute for this API key's own limit. Retry after 7s"라는 메시지와 함께 역시 "Nothing was charged"가 표시되었습니다.
RFC 6585는 429를 일정 시간 내 요청이 너무 많은 경우로 정의합니다. RFC 9110은 401을 정의합니다. 429 응답 하나의 본문을 터미널에서 복사해 보관하고 있습니다.
왜 이 행만 따로 비교할까요? Google이 Custom Search JSON API의 신규 고객 접수를 중단한 뒤, r/googlecloud에서 한 사용자가 월 60,000회 호출을 대체할 서비스를 찾았습니다. 비슷한 검색 API를 운영한다고 밝힌 사람이 답글을 달았습니다. 각 업체에 요청을 어떻게 세는지, 재시도와 빈 결과와 추가 페이지가 과금 대상인지 물어보라는 조언이었습니다. "그에 따라 실제 비용이 달라지기 때문"입니다.
모니터링에서는 빈 결과가 흔합니다. 새 브랜드명, 드문 키워드, 좁은 날짜 범위는 모두 결과가 없을 수 있습니다. 저희가 보낸 호출 35건 중 6건, 즉 17%가 과금되지 않았습니다.
시작하기: 회원가입부터 첫 결과까지
| 단계 | Serper | EveryInfra |
|---|---|---|
| 1 | serper.dev에 회원가입하면 신용카드 없이 무료 쿼리 2,500건 제공 | everyinfra.com에 무료로 회원가입 |
| 2 | 대시보드에서 API 키 복사 | 콘솔에서 API 키 복사, 체험용 크레딧은 GitHub에서 everyinfra-agent-plugins에 스타를 누르고 $1 받기 |
| 3 | 무료 쿼리 소진 후 최소 $50 Starter 팩 구매 | 최소 $10 충전, 잔액은 만료되지 않음 |
| 4 | X-API-KEY 헤더로 키 전송(LangChain 등 래퍼 참고) | /api/v1/search로 Authorization: Bearer 전송 |
| 5 | LangChain, CrewAI, Haystack 래퍼 또는 서드파티 MCP 서버로 AI 도구 연결 | 설정 블록 하나로 공식 MCP 엔드포인트에 AI 도구 연결 |
Serper의 무료 제공량이 더 크며, 2,500건이면 새 아이디어를 테스트하기에 충분합니다. 이는 분명한 장점입니다. EveryInfra의 $1 체험은 검색 약 1,440회 분량이며 24시간 안에 사용해야 합니다. "한 달 동안 써 보기"보다는 "오늘 한 번 제대로 돌려 보기"에 적합합니다. 먼저 브라우저에서 결과를 보고 싶다면 샘플 파라미터가 미리 채워진 웹 검색 도구 페이지의 원클릭 체험을 이용하세요. 전체 단계는 빠른 시작에, 모든 기능과 가격은 마켓에 있습니다.
| 무료 제공 | Serper | EveryInfra |
|---|---|---|
| 금액 | 쿼리 2,500건 | $1 크레딧, 약 1,440회 검색 |
| 유효 기간 | 페이지에 명시 없음 | 24시간 |
| 카드 필요 여부 | 아니요 | 아니요 |
| 적합한 용도 | 실제 제품에서 몇 주간 사용 | 오후 한나절 동안 여러 도구와 오류 케이스 테스트 |
두 무료 혜택은 적합한 테스트가 다릅니다. Serper의 쿼리 2,500건이면 실제 제품에서 몇 주간 운영해 볼 수 있습니다. 하루 50회 검색하면 50일 동안 쓸 수 있습니다. EveryInfra의 $1로는 모든 도구와 모든 오류 케이스를 오후 한나절에 시험해 볼 수 있습니다. 저희가 보낸 35건의 호출 비용이 $0.020126이었으므로, $1이면 같은 테스트를 거의 50번 반복할 수 있습니다. 두 무료 혜택 모두 부하 테스트에는 사용하지 마십시오. 테스트 키와 무료 계정은 요청 속도 제한이 더 낮습니다.
무료 사용 이후 첫 결제 금액은 차이가 더 큽니다. Serper는 최소 $50이며, 6개월 안에 쓰지 않은 크레딧은 소멸합니다. EveryInfra는 최소 $10이며 잔액이 유지됩니다. 아직 아이디어를 검증하는 팀이라면 $10을 충전해 한 달간 운영하면서 실제 사용량을 확인한 뒤 결정할 수 있습니다.
6개월 치 사용량을 미리 예측할 필요가 없습니다. 규모가 크고 사용량이 안정적인 팀이라면 이 차이는 작고, 중요한 것은 단가입니다. 이 경우 월간 사용량 표로 돌아가 교차 지점의 어느 쪽에 해당하는지 확인하십시오.
Serper에서 전환하기: 코드에서 바꿔야 할 네 가지
현재 Serper를 사용 중이라면 EveryInfra로 옮길 때 네 가지를 바꿔야 합니다. 항목마다 바꾸는 이유와 잘못했을 때 나타나는 결과를 정리했습니다.
| 변경 사항 | 기존(Serper 래퍼) | 변경 후(EveryInfra) | 잘못했을 때 |
|---|---|---|---|
| 엔드포인트와 키 | 결과 유형마다 별도 URL, X-API-KEY | /api/v1/search, Authorization: Bearer | 401, 과금 없음 |
| 파라미터 | gl, hl, tbs, type | location, after, before, tool | 허용 목록과 함께 422 반환, 과금 없음 |
| 결과 | 업체별 필드 | title, url, snippet, published | 코드에서 파싱 오류 발생 |
| 과금과 재시도 | 크레딧이 0이 되면 중단 | 호출마다 charged_usd, 429 시 retry_after | 즉시 재시도하면 429가 더 발생 |
첫 번째는 엔드포인트와 키입니다. Serper 래퍼는 키를 X-API-KEY 헤더에 넣고 결과 유형마다 다른 URL을 사용합니다.
EveryInfra는 URL이 /api/v1/search 하나이고, 키는 Authorization: Bearer에 넣습니다. 결과 유형은 요청 본문의 tool 필드로 지정합니다. 키를 잘못된 헤더에 넣으면 401이 반환되고 비용은 발생하지 않으며, 오류 메시지에 무엇이 빠졌는지 표시됩니다.
두 번째는 파라미터 이름입니다. gl은 location이 됩니다. tbs는 after와 before 두 날짜로 나뉩니다. type=news는 tool: "news"가 되고, type=places는 tool: "places"가 됩니다. 흔한 실수는 gl 같은 기존 파라미터를 그대로 남겨 두는 것입니다.
EveryInfra는 이런 파라미터를 조용히 무시한 뒤 호출 비용을 그대로 청구하지 않습니다. 422를 반환하고, web이 받는 파라미터 7개를 나열하며, 과금되지 않았다고 알려 줍니다. 이번 테스트의 17번째 호출은 일부러 이 실수를 한 것이었습니다. 이 방식은 AI 에이전트에게 가장 유용합니다. 모델이 오류에 담긴 허용 값을 읽고 다음 호출을 스스로 고치기 때문입니다.
세 번째는 결과를 읽는 방식입니다. EveryInfra의 각 결과에는 title, url, snippet이 있고 경우에 따라 published도 있습니다. places는 평점, 주소, 좌표 등을 추가로 제공합니다. 모든 필드는 검색 도구 카탈로그에 나와 있습니다.
코드에 자체 데이터 타입 계층을 하나 두는 것을 권장합니다. 다른 코드가 읽기 전에 모든 업체의 응답을 이 계층으로 변환하십시오. 그러면 나중에 업체를 바꿔도 나머지 코드는 손대지 않아도 됩니다. ‘최근 달라진 점’ 섹션의 Cloudflare 항목도 같은 방향을 가리킵니다.
네 번째는 과금과 재시도 로직입니다. Serper는 잔액이 0이 되면 새 쿼리를 중단합니다. EveryInfra도 잔액이 부족하면 중단하지만, 잔액은 소멸하지 않습니다. 모든 응답에 charged_usd가 포함되므로 과금 내역을 건별로 기록해 두었다가 월말에 합계를 청구서와 대조할 수 있습니다.
429를 받으면 retry_after에 표시된 초만큼 기다린 뒤 재시도하십시오. 즉시 다시 보내면 429가 더 발생합니다. 네 가지를 모두 바꾼 뒤에는 실제 쿼리 20개를 양쪽에서 실행해 보십시오. 전체를 옮기기 전에 결과 수와 응답 시간을 비교하십시오.
AI 도구 연결: MCP, LangChain, n8n
Serper는 AI 프레임워크용 기성 래퍼가 많으며, 이 역시 실질적인 강점입니다. LangChain, CrewAI SerperDevTool, Haystack SerperDevWebSearch에 모두 포함되어 있어 환경 변수 하나만 설정하면 바로 시작할 수 있습니다. MCP의 경우 serper.dev 페이지에는 공식 서버가 나와 있지 않습니다. GitHub에는 mcp-server-serper나 serper-mcp-server 같은 서드파티 서버가 있으며, 사용자의 로컬 머신에서 직접 실행해야 합니다.
EveryInfra는 공식 원격 MCP 엔드포인트를 운영합니다. Streamable HTTP에 관한 MCP 사양을 따르므로 로컬에 아무것도 설치할 필요가 없습니다. MCP가 처음이라면 MCP 소개에서 구성 요소를 확인할 수 있습니다. 검색은 everyinfra_search 도구 하나로 제공됩니다.
이 도구는 REST API와 똑같이 tool과 params를 받습니다. 도구 설명에도 실패하거나 결과가 비어 있는 검색에는 최종적으로 과금되지 않는다고 명시되어 있습니다. Claude, Cursor처럼 원격 MCP를 지원하는 클라이언트에서는 다음과 같이 설정합니다:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
연결한 뒤 클라이언트에 "use everyinfra_search with the web tool for best crm software, US, page 2"라고 요청하십시오. 클라이언트는 위의 curl과 같은 요청을 보냅니다. 코드에서 검색 도구를 선택하는 방법은 에이전트를 위한 검색 도구 선택 가이드를 참고하십시오. AI가 오류 코드를 보고 파라미터를 스스로 고치게 하려면 스스로 복구하는 API 오류를 참고하십시오.
환불과 과금을 대조하는 방법은 실패 환불 대조를 참고하십시오. n8n에 기성 노드가 없다면 HTTP Request 노드로 같은 JSON을 보내면 됩니다. n8n의 SerpApi 도구 노드 문서에도 비슷한 파라미터 구성이 나와 있습니다.
오후 한나절에 직접 테스트하기
요금표로는 후보를 좁힐 수 있을 뿐입니다. 최종 선택은 직접 실행한 쿼리로 해야 합니다. 세 단계를 권장하며, 단계마다 결과를 보기 전에 명확한 통과 기준을 적어 두십시오. 1단계: 로그에서 실제 쿼리 50개를 무작위로 뽑습니다. 가장 많이 쓰는 국가, 언어, 결과 유형을 포함하십시오. 인기 키워드만 고르지 마십시오. 드물고 긴 쿼리에서 빈 결과와 지역 편차가 가장 잘 드러납니다.
2단계: 50개 쿼리를 양쪽에서 실행합니다. 응답 시간, 결과 수, 과금 여부와 금액을 기록합니다. Serper는 무료 쿼리 2,500건으로 충분합니다. EveryInfra는 $1 체험용 크레딧으로 충분하며, 50건 호출 비용은 $0.035입니다. 3단계: 업체의 마케팅이 아니라 직접 정한 기준으로 비교합니다.
예를 들어 상위 10개 중 브라우저에서 직접 확인한 결과와 일치하는 개수를 셉니다. 90번째 백분위 응답 시간을 기록합니다. 빈 결과가 몇 건인지 세고 각각 과금되었는지 확인합니다. 비용을 합산합니다. ‘10개 중 7개 이상 일치, 90번째 백분위 3초 미만, 빈 결과 무료’처럼 통과 기준을 먼저 적고, 데이터를 본 뒤에는 바꾸지 마십시오.
다음 Python 스크립트는 EveryInfra 쪽 테스트를 실행합니다. 호출마다 결과 수, 응답 시간, 과금액을 출력하며 키는 환경 변수에서 읽습니다:
import json, os, time, urllib.request

def search(q, **params):
    body = json.dumps({"tool": "web", "params": {"q": q, **params}}).encode()
    req = urllib.request.Request(
        "https://api.everyinfra.com/api/v1/search", data=body, method="POST",
        headers={"Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
                 "Content-Type": "application/json", "User-Agent": "price-test/1.0"})
    t0 = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        d = json.load(r)
    return len(d.get("results", [])), round(time.time() - t0, 2), d["billing"]["charged_usd"]

for q in ["best crm software for small business", "best air purifier"]:
    print(q, search(q, num=10, location="us"))
    time.sleep(7)  # the test key allows 10 calls per minute
저희는 2026년 10월 26일 싱가포르 시간 14:00에 이 스크립트를 그대로 실행했습니다. 각 쿼리는 2.84초와 2.02초 만에 결과 10개를 반환했고, 각각 $0.000694가 과금되었습니다. 이 두 호출은 위의 35건에 포함되지 않으며 별도로 기록했습니다. User-Agent 헤더에 주목하십시오.
Python의 기본 요청은 사이트 보호 기능에 차단되는 경우가 있으며, 이때 돌아오는 403은 키가 잘못되었다는 뜻이 아닙니다. 7초 대기는 테스트 키를 분당 10회 미만으로 유지하기 위한 것입니다. 실제 계정 한도는 더 높을 수 있으니 콘솔에서 확인하십시오.
Serper가 더 나은 선택인 경우
Serper가 더 적합한 다섯 가지 경우를 있는 그대로 정리합니다. 첫째, 사용량이 매우 많은 경우입니다. 월 검색량이 300,000회를 초과하고 크레딧을 6개월 안에 모두 쓴다고 가정해 보겠습니다. 그러면 $0.50인 Serper Scale과 $0.30인 Ultimate가 EveryInfra의 $0.694보다 28%~57% 저렴합니다. 검색량이 많을수록 차이가 커집니다.
둘째, 동시 요청 수가 많은 경우입니다. Serper Ultimate 팩은 기본으로 초당 300건의 쿼리를 허용하며, 페이지에는 분당 15,000~18,000회 검색에 해당한다고 나와 있습니다. EveryInfra의 한도는 계정에 따라 다르며, 테스트 키는 분당 10회만 허용했습니다. 대규모 배치 작업이라면 먼저 콘솔에서 한도를 확인하십시오.
셋째, 이미 LangChain, CrewAI, Haystack의 기성 래퍼를 쓰고 있고 코드가 Serper의 파라미터와 응답 구조에 의존하는 경우입니다. 어떤 전환이든 새 코드와 새 파싱 로직이 필요합니다. 월 지출이 수십 달러 수준이라면 전환 작업 비용이 절감액보다 클 수 있습니다. 다만 래퍼 자체도 바뀌고 있습니다. Haystack의 SerperDevWebSearch 소스에는 이 컴포넌트가 Haystack 3.0에서 메인 패키지를 떠나 별도의 serperdev-haystack 패키지로 옮겨 간다고 적혀 있습니다. CrewAI의 SerperDevTool이 있던 crewAI-tools 저장소는 2025년 11월 10일에 보관(archived) 처리되었습니다. 어차피 이런 의존성을 손봐야 한다면 가격을 비교하기 좋은 시점입니다. 넷째, 인터페이스 언어를 세밀하게 제어해야 하는 경우입니다. Serper에는 hl이 있습니다. EveryInfra의 web 검색 도구에는 별도의 언어 파라미터가 없으므로 데이터 카탈로그의 web/search를 써야 하며, 이 경우 호출당 비용이 두 배입니다.
다섯째, 결과 페이지의 부가 블록이 필요한 경우입니다. Serper 홈페이지의 샘플 응답에는 자연 검색 결과와 함께 지식 그래프(knowledgeGraph), ‘관련 질문’(peopleAlsoAsk), 관련 검색어(relatedSearches)가 들어 있습니다. 저희 테스트에서 EveryInfra web 도구는 자연 검색 결과의 제목, URL, 스니펫, 날짜만 반환했습니다. 검색어 추천은 별도의 suggest 호출이 필요하고, 뉴스, 장소, 쇼핑은 각각 전용 도구가 있습니다. 결과 페이지 전체 스냅샷처럼 이 블록을 한 번의 호출로 모두 받아야 하는 제품도 있습니다. 이런 경우에는 Serper 같은 API가 더 직접적입니다.
두 업체 외에도 선택지가 두 가지 더 있습니다. 하나는 직접 호스팅하는 방법으로, 오픈소스 메타검색 엔진인 SearXNG(GitHub 소스)가 그 예입니다. 호출당 요금은 없지만 서버를 직접 운영하고 차단과 불안정한 결과도 직접 처리해야 합니다.
다른 하나는 결과를 다르게 세는 업체입니다. 같은 Hacker News 스레드에서 다른 사용자는 Bright Data가 결과 100개짜리 요청을 1건으로 과금하며 1,000건당 $1.5라고 적었습니다. Bright Data FAQ에도 Google이 num 파라미터를 없앤 뒤의 과금 방식이 설명되어 있습니다. 업체마다 ‘호출 1건’을 세는 방식이 다르며, 대부분의 가격 비교는 바로 이 지점에서 틀립니다.
반대로 EveryInfra가 더 적합한 경우도 있습니다. 월 검색량이 300,000회 미만인 경우입니다. 사용량이 들쭉날쭉해 선불 크레딧이 소멸되는 것을 원하지 않는 경우입니다. 결과가 없는 쿼리가 많은 경우입니다.
원격 MCP로 AI 도구를 연결하려는 경우, 또는 같은 키로 플랫폼 데이터도 필요한 경우입니다. 웹 검색 API 외에 Google Maps 리뷰, 네이버, Yandex 데이터도 포함됩니다. SerpApi와 DataForSEO 비교 페이지도 있습니다.
다른 선택지: 1,000건당 공개 가격
Serper만 있는 것은 아닙니다. 다음은 2026년 10월 26일에 확인한 공개 가격으로, 모두 요청 1,000건당 USD 기준입니다. 단위가 모두 같지는 않습니다. 모델 업체의 검색 도구는 검색 콘텐츠를 토큰으로도 과금합니다.
Exa는 결과 10개를 넘으면 추가 요금을 받습니다. SerpApi는 월간 플랜입니다. 따라서 이 표는 동일 조건을 비교하는 표가 아니라 대략적인 비용 수준을 파악하는 용도로 보십시오.
| 서비스 | 1,000건당(USD) | 과금 조건(출처의 핵심 내용) |
|---|---|---|
| Serper Ultimate / Scale / Standard / Starter | $0.30 / $0.50 / $0.75 / $1.00 | 선불, 6개월 유효 |
EveryInfra web(실측) | $0.694 | 호출당 과금, 결과가 있을 때만, 만료 없음 |
| DeepSeek Search API | $0.75 | 결과가 있는 200 응답만 과금, 빈 결과와 타임아웃은 무료 |
| Exa Lite Search | $4 | 결과 10개까지, 초과분은 1,000건당 $1 추가 |
| Google Custom Search JSON API | $5 | 기존 고객 전용, 2027년 1월 1일 종료 |
| OpenAI 웹 검색 도구 | $10 | 검색 콘텐츠 토큰은 모델 요금으로 별도 과금 |
| Claude 웹 검색 도구 | $10 | 오류 시 과금 없음, 토큰 별도 |
| Gemini의 Google 검색 그라운딩 | $14 | 매월 처음 5,000건 무료 |
| SerpApi Starter | $25 | 월 $25에 검색 1,000회 |
Serper를 두고 결정할 때 가장 유용한 행은 DeepSeek입니다. DeepSeek가 2026년 10월 17일에 공개한 검색 API도 빈 결과와 타임아웃에는 과금하지 않으며, 가격은 1,000건당 $0.75입니다(DeepSeek 릴리스 노트, 2026년 10월 17일). 또 하나의 비교 기준으로 활용하십시오.
최근 달라진 점
| 날짜 | 내용 | 시사점 |
|---|---|---|
| 2026년 10월 2일 | AI Gateway의 Cloudflare Web Search API | 검색 제공업체가 교체 가능한 부품이 되는 중 |
| 2026년 10월 13일 | SerpApi Extract API | 페이지 읽기 가격도 비교할 것 |
| 2026년 10월 17일 | 1,000건당 $0.75의 DeepSeek Search API | 빈 결과 무료가 표준이 되는 중 |
| 2027년 1월 1일 | Google Custom Search JSON API 종료 | 연말 전 대규모 전환 예상 |
DeepSeek, 검색 API 공개(2026년 10월 17일). DeepSeek Search & Fetch 가이드는 성공한 요청 1,000건당 $0.75로 가격을 정했습니다. count 파라미터는 결과 수만 바꾸며 가격은 바꾸지 않습니다. Search Engine Journal은 2026년 10월 19일 각 결과에 페이지 권위 등급도 포함된다고 보도했습니다. PPC Land 보도에 따르면 Claude Code와 Codex에서 실행하는 DeepSeek 검색은 2026년 10월 31일까지 무료입니다.
출처는 위의 DeepSeek 가이드입니다. 시사점: 낮은 가격과 결과가 있는 호출에만 과금하는 방식이 기본 기준이 되고 있습니다. 모든 업체에 이 두 가지를 확인하십시오.
Cloudflare, Web Search API 출시(2026년 10월 2일). Cloudflare 개발자 문서에 따르면 AI Gateway에서 파라미터 하나로 여러 검색 제공업체를 전환할 수 있습니다. 각 검색 비용은 마크업 없이 제공업체의 정가로 AI Gateway 크레딧에서 차감됩니다. 시사점: 검색 API는 교체 가능한 부품이 되고 있습니다. 코드를 특정 업체의 응답 구조가 아니라 자체 계층에 묶어 두십시오.
SerpApi, Extract API 출시(2026년 10월 13일). SerpApi는 블로그 글에서 이제 결과 페이지뿐 아니라 모든 공개 웹 페이지도 가져온다고 밝혔습니다. 문서에 따르면 크롤 모드는 추출한 페이지마다 크레딧 1개를 과금합니다. 시사점: 검색과 페이지 읽기가 하나의 제품으로 합쳐지고 있으니 페이지 읽기 가격도 비교하십시오. EveryInfra read 도구도 호출당 $0.000694입니다.
Google Custom Search JSON API, 2027년 1월 1일 종료. Google 개요 페이지에 따르면 이 API는 신규 고객을 받지 않습니다. 기존 고객은 2027년 1월 1일까지 이전해야 합니다. 기존 고객은 하루 처음 100개 쿼리가 무료이고, 이후 1,000건당 $5입니다. 그보다 앞서 Microsoft는 2025년 8월 11일에 Bing Search API를 종료했습니다(Microsoft Learn).
Microsoft가 제시한 대안은 Azure 에이전트 내부의 Grounding with Bing Search이며, 개발자에게 원시 결과를 제공하지 않습니다. 시사점: 이제 두 대형 검색 엔진 모두 원시 결과를 직접 판매하지 않으므로, 남은 주요 선택지는 서드파티 API입니다. 연말 전에 전환이 대거 몰릴 것으로 예상됩니다.
한계: 이 결과가 성립하지 않는 경우
첫째, 표본이 작습니다. 도구 10개와 국가 4개를 대상으로 호출 35건을 보냈습니다. 가격과 과금 규칙을 확인하기에는 충분하지만 결과 품질이나 장기 안정성을 판단하기에는 부족합니다. 응답 시간 값 29개는 싱가포르의 머신 한 대에서 오후 한나절 동안 측정한 것입니다.
둘째, Serper 쪽 정보는 모두 공개 페이지와 사용자 게시물에서 나왔습니다. ‘결과 10개 초과 시 크레딧 2개’는 사용자 제보입니다. 빈 결과처럼 페이지에 언급이 없는 부분은 추측하지 않았습니다.
셋째, 세금을 제외한 정가로 비교했습니다. Serper 페이지에는 가격에 판매세, VAT, GST가 포함되지 않는다고 나와 있으며, EveryInfra 충전 페이지에도 별도 안내가 있습니다. 넷째, EveryInfra의 요청 속도 제한은 계정마다 다릅니다. 이 글의 분당 10회는 테스트 키의 설정일 뿐입니다. 다섯째, 가격은 바뀝니다.
Serper의 가격 4개는 2026년 10월 26일 싱가포르 시간 13:32에 확인했고, EveryInfra 가격은 같은 날 카탈로그에서 가져왔습니다. 어느 한쪽이라도 가격을 바꾸면 비율과 교차 지점을 다시 계산해야 합니다. 방법은 두 단계입니다. serper.dev 페이지와 EveryInfra 검색 도구 카탈로그를 다시 확인한 다음, 새 팩 가격과 단가를 만료 섹션의 계산 방법에 대입합니다. 그러면 표와 차트의 모든 수치를 다시 계산할 수 있습니다. 게시 전에 양쪽 가격을 다시 확인하겠습니다.
한 가지 더 있습니다. 이 글은 같은 키워드에 대해 양쪽이 반환하는 순위를 비교하지 않습니다. 비교한 것은 가격, 과금, 결과 유형, 설정 단계입니다. 결과를 비교하려면 실제 쿼리 50개를 양쪽에서 실행하고 원시 응답을 직접 읽어 보십시오.
FAQ
Serper API 무료 티어는 얼마나 되며, 만료되나요?
이 질문은 Google 추천 검색어 "serper api free tier"와 "serper dev free tier"에서 가져왔습니다. Serper 홈페이지에는 신용카드 없이 "Get 2,500 free queries"라고 적혀 있습니다. 무료 쿼리의 만료 기한은 페이지에 나와 있지 않습니다. 유료 크레딧은 6개월간 유효합니다. EveryInfra 체험용 크레딧은 $1(약 1,440회 검색)이며, EveryInfra GitHub 저장소에 스타를 누르면 받을 수 있습니다. 유효 기간은 24시간입니다.
Serper API 요금은 어떻게 책정되나요? 결과 100개를 요청하면 비용이 두 배인가요?
이 질문은 추천 검색어 "serper api pricing"과 "serper dev pricing"에서 가져왔습니다. $50, $375, $1,250, $3,750 네 가지 팩 중 하나를 선불로 구매하며, 1,000건당 $1.00~$0.30이고 6개월간 유효합니다. ‘결과 10개 초과 시 크레딧 2개’ 규칙은 Hacker News 사용자에게서 나온 것으로 요금 카드에는 없습니다. EveryInfra는 한 페이지에 결과가 최대 10개이며 호출 1건으로 과금됩니다. 더 필요하면 page를 사용하십시오.
Google 검색 결과용으로 Serper보다 저렴한 대안이 있나요?
이 질문은 추천 검색어 "serper api alternative free"와 "serper alternatives"에서 가져왔습니다. 사용량에 따라 다릅니다. 월 300,000회 미만이라면 6개월 만료를 계산에 넣어야 합니다. 그러면 1,000건당 $0.694인 EveryInfra 가격이 Serper에서 실제로 내는 금액보다 낮습니다.
사용량이 적을수록 차이가 커집니다. 월 300,000회를 넘으면 Serper Scale과 Ultimate가 더 저렴합니다. 1,000건당 $0.75인 DeepSeek도 비슷한 가격대입니다.
Serper와 SerpApi의 차이는 무엇인가요?
이 질문은 추천 검색어 "serper api vs serpapi"에서 가져왔습니다. 두 공개 페이지를 기준으로 보면, Serper는 1,000건당 $0.30~$1.00에 선불 크레딧을 판매합니다. SerpApi는 월간 플랜을 판매하며, Starter는 월 $25에 검색 1,000회이고 더 많은 검색 엔진과 결과 유형, 미국 법적 보호 조항을 제공합니다. 더 자세한 표는 SerpApi 비교 페이지에 있습니다.
Serper에 요청 속도 제한이 있나요?
이 질문은 추천 검색어 "serper dev rate limit"에서 가져왔습니다. 네, 팩마다 다릅니다. Starter는 초당 50건, Standard는 100건, Scale은 200건, Ultimate는 300건입니다. 페이지에는 더 높은 한도를 요청할 수 있다고 나와 있습니다. EveryInfra의 한도는 계정에 따라 다릅니다. 호출이 너무 많으면 retry_after와 함께 429가 반환되며 비용은 발생하지 않습니다.
실패한 호출, 빈 결과, 재시도에도 비용이 드나요?
이 질문은 r/googlecloud 스레드에서 비슷한 API를 운영한다고 밝힌 사람의 답글에서 가져왔습니다. Serper는 ‘성공한 응답’마다 크레딧이 차감된다고 설명합니다. 저희 테스트에서 EveryInfra는 빈 결과에 charged: false를 반환하고 환불했으며, 401, 422, 429 응답에는 모두 "Nothing was charged"라고 표시되었습니다.
Google Custom Search API를 무엇으로 대체할 수 있나요?
이 질문은 같은 r/googlecloud 게시물에서 가져왔습니다. 작성자는 월 40,000~60,000건을 호출하며 1,000건당 약 $5의 예산을 잡았습니다. 이 글의 수치로 계산하면 60,000건은 EveryInfra에서 월 $41.67입니다. Serper에서는 6개월간 360,000건이 $375짜리 Standard 팩 하나에 들어가며, 월 $62.50입니다.
참고 자료
- Serper 홈페이지(요금 섹션 및 FAQ), serper.dev, 2026년 10월 26일 확인. https://serper.dev/
- “Serper Terms of Service”(Refund Policy), serper.dev, 2024년 5월 29일 업데이트. https://serper.dev/terms
- Serper 결과 수와 크레딧에 관한 스레드, Hacker News. https://news.ycombinator.com/item?id=43921687
- “Picking ONE Google SERP API in 2026”, Reddit r/WebScrapingInsider. https://www.reddit.com/r/WebScrapingInsider/comments/1sesvvq/picking_one_google_serp_api_in_2026_feels_less/
- “Google Custom Search API is closing”, Reddit r/googlecloud. https://www.reddit.com/r/googlecloud/comments/1qp4mlz/google_custom_search_api_is_closing_need/
- “Custom Search JSON API overview”, Google for Developers. https://developers.google.com/custom-search/v1/overview
- “Method: cse.list”, Google for Developers. https://developers.google.com/custom-search/v1/reference/rest/v1/cse/list
- “Bing Search APIs retiring on August 11, 2025”, Microsoft Learn. https://learn.microsoft.com/en-us/lifecycle/announcements/bing-search-api-retirement
- “Grounding with Bing Search”, Microsoft Learn. https://learn.microsoft.com/en-us/azure/ai-foundry/agents/how-to/tools/bing-grounding
- “Search & Fetch guide”, DeepSeek API Docs. https://api-docs.deepseek.com/guides/search
- Search and Fetch API를 포함한 DeepSeek-V4.1-Flash-1017 릴리스, DeepSeek, 2026년 10월 17일. https://api-docs.deepseek.com/news/news261017
- “DeepSeek Opens Its In-House Search Engine To Developers”, Search Engine Journal, 2026년 10월 19일. https://www.searchenginejournal.com/deepseek-opens-its-in-house-search-engine-to-developers/593526/
- “DeepSeek prices web search for AI agents at $0.75 per 1,000 calls”, PPC Land(2차 자료, 원 출처는 11번 항목). https://ppc.land/deepseek-prices-web-search-for-ai-agents-at-0-75-per-1-000-calls/
- Cloudflare Web Search API 문서, Cloudflare, 2026년 10월 2일 업데이트. https://developers.cloudflare.com/web-search/
- “Introducing the SerpApi Extract API”, SerpApi 블로그, 2026년 10월 13일. https://serpapi.com/blog/introducing-extract-api/
- Extract API 문서, SerpApi. https://serpapi.com/extract-api
- SerpApi 요금, serpapi.com. https://serpapi.com/pricing
- “Google Search confirms it does not support the results per page parameter”, Search Engine Land, 2025년 9월 18일. https://searchengineland.com/google-search-confirms-it-does-not-support-the-results-per-page-parameter-462244
- Exa 요금, exa.ai. https://exa.ai/pricing
- “Pricing”, OpenAI 플랫폼 문서. https://platform.openai.com/docs/pricing
- “Web search tool”, Claude 문서. https://docs.claude.com/en/docs/agents-and-tools/tool-use/web-search-tool
- “Gemini Developer API pricing”, Google AI for Developers. https://ai.google.dev/gemini-api/docs/pricing
- “GoogleSerperAPIWrapper”, LangChain Reference. https://reference.langchain.com/python/langchain-community/utilities/google_serper/GoogleSerperAPIWrapper
- google_serper.py 소스, langchain-community, GitHub. https://github.com/langchain-ai/langchain-community/blob/main/libs/community/langchain_community/utilities/google_serper.py
- “SerperDevTool”, CrewAI 문서. https://docs.crewai.com/v1.15.28/en/tools/search-research/serperdevtool
- “SerperDev”, Haystack 문서. https://docs.haystack.deepset.ai/reference/integrations-serperdev
- mcp-server-serper, GitHub. https://github.com/marcopesani/mcp-server-serper
- serper-mcp-server, GitHub. https://github.com/garylab/serper-mcp-server
- “Model Context Protocol specification 2025-11-25”. https://modelcontextprotocol.io/specification/2025-11-25
- “Introduction to MCP”, modelcontextprotocol.io. https://modelcontextprotocol.io/docs/getting-started/intro
- EveryInfra 검색 도구 카탈로그(키 불필요), 2026년 10월 26일 확인. https://api.everyinfra.com/api/v1/search/tools
- EveryInfra 데이터 기능 카탈로그(키 불필요), 2026년 10월 26일 확인. https://api.everyinfra.com/api/v1/social/catalog
- “RFC 6585: Additional HTTP Status Codes”(429), IETF. https://www.rfc-editor.org/rfc/rfc6585
- “RFC 9110: HTTP Semantics”(401, 422), IETF. https://www.rfc-editor.org/rfc/rfc9110
- “RFC 5646: Tags for Identifying Languages”, IETF. https://datatracker.ietf.org/doc/html/rfc5646
- SearXNG 문서. https://docs.searxng.org/
- SearXNG, GitHub. https://github.com/searxng/searxng
- “SERP API FAQs”, Bright Data 문서. https://docs.brightdata.com/scraping-automation/serp-api/faqs
- “SerpApi Tool node”, n8n 문서. https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolserpapi/
- SerperDevWebSearch 소스, Haystack, GitHub. https://github.com/deepset-ai/haystack/blob/main/haystack/components/websearch/serper_dev.py
- serper_dev_tool.py(crewAI-tools, 2025년 11월 10일 보관 처리), GitHub. https://github.com/crewAIInc/crewAI-tools/blob/main/crewai_tools/tools/serper_dev_tool/serper_dev_tool.py
참고 BL-48