n8n 일일 트렌드 리포트: 2.45 스케줄러 직접 테스트
n8n 2.45.3을 스케줄로 돌려 EveryInfra의 X, Weibo, Douyin 인기 급상승 목록을 가져오고, 일부러 두 번 중단한 뒤 모든 실행과 누락된 실행, 과금 내역을 하나하나 확인했습니다.
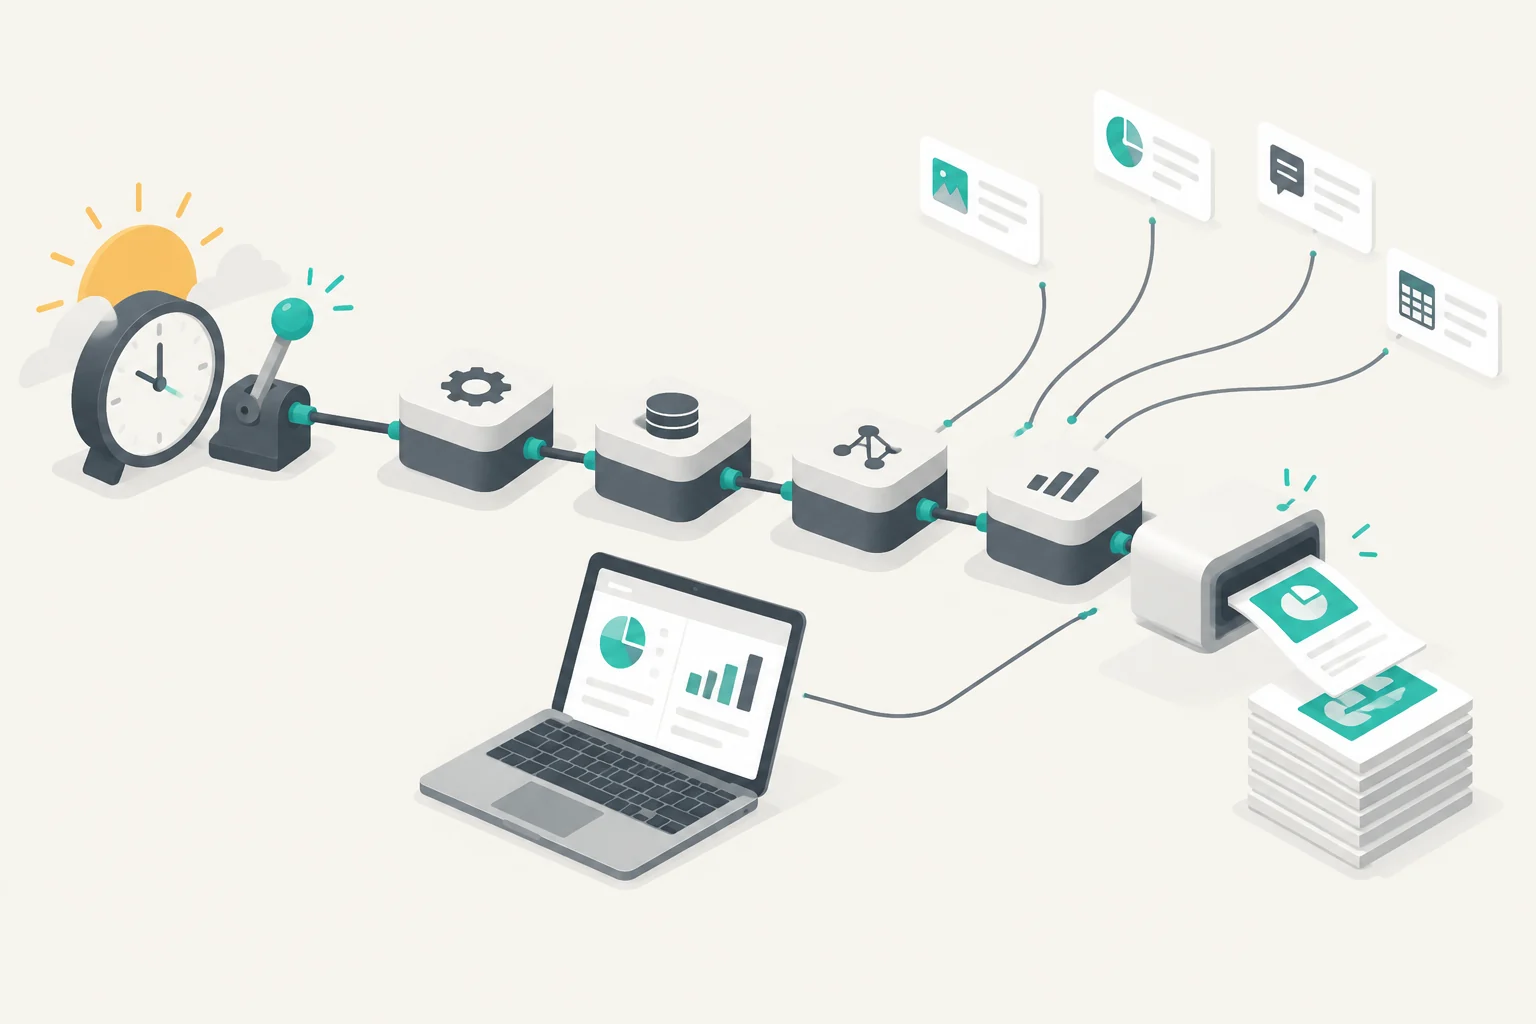
셀프 호스팅 n8n 워크플로로 EveryInfra 데이터를 받아 실행당 $0.002224에 일일 트렌드 리포트를 만들 수 있습니다. 어려운 부분은 API 호출이 아닙니다. 첫째는 n8n이 꺼져 있는 동안 예정 시각이 지나간 실행입니다. 둘째는 이중 과금처럼 보일 수 있는 재실행입니다. 셋째는 호출 하나가 실패하면 리포트 전체가 멈출 수 있다는 점입니다.
2026년 10월 26일 싱가포르 시간 10:36~11:25(SGT, UTC+8; UTC 02:36–03:25)에 Mac에서 n8n 2.45.3을 3분 간격으로 실행했습니다. 일부러 두 번 중단했습니다. 그런 다음 리포트 14건을 데이터베이스, 메트릭, 자체 서버 로그와 대조했습니다.
이 글에서 “일일 트렌드 리포트”는 사용자 자신의 컴퓨터에서 실행하는 n8n 워크플로를 말합니다. Schedule Trigger 노드가 워크플로를 시작합니다. Code 노드가 읽을 인기 급상승 목록을 나열합니다. HTTP Request 노드가 API 키 하나로 EveryInfra를 호출합니다. 두 번째 Code 노드가 목록별 상위 10개, 직전 실행과 겹치는 항목, 비용을 Markdown 파일로 씁니다.
이 리포트는 오늘 아침 사람들이 무엇을 이야기하는지 알려 줍니다. 무엇이 뜰지 예측하지 않으며, 주제가 사실인지도 확인하지 않습니다.


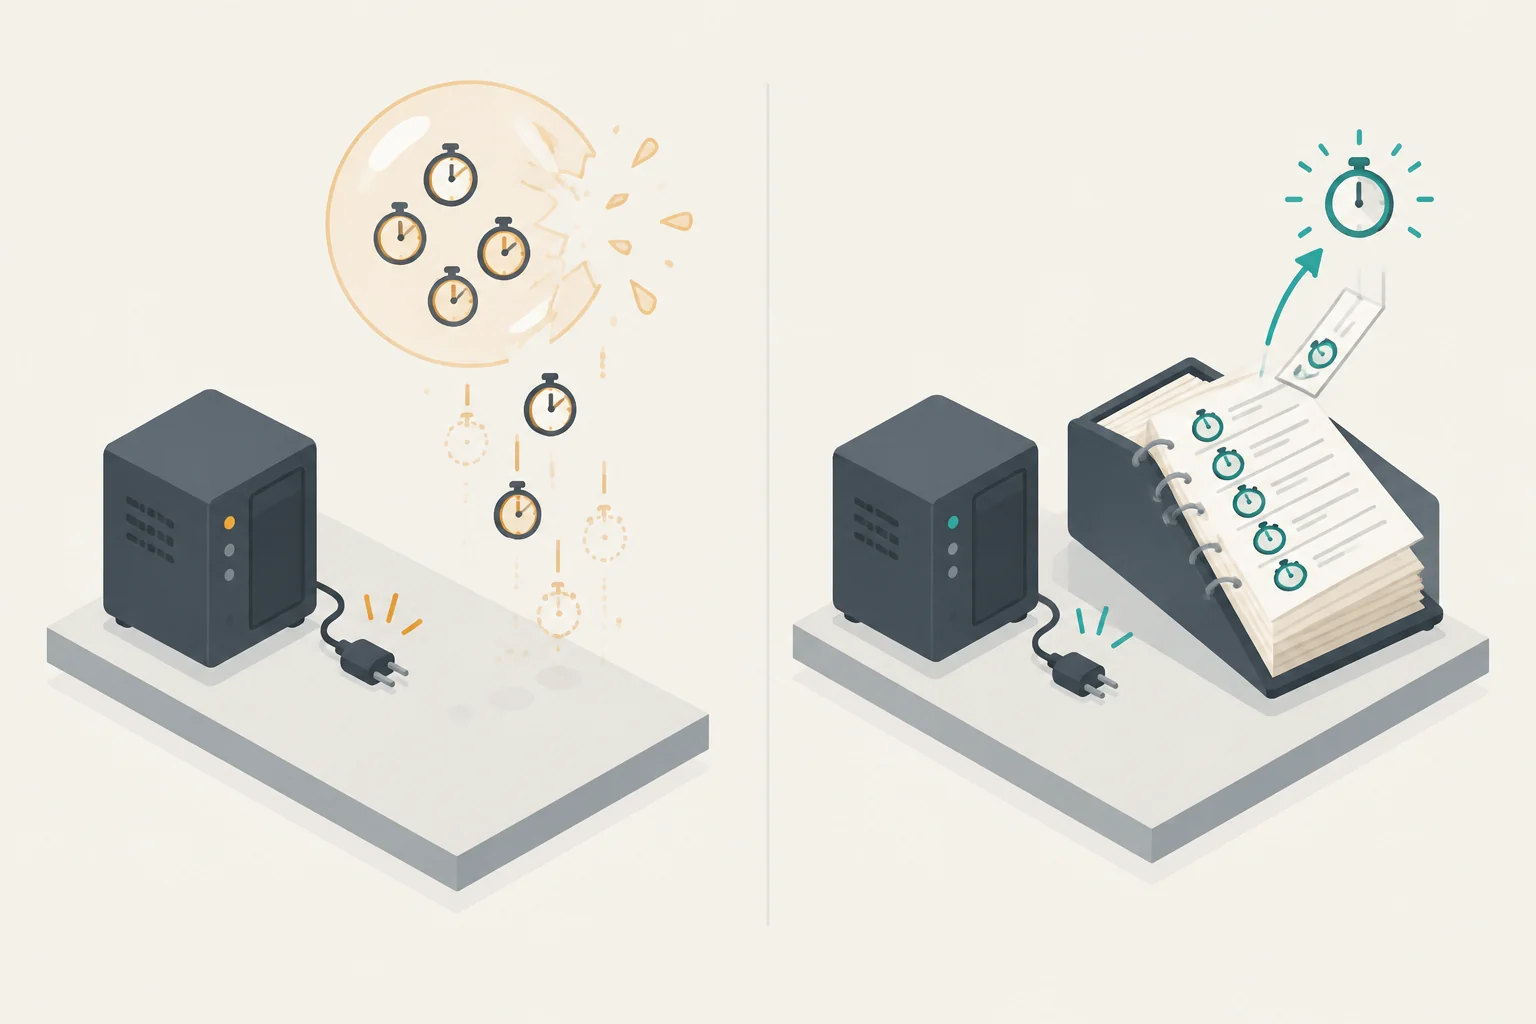
이 그림은 내구성 스케줄러의 개념을 보여 줍니다. 실행은 프로세스 안의 타이머가 아닙니다. 예정 시각보다 먼저 데이터베이스에 기록되는 하나의 행입니다. 시각이 되면 n8n 프로세스 하나가 그 행을 점유해 실행합니다. n8n 문서는 이 과정을 구체화, 실행, 복구, 보존, 소유자 조정의 다섯 단계로 나눕니다. 아래의 각 테스트에서는 이 단계들에 해당하는 SQLite의 실제 행을 읽었습니다.
리포트 1건의 모습
10:39:24 SGT 실행의 리포트입니다. 원본 파일은 5단계의 첫 버전으로 만들어졌는데, 이 버전은 Weibo 프로모션 슬롯 하나에도 순번을 매겼습니다. 그래서 그 실행의 원본 응답을 수정된 5단계(rank로 정렬, rank가 없는 행은 건너뜀)로 다시 생성했습니다. 분량을 줄이려고 목록 행 일부를 뺐습니다.
# EveryInfra daily report 2026-10-26T10:39:24.294+08:00

## X US trends (52 items, $0.000556)
1. Lula
2. Brazil
3. Mahomes
4. Chiefs

## X Mexico trends (71 items, $0.000556)
1. Lula
2. Pachuca
3. #EleccionesBrasil2026

## Weibo hot search (10 items, 2 promoted slots skipped, $0.000556)
4. Brazil's President Lula wins re-election

## Deliberately misspelled list name: failed (HTTP 422, invalid_value)
- `boards` must be one of: challenge, entertainment, hotspot, seeding, social (got 'hot')

## Cost of this run
- Sum of charged_usd in the responses: $0.002224
- Actual charge after removing replays: $0.002224
저희 팀이 워크플로를 중국어로 작성했기 때문에 제목이 중국어입니다. 레이블은 Code 노드 안의 자유 텍스트라서 한 줄만 고치면 영어로 바꿀 수 있습니다. 이 파일에서 눈여겨볼 점이 두 가지 있습니다.
첫째, 사건 하나가 네 목록 상위에 동시에 올랐습니다. 브라질은 10월 25일 대통령 선거 결선 투표를 치렀습니다(최고선거법원 공지). 다음 날 10:39 SGT(뉴욕 시간 10월 25일 22:39)에 “Lula”는 미국과 멕시코의 X 트렌드에서 1위였습니다. 같은 소식은 중국 Weibo 실시간 검색어에서 4위, Douyin 핫스팟 목록에서 5위였습니다. Weibo 순위에는 설명이 필요합니다. Weibo 응답의 네 번째 행은 rank 필드가 없는 브랜드 캠페인, 즉 프로모션 슬롯이었습니다(Weibo 실시간 검색어 규칙은 상업 광고를 레이블 유형 중 하나로 명시합니다). Lula 행의 rank는 4였습니다. 첫 리포트 노드는 위치 순서대로 번호를 매겼기 때문에 Lula를 5위로 표시하고 광고를 인기 주제로 올렸습니다. 지금 5단계는 rank로 정렬하고, rank가 비어 있는 행은 건너뛰며, 건너뛴 개수를 제목에 표시합니다. 여러 플랫폼을 함께 보는 리포트에서는 이런 겹침이 한눈에 드러납니다. 같은 시각 미국 트렌드에는 스포츠도 함께 올라옵니다. “Mahomes”, “Chiefs”, “Packers”가 미국 상위 10위의 나머지를 채웠습니다.
둘째, 실패한 호출 때문에 리포트가 실패하지 않았습니다. 리포트에는 실패 사유와 제안 값이 짧은 메모로 표시됩니다. 비용 항목에는 실패한 호출의 비용이 0이라고 나옵니다. 이 처리를 첫 오류가 난 뒤가 아니라 그 전에 설계해야 하는 이유는 테스트 4에서 설명합니다.
첫 실행 전에 정한 통과 기준
첫 실행 전에 통과 기준 10개를 점검 파일에 적었습니다. 결과를 본 뒤에도 바꾸지 않았습니다. 예외가 하나 있습니다. 원래는 계정 잔액으로 과금을 확인할 계획이었습니다. 그런데 10:33 SGT에 다른 작성자들도 같은 테스트 키를 쓴다는 사실을 알게 되었고, 그 경우 잔액은 그들의 호출로도 바뀝니다. 그래서 과금되는 호출을 하기 전에 확인 방법을 바꿔 각 request_id를 서버 호출 로그에서 조회하기로 했습니다.
| ID | 확인 항목 | 통과 기준 | 결과 |
|---|---|---|---|
| J1 | 실행이 자동으로 시작됨 | mode=trigger 실행이 3회 이상이고, 실행마다 리포트를 작성 | 통과: 실행 14회, 파일 14개 |
| J2 | 정시 실행 | 정상 실행에서 시작 시각과 예정 시각의 차이가 5초 이하 | 통과: 0.008~0.034초 |
| J3 | “Every N minutes”는 게시 시점부터 계산 | 실행 간격 180 ±5초, 매분 0초에 맞춰지지 않음 | 통과: 모두 3분 단위 시각에서 24.206초 경과 시점 |
| J4a | 유예 시간 내 중단 | 예정 시각 1개에 걸친 32초 중단: A와 B 모두 늦게 실행 | 통과: 둘 다 21.8초 지연 |
| J4b | 유예 시간 초과 중단, 기본 정책 | A는 누락된 실행 2회를 모두 건너뜀 | 통과 |
| J4c | 유예 시간 초과 중단, 따라잡기 정책 | B는 따라잡기 실행을 1회만 수행 | 통과: 1회 실행, 89.0초 지연 |
| J5 | 비용 | 리플레이가 없는 각 실행 = 4 × $0.000556, 호출 단위로 서버 로그와 일치 | 통과: 과금된 호출 56건 모두 일치 |
| J6 | 실패 1건이 리포트를 멈추지 않음 | 잘못된 호출은 did_you_mean과 함께 422를 반환하고 비용은 $0이며, 나머지 호출은 계속 진행 | 통과 |
| J7 | MCP | MCP Client 노드가 REST와 같은 필드로 everyinfra_call_api 호출 | 통과 |
| J8 | 목록 변화 속도 | 개수만 집계: 실행 간 상위 10개 항목의 중복 수 | “45분 동안 목록은 얼마나 바뀌었나” 참고 |
| J9 | 키가 디스크에 기록되지 않음 | n8n 데이터베이스, 실행 데이터, 리포트, 원본 파일에서 키 검색 결과 0건 | 통과: 0건 |
| J10 | 리플레이는 다시 과금되지 않음 | 같은 Idempotency-Key 재사용: replayed: true, 두 번째 로그 항목 없음 | 통과 |
예약 작업의 가장 까다로운 문제는 오류로 드러나지 않습니다. 실행이 빠지거나, 두 번 실행되거나, 과금이 조금 많이 나오는 식입니다. 그래서 점검 기준에 건수, 행, 비용을 미리 명시했습니다. 한 n8n 사용자는 항목을 0개 받은 노드에 관해 글을 올렸습니다. 다음 노드는 실행되지 않는데도 실행 상태는 “Success”로 표시되고, 오류 워크플로도 시작되지 않는다는 내용입니다(Reddit r/n8n 스레드). 이런 문제는 예상 건수, 행, 비용을 먼저 적어 두어야만 찾을 수 있습니다.
시작하기 전에: 버전, 설치 방법, Node.js
버전. durable scheduler는 2026년 10월 20일 출시된 n8n 2.45.0부터 기본으로 켜져 있습니다. 변경 내역에는 Schedule Trigger 노드가 “이제 기본적으로 durable scheduler에서 실행된다”고 나와 있습니다. 하지만 10월 26일 기준 npm 레지스트리의 latest 태그는 여전히 2.44.6(10월 22일)이었습니다. 2.45.3(10월 23일)은 next와 beta 태그에 있었습니다. 따라서 지금 npm install n8n만 실행하면 durable scheduler가 기본으로 꺼져 있는 2.44.6이 설치됩니다. 이 테스트를 재현하려면 버전을 지정해야 합니다.
n8n은 두 라인에 패치도 따로 배포합니다. 10월 14일 보안 업데이트에는 “beta는 v2.44.1에서 패치”, “stable은 v2.43.5에서 패치”라고 적혀 있습니다.
| 설치 명령 | 10월 26일 기준 버전 | Durable scheduler | 이번 테스트에서 사용 |
|---|---|---|---|
npm install n8n | 2.44.6 (latest) | 기본값 꺼짐, N8N_SCHEDULER_ENABLED=true 설정 필요 | 아니요 |
npm install n8n@'2.45.3' | 2.45.3 (next, beta) | 기본값 켜짐 | 예 |
| n8n Cloud | n8n이 관리 | Cloud 버전을 따름 | 아니요(회원가입하지 않음) |
| Docker 이미지 | 가져온 태그에 따라 다름 | 2.45부터 기본값 켜짐 | 테스트하지 않음(이 Mac에 Docker 없음) |
10월 13일부터 23일까지 2.44와 2.45 두 라인은 npm에 합쳐서 7개 버전(2.44.0~2.45.3)을 배포했고, 번갈아 가며 패치를 냈습니다. 온라인 튜토리얼을 보고 “최신 버전”을 설치하면 어느 라인이든 설치될 수 있습니다.
설치 방법. 이 Mac에는 Node.js가 있고 Docker가 없어서 npm을 사용했습니다. 감수해야 할 점이 두 가지 있습니다. 첫째, npm 설치 페이지에는 “n8n 3.0부터 npm 기반 설치 방식은 더 이상 권장되지 않는다”고 나와 있습니다. 3.0 호환성 변경 사항 페이지에는 3.0에는 Docker가 필요하며 npm에는 실행 가능한 n8n 패키지가 배포되지 않는다고 나와 있습니다. GitHub의 n8n 개발자 가이드는 v3 출시 시점을 2026년 10월경으로 잡고 있습니다. 저희가 설치한 n8n도 시작할 때 “Running n8n outside a container is deprecated”라는 경고를 출력했습니다.
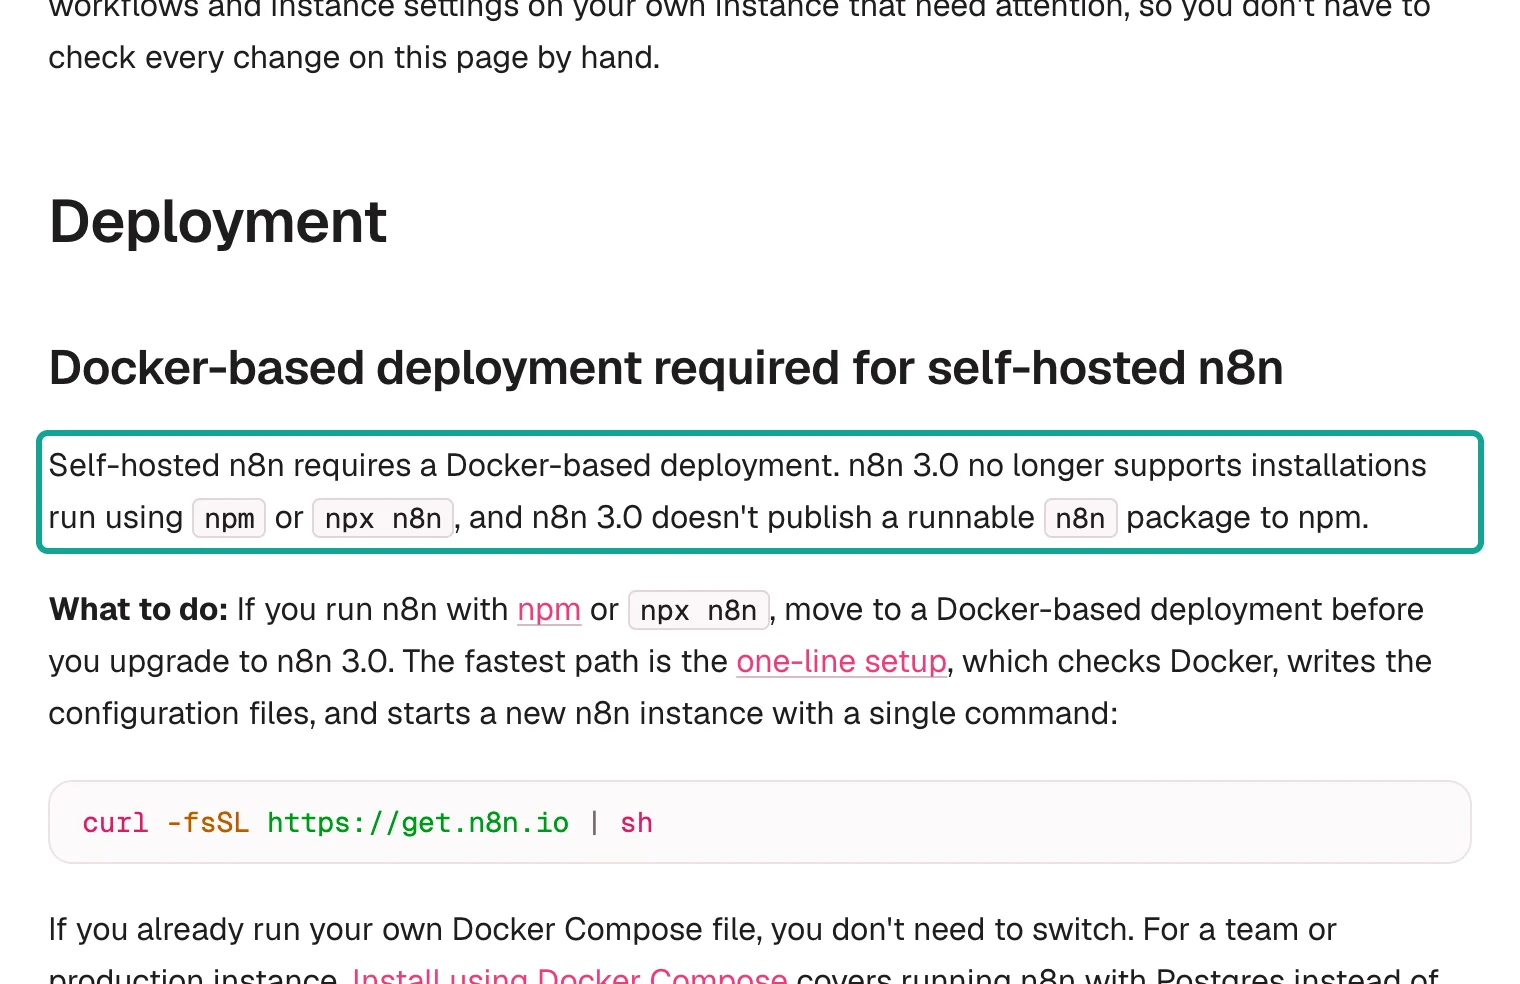
따라서 npm은 노트북에서 테스트할 때는 괜찮습니다. 몇 달 동안 매일 돌아가는 리포트에는 Docker Compose나 한 줄 설치를 사용하세요.
둘째, 용량입니다. 새로 설치하자 6분 동안 패키지 2,328개가 추가되었고, node_modules가 4.4 GB를 차지했습니다. 첫 설치는 도중에 멈췄습니다. 반쯤 설치된 폴더는 시작할 때 Cannot find module 'kuler' 오류로 실패했습니다. 같은 폴더에서 npm install을 다시 실행해도 해결되지 않았습니다.
node_modules와 package-lock.json을 삭제하고 다시 설치하자 n8n이 시작되었습니다. 설치가 중간에 멈추면 빈 폴더에서 다시 시작하세요. 이것이 가장 빠른 해결 방법입니다.
Node.js 버전. 문서와 패키지의 내용이 서로 다릅니다. npm 설치 페이지에는 “20.19 이상 24.x 이하”라고 나와 있습니다. 패키지 자체(npm view n8n@'2.45.3' engines)는 >=24.0.0을 요구합니다. Node.js 릴리스 표를 보면 20은 2026년 3월에 지원이 종료되었고, 24는 LTS, 26은 “Current”입니다. 저희는 26.11.1을 사용했고 이번 테스트에서는 문제가 없었습니다. 다만 문서에 명시된 범위를 벗어나므로, 오래 돌릴 리포트에는 Node.js 24 LTS를 사용하세요.
함정이 하나 더 있습니다. 바로 포트입니다. 처음에는 n8n을 5679 포트로 설정했습니다. n8n은 로그에 “n8n Task Broker's port 5679 is already in use” 한 줄을 남기고 곧바로 멈췄습니다. n8n 2.x에서는 Code 노드가 내장 task runner에서 실행되며, 그 broker가 기본으로 5679 포트를 씁니다. 그래서 N8N_PORT를 5690으로 옮기고 N8N_RUNNERS_BROKER_PORT를 5691로 설정했습니다.
그러자 n8n이 시작되었습니다. 사용한 설정 전체는 다음과 같습니다:
export N8N_USER_FOLDER=$HOME/Downloads/n8n-lf25/home # database and encryption key live here
export N8N_PORT=5690 N8N_LISTEN_ADDRESS=127.0.0.1 # listen on this machine only
export N8N_RUNNERS_BROKER_PORT=5691 # keep away from the broker default 5679
export GENERIC_TIMEZONE=Asia/Singapore TZ=Asia/Singapore # the default is America/New_York
export N8N_RESTRICT_FILE_ACCESS_TO=$HOME/Downloads/n8n-lf25/reports
export N8N_DIAGNOSTICS_ENABLED=false N8N_VERSION_NOTIFICATIONS_ENABLED=false
export N8N_METRICS=true N8N_METRICS_INCLUDE_SCHEDULER_METRICS=true
npm install n8n같은 설정을 표로 정리하고 각 설정의 이유를 덧붙였습니다:
| 변수 | 기본값 | 설정값 | 이유 |
|---|---|---|---|
N8N_USER_FOLDER | ~/.n8n | ~/Downloads 안의 폴더 | 데이터베이스와 암호화 키를 테스트 폴더에 함께 보관 |
N8N_PORT | 5678 | 5690 | 5679 포트는 task broker 기본값 |
N8N_LISTEN_ADDRESS | 모든 인터페이스 | 127.0.0.1 | 이 컴퓨터에서만 에디터를 열 수 있음 |
N8N_RUNNERS_BROKER_PORT | 5679 | 5691 | 다른 설정과 충돌하지 않도록 명시적으로 지정 |
GENERIC_TIMEZONE | America/New_York | Asia/Singapore | 트리거가 어느 지역의 “오전 8시”를 쓸지 결정 |
N8N_RESTRICT_FILE_ACCESS_TO | ~/.n8n-files | reports/ 폴더 | 파일 노드가 쓸 수 있는 유일한 폴더 |
N8N_METRICS와 N8N_METRICS_INCLUDE_SCHEDULER_METRICS | false | true | 누락 실행 및 보충 실행 카운터 |
이 컴퓨터에서만 n8n을 열 수 있도록 수신 주소를 127.0.0.1로 지정했습니다. 인터넷 스캐닝 기업 Censys는 10월 14일 연례 보고서에서 공용 인터넷에 노출된 n8n 호스트를 113,926개로 집계했으며, 버전을 확인할 수 있는 호스트 중 76%에 최근 공개된 치명적 취약점이 하나 이상 있었습니다(Censys 블로그). n8n은 2주마다 보안 업데이트도 배포합니다(예: 10월 1일 업데이트). 다른 컴퓨터에서 리포트를 보려면 reports/ 폴더를 동기화하세요. n8n 에디터를 인터넷에 공개하지 마세요.
시간대 설정 줄을 빼먹지 마세요. 시간대 페이지에 따르면 셀프 호스팅 인스턴스는 기본으로 America/New_York을 사용합니다. Schedule Trigger는 이 시간대로 사용자가 말한 “오전 8시”가 언제인지 판단합니다. 뉴욕에 있는 독자라면 이 기본값이 우연히 맞습니다. 그 밖의 지역에서는 오전 8시
리포트가 엉뚱한 시각에 실행됩니다. 워크플로 설정에서 워크플로별 시간대를 지정할 수도 있습니다. 저희는 두 곳 모두 Asia/Singapore로 설정했습니다.
파일 설정 줄도 중요합니다. n8n 2.0부터 Read/Write Files 노드는 기본적으로 ~/.n8n-files만 사용할 수 있습니다. 다른 위치에 리포트를 쓰려면 N8N_RESTRICT_FILE_ACCESS_TO로 해당 폴더를 허용해야 합니다. 그 폴더 하나만 허용하세요.
미국 독자: 11월 1일에 대비하세요
리포트를 미국 시간 기준으로 실행한다면 날짜 하나를 기억해 두세요. NIST에 따르면 2026년 서머타임은 11월 1일 현지 시간 오전 2시에 끝나고, 오전 1시대가 한 번 더 반복됩니다. 오전 8시에 실행하는 일일 리포트는
America/New_York 기준으로 안전합니다. 전환 시각과 멀리 떨어져 있고, durable scheduler가 현지 시각을 그대로 유지하기 때문입니다. 오전 1시 30분 작업은 다릅니다. 11월 1일에는 그 시각이 두 번 오기 때문입니다.
다음 표는 NIST 규칙을 바탕으로 미국 주요 시간대의 11월 1일 변경 사항을 정리한 것입니다:
| IANA 시간대 | 2026년 11월 1일 이전 | 2026년 11월 1일 이후 | 안전한 일일 리포트 시각 |
|---|---|---|---|
America/New_York | UTC−4 | UTC−5 | 오전 1:00~2:59를 제외한 모든 시간 |
America/Chicago | UTC−5 | UTC−6 | 오전 1:00~2:59를 제외한 모든 시간 |
America/Los_Angeles | UTC−7 | UTC−8 | 오전 1:00~2:59를 제외한 모든 시간 |
America/Phoenix | UTC−7 | UTC−7(서머타임 없음) | 모든 시간 |
Pacific/Honolulu | UTC−10 | UTC−10(서머타임 없음) | 모든 시간 |
durable scheduler 문서에 따르면 시간·일·주·월 단위 스케줄은 “일상적인 사용에서는” 이전과 똑같이 실행됩니다. 또한 durable scheduler는 서머타임 전환, 윤년, 53번째 주를 인메모리 스케줄러보다 더 정확하게 처리하며, 인메모리 스케줄러는 “한 주기만큼 어긋날 수 있었다”고 설명합니다. 실제 시간 변경은 다음 주에야 일어나기 때문에 테스트하지 않았습니다. 권장 사항은 간단합니다. 일일 리포트는 현지 시간 오전 1시부터
오전 3시 사이에 예약하지 마세요. 워크플로 시간대는 고정 오프셋이 아니라 America/Chicago 같은 실제 IANA 이름으로 설정하세요. 이 이름과 규칙은 IANA 시간대 데이터베이스에서 관리됩니다.
워크플로 구성: 노드 6개, 단계마다 액션 하나
워크플로는 6개의 노드로 구성됩니다. 아래 애니메이션은 한 번의 실행 과정을 보여 줍니다.


이 워크플로는 에디터에서 클릭해 만들지 않았습니다. JSON으로 작성한 뒤 n8n 명령줄로 가져왔습니다. 이렇게 하면 두 가지 이점이 있습니다. 모든 단계를 그대로 재현할 수 있고, 로컬 n8n에 소유자 계정이 없어도 됩니다. 각 단계마다 수행할 작업, 확인해야 할 결과, 그 이유를 함께 설명합니다.
- API 키를 n8n 자격 증명으로 저장합니다.
jq -n --arg t "$EVERYINFRA_API_KEY" '[{"id":"eiBearer000001","name":"EveryInfra API Key","type":"httpBearerAuth","data":{"token":$t}}]' | n8n import:credentials --input=/dev/stdin을 실행합니다. "Successfully imported 1 credential"이 표시되어야 합니다.
핵심은 --input=/dev/stdin입니다. 키는 환경 변수와 파이프로만 전달되며 파일에는 전혀 기록되지 않습니다. data 필드가 평문이면 가져오기 명령이 행을 쓰기 전에 인스턴스 키로 암호화합니다(소스 코드에서는 cipher.encryptV2). HTTP Request 노드의 헤더 필드에 키를 직접 입력하지 마십시오.
그렇게 하면 키가 워크플로 JSON, 모든 내보내기 파일, 버전 기록에 평문으로 남습니다. HTTP Request 자격 증명 페이지에는 Bearer, Header 등 여러 유형이 나와 있습니다. Bearer를 사용하십시오. RFC 6750의 Authorization: Bearer 헤더를 보내며, 이는 EveryInfra가 요구하는 형식입니다.
- Schedule Trigger를 추가합니다. 테스트에서는 "3분마다"로 설정합니다. 매일 사용할 때는 "Days", 오전 8시, 0분으로 설정합니다. 게시하면 SQLite 테이블
scheduled_job에intervalSeconds180,misfirePolicyskip,misfireGraceSeconds60인 새 행이 생깁니다.
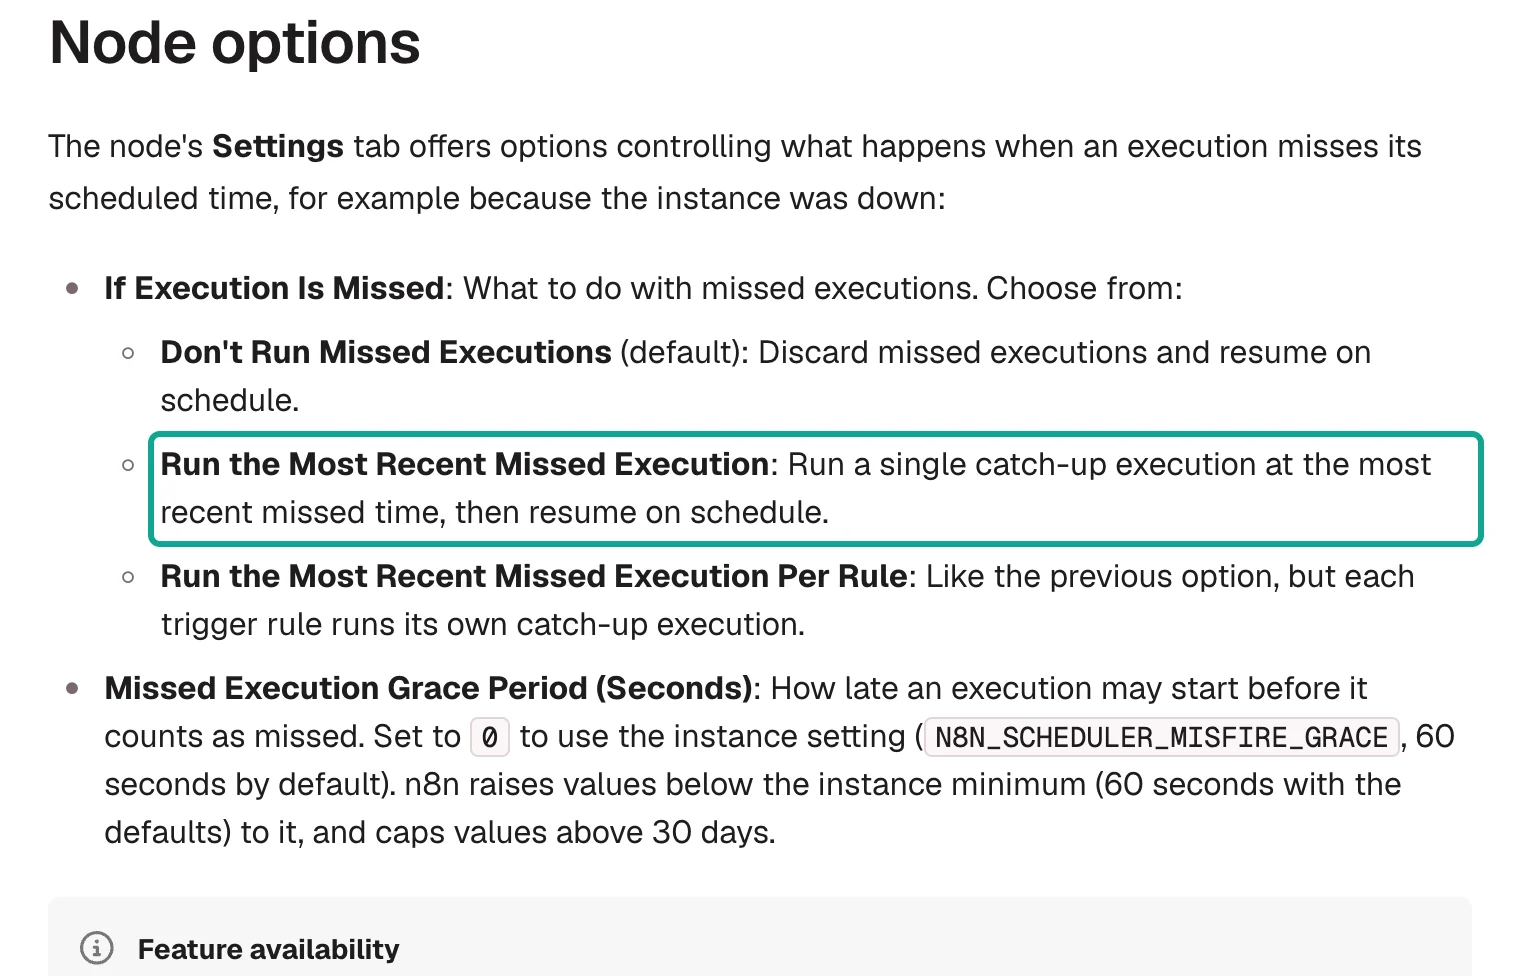
Schedule Trigger 페이지에는 새 노드 설정이 두 가지 있습니다. "If Execution Is Missed"에는 세 가지 선택지가 있으며 기본값은 건너뛰기입니다. "Missed Execution Grace Period (Seconds)"를 0으로 두면 인스턴스 값 N8N_SCHEDULER_MISFIRE_GRACE(기본 60초)를 사용합니다. 두 설정 모두 2.36 이상에서 추가한 노드에만, 그리고 durable 스케줄러가 켜져 있을 때만 적용됩니다. 저장되는 값은 노드 소스를 읽어 확인했습니다. coalesce_owner는 "Run the Most Recent Missed Execution", coalesce는 같은 동작을 규칙별로 수행하며, skip이 기본값입니다.
- Code 노드에서 요청 목록을 만들고 요청마다 키를 하나씩 붙입니다. 노드는 항목 5개를 반환합니다. 각 항목에는 플랫폼, 액션, 파라미터,
idem필드가 있습니다. 실행 데이터에 출력 항목 5개가 표시되어야 합니다.
const now = DateTime.now().setZone('Asia/Singapore');
// Daily use: one key per day (a rerun on the same day is a replay). Test: one key per minute.
const KEY_BY = 'day';
const keyBase = KEY_BY === 'day' ? now.toFormat('yyyyLLdd') : now.toFormat('yyyyLLdd-HHmm');
const reqs = [
  { label: 'Weibo hot search', platform: 'weibo', action: 'trending', params: {} },
  { label: 'Douyin hot list', platform: 'douyin', action: 'trending', params: { boards: 'hotspot' } },
  { label: 'X US trends', platform: 'twitter', action: 'trending', params: { country: 'us' } },
  { label: 'X Mexico trends', platform: 'twitter', action: 'trending', params: { country: 'mx' } },
  { label: 'Misspelled list name', platform: 'douyin', action: 'trending', params: { boards: 'hot' } },
];
return reqs.map(r => ({ json: { ...r,
  idem: `daily-report-${keyBase}-${r.platform}-${r.params.country || r.params.boards || 'default'}`,
  firedAt: now.toISO() } }));
실제로 실행한 코드 그대로입니다. 저희 팀은 리포트를 중국어로 읽기 때문에 레이블이 중국어로 되어 있으며, 레이블 문자열은 자유롭게 바꿔도 됩니다.
키를 직접 만드는 이유는 무엇일까요? 일일 리포트는 같은 날 두 번 실행되거나, 두 번 과금되거나, 서로 다른 파일 두 개를 만들어서는 안 됩니다. EveryInfra OpenAPI 명세에 따르면, 24시간 안에 같은 Idempotency-Key, 플랫폼, 액션, 파라미터로 보낸 동기 호출은 "첫 번째 성공 응답을 재생"합니다. 호출이 다시 실행되지 않고 다시 과금되지도 않습니다. 같은 키에 다른 파라미터를 보내면 409 idempotency_conflict가 반환됩니다.
날짜로 만든 키는 API에 "오늘 목록은 한 부만"이라고 알려 줍니다. 이 패턴은 IETF Idempotency-Key 헤더 초안과 같으며, 이 초안은 2026년 10월 22일 버전 08로 갱신되었습니다. 테스트에서는 KEY_BY를 minute으로 설정했습니다. 하루에 키를 하나만 사용하면 첫 실행 이후 3분 간격의 테스트 실행이 모두 재생 처리되어 목록이 어떻게 바뀌는지 볼 수 없기 때문입니다.
- HTTP Request 노드로 EveryInfra를 호출합니다. 메서드는 POST로, URL은
https://api.everyinfra.com/api/v1/social로 설정합니다. 1단계의 Bearer 자격 증명을 선택합니다.Idempotency-Key: {{ $json.idem }}헤더를 추가합니다. JSON 요청 본문으로{{ JSON.stringify({ platform: $json.platform, action: $json.action, params: $json.params }) }}를 보냅니다. "Include Response Headers and Status"와 "Never Error"를 켭니다. 배치는 배치당 항목 1개, 배치 간격 1,500 ms로 설정합니다. 실행마다 항목 5개가 나와야 하며, 4개는statusCode200, 1개는 422입니다.
"Never Error"는 이 단계에서 가장 중요한 스위치입니다. HTTP Request 페이지에 따르면 기본적으로 2xx가 아닌 응답이 오면 노드가 실패합니다. 실행은 거기서 멈추고 리포트 노드는 실행되지 않습니다. 일일 리포트에는 그 반대가 필요합니다. 목록 하나가 실패해도 나머지 목록은 리포트에 들어가고, 실패한 목록에는 명확한 메모가 남아야 합니다.
"Never Error"와 전체 응답 옵션을 켜면 422 본문과 상태 코드가 일반 데이터로 다음 노드에 전달됩니다. 배치 간격을 두면 키당 분당 10회라는 EveryInfra 제한을 넘지 않습니다. GET /api/v1/account는 이 값을 key_requests_per_minute로 반환합니다. 호출 간격을 1.5초로 두었을 때 한 번 실행에 약 13~16초가 걸렸습니다.
- 두 번째 Code 노드에서 리포트를 작성하고 지난 실행을 기억합니다. 이 노드는 응답 5개를 3단계의 요청 5개와 순서대로 짝짓습니다. 각 목록에서
rank기준 상위 10개를 가져오고, 순위가 없는 프로모션 행은 건너뜁니다(아래 코드 참고).$getWorkflowStaticData('global')에서 지난 상위 10개를 읽어 중복 수를 세고 새 목록을 저장합니다.markdown과fileName이 있는 항목 1개가 표시되어야 합니다.
상위 10개 단계는 따로 신경 써서 정확히 구현해야 합니다. Weibo 인기 검색어 응답에는 프로모션 슬롯이 섞여 있습니다. 제목과 인기 값은 있지만 rank가 없습니다. 14회 실행 동안 Weibo 상위 10개 위치에 프로모션 슬롯이 총 16번 들어갔고, Douyin과 X에는 한 번도 없었습니다. 위치로 번호를 매기면 광고가 인기 주제가 되고 그 뒤 순위가 모두 하나씩 밀립니다. 두 번째 Code 노드에 다음 규칙을 넣으십시오. 목록의 행 중 하나라도 rank가 있으면 rank가 있는 행만 남기고 그 값으로 정렬합니다. 어떤 행에도 순위가 없을 때만 위치를 기준으로 삼습니다.
function top10(results) {
  const rows = results || [];
  const hasRank = rows.some(x => x.rank != null);
  const kept = hasRank ? rows.filter(x => x.rank != null).sort((a, b) => a.rank - b.rank) : rows;
  return {
    top: kept.slice(0, 10).map((x, i) => ({ rank: x.rank ?? i + 1, title: x.title || x.keyword || x.name })),
    promoted: rows.length - kept.length,   // goes into the heading: "N promoted rows skipped"
  };
}
아래는 14회 실행에서 나타난 프로모션 슬롯 7개입니다. 이 슬롯은 4위와 8위, 두 위치에만 있었습니다. 제목이 일반 인기 주제처럼 보이기 때문에 비어 있는 rank만이 단서입니다. 마지막 항목인 "여러 아이크림, 허위 광고 의혹"은 뉴스처럼 보이지만 역시 rank가 없으므로 이것도 건너뜁니다. 이런 행을 유지하려면 별도 규칙이 필요합니다.
| 프로모션 슬롯 제목 | 등장 횟수 | 위치 | 시각(SGT) |
|---|---|---|---|
| ROSÉ, 조니워커 블랙 라벨 글로벌 앰배서더로 선정 | 5 | 4th | 10:42–11:18 |
| 살림하는 분들, 모두 와서 써 보세요 | 3 | 4th | 11:03–11:15 |
| Lynk & Co는 어떻게 7년 만에 16개 타이틀을 차지했나 | 3 | 8th | 11:06–11:15 |
| 류하오춘, Anta 글로벌 브랜드 앰배서더로 선정 | 2 | 4th | 10:39–11:00 |
| Mikimoto와 디리러바: 진주 3부작 | 1 | 8th | 10:39 |
| 러우이샤오와 함께 JD에서 패션·뷰티 50% 할인 쇼핑 | 1 | 4th | 11:21 |
| 여러 아이크림, 허위 광고 의혹 | 1 | 8th | 11:21 |
정적 데이터(static data)는 n8n에서 실행 간에 값을 기억하는 가장 가벼운 방법입니다. n8n 문서에는 두 가지 제한이 나와 있습니다. 수동 테스트 실행에서는 저장되지 않고, 게시된 워크플로가 트리거로 실행될 때만 저장됩니다. 또한 실행 빈도가 높으면 신뢰하기 어려울 수 있습니다. 그래서 수동 실행에서는 "지난 실행과의 중복"이 항상 비어 있습니다.
정상적인 동작입니다. 반드시 보관해야 하는 데이터는 데이터 테이블에 저장할 것을 문서에서는 권장합니다.
이 노드는 비용도 두 가지 방식으로 계산합니다. "응답 합계"는 모든 호출의 billing.charged_usd를 더합니다. "실제 청구액"은 replayed가 true인 호출을 제외합니다. 두 숫자가 모두 필요한 이유는 테스트 3에서 보여 드립니다.
- 파일로 변환해 디스크에 씁니다. Convert to File에서
markdown필드에 "Convert to Text File"을 적용합니다. 그런 다음 Read/Write Files 노드로reports/폴더에 파일을 씁니다. 실행할 때마다 새report-<time>.md파일이 하나씩 생겨야 합니다.
이 단계에서 경로에 쓸 수 없다거나 허용되지 않는다는 오류가 나면 먼저 N8N_RESTRICT_FILE_ACCESS_TO를 확인하십시오. 경로는 이 변수가 허용하는 폴더 안에 있어야 합니다.
- 게시한 다음 n8n을 재시작합니다.
n8n import:workflow --input=A.json,n8n publish:workflow --id=eiDailyReport01,n8n start를 차례로 실행합니다. 시작 로그에 "Scheduler started"와 "Processed 0 draft workflows, 2 published workflows"가 표시되어야 합니다.
명령줄 게시에는 놓치기 쉬운 점이 하나 있습니다. publish:workflow는 데이터베이스에 직접 씁니다. 명령 자체도 "Changes will not take effect if n8n is running"이라고 출력합니다. 실행 중인 n8n은 재시작해야 변경 사항을 인식합니다. 이 점이 테스트 1의 결과를 좌우합니다.
테스트 1: 제시간에 실행될까, "N분마다"는 언제부터 셀까?
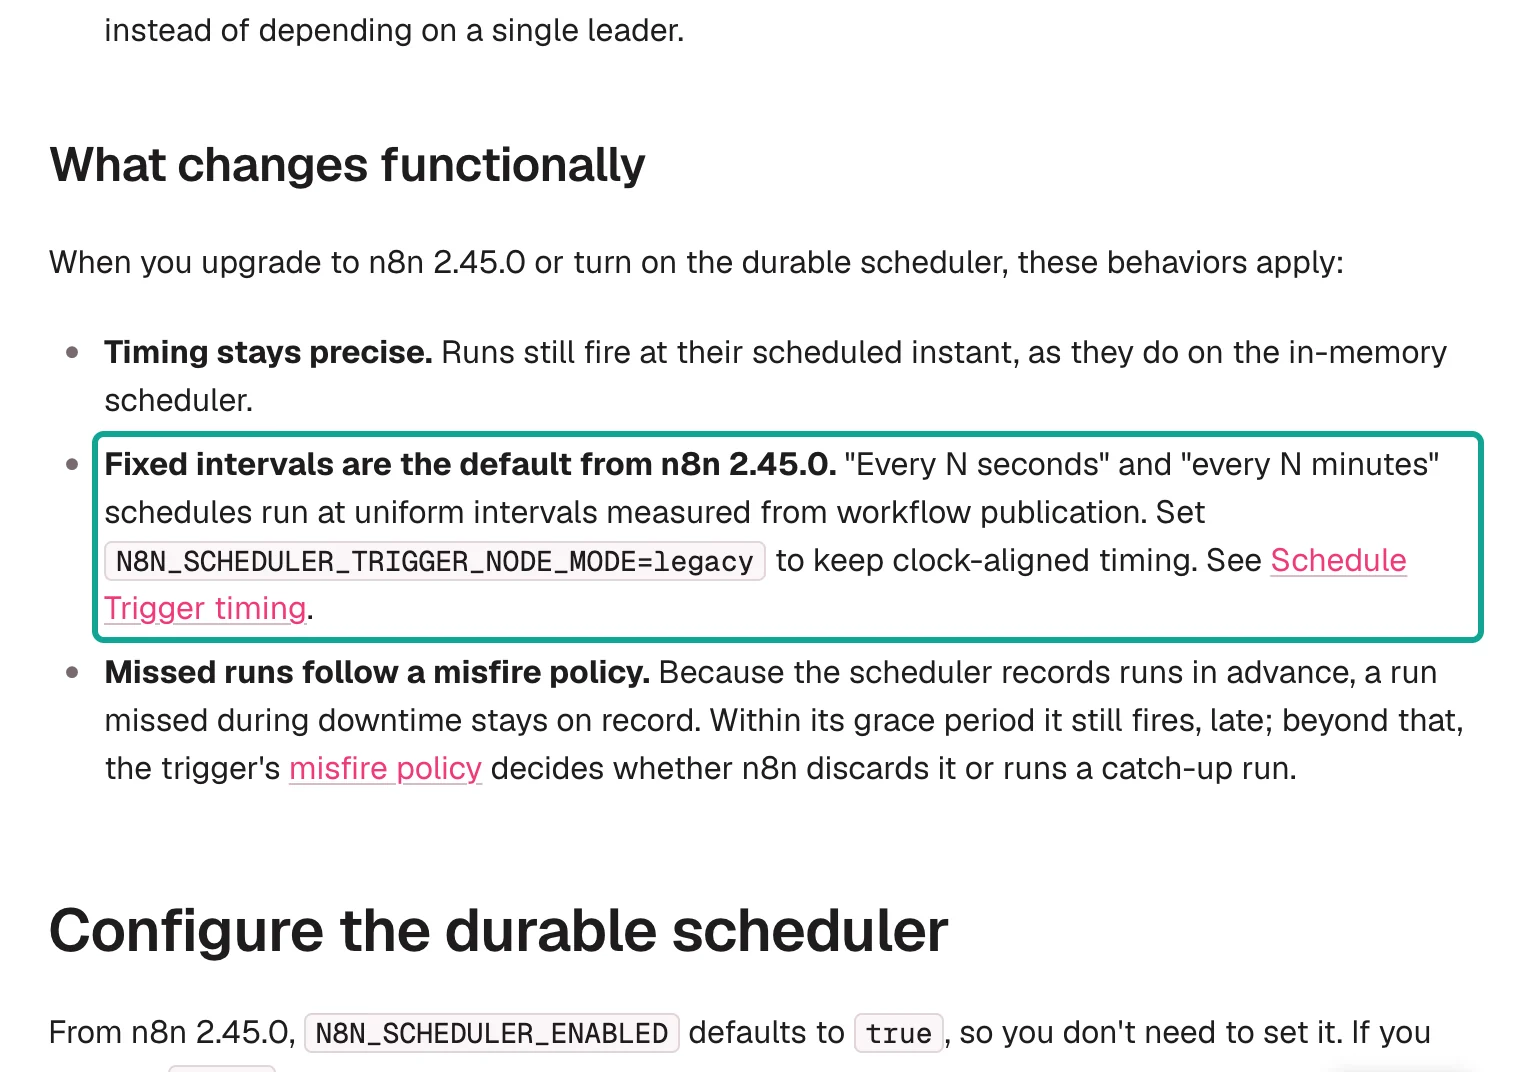
n8n 2.45에서는 "N분마다"의 의미가 바뀝니다. durable 스케줄러 페이지에 따르면 이 스케줄은 "워크플로 게시 시점부터 측정한 균일한 간격으로 실행"됩니다. 더 이상 매분 0초에 맞춰 실행되지 않습니다. 실행 시각을 계속 매분 0초에 맞추려면 N8N_SCHEDULER_TRIGGER_NODE_MODE=legacy를 설정합니다. 아래는 원문이며, 해당 규칙은 청록색 상자로 표시했습니다.
그렇다면 "게시"는 어느 시점일까요? 두 워크플로는 명령줄에서 10:32:59와 10:33:01 SGT에 게시했습니다. n8n은 10:36:20에 시작해 10:36:24에 워크플로를 활성화했습니다. 답은 SQLite 테이블 scheduled_job에 있습니다. 두 행의 createdAt은 10:36:24.207과 10:36:24.209이고, 첫 nextRunAt은 10:39:24.206입니다.
카운트는 명령이 데이터베이스에 쓸 때가 아니라 실행 중인 n8n이 워크플로를 활성화할 때 시작됩니다. 에디터에서는 워크플로를 게시하는 클릭 한 번으로 두 시점이 일치합니다. 명령줄에서는 두 시점 사이에 3분 25초 차이가 났습니다.
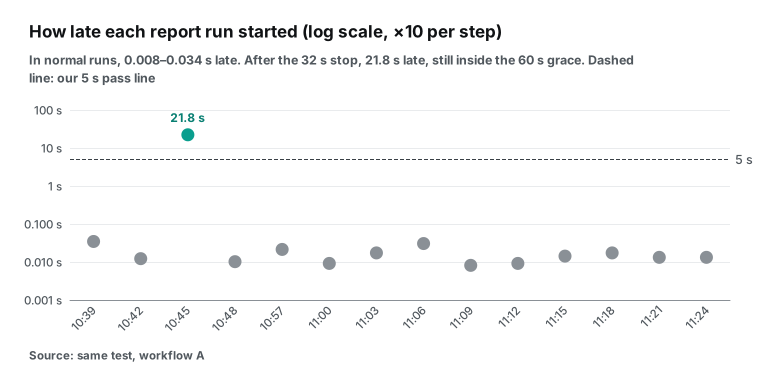
이후 14회 실행은 모두 같은 위상, 즉 3분 단위 기준점에서 24.206초 지난 시점에 실행되었습니다(10:39:24부터 11:24:24까지). 정상 실행에서는 예정 시각보다 0.008~0.034초 뒤에 실행이 시작되었습니다. 미리 정한 합격선 5초보다 훨씬 짧습니다. 중지가 없었을 때 두 실행 사이 간격은 179.978~180.013초였습니다.
테스트 중에 n8n을 두 번 재시작했지만 위상은 바뀌지 않았습니다. 재시작할 때마다 scheduled_job 행이 그대로 남아 있었고 nextRunAt은 기존 위상을 이어 갔습니다. 재시작으로 카운트가 새로 시작되지 않았습니다. 기존 인메모리 스케줄러와 가장 분명하게 다른 점입니다.
아래 표는 예정 시각 16개를 하나씩 보여 줍니다. 모든 값은 SQLite와 실행 데이터에서 가져왔으며 분석 스크립트 analysis.py로 계산했습니다. 시각은 SGT입니다.
| 예정 | 시작 | 지연(초) | 과금된 호출 | 과금액 | 행 수: Weibo / Douyin / X 미국 / X 멕시코 |
|---|---|---|---|---|---|
| 10:39:24.206 | 10:39:24.240 | 0.034 | 4 | $0.002224 | 10 / 8 / 52 / 71 |
| 10:42:24.206 | 10:42:24.218 | 0.012 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 10:45:24.206 | 10:45:46.037 | 21.831 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:48:24.206 | 10:48:24.216 | 0.010 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:51:24.206 | 실행 안 됨(중지, 기본값: 건너뛰기) | — | 0 | $0 | — |
| 10:54:24.206 | 실행 안 됨(중지, 기본값: 건너뛰기) | — | 0 | $0 | — |
| 10:57:24.206 | 10:57:24.227 | 0.021 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:00:24.206 | 11:00:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:03:24.206 | 11:03:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:06:24.206 | 11:06:24.236 | 0.030 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 11:09:24.206 | 11:09:24.214 | 0.008 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:12:24.206 | 11:12:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:15:24.206 | 11:15:24.220 | 0.014 | 4 | $0.002224 | 15 / 20 / 50 / 72 |
| 11:18:24.206 | 11:18:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:21:24.206 | 11:21:24.219 | 0.013 | 4 | $0.002224 | 19 / 20 / 50 / 72 |
| 11:24:24.206 | 11:24:24.219 | 0.013 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
마지막 열은 스케줄링과 무관한 점 하나를 보여 줍니다. 첫 실행에서 Weibo는 10행, Douyin은 8행만 반환했습니다. 그 이후로는 둘 다 대부분 20행을 반환했으며, 이는 카탈로그에 있는 두 기능의 default_limit입니다. 이것이 비용에 어떤 의미인지는 테스트 3에서 설명합니다.
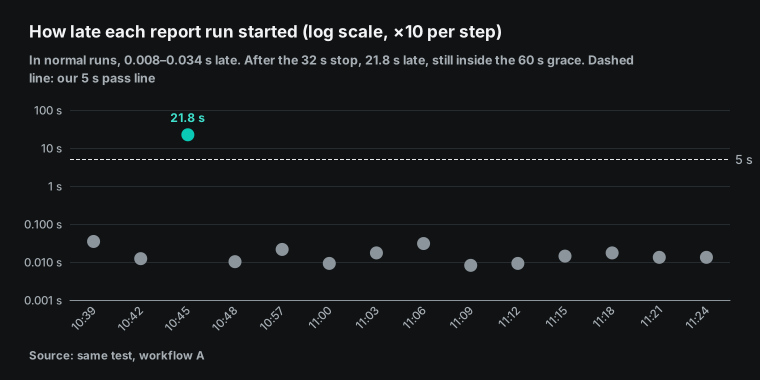
일일 리포트에는 어떤 의미일까요? 정확히 8:00에 리포트를 받으려면 "Days" 간격에 오전 8시, 0분을 설정하십시오. 문서에 따르면 시간·일·주·월 단위 스케줄은 일상적인 사용에서 두 모드 모두 동일하게 동작합니다. 바뀌는 것은 "N분마다"와 "N초마다"뿐입니다.
"30분마다" 설정으로 :00과 :30에 실행해 왔다면, 2.45부터는 게시를 클릭한 정확한 시점을 기준으로 30분 간격으로 실행됩니다. 기존처럼 :00과 :30에 맞추려면 0 */30 * * * * 같은 cron 표현식을 사용하십시오. 문서에 따르면 cron은 이 설정의 영향을 받지 않습니다. legacy로 설정할 수도 있지만, 문서에서는 legacy를 지원 중단 대상으로 표시하고 있으며 향후 버전에서 제거될 예정입니다.
테스트 2: n8n이 다운되면 예정된 실행은 어떻게 될까?
2.45에서 가장 큰 변화이며, 저희가 가장 많은 시간을 들인 부분입니다. 기존 인메모리 스케줄러는 다음 실행을 프로세스 안에 보관합니다. 문서는 "재시작하면 대기 중인 실행이 사라집니다"라고 분명히 말합니다. 다운타임 중에 예정된 실행은 건너뜁니다. durable 스케줄러는 각 실행을 먼저 데이터베이스에 기록하므로, 놓친 실행도 "기록에 남습니다". 유예 기간 안에 n8n이 복구되면 실행이 늦게 시작됩니다. 유예 기간을 넘기면 misfire 정책에 따라 결정됩니다.
같은 다운타임에서 두 정책을 비교하기 위해 워크플로 두 개를 게시했습니다. 워크플로 A는 리포트로, 기본값인 "Don't Run Missed Executions"를 사용합니다. 워크플로 B는 하트비트입니다. API를 호출하지 않고 시각만 파일에 쓰므로 비용이 들지 않습니다. B는 "Run the Most Recent Missed Execution"을 사용합니다.
둘 다 같은 위상으로 3분마다 실행됩니다. 스크립트가 프로세스 ID로 n8n에 SIGTERM을 보내 중지하고, 프로세스가 종료될 때까지 기다린 뒤, 정해진 시각에 다시 시작했습니다. 스크립트는 모든 시각을 기록했습니다.
| 다운타임(싱가포르 시간) | 포함된 예정 시각 | 워크플로 A(건너뛰기) | 워크플로 B(가장 최근 누락 실행) |
|---|---|---|---|
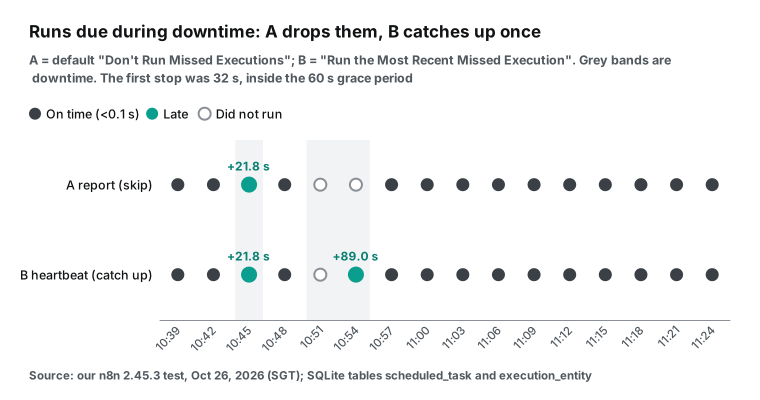
| 10:45:12 → 10:45:40, 10:45:44에 준비 완료 | 10:45:24 | 10:45:46.0에 실행, 21.8초 지연 | 10:45:46.0에 실행, 21.8초 지연 |
| 10:49:00 → 10:55:40, 10:55:44에 준비 완료 | 10:51:24, 10:54:24 | 둘 다 실행 안 됨 | 10:55:53에 따라잡기 실행 1회, 89.0초 지연 |
첫 번째 중지: 32초, 유예 기간 이내. 10:45:12 SGT에 n8n을 중지하고 10:45:40에 시작했으며, 10:45:44에 준비가 완료되었습니다. 예정 시각인 10:45:24는 중지 구간에 포함되었습니다. 이 실행은 중지 전에 이미 scheduled_task 테이블에 들어가 있었습니다. 구체화 윈도(materialization window)인 N8N_SCHEDULER_MATERIALIZATION_WINDOW의 기본값은 60초이므로 각 실행에 대한 행은 약 1분 전에 생성됩니다. 재시작 후 A와 B 모두 10:45:46.0에 시작했으며, 예정 시각보다 21.8초 늦었지만 60초 유예 기간 이내였습니다.
한 가지 세부 사항이 있습니다. 중지 전 두 행의 missedAfter는 예정 시각에 60초를 더한 10:46:24.206이었습니다. 재시작 후 n8n은 이를 10:46:45.677로 바꿨습니다. 재시작 후 실행 시작 시각을 기준으로 새 유예 기간이 부여된 것으로 보입니다. 한 번만 관찰했으며 이 규칙을 더 테스트하지는 않았습니다.
두 번째 중지: 6분 44초, 예정 시각 두 개에 걸침. 10:49:00 SGT에 n8n을 중지하고 10:55:40에 시작했으며, 10:55:44에 준비가 완료되었습니다. 예정 시각인 10:51:24와 10:54:24는 모두 중지 구간에 포함되었고, n8n이 복구되었을 때 둘 다 60초 유예 기간이 지난 상태였습니다. 결과는 문서와 일치했습니다.
A는 두 시각 모두 실행되지 않았고 다음 실행은 10:57:24였습니다. B는 10:55:53에 한 번 실행되었습니다. 이 실행은 가장 최근 예정 시각인 10:54:24에 해당하며 89.0초 늦었습니다. B는 10:51:24에 대한 별도 따라잡기 실행은 하지 않았습니다.
실행 데이터만으로는 부족합니다. 누락된 실행은 아예 기록에 없기 때문입니다. 그래서 n8n Prometheus 메트릭을 켜고 두 번째 재시작 후인 10:56:30 SGT에 /metrics를 한 번 읽었습니다. 카운터는 프로세스가 시작될 때 0부터 시작하므로 두 번째 중지만 보여 줍니다.
| 메트릭 | 값 | 의미 |
|---|---|---|
n8n_scheduler_occurrences_misfired_total{policy="skip"} | 2 | A가 10:51:24와 10:54:24 실행을 건너뜀 |
n8n_scheduler_occurrences_misfired_total{policy="coalesce_owner"} | 1 | B가 10:51:24를 따라잡기 실행에 합침 |
n8n_scheduler_occurrences_materialized_total | 1 | B의 따라잡기 실행이 큐에 들어감 |
n8n_scheduler_tasks_dispatched_total | 1 | 실행 1건이 디스패치됨 |
n8n_scheduler_tasks_completed_total{result="success"} | 1 | 따라잡기 실행 성공 |
n8n_scheduler_tasks_reclaimed_total | 0 | 중간에 끊긴 실행을 회수한 경우 없음 |
리포트 실행 간격을 보면 두 번의 중지가 명확히 드러납니다. 첫 번째 중지로 실행 하나가 21.8초 늦어져 그 전후 간격이 201.8초와 158.2초가 되었습니다. 합하면 여전히 360초이므로 위상은 바뀌지 않았습니다. 두 번째 중지로 실행 두 건이 빠졌고, 그 간격은 정확히 세 주기인 540.0초였습니다.
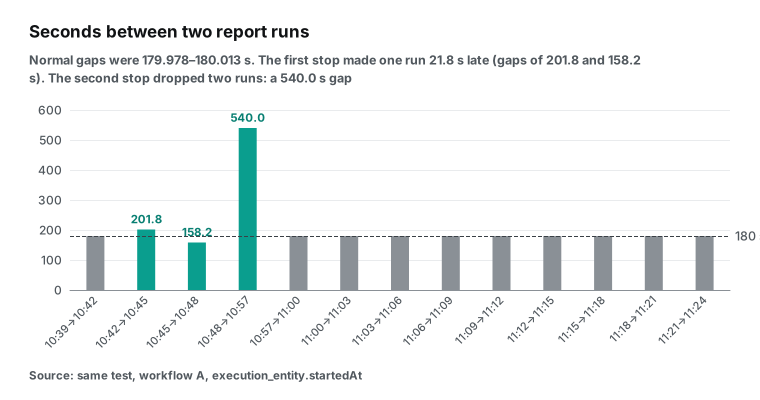
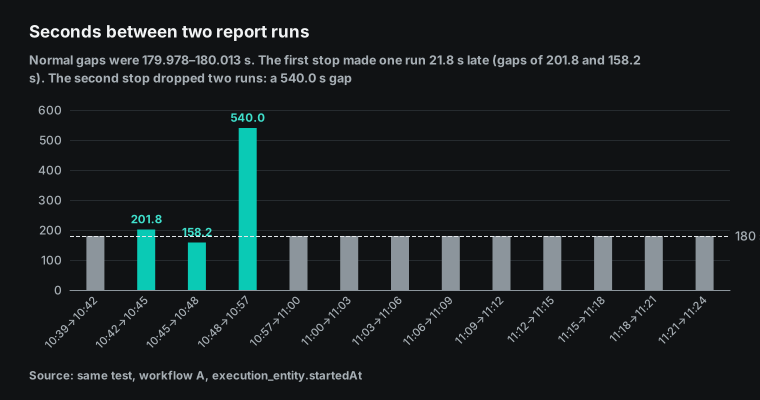
실행 데이터, scheduled_task 테이블, 메트릭이라는 세 출처가 같은 결과를 보여 줍니다. 그래서 J4를 통과로 표시했습니다. 각 카운터의 의미는 스케줄러 변수 페이지에 설명되어 있습니다. n8n은 바로 쓸 수 있는 Grafana 대시보드도 제공합니다. 다른 사람이 리포트를 읽는다면 occurrences_misfired_total에 알림을 설정하십시오. 이 값이 올라가면 하루치 리포트가 생성되지 않은 것입니다.
일일 리포트에는 어떤 정책이 맞을까요? 3단계의 날짜 기반 키와 함께 "Run the Most Recent Missed Execution"을 권장합니다. 일일 리포트는 하루에 한 부가 필요합니다. 중지 후에는 오늘 자 리포트를 받아야 합니다. n8n이 다음 날 복구되면 따라잡기 실행은 새 날짜와 새 키를 사용하므로 새 날짜의 리포트를 받게 됩니다. 기본 건너뛰기 정책은 1분마다 도는 하트비트처럼 늦으면 쓸모가 없는 작업에 적합합니다.
유예 기간은 재시작에 걸리는 시간을 기준으로 정하십시오. 문서에 따르면 유예 기간은 executor 간격보다 길어야 하고 구체화 윈도보다 짧아서는 안 되며, 기본값에서는 60초가 됩니다. 사용하는 머신에서 업그레이드 재시작에 3분이 걸린다면 노드 유예 기간을 300초로 설정하십시오.
테스트 3: 비용과 과금된 것처럼 보이는 리플레이
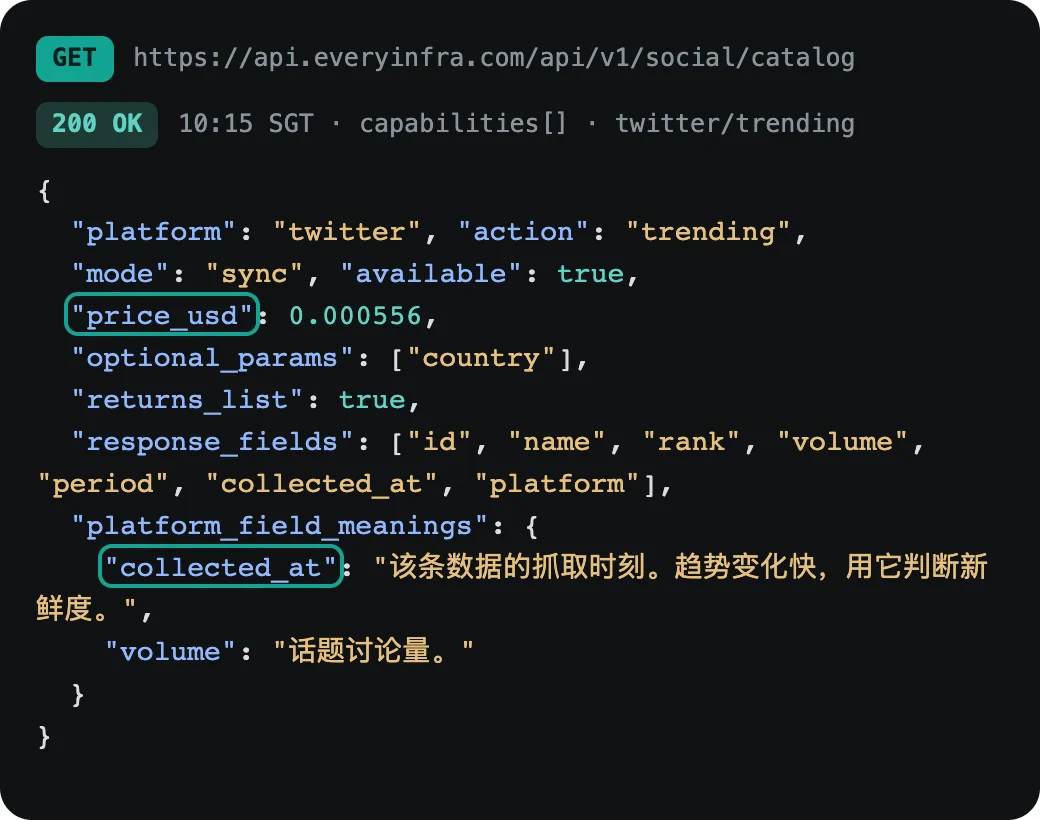
각 실행은 인기 급상승 기능 4개를 호출합니다. 미국과 멕시코용 twitter/trending, weibo/trending, douyin/trending입니다. 10:15 SGT에 조회한 EveryInfra 카탈로그에서 세 기능 모두 호출당 price_usd가 0.000556입니다. 따라서 실행당 비용은 4 × $0.000556 = $0.002224여야 합니다. 아래는 twitter/trending에 대한 실제 카탈로그 응답입니다. 청록색 상자는 가격과 collected_at의 의미를 표시합니다.
리플레이를 제외하면 14회 실행 모두 정확히 $0.002224가 들었습니다. 합계는 $0.031136이었습니다.
응답만 믿지는 않았습니다. 테스트 후 GET /portal/api/logs로 서버 호출 로그를 읽고 모든 request_id를 대조했습니다. 14회 실행의 과금 호출 56건이 모두 로그에 있었습니다. 각 호출의 cost는 40 크레딧, 즉 $0.000556으로 응답의 charged_usd와 소수점 6자리까지 같았습니다. 422를 반환한 호출 14건은 호출 로그에 아예 항목이 없었습니다. 즉 이 호출에는 과금되지 않았습니다.
함정은 리플레이입니다. 10:40:46 SGT에 10:39 실행의 Weibo 호출을 같은 키 daily-report-20261026-1039-weibo-default로 curl을 사용해 다시 보냈습니다.
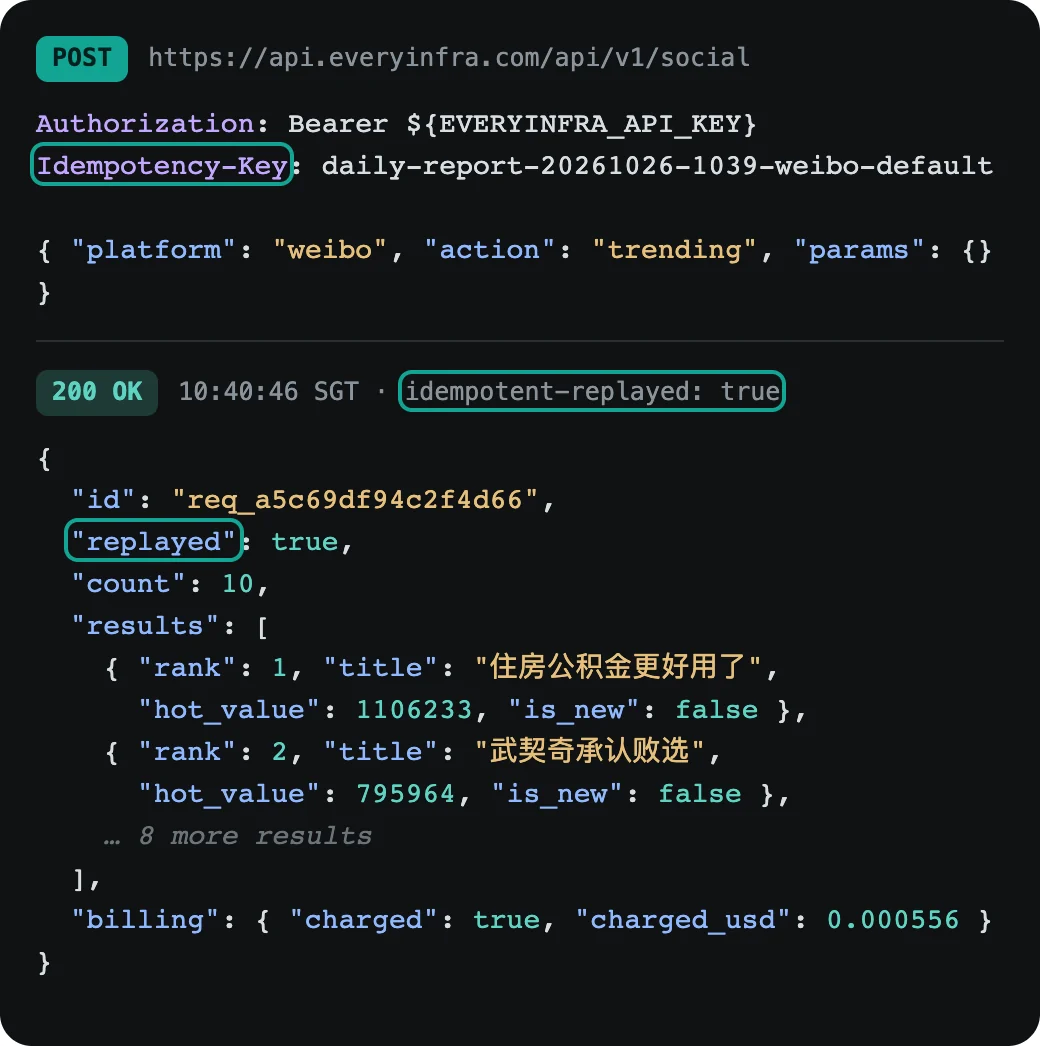
응답은 200이었고, idempotent-replayed: true 헤더와 본문의 replayed: true가 있었습니다. id는 첫 호출의 req_a5c69df94c2f4d66이었습니다. 새 요청은 x-request-id 헤더에 자체 ID인 req_7278432b29f64594를 받았습니다. 서버 로그에 두 번째 과금은 없었습니다. 그런데 billing 블록에는 여전히 "charged": true, "charged_usd": 0.000556이 표시되었습니다.
OpenAPI 명세가 그 이유를 설명합니다. 리플레이는 저장된 첫 응답을 반환하며, "동일한 billing을 반환하지만 다시 실행하거나 과금하지 않습니다". 즉 billing은 이번 호출이 아니라 첫 과금을 나타냅니다.
일일 리포트에서는 아래 차트처럼 나타납니다. KEY_BY를 day로 설정하고 n8n execute로 워크플로를 수동으로 두 번 실행했습니다. 실행 기록상 시작 시각은 10:56:46.565와 10:57:04.358 SGT입니다. 두 번째 실행에서는 호출 4건이 모두 리플레이였고 실제 청구액은 $0이었습니다. 대부분의 튜토리얼처럼 모든 charged_usd를 더하는 리포트라면 두 번째 실행을 $0.002224로 표시했을 것입니다.
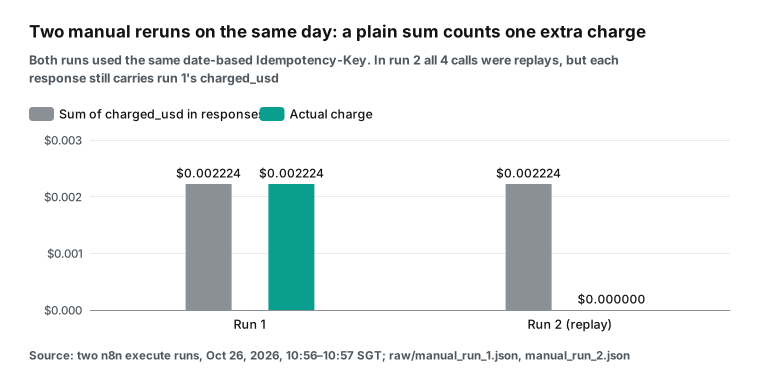
따라서 replayed가 true가 아닌 호출만 세십시오. 저희 리포트는 두 숫자를 모두 표시합니다. 두 숫자가 다르면 그날 재실행이 있었다는 뜻이므로 누가 왜 실행했는지 확인할 수 있습니다.
반대 경우도 테스트했습니다. 10:40:54 SGT에 같은 키에 다른 파라미터를 보냈습니다. API는 409 idempotency_conflict를 반환했고, next_steps에는 "send the new request with a new key. Nothing was charged."라고 나와 있었습니다. 따라서 날짜 기반 키에는 플랫폼과 파라미터도 포함되어야 합니다. 그렇지 않으면 같은 날의 서로 다른 목록 두 개가 서로를 막습니다. 3단계의 키에 플랫폼과 국가가 들어 있는 이유입니다.
실제 비용
전체 테스트의 청구 내역입니다. 모든 금액은 리플레이를 제외한 실제 청구액이며 서버 로그와 대조했습니다.
| 항목 | 호출 수 | 과금액 |
|---|---|---|
| 예약된 리포트 실행 14회, 회당 과금 호출 4건 | 56 | $0.031136 |
| 의도적으로 잘못 보낸 호출 14건(422) | 14 | $0 |
| 날짜 기반 키로 수동 실행 2회: 과금 호출 4건, 리플레이 4건, 잘못된 호출 2건 | 10 | $0.002224 |
| MCP 클라이언트 호출 1건 | 1 | $0.000556 |
| curl 리플레이 1건, 키 충돌 1건(409), 잘못된 보드 이름 단독 전송 1건(422), 키 없는 호출 1건(401) | 4 | $0 |
| EveryInfra 호출 합계 | 85 | $0.033916 |
직접 만드는 리포트의 비용은 스케줄에 따라 달라집니다.
| 스케줄 | 일일 과금 호출 수 | 일일 | 30일 |
|---|---|---|---|
| 하루 한 번 오전 8시, 목록 4개 | 4 | $0.002224 | $0.06672 |
| 하루 두 번, 오전 8시와 오후 8시 | 8 | $0.004448 | $0.13344 |
| 매시간 | 96 | $0.053376 | $1.60128 |
| 하루 한 번 + 따라잡기 1회 + 수동 재실행 1회(날짜 기반 키) | 과금 4건 + 리플레이 8건 | $0.002224 | $0.06672 |
모든 가격은 2026년 10월 26일 10:15 SGT에 조회한 카탈로그의 price_usd입니다. 마지막 행은 키의 가치를 보여 줍니다. 하루에 몇 번을 재실행하든 비용은 한 번만 냅니다.
놓치기 쉬운 사실이 하나 더 있습니다. 인기 급상승 목록은 행 단위가 아니라 호출 단위로 과금됩니다. 같은 $0.000556으로 X 멕시코 목록은 71행, Weibo와 Douyin 목록은 각각 20행을 반환했습니다(14회 실행의 중앙값). 1,000행당으로 환산하면 3.6배 차이입니다.
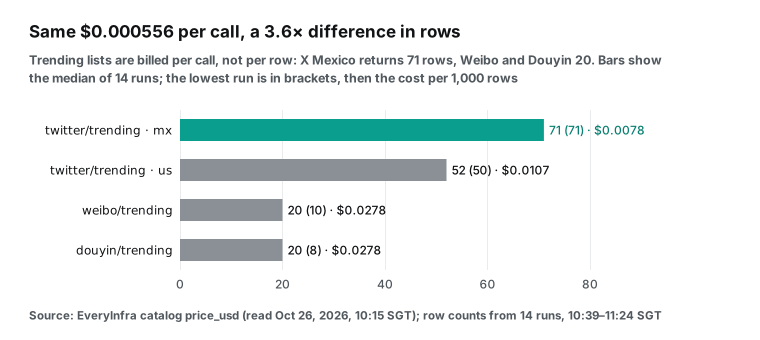
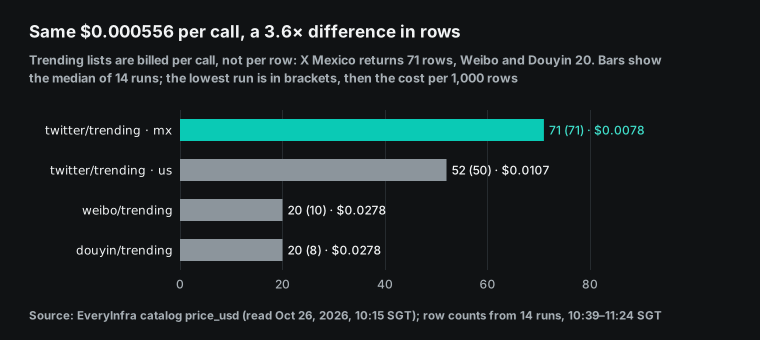
행 수는 호출마다 달라지기도 합니다. 10:39 SGT 첫 실행에서 Weibo는 10행, Douyin은 8행을 반환했습니다. 이후 13회 실행에서 Douyin은 항상 20행을, Weibo는 15~20행(대부분 20행)을 반환했습니다. 20은 카탈로그에 있는 두 기능의 default_limit이며, weibo/trending의 max_limit은 200입니다. Weibo 인기 검색어 규칙은 매분 갱신되는 Top 50 목록을 설명하고 있으므로, 기본값으로는 그중 일부만 받게 됩니다.
저희 리포트는 상위 10개만 쓰므로 첫 실행에서는 Douyin 항목 2개만 누락되었습니다. 전체 목록이 필요하다면 카탈로그에서 limit이 허용되는지 확인하십시오. 그다음 실제 호출 한 번으로 행 수를 확인하십시오. 각 실행의 행 수도 리포트에 기록하십시오.
기본값으로 추정하지 마십시오. 짧은 응답도 $0.000556이 들므로 행당 가격을 계산할 때 이를 반영하십시오.
테스트 4: 호출 하나가 잘못되어도 리포트는 도착한다
매 실행의 다섯 번째 호출은 Douyin boards 값을 hot으로 설정합니다. 올바른 값은 hotspot입니다. 14회 실행 모두에서 이 호출은 422를 반환했지만 리포트는 정상적으로 도착했고 나머지 4개 목록도 온전했습니다. 다음은 10:39 실행의 실제 응답입니다.
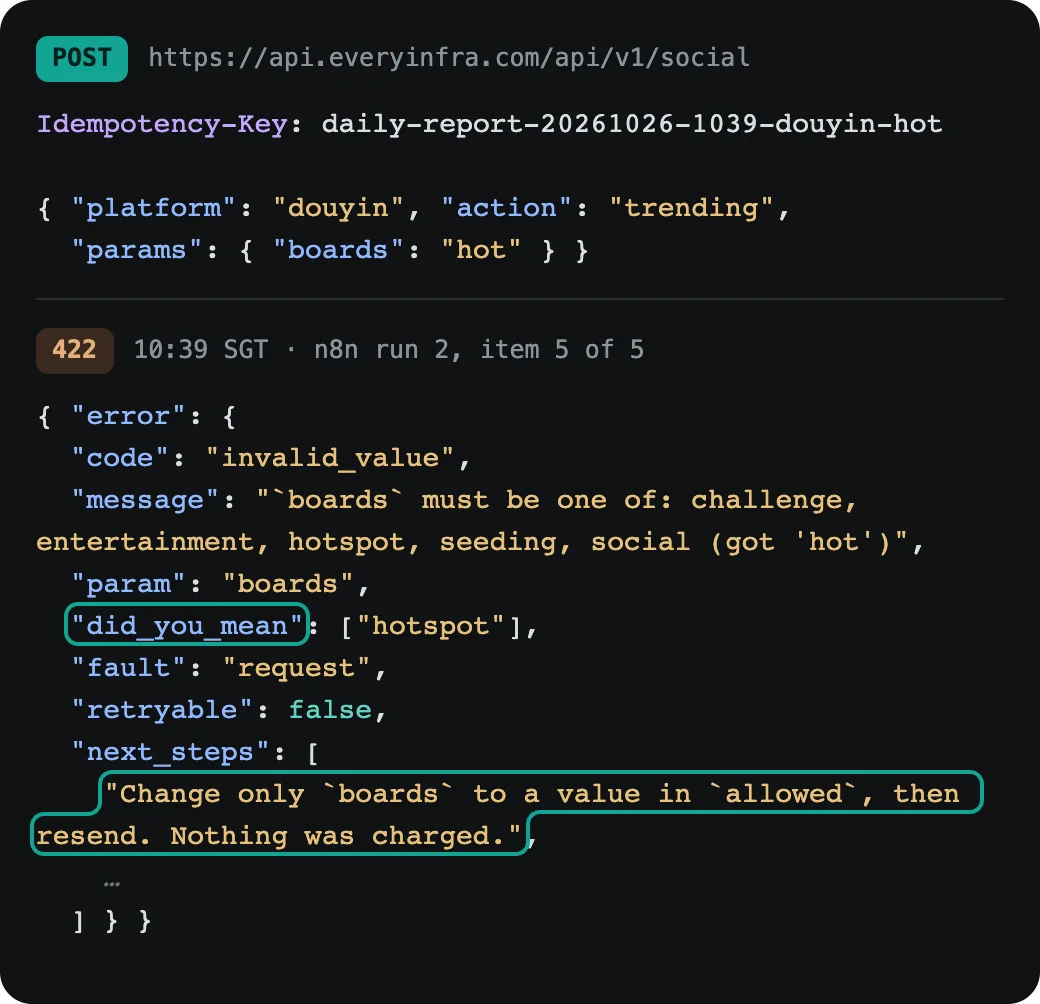
이 응답이 자동화에 적합한 이유는 무엇일까요? 프로그램이 읽을 수 있는 필드로 수정 방법을 알려 주기 때문입니다. allowed는 유효한 값을 나열합니다. did_you_mean은 가장 가까운 값을 제시합니다. retryable: false는 같은 요청이 다시 실패한다는 것을 알려 줍니다.
next_steps의 첫 줄에는 "Nothing was charged"라고 나와 있습니다. 저희 리포트 노드는 message와 did_you_mean을 리포트에 복사하므로, 읽는 사람은 값을 hotspot으로 바꿔야 한다는 것을 알 수 있습니다. 상태 코드 422는 RFC 9110의 "Unprocessable Content"로, 요청 형식은 올바르지만 내용을 처리할 수 없다는 뜻입니다. 같은 요청을 재시도해도 성공할 수 없습니다.
이 설계는 4단계의 "Never Error" 스위치 덕분에 작동합니다. 이 스위치가 없으면 n8n은 실행을 실패로 표시하고 오류 워크플로를 시작하며(오류 처리 페이지), 그날은 리포트가 없습니다. 사람들이 매일 읽는 파일이라면 목록 하나가 빠지는 편이 파일이 아예 없는 것보다 훨씬 낫습니다. 아래 표는 테스트에서 직접 발생시켰거나 OpenAPI 명세에서 확인한 응답과, 각 경우 리포트가 해야 할 일을 정리한 것입니다.
| 상황 | 상태 및 코드 | 과금액 | 리포트 처리 방식 |
|---|---|---|---|
| 키 없음 | 401 missing_key | 없음("Nothing was charged") | 실행 중지, 알림, 자격 증명 확인 |
| 허용되지 않는 값 | 422 invalid_value | 없음 | 사유와 did_you_mean을 기록하고 나머지 목록은 유지 |
| 같은 키, 다른 파라미터 | 409 idempotency_conflict | 없음 | 키 패턴 수정 |
| 같은 키, 첫 호출이 아직 실행 중 | Retry-After와 함께 409 idempotency_in_progress | 없음 | Retry-After만큼 기다린 후 다시 전송 |
| 같은 키로 다시 전송 | 200, replayed: true | 새 과금 없음, billing은 첫 과금 | 비용은 한 번만 계산 |
| 성공했지만 행 없음 | 200, count: 0 | 전액 환불 | "오늘은 이 목록이 비어 있습니다"라고 기록 |
| 환불 결과 불명 | 503 | 확인 필요 | 무작정 재시도하지 말고 먼저 호출 로그 확인 |
앞의 다섯 가지 경우는 직접 발생시켰습니다. 401은 10:18 SGT에 키 없이 보낸 호출에서 나왔으며 원본 응답을 보관하고 있습니다. 마지막 두 행은 OpenAPI 명세에서 가져온 것으로, 이번 테스트에서 직접 발생시키지는 않았습니다.
테스트 5: MCP Client 노드로 같은 기능 호출하기
n8n에는 MCP Client 노드도 있습니다. 어떤 MCP 서버의 도구든 일반 워크플로 단계처럼 사용할 수 있습니다. EveryInfra MCP 엔드포인트는 https://api.everyinfra.com/mcp입니다. 도구 목록 조회에는 키가 필요 없으며, 10:39 SGT에 도구 25개가 조회되었습니다. REST 호출 한 번과 동일한 파라미터로 everyinfra_call_api를 한 번 호출했습니다:
{
  "type": "@n8n/n8n-nodes-langchain.mcpClient",
  "typeVersion": 1.1,
  "parameters": {
    "endpointUrl": "https://api.everyinfra.com/mcp",
    "authentication": "bearerAuth",
    "tool": { "__rl": true, "mode": "id", "value": "everyinfra_call_api" },
    "inputMode": "json",
    "jsonInput": "{\"platform\":\"weibo\",\"action\":\"trending\",\"params\":{}}",
    "options": { "timeout": 90000 }
  },
  "credentials": { "httpBearerAuth": { "id": "eiBearer000001", "name": "EveryInfra API Key" } }
}
10:39:52 SGT에 n8n execute --id=eiMcpCheck0001로 실행했습니다. 노드 실행에 9.3초가 걸렸습니다. content[0].text는 최상위 필드 id, platform, action, results, count, billing, quota, async_hint가 있는 객체로 반환되었습니다. count는 10, 청구액은 $0.000556이었고, 서버 로그에도 호출이 기록되어 있었습니다(req_0e075488e27f44e6, 10:40:01). 각 결과에는 rank, title, hot_value, is_hot, is_new, label, url, platform이 있었으며, 같은 시각의 REST 응답과 필드가 같았습니다. 전송 방식은 기본값인 Streamable HTTP로, 2025-11-25 MCP 사양의 두 가지 표준 전송 방식 중 하나입니다.
| HTTP Request로 REST 호출 | MCP Client | |
|---|---|---|
| 요청 | POST /api/v1/social | everyinfra_call_api에 대한 tools/call |
| Weibo 행 수 | 첫 실행에서 10행 | 10 |
| 청구액 | $0.000556 | $0.000556 |
| 서버 측 로그 기록 | 있음, request_id 포함 | 있음, req_0e075488e27f44e6 |
Idempotency-Key 헤더 | 예 | 넣을 곳 없음 |
| 적합한 용도 | 고정된 예약 호출 | 무엇을 조회할지 모델이 고르는 경우 |
그렇다면 리포트에 MCP를 쓰지 않는 이유는 무엇일까요? 두 가지 이유가 있습니다. 첫째, HTTP Request 노드는 Idempotency-Key 헤더를 보낼 수 있지만 MCP Client 노드의 도구 인수에는 이를 넣을 곳이 없습니다. 키가 없으면 따라잡기 실행에서 같은 날 중복 과금을 막을 수 없습니다. 둘째, MCP는 모델이 도구를 고르고 인수를 구성할 때 가장 효과적입니다.
고정된 호출 5개로 이루어진 리포트에는 그럴 필요가 없습니다. MCP Client는 AI Agent 노드 뒤에서, 모델이 리포트를 읽고 특정 주제를 더 깊이 살펴볼지 결정하는 경우에 적합합니다. 이런 용도로 n8n에는 별도의 MCP Client Tool 노드가 있습니다.
명령줄에는 함정이 하나 더 있습니다. n8n 서비스가 실행 중일 때 n8n execute는 같은 포트에서 자체 태스크 브로커를 시작합니다. 해당 명령에만 N8N_RUNNERS_BROKER_PORT=5692를 설정하자 정상적으로 동작했습니다. Claude, Cursor 등 클라이언트에서 EveryInfra MCP를 설정하려면 원격 MCP 설정 가이드를 참고하세요. 자세한 내용은 MCP 서버 페이지에 있습니다.
45분 동안 목록은 얼마나 바뀌었나
하루 한 번 리포트로 충분할까요? 각 목록이 얼마나 빨리 바뀌는지에 달려 있습니다. 측정 시간은 10:39부터 11:24 SGT까지 45분뿐이므로, 이 결과는 "하루 안"이 아니라 "한 시간 안"에 대한 답입니다. 모든 숫자는 분석 스크립트 analysis.py가 14개의 실행 기록에서 계산했습니다.
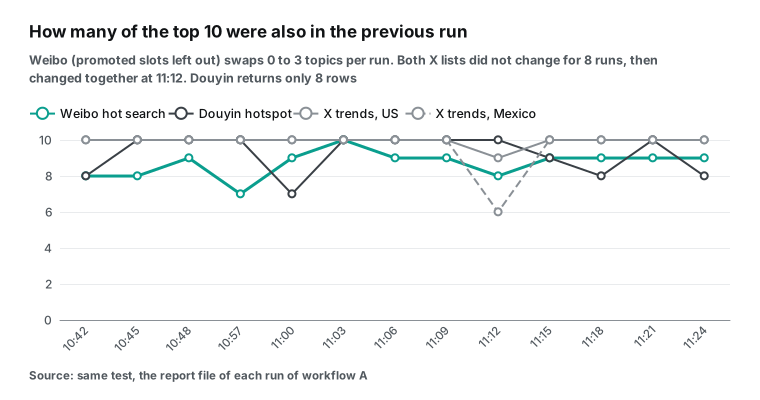
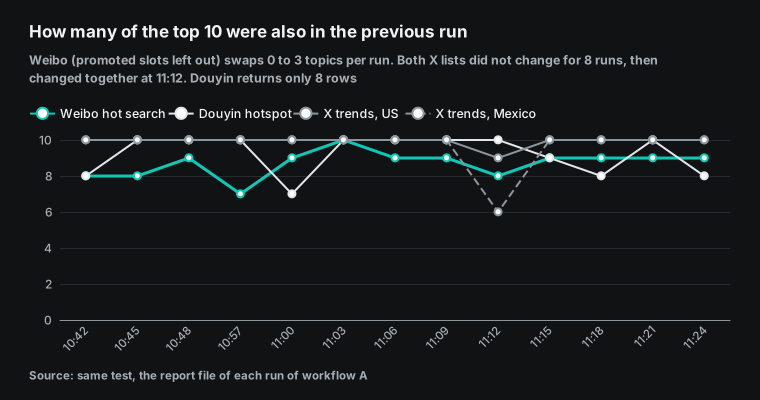
목록별 수치는 다음과 같습니다. Weibo 인기 검색어는 rank 기준으로 세고 프로모션 슬롯을 제외했습니다(각 실행에서 상위 10개 위치 중 0~2개이며, 위치 기준으로 셌을 때는 새 주제처럼 보였습니다). 두 실행 사이에 상위 10개 중 7~10개가 유지되었으므로 3분마다 0~3개 주제가 바뀌었고, 13쌍 중 9쌍에서는 바뀐 주제가 1개 이하였습니다. 1위 주제는 10:57과 11:18 SGT, 두 번 바뀌었습니다. 첫 실행과 마지막 실행의 상위 10개에 모두 있었던 주제는 4개뿐이었습니다.
Douyin 핫스팟 목록의 고정된 1위는 한 번도 바뀌지 않았습니다. 두 실행 사이에 7~10개 주제가 유지되었고, 첫 목록과 마지막 목록에 모두 있었던 주제는 5개였습니다(첫 실행은 8행뿐이었습니다).
두 X 목록은 처음 8회 실행 동안 전혀 바뀌지 않았습니다. 그러다 11:12 실행에서 둘 다 함께 바뀌었습니다. 미국 목록에서는 "Chiefs"가 1위로 올라섰습니다. 멕시코 목록에서는 TV 프로그램의 새 해시태그가 2위로 진입했고, 직전 실행에서 유지된 주제는 6개뿐이었습니다. 그 뒤 두 목록은 다시 안정되었습니다. 첫 실행과 마지막 실행 사이에 미국 목록은 9개, 멕시코 목록은 6개 주제가 유지되었습니다.
| 목록 | 연속 두 실행 간 유지 | 첫 실행과 마지막 실행 | 45분간 서로 다른 주제 수 | 1위 변경 횟수 |
|---|---|---|---|---|
| Weibo(프로모션 슬롯 제외) | 7–10 | 4 | 21 | 2회(10:57, 11:18) |
| Douyin | 7–10 | 5 | 18 | 0회(1위 고정) |
| X 미국 | 9–10 | 9 | 11 | 1 (11:12) |
| X 멕시코 | 6–10 | 6 | 14 | 0 |
프로모션 슬롯이 Weibo 수치에 미치는 영향을 나란히 비교하면 다음과 같습니다.
| Weibo 인기 검색어, 14회 실행 | 위치 기준(첫 리포트) | `rank` 기준, 프로모션 슬롯 제외(수정 후) |
|---|---|---|
| 두 실행 간 상위 10개 중복 | 7–9 | 7–10 |
| 첫 실행과 마지막 실행의 중복 | 4 | 4 |
| 45분간 등장한 서로 다른 주제 수 | 27 | 21 |
| 10:39 시점 룰라의 순위 | 5th | 4th |
| 1위 주제 변경 횟수 | 2 | 2 |
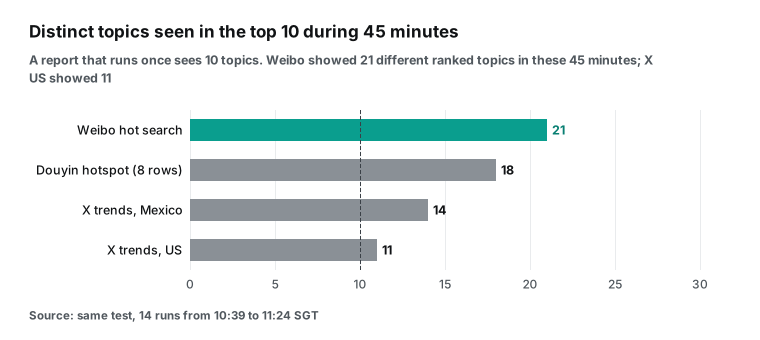
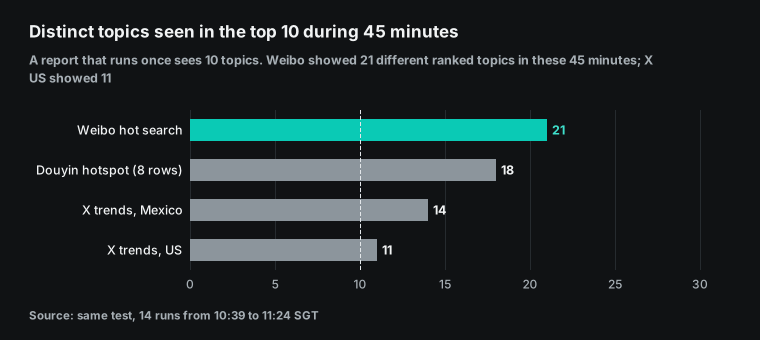
같은 데이터를 다른 측면에서 보겠습니다. 45분 동안 Weibo 상위 10위에는 순위가 매겨진 서로 다른 주제 21개가 올랐습니다(위치 기준으로 세면 27개이며, 추가 6개는 순환되는 프로모션 슬롯입니다). Douyin에는 18개, X 멕시코에는 14개, X 미국에는 11개가 올랐습니다. 하루 한 번 실행하는 리포트는 목록마다 그중 10개를 보여 줍니다. X는 이것으로 이 시간대의 대부분을 담을 수 있습니다. Weibo는 이 시간 동안 상위 10위에 오른 주제 중 절반 이상(21개 중 11개)이 리포트에 전혀 나타나지 않습니다.
이 수치는 네 목록이 서로 다른 속도로 바뀐다는 점을 보여 줄 뿐, 어느 목록이 더 낫다는 뜻은 아닙니다. X 목록은 호출할 때마다 최신 상태였습니다. collected_at은 각 호출보다 몇 초 앞선 시각이었습니다(예: SGT 10:39:34, 10:42:35). 상위 10위는 대부분 그대로 유지되다가 한 번에 바뀌었습니다. 이 기간에는 전날 밤 치러진 브라질 선거 관련 주제가 상위권을 차지했습니다.
이런 일괄 변경은 한 번만 관찰했기 때문에 X가 목록을 얼마나 자주 갱신하는지는 알 수 없습니다. X 트렌드 추천 페이지에 따르면 트렌드는 "지금 인기 있는" 주제입니다. 또한 X는 새 계정과 팔로워가 적은 계정을 걸러 내고, 국가·지역·도시별로 트렌드를 감지한다고 설명합니다. 따라서 X 트렌드는 1분마다 갱신되는 Weibo 인기 검색어보다 느리게 움직입니다.
리포트에 적용하면 이렇습니다. X의 큰 이슈를 따라가려면 하루 한두 번 실행으로 충분합니다. Weibo의 등락을 따라가려면 하루 한 번 실행으로는 실행 사이에 떠올랐다 사라지는 주제를 많이 놓칩니다. 더 자주 실행하거나 모든 목록을 보관해 "오늘 확인된 모든 주제"를 리포트에 담으세요.
키가 디스크에 기록됐을까?
리포트는 장기간 운영됩니다. 내보내기 파일, 실행 데이터 또는 백업에 들어간 키도 오랫동안 남습니다.
테스트가 끝난 SGT 11:25에 n8n을 중지하고 세 곳에서 키 문자열을 검색했습니다. 첫째는 SQLite 데이터베이스, WAL 파일, 이벤트 로그, 설정 파일을 포함한 n8n 데이터 폴더 전체입니다. 둘째는 reports/에 있는 리포트 16개입니다. 셋째는 이 글에 사용한 모든 원본 파일입니다. 일치 항목은 0건이었습니다.
자격 증명 테이블에는 암호화된 값만 저장됩니다. 실행 데이터에서 HTTP Request 노드 출력에는 상태, 응답 헤더, 본문이 있지만 요청 헤더는 없습니다. 422 호출의 오류 데이터에도 키는 없었습니다.
오류 데이터는 일부러 확인했습니다. 10월 14일 n8n은 관련 문제를 수정했습니다. GHSA-qmvv-q3c9-wpp7은 Git, MongoDB Atlas Vector Store, Google Cloud Storage 노드에 관한 권고입니다. 이 노드들은 작업이 실패하면 자격 증명의 비밀번호나 토큰을 오류 데이터에 넣었습니다. 그래서 실행 데이터는 볼 수 있지만 자격 증명은 볼 수 없는 사용자도 비밀 값을 읽을 수 있었습니다. 수정된 버전은 1.123.85, 2.44.1, 2.43.5입니다.
HTTP Request 노드는 이 목록에 없고, 저희 테스트에서도 유출은 발견되지 않았습니다. 하지만 이 사례는 업그레이드할 때마다 실행 데이터에서 비밀 값을 검색해야 하는 이유를 보여 줍니다.
실제로 겪은 문제
아래 각 행은 이번 테스트 중에 실제로 일어난 일을 순서대로 정리한 것입니다. 대부분은 n8n 버그가 아닙니다. 2.x의 새 기본값이 명령줄 사용 방식과 맞물리면서 생긴 문제입니다.
| 증상 | 원인 | 해결 방법 |
|---|---|---|
Cannot find module 'kuler' 오류로 시작 실패 | 첫 npm install이 중간에 멈췄고, 두 번째 설치로도 복구되지 않음 | node_modules와 package-lock.json을 삭제하고 다시 설치(6분 소요) |
| n8n이 즉시 종료됨: "Task Broker's port 5679 is already in use" | N8N_PORT가 내장 태스크 브로커의 기본 포트인 5679였음 | 다른 포트를 사용하거나 N8N_RUNNERS_BROKER_PORT 설정 |
publish:workflow는 성공하지만 일정대로 아무것도 실행되지 않음 | 명령은 데이터베이스에 기록하지만, 실행 중인 n8n은 이를 다시 읽지 않음 | n8n 재시작(명령이 이에 관한 경고를 출력함) |
| 매분 0초가 아니라 24초에 실행됨 | 2.45부터 "N분마다"는 활성화 시점부터 계산됨 | "Days"나 "Hours", 또는 cron 표현식 사용 |
서비스 실행 중에는 n8n execute 실패 | 명령이 같은 포트에서 두 번째 태스크 브로커를 시작함 | 해당 명령에 N8N_RUNNERS_BROKER_PORT와 N8N_PORT 설정 |
| 수동 실행에서는 "직전 실행과의 중복"이 항상 비어 있음 | 정적 데이터는 트리거로 시작된 게시된 워크플로에서만 저장됨 | 정상 동작. 테스트에서 필요하면 데이터 테이블 사용 |
| 시작 시 지원 중단 안내가 다수 출력됨 | 2.x 라인은 3.0을 준비하는 단계 | 테스트에는 문제없음. 일상 운영에는 Docker와 외부 태스크 러너로 전환 |
첫 번째 행이 가장 많은 시간을 잡아먹었고, 잘못 해석하기도 쉽습니다. 오류 메시지에 n8n과 무관한 로깅 패키지 이름이 나와 Node.js 문제처럼 보이지만 그렇지 않습니다. 설치가 끝나지 않은 것이며, 클린 설치로 해결됩니다.
세 번째와 네 번째 행은 함께 읽으세요. 에디터에서는 데이터베이스 기록과 워크플로 활성화가 한 번의 클릭으로 함께 일어나므로, 실행 주기의 기준 초는 클릭한 시점의 초로 정해집니다. 명령줄에서 게시한 뒤 재시작하는 경우에는 재시작으로 워크플로가 활성화된 시점의 초가 기준이 됩니다. 저희 테스트에서 두 시점은 3분 25초 차이가 났습니다. 명령줄로 리포트를 배포하면서 "N분마다" 실행을 다른 시스템과 맞춰야 한다면, 기준 초는 재시작 시점에 정해집니다.
지원 중단 안내는 한 번 꼼꼼히 읽어 볼 만합니다. SGT 10:36 시작 로그에는 6개가 있었습니다. N8N_UNVERIFIED_PACKAGES_ENABLED의 기본값이 false로 바뀝니다. 내부 태스크 러너 모드가 제거되므로 외부 모드로 옮겨야 합니다. 태스크 타임아웃 N8N_RUNNERS_TASK_TIMEOUT은 300초에서 60초로 줄어듭니다.
압축 노드의 제한 두 가지가 낮아집니다. 마지막 안내는 "Running n8n outside a container is deprecated"입니다. 리포트에서는 태스크 타임아웃이 중요합니다. 3.0 이후에는 60초보다 오래 실행되는 Code 노드 태스크가 중지되므로, 타임아웃을 직접 설정하거나 작업을 나누세요. 외부 모드는 태스크 러너 페이지에서 설명합니다.
SQLite에서 직접 확인하는 방법
n8n 에디터는 실행 목록을 보여 주지만 "실행됐어야 하는데 실행되지 않은 실행"은 보여 주지 않습니다. 영속형 스케줄러는 이 정보를 두 테이블에 보관하며, sqlite3로 읽을 수 있습니다. J1~J4 판정에는 다음 세 쿼리를 사용했습니다:
DB=$HOME/Downloads/n8n-lf25/home/.n8n/database.sqlite
# 1. Phase, interval, misfire policy and grace of each schedule
sqlite3 -header $DB "select name, intervalSeconds, nextRunAt, lastFiredAt, misfirePolicy, misfireGraceSeconds from scheduled_job;"
# 2. Each run in the queue: planned time, actual start, latest allowed start
sqlite3 -header $DB "select id, jobId, status, scheduledFor, startedAt, missedAfter from scheduled_task order by id;"
# 3. Runs that executed: trigger mode, status, start time (all times in UTC)
sqlite3 -header $DB "select id, workflowId, mode, status, startedAt from execution_entity order by id;"
세 가지를 기억하세요. 첫째, 모든 시각은 UTC입니다. 싱가포르 시간은 8시간을 더하고, 뉴욕 시간은 11월 1일까지 4시간을 빼세요.
둘째, scheduled_task에는 대기열에 들어간 실행만 기록됩니다. 유예 시간은 기본 60초입니다. 다운타임 중 실행 예정 시각이 지났고 n8n이 다시 시작됐을 때 유예 시간도 지난 실행은 이 테이블에 전혀 나타나지 않습니다. 따라서 행 수를 세어 누락된 실행 수를 알 수 없습니다. 실행 주기의 기준 시점에서 계산하거나 n8n_scheduler_occurrences_misfired_total을 확인하세요.
저희도 정확히 이렇게 했습니다. SGT 10:51:24와 10:54:24에 예정된 A의 실행에는 행이 없습니다. "주기 기준 시점 + 180초 × k"로 계산한 뒤 카운터 값 2와 일치하는지 확인했습니다.
셋째, 완료된 실행은 기본적으로 하루 동안 보관되고(N8N_SCHEDULER_RETENTION은 86,400초), 실패하거나 누락된 실행은 7일 동안 보관됩니다. 월간 검토를 하려면 정기적으로 내보내세요. 저희는 테이블 세 개를 executions.json으로 내보냈고, 분석 스크립트 analysis.py는 이 파일을 바탕으로 이 글에 나오는 모든 시간 값을 계산합니다.
이 표는 각 통과 기준과 그 판정 근거가 된 증거를 연결합니다. 모든 파일은 기록으로 보관합니다.
| 확인 항목 | 근거 자료 | 비교 대상 |
|---|---|---|
| J1–J3 | executions.json(테이블 execution_entity, scheduled_task, scheduled_job) | 계획 시각 대비 시작 시각, 간격, 위상 |
| J4 | executions.json, metrics_1057.txt | 누락된 행과 카운터 비교 |
| J5 | run_*.json, logs_*.json | 호출별 charged_usd와 서버 로그의 cost 비교 |
| J6 | run_*.json | 상태 코드 422, did_you_mean, 로그 항목 없음 |
| J7 | mcp_n8n_weibo_trending.json, run_2_eiDailyReport01.json | 필드 이름, MCP와 REST 비교 |
| J8 | analysis.json | 실행 간 상위 10개 집합 |
| J9 | n8n 폴더, 보고서, 저장된 원본 파일 검색 | API 키 문자열, 일치 항목 0건 |
| J10 | replay_weibo.json, replay_weibo.headers, manual_run_*.json | replayed, 헤더, 서버 로그 |
필드 레퍼런스: 보고서에서 쓸 수 있는 모든 필드
보고서는 각 행의 이름과 순위만 사용하지만, 4개 기능은 더 많은 필드를 반환합니다. 저희는 이 표를 SGT 10:15에 조회한 카탈로그 response_fields와 필드별로 대조했습니다. "이번 실행" 열은 10:39 실행의 행에 실제로 있었던 필드를 보여 줍니다.
| 기능 | 카탈로그 `response_fields` | 이번 실행 | 보고서 사용 필드 | 의미(카탈로그 기준) |
|---|---|---|---|---|
twitter/trending | id, name, rank, volume, period, collected_at, platform | 7개 모두 | name, rank | volume은 논의량이고 collected_at은 수집 시각이므로, 최신성을 판단할 때 사용 |
weibo/trending | rank, title, category, hot_value, label, is_hot, is_new, url, platform | 14회 실행 모두 category 없음. label은 있으며 값은 빈 값, "new", "hot" 중 하나 | title, rank | hot_value는 웨이보 자체 인기 점수로 목록 안에서만 비교 가능. is_new는 목록에 새로 오른 항목을 의미 |
douyin/trending | rank, keyword, hot_value, video_count, board, image_url, event_time, sentence_id, group_id, label, word_type, article_count, is_pinned, max_rank, live_room_count, topic_view_count, sentence_tag, label_icon_url, related_music_id, platform | 14회 실행에서 20개 필드 모두 확인. hot_value와 max_rank는 고정된 1위에서만 비어 있음 | keyword, rank | hot_value는 더우인 자체 인기 점수로 핫스팟 목록에서는 비어 있을 수 있음. event_time은 이벤트 발생 시각 |
원본 응답을 행 단위로 확인하고 나서야 발견한 점이 세 가지 있습니다. 첫째, 더우인의 고정 행(is_pinned: true)에는 hot_value가 없지만 나머지 19개 행에는 있습니다. 인기 점수로 정렬하면 고정 행이 맨 뒤로 가므로 더우인은 rank로 정렬하세요.
둘째, event_time 필드 하나가 두 가지 형식으로 왔습니다. 고정 행은 시간대 없이 "2026-10-26 10:41:56" 형식을, 나머지 행은 UTC 기준 "2026-10-25T01:23:31.000Z" 형식을 사용했습니다. 단순 문자열 비교로는 잘못된 결과가 나오므로 두 형식을 모두 파싱하세요.
셋째, 웨이보는 14회 실행 동안 category를 한 번도 반환하지 않았습니다. 필드가 항상 있다고 가정하지 마세요. x.category ?? ''처럼 기본값을 두고 읽어야 필드가 빠진 날 Code 노드에서 오류가 나지 않습니다. 다른 boards 값은 다르게 동작할 수 있으며, 이는 테스트하지 않았습니다.
전체 파라미터와 필드는 X 트렌드 API 페이지, 웨이보 인기 급상승 페이지, 더우인 인기 급상승 페이지에서 확인할 수 있습니다. 플랫폼 개요는 X 스크래핑 API, 웨이보 스크래핑 API, 더우인 스크래핑 API를 참고하세요.
코드로 같은 호출 보내기
아직 n8n을 설치하지 않으려면, 이 curl 명령으로 4단계의 HTTP Request 노드와 같은 요청을 보낼 수 있습니다. 먼저 터미널에서 API 키와 파라미터를 확인할 때 사용하세요.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer ${EVERYINFRA_API_KEY}" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: daily-report-$(TZ=America/New_York date +%Y%m%d)-twitter-us" \
  -d '{"platform":"twitter","action":"trending","params":{"country":"us"}}' \
  | jq '{replayed, count, top3: [.results[0:3][].name], charged_usd: .billing.charged_usd}'
같은 날 두 번째로 실행하면 replayed가 true가 됩니다. charged_usd에는 여전히 첫 번째 값이 표시되지만 새로 과금되지는 않습니다. 여기서는 키의 날짜에 뉴욕 시간을 사용한다는 점에 유의하세요. 키에 사용할 시간대를 하나 정하고 n8n에서도 같은 시간대를 쓰세요. 그렇지 않으면 자정 무렵 실행되는 보고서가 예상보다 일찍 또는 늦게 새 키를 받을 수 있습니다.
API 키를 발급받고 요청·응답 형식을 확인하려면 빠른 시작부터 보세요. 기능별 가격은 요금 페이지에 있습니다. 보고서에서 실패한 호출의 환불도 확인하나요? 실패 호출 환불 대조 가이드에서 charge_id와 호출 로그로 각 과금을 대조하는 방법을 소개합니다.
같은 작업을 하는 다른 방법
일일 보고서에 꼭 n8n이 필요한 것은 아닙니다. 이 표에는 저희가 직접 확인할 수 있었던 사실과 각 방법이 적합한 경우만 정리했습니다.
| 방법 | 다운타임 중 예정된 실행 | 재실행 시 이중 과금 방지 | 적합한 경우 |
|---|---|---|---|
| n8n 2.45+ durable 스케줄러(이 글) | 유예 시간 안이면 늦게 실행, 넘으면 건너뛰거나 한 번 따라잡기 실행 | 각 요청의 Idempotency-Key | 여러 단계와 실패 분기가 있는 흐름을 UI에서 편집하려는 경우 |
| n8n 2.44 이하(인메모리 스케줄러) | 건너뜀, 따라잡기 없음 | 동일 | 아직 업그레이드할 수 없는 인스턴스 |
| 시스템 cron + curl 스크립트 | 건너뜀(cron은 놓친 시각을 실행하지 않음) | 동일. 단, 스크립트에서 키를 생성 | 호출 한두 번, UI 불필요 |
| MCP를 통해 AI 클라이언트에서 직접 질문 | 예약 실행 없음 | 도구 인수에 키 없음 | 일회성 질문, 고정된 일일 출력 불필요 |
"cron은 따라잡지 않는다"는 전통적인 cron 기준입니다. Persistent=true를 설정한 systemd 타이머처럼 따라잡기를 지원하는 타이머도 있지만, 테스트하지는 않았습니다. 저희 기준은 이렇습니다. 실패 분기 없이 호출이 한두 번이면 cron과 curl이 더 가볍습니다. 단계가 세 개 이상이거나, 실패를 보고서에 담아야 하거나, 다른 사람이 흐름을 편집한다면 n8n을 쓰세요. 멀티 플랫폼 평판 모니터링 가이드는 다른 방식을 사용하므로 비교해 보세요.
이 구성이 맞지 않는 경우
모든 실행이 정확히 한 번씩 필요한 경우. 따라잡기 정책은 놓친 실행 중 가장 최근 한 건만 실행하며, 모든 실행을 다시 하지는 않습니다. 문서에 따르면 밀린 실행을 하나씩 재실행하는 정책은 없습니다. 일 평균 계산처럼 매시간 결과가 모두 필요하다면, 보고서의 계획 시각을 확인하고 빈 곳을 직접 채우세요.
여러 n8n 인스턴스가 SQLite 데이터베이스 하나를 공유하는 경우. 저희는 인스턴스 하나만 테스트했습니다. 문서에 따르면 메인 인스턴스가 여러 개이면 각 실행을 한 인스턴스가 맡지만, 여기에는 Postgres와 큐 모드가 필요하며 이는 테스트하지 않았습니다.
전체 목록이 필요한 경우. 기본적으로 호출마다 20행을 반환하며, 첫 호출은 10행과 8행만 반환했습니다(테스트 3 참고).
긴 측정 기간이 필요한 경우. 저희는 SGT 기준 10월 26일 오전에 45분 동안 측정했습니다. 브라질 선거 다음 날로, 하나의 이슈가 모든 목록의 1위를 차지하던 때였습니다.
최근 변경 사항
- 2026년 10월 20일: n8n 2.45에서 durable 스케줄러가 기본으로 켜집니다. 변경 내역과 GitHub 릴리스 노트를 참고하세요. 이 릴리스는 사용되지 않던
N8N_SCHEDULER_MIN_INTERVAL도 제거합니다. 영향: 업그레이드 후 "N분마다"의 위상이 새로 정해지고 다운타임 시 동작도 달라지므로, 예약된 워크플로마다 misfire 정책을 검토하세요. - 3.0부터는 Docker만 지원합니다. 3.0 브레이킹 체인지 페이지에 따르면 npm과
npx n8n지원이 종료되고 기존 Cron 및 Interval 노드가 제거됩니다. 영향: 이 글의 npm 설치는 테스트용입니다. 장기 실행 보고서는 Docker로 옮기고 Cron 노드는 Schedule Trigger로 교체하세요. - 2026년 10월 14일: n8n 보안 업데이트. 업데이트에는 실행 오류 데이터의 자격 증명 노출을 포함한 보안 권고 15건이 담겨 있습니다. 영향: 셀프 호스팅 인스턴스는 최신 패치를 유지하고, 업그레이드 후에는 실행 데이터에서 비밀 값을 검색하세요.
- 2026년 10월 14일: Censys, n8n을 가장 많이 노출된 AI 관련 제품으로 지목. Censys 보고서는 호스트 113,926개를 집계했습니다. 영향: 자체 머신에서 보고서를 실행하는 n8n은 인터넷에 노출될 이유가 없습니다.
- 2026년 10월 6일: Diagrid, n8n용 durable execution 발표. 유료 보도자료에 따르면 크래시 후 워크플로가 실패한 노드부터 이어서 실행됩니다. 멱등성 원장이 부수 효과의 반복을 막습니다. 영향: n8n 2.45는 예정된 실행이 사라지지 않도록 보장합니다. 실행 도중의 크래시는 별개의 문제이며, 파트너사들이 이미 이 문제에 대응하고 있습니다.
- 2026년 10월 12일: ZoomInfo, 네이티브 n8n 노드 출시. Business Wire 보도자료에 따르면 ZoomInfo는 API와 MCP로도 데이터를 제공합니다. 영향: 데이터 서비스는 전용 노드와 MCP를 통해 n8n에 연결됩니다. EveryInfra는 현재 전용 n8n 노드가 없으며, 이 글에서는 범용 HTTP Request 노드와 MCP Client 노드를 사용합니다.
- 2026년 10월 22일: IETF Idempotency-Key 초안 버전 08 공개. IETF datatracker 페이지를 참고하세요. 영향: 요청 헤더를 통한 멱등성 처리가 표준이 되어 가고 있으므로, 날짜 기반 키는 다른 API에서도 쓸 수 있습니다.
FAQ
n8n Schedule Trigger의 시간대는 어떻게 설정하나요? (출처: Google 추천 검색어 "n8n schedule trigger time zone", 2026년 10월 26일 확인)
셀프 호스팅 n8n은 기본적으로 America/New_York을 사용합니다. GENERIC_TIMEZONE을 America/Chicago 등으로 설정하고 재시작하세요. 워크플로 설정에서도 시간대를 지정할 수 있으며, 이 값이 인스턴스 설정보다 우선합니다(Schedule Trigger 페이지). 저희는 두 곳 모두 Asia/Singapore로 설정했기 때문에 파일 이름이 싱가포르 시간을 따릅니다.
재시작 후 n8n Schedule Trigger가 실행되지 않은 이유는 무엇인가요? (출처: Google 추천 검색어 "n8n schedule trigger not running", 2026년 10월 26일 확인)
먼저 버전을 확인하세요. 2.44까지는 기본 인메모리 스케줄러가 다운타임 중 예정된 실행을 모두 건너뜁니다. 2.45부터는 n8n이 유예 시간(기본 60초) 안에 복구되면 durable 스케줄러가 해당 실행을 늦게라도 실행합니다. 유예 시간을 넘기면 노드 설정 "If Execution Is Missed"에 따라 결정되며, 이 설정의 기본값도 건너뛰기입니다. 6분 44초 동안 중지한 저희 테스트에서는 기본 정책이 설계대로 실행 2건을 건너뛰었습니다. 따라잡으려면 "Run the Most Recent Missed Execution"을 설정하고, 따라잡기 실행이 이중으로 과금되지 않도록 날짜 기반 키를 사용하세요.
n8n에서 워크플로를 멈추지 않고 HTTP Request 오류를 처리하려면 어떻게 하나요? (출처: Google 추천 검색어 "n8n http request error handling", 2026년 10월 26일 확인)
HTTP Request 노드 옵션에서 "Never Error"와 "Include Response Headers and Status"를 켜세요. 그러면 2xx가 아닌 응답도 데이터로 다음 노드에 전달되고, statusCode로 분기할 수 있습니다. 14회 실행 동안 잘못된 호출은 매번 422를 반환했고, 보고서는 매번 도착했습니다. EveryInfra 오류에는 next_steps가 포함되어 있어 그대로 보고서에 넣을 수 있습니다.
함께 읽을 글
- 원격 MCP 설정: Claude, Cursor 등 클라이언트에서 EveryInfra MCP를 연결합니다.
- 실패 호출 환불 대조: 모든 과금과 환불을 대조합니다.
- YouTube 댓글로 주제 보고서 판매하기: 매월 실행하는 또 다른 예약 보고서입니다.
- MCP 2026 사양과 프로덕션 준비 상태: MCP 전송 방식과 인증에 관한 배경 지식입니다.
참고 자료
- “Durable scheduler”, n8n Docs, 2026년 10월, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/durable-scheduler/>
- “Scheduler environment variables”, n8n Docs, 2026년 10월, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/scheduler/>
- “Schedule Trigger node”, n8n Docs, 2026년 10월, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.scheduletrigger/>
- “Changelog”(durable 스케줄러 기본 활성화), n8n Docs, 2026년 10월 20일, <https://docs.n8n.io/changelog/>
- “Release notes”(n8n 2.45 및 2.44), n8n Docs, 2026년 10월 20일, <https://docs.n8n.io/changelog/release-notes/>
- “Release n8n 2.45.0”, n8n(GitHub), 2026년 10월 20일, <https://github.com/n8n-io/n8n/releases/tag/n8n%402.45.0>
- “v3.0 Breaking changes”, n8n Docs, 2026년 10월, <https://docs.n8n.io/changelog/v30-breaking-changes/>
- “Developing v3 features”, n8n(GitHub), 2026, <https://github.com/n8n-io/n8n/blob/master/.github/DEVELOPING_V3.md>
- “Install with npm”, n8n Docs, 2026년 10월, <https://docs.n8n.io/deploy/host-n8n/install-options/install-with-npm/>
- n8n 패키지 메타데이터(dist-tags 및 릴리스 시각), npm registry, 2026년 10월 26일 확인, <https://registry.npmjs.org/n8n>
- “Use Docker Compose”, n8n Docs, 2026년 10월, <https://docs.n8n.io/deploy/host-n8n/install-options/install-using-docker-compose/>
- “One-line setup”, n8n Docs, 2026년 10월, <https://docs.n8n.io/deploy/host-n8n/install-options/one-line-setup/>
- “Node.js Releases”, Node.js, 2026년 10월 21일 업데이트, <https://nodejs.org/en/about/previous-releases>
- “Set the timezone”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/set-the-timezone/>
- “Daylight Saving Time Rules”, NIST, 2026, <https://www.nist.gov/pml/time-and-frequency-division/popular-links/daylight-saving-time-dst>
- “Time Zone Database”, IANA, <https://www.iana.org/time-zones>
- “Security environment variables”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/security/>
- “Read/Write Files from Disk node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.readwritefile/>
- “Use the command line”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/use-the-command-line/>
- “HTTP Request credentials”, n8n Docs, <https://docs.n8n.io/integrations/builtin/credentials/httprequest/>
- “RFC 6750: Bearer Token Usage”, IETF, 2012, <https://www.rfc-editor.org/rfc/rfc6750>
- “EveryInfra OpenAPI”(멱등성 키, 리플레이, 오류), EveryInfra, 2026년 10월 26일 확인, <https://api.everyinfra.com/openapi.json>
- “The Idempotency-Key HTTP Header Field”, draft-08, IETF HTTPAPI WG, 2026년 10월 22일, <https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/>
- “HTTP Request node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/>
- “getWorkflowStaticData”, n8n Docs, <https://docs.n8n.io/build/code-in-n8n/cookbook/built-in-methods-and-variables-examples/getworkflowstaticdata/>
- “Convert to File node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.converttofile/>
- “Enable Prometheus metrics”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/enable-prometheus-metrics/>
- “n8n-scheduler Grafana dashboard”, n8n-observability(GitHub), <https://github.com/n8n-io/n8n-observability/tree/main/dashboards/grafana/n8n-scheduler>
- EveryInfra 기능 카탈로그, EveryInfra, 2026년 10월 26일 10:15 SGT 확인, <https://api.everyinfra.com/api/v1/social/catalog>
- “Hot search rules”, 웨이보, <https://m.s.weibo.com/hot/description>
- “RFC 9110: HTTP Semantics”(422 Unprocessable Content), IETF, 2022, <https://www.rfc-editor.org/rfc/rfc9110>
- “Handle errors gracefully”, n8n Docs, <https://docs.n8n.io/build/flow-logic/handle-errors-gracefully/>
- “MCP Client node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-langchain.mcpclient/>
- “MCP Client Tool node”, n8n Docs, <https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolmcp>
- “MCP specification 2025-11-25: Transports”, Model Context Protocol, <https://modelcontextprotocol.io/specification/2025-11-25/basic/transports>
- “Trends Recommendations”, X 고객센터, <https://help.x.com/en/resources/recommender-systems/trends-recommendations>
- “Set up task runners”, n8n Docs, <https://docs.n8n.io/deploy/host-n8n/configure-n8n/set-up-task-runners/>
- “GHSA-qmvv-q3c9-wpp7: Credential Secrets Exposed in Execution Error Data”, n8n(GitHub), 2026년 10월 14일, <https://github.com/n8n-io/n8n/security/advisories/GHSA-qmvv-q3c9-wpp7>
- “5 Key Takeaways From Censys' State of the Internet Report”, Censys, 2026년 10월 14일, <https://censys.com/blog/state-of-the-internet-report-2026/>
- “Security update — 01 October 2026”, n8n Community, 2026년 10월 1일, <https://community.n8n.io/t/security-update-01-october-2026/318054>
- “Security update — 14 October 2026”, n8n Community, 2026년 10월 14일, <https://community.n8n.io/t/security-update-14-october-2026/321284>
- “Diagrid Brings Durable Execution to n8n”(유료 보도자료), Business Wire(Yahoo Finance 게재), 2026년 10월 6일, <https://finance.yahoo.com/technology/ai/articles/diagrid-brings-durable-execution-n8n-130000140.html>
- “ZoomInfo Launches Native Integration With n8n Through GTM.AI”, Business Wire, 2026년 10월 12일, <https://www.businesswire.com/news/home/20261012317239/en/ZoomInfo-Launches-Native-Integration-With-n8n-Through-GTM.AI>
- “Faltam 12 dias: consulte propostas das candidaturas que disputam o 2º turno”, 브라질 최고선거법원, 2026년 10월 13일, <https://www.tse.jus.br/comunicacao/noticias/2026/Outubro/faltam-12-dias-consulte-propostas-das-candidaturas-que-disputam-o-2o-turno>
- “An n8n execution can show Success after processing zero items”, Reddit r/n8n, <https://www.reddit.com/r/n8n/comments/1xadlkd/an_n8n_execution_can_show_success_after/>
참고 LF-26