Выборки для исследований соцсетей: повторите тот же поиск, и половина результатов изменится
Прежде чем использовать результаты поиска в соцсетях как исследовательскую выборку, проверьте, стабильна ли она. 24 октября 2026 года мы повторили те же запросы через две минуты. В X, YouTube и TikTok совпала лишь примерно половина результатов. Также в статье: удаления, дубликаты, временные окна и положение дел со статьёй 40 DSA.
Поиск по ключевым словам на соцплатформе не даёт фиксированной выборки. 24 октября 2026 года (здесь и далее время сингапурское, UTC+8) мы повторно отправили те же четыре запроса примерно через две минуты. Каждый раз мы брали по 25 результатов. В X, YouTube и TikTok коэффициент Жаккара между двумя прогонами составил всего 0,47–0,56. Все «новые» записи во втором прогоне были опубликованы ещё до первого прогона.
Третий прогон через два часа дал коэффициент Жаккара 0,52 с первым прогоном для X и 0,22 для TikTok, но 0,92 для YouTube. Поэтому фиксируйте время запроса, полный набор параметров и сырой ответ. Выполняйте каждый запрос несколько раз и указывайте коэффициент Жаккара. Иначе другие исследователи не смогут воспроизвести вашу выборку, а вы сами не сможете сделать это завтра.
Эта статья для исследовательских групп, которые работают с данными соцсетей или поиска: в коммуникативистике, общественном здравоохранении, политологии, вычислительной социальной науке, а также в фактчекинговых подразделениях. Мы описываем методы работы с данными и приводим числа, которые можно проверить. Юридических консультаций мы не даём. Условия платформ и Закон ЕС о цифровых услугах (DSA) читайте в оригинале, а по своему проекту консультируйтесь с этическим комитетом и юридическим отделом.
Почему стоит проверить выборку именно сейчас
За последние два месяца изменились сразу несколько способов получить данные платформ:
- Reddit назначил даты закрытия публичного Data API. Reddit опубликовал их в r/redditdev 30 сентября 2026 года. С 31 октября новые заявки на доступ к публичному API не принимаются. С 12 января 2027 года начнётся отключение доступа для приложений, которые не зарегистрировались. В марте 2027 года публичный доступ закроют для всех оставшихся приложений. TechCrunch в тот же день сообщил, что это затронет инструменты, которыми пользуются исследователи.
- Правило 8 Reddit запрещает использовать удалённый контент. 24 октября мы прочитали страницу Reddit Help «Don't break the site». В ней сказано, что приложения не должны «продолжать использовать или показывать публичный контент, удалённый пользователями или за нарушение Правил Reddit». Там же как возможное нарушение указан парсинг «без официального соглашения».
- Заявки по статье 40 DSA принимаются, но публичных сообщений об успешных заявках пока нет. Oliver Marsh работает в немецкой НКО AlgorithmWatch. В DSA Observatory 2 октября он написал, что к июлю 2026 года было подано 77 заявок по статье 40(4). По имеющимся данным, ни одна из них ещё не была удовлетворена. Ирландский регулятор Coimisiún na Meán опубликовал годовой отчёт за 2025 год 7 октября. На странице 81 сказано, что положение вступило в силу 29 октября 2025 года и что поступили первые заявки.
- Reddit теперь — очень крупная онлайн-платформа. 31 августа Европейская комиссия присвоила Reddit и Roblox статус очень крупных онлайн-платформ (VLOP). ChatGPT стал очень крупной поисковой системой (VLOSE). У них есть четыре месяца, до января 2027 года, чтобы выполнить дополнительные обязательства VLOP, и доступ к данным по статье 40 — одно из них. Так что закрытие публичного API Reddit и начало его обязанностей перед исследователями по DSA приходятся на один квартал.
Когда доступ к данным сужается, исследователям приходится показывать, насколько полны их собственные выборки. Тест ниже — недорогой способ это сделать.
Тест: один запрос, три прогона
Сначала мы зафиксировали критерии. Это правило мы задали до третьего прогона. Если у двух прогонов одного запроса коэффициент Жаккара 0,9 или выше, для этого эндпоинта достаточно одного прогона. Если ниже 0,9, делайте несколько прогонов и указывайте объединение и пересечение. Если новая запись опубликована до первого прогона, мы считаем это различием в ранжировании или выборке, а не новым постом.
Условия. Четыре платформы, четыре эндпоинта, одинаковые параметры во всех прогонах, 25 результатов на вызов:
- API поиска Reddit (
reddit/search): ключевое словоDigital Services Act,sort=newest. - API поиска Twitter (X) (
twitter/search): ключевое слово в кавычках,"Digital Services Act",sort=latest. - API поиска YouTube (
youtube/search): ключевое словоDigital Services Act, сортировка по релевантности по умолчанию. - API поиска TikTok (
tiktok/search): ключевое словоclimate change,content_type=video.
Прогон A — в 12:13–12:15, прогон B — в 12:16–12:17, прогон C — в 14:15–14:18. Мы сравнивали ID записей, а не заголовки.


Результаты.
- X: у прогонов A и B совпали 18 из 25 записей. Коэффициент Жаккара — 0,56, в топ-10 совпали 7. 7 новых записей в прогоне B были опубликованы с апреля 2022 по август 2026 года. Ни одна не появилась между двумя прогонами. У прогона C коэффициент Жаккара с A — 0,52, с B — 0,43. За три прогона появилось 39 разных записей, и только 14 были во всех трёх. Самая новая из 7 новых записей в прогоне C опубликована 20 октября.
- YouTube: 16 общих записей, коэффициент Жаккара 0,47, в топ-10 совпали лишь 4. 9 новых записей в прогоне B опубликованы в 2022–2025 годах. У прогона C коэффициент Жаккара с A — 0,92 (отличалась только 1 запись), но с B — 0,43. Прогон B похож на другой набор результатов, который через два часа снова исчез. За три прогона появилось 35 разных записей, и 15 были во всех трёх.
- TikTok: 16 общих записей, коэффициент Жаккара 0,47. Но в топ-10 совпали 9, так что большинство изменений пришлось на позиции ниже 12-й. Самая новая из 9 новых записей опубликована 24 октября в 00:11 UTC, до прогона A. Через два часа расхождение выросло. У прогона C коэффициент Жаккара с A — 0,22, с B — 0,19. За три прогона появилось 49 разных записей, и лишь 7 были во всех трёх. Самая новая из 15 новых записей в прогоне C опубликована 23 октября в 23:50 UTC, тоже до прогона A.
- Reddit (сначала новые): прогоны A и B вернули те же 25 записей в том же порядке. В прогоне C, через два часа, все 25 записей оказались новыми постами за 05:15–06:12 UTC. Окно «сначала новые» сдвигается со временем. Именно это и означает «newest», поэтому нестабильностью мы это не считаем.
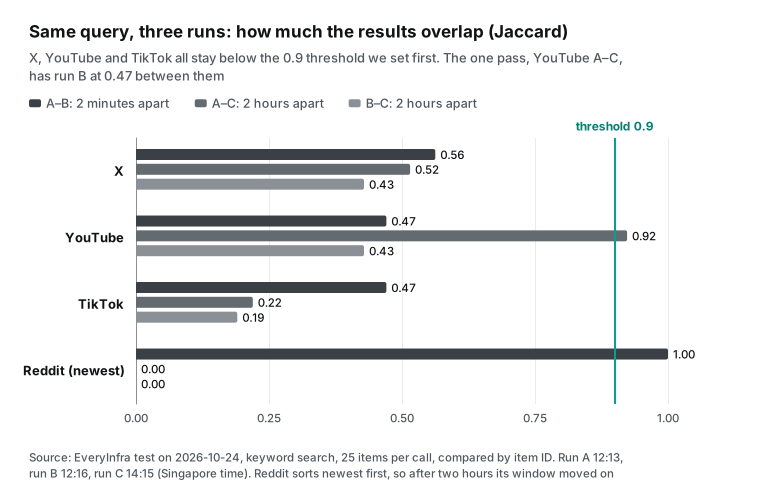
По нашему же правилу поиск по ключевым словам в X, YouTube и TikTok не даёт воспроизводимой выборки за один прогон. Единственная пара выше 0,9 — прогоны A и C в YouTube, но у прогона B между ними было 0,47. Так что одно высокое пересечение у одной пары прогонов ничего не доказывает.
Дело не в сбое инструмента. В каталоге возможностей EveryInfra указано, что X по умолчанию возвращает результаты «Top», а latest не гарантирует строгого порядка по времени. В документации YouTube Data API сама Google пишет, что totalResults «является приблизительным значением и может не отражать точное число». Поиск с ранжированием по релевантности — это не фиксированный список.
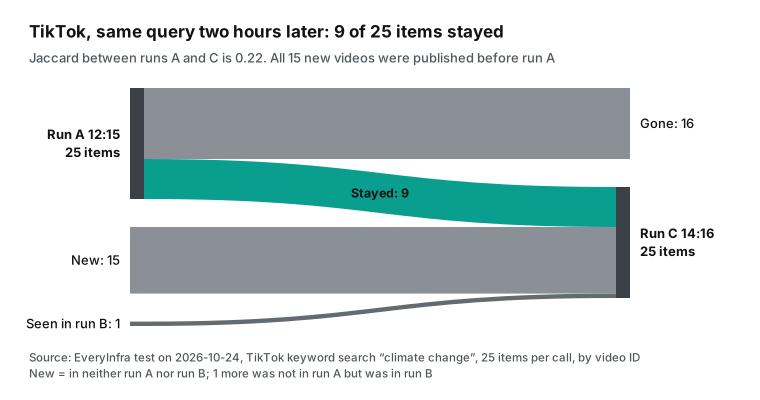
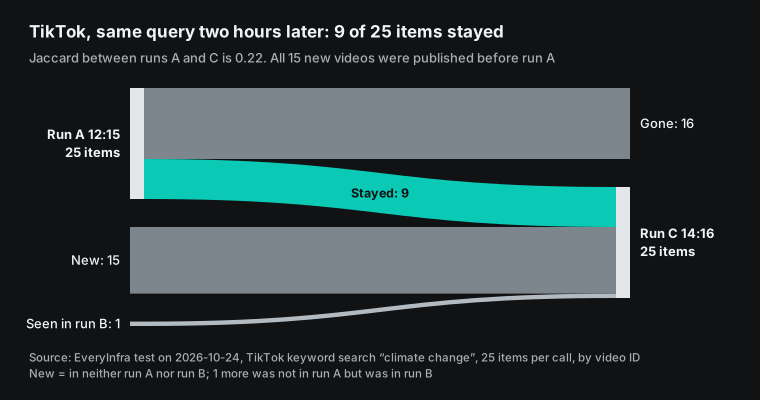
Ограничения результата: мы проверили 4 запроса по 25 записей, три прогона за один день. Не переносите выводы на полные архивы или более длинные периоды. Стабильный результат Reddit относится к сортировке «сначала новые» на интервале в две минуты. Он не доказывает, что сортировка по релевантности в Reddit стабильна.
Совпадение по ключевым словам шире, чем кажется
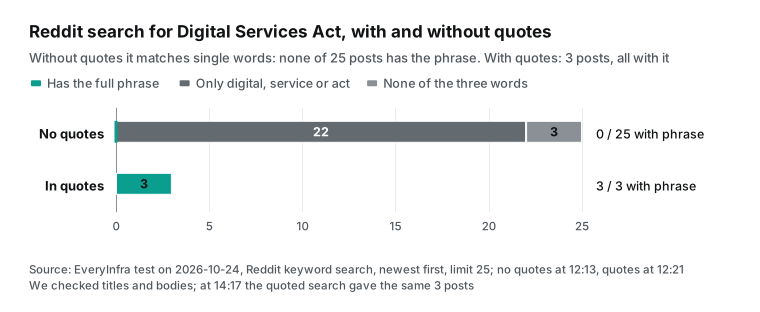
Тот же тест выявил вторую проблему. В Reddit ключевая фраза из нескольких слов без кавычек ищется по отдельным словам, а не как фраза.
- В прогоне A запрос
Digital Services Actбез кавычек (сначала новые) вернул 25 постов. Ни в одном не было полной фразы ни в заголовке, ни в тексте. В 22 встречалось хотя бы одно из слов (digital, service, act). Это были реклама казино, советы об отношениях и предложения обмена в играх. - В 12:21 мы отправили
"Digital Services Act"в кавычках, тоже с сортировкой от новых к старым. Поиск вернул 3 поста, и во всех 3 была полная фраза. Это были апелляция по аккаунту Instagram, предупреждение о мошеннических сайтах знакомств и немецкий пост о мошенничестве с арендой жилья. Согласно каталогу, этот эндпоинт ищет за последний месяц, поэтому эти 3 поста и есть всё, что поиск с сортировкой по новизне выдаёт за этот месяц. В 14:17 мы снова получили те же 3 поста.
Проверка релевантности тоже может ошибаться. Для набора из TikTok мы сначала посчитали посты, в тексте которых есть «climate change». Совпали только 4 из 25. Затем мы убрали из хештегов # и пробелы и сравнили снова. Теперь совпали 23 из 25. 19 видео, которые мы упустили, содержали только #climatechange.
Что это значит для исследования: проверяйте выборку по ключевым словам вручную и указывайте долю нерелевантных записей. Корпус ISAAC (arXiv:2609.27059), опубликованный 22 сентября, включает более 527 млн постов Reddit. Его авторы использовали многоэтапный фильтр с проверкой людьми, чтобы удержать долю нерелевантного контента ниже 10%, и приводят эту долю для каждой группы. Без такого шага выборка «обсуждение DSA в Reddit» может состоять в основном из рекламы казино.
Одна запись, два эндпоинта, два разных числа
В исследованиях лайки, просмотры или комментарии часто служат зависимыми переменными или весами. 24 октября с 12:16 до 12:21 мы сравнили счётчики в результатах поиска со счётчиками из эндпоинтов для отдельных записей:
- YouTube: для видео, опубликованного в июне 2026 года, поиск показал 4 650 лайков. В 12:19 YouTube Video Details API показал 4 600. Просмотры (48 406) и комментарии (590) совпали и не изменились к 14:18. Разница в лайках объясняется точностью отображения, а не реальным изменением.
- TikTok: для видео о климате, которое The Guardian опубликовал 23 октября, поиск в 12:17 показал 671 900 просмотров, 90 300 лайков и 3 068 комментариев. В 12:19 TikTok Video Details API показал 673 500, 90 500 и 3 074. За две с половиной минуты просмотров стало больше на 1 600. У этого видео просмотры и лайки были округлены до сотен, а комментарии были точными. В 14:17 мы проверили снова: 767 600 просмотров, 101 600 лайков и 3 402 комментария. За два часа просмотры выросли примерно на 14%.
- X: мы проверили пост Европейской комиссии от 31 августа о присвоении статусов. Поиск и X (Twitter) Post Details API показали одно и то же: 6 523 789 просмотров и 4 668 лайков. В 14:17 просмотров было 6 523 800, а лайков по-прежнему 4 668. Последние две цифры превратились в 0. Это может быть округление, а может быть 11 новых просмотров. По одной записи этого не определить, поэтому фиксируйте и точность каждого счётчика.
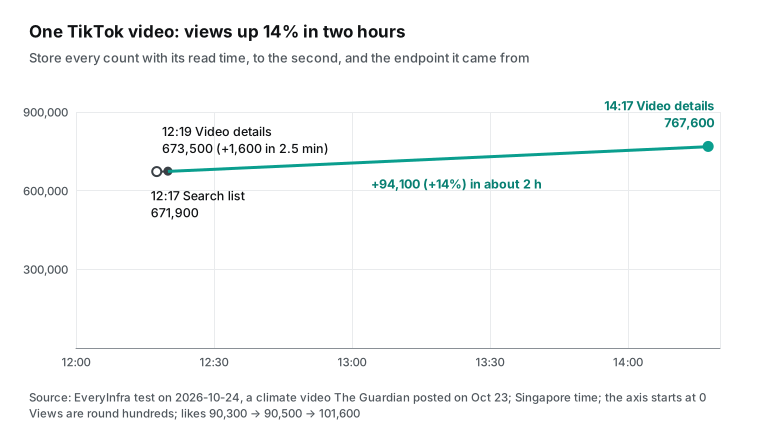
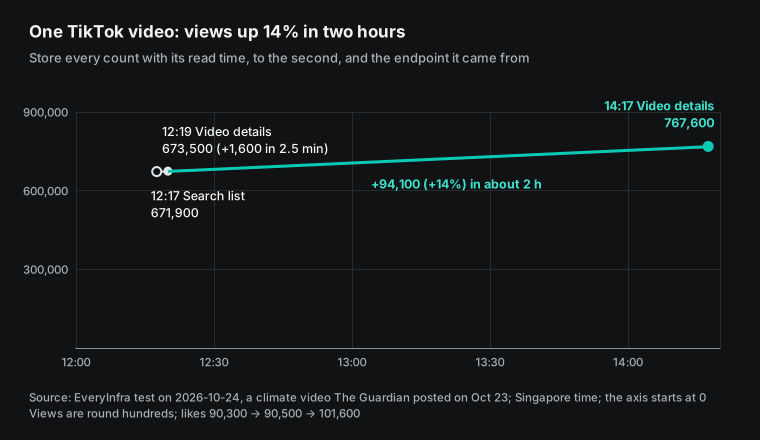
Поэтому вместе с каждым значением сохраняйте два факта: время его получения с точностью до секунды и эндпоинт, который вернул это значение. Показатели новых постов быстро растут в первые дни. Не сравнивайте утреннее значение с дневным за тот же день так, будто они равны.
Дубликаты и репосты: один аккаунт, четыре поста за девять минут
Из 25 нерелевантных постов Reddit 4 опубликовал один аккаунт. Он разместил их в 4 разных сообществах за 9 минут (03:39–03:48 UTC). Тексты почти совпадали: коэффициент Жаккара по 5-словным шинглам составил 0,93–0,99. Другой аккаунт опубликовал 3 рекламных объявления о казино в 3 не связанных между собой сообществах.
Если ваш вопрос — «сколько людей обсуждают эту тему», считайте эти 4 поста одним голосом. Если вопрос — «как контент распространяется между сообществами», именно эти посты и есть нужный вам сигнал. Мы предлагаем такой метод:
- Нормализуйте текст: удалите ссылки и пунктуацию, приведите его к нижнему регистру.
- Отмечайте пары почти дубликатов, если коэффициент Жаккара по 5-словным шинглам 0,6 или выше.
- По автору и временному окну (например, один автор в пределах 1 часа) отделяйте репосты, кросспосты и спам.
- Указывайте размер выборки до и после удаления дубликатов.
Та же логика применима к записям о заведениях в Google Maps: ID платформы говорит о том, что запись существует. Но он не говорит о том, что запись — независимый голос или отдельный объект.
Удаления и видимость: выборки сокращаются
К тому же контент исчезает. Авторы удаляют посты, платформы удаляют их сами, аккаунты закрываются или становятся приватными.
- Датасет PoliTok-DE (arXiv:2509.15860) Ruiz и соавторов содержит более 930 000 постов TikTok, связанных с двумя выборами в Германии. Более 330 000 из них позже были удалены: 18,7% выборки по Саксонии и 39,7% федеральной выборки. В федеральной выборке примерно две трети публикаций были удалены самими авторами.
- Zubiaga (2018, JASIST) повторно собрал 30 датасетов Twitter, в которых было более 147 млн твитов. Чем старше был датасет, тем меньшая его доля оставалась доступной. Метаданные, например число подписчиков, со временем тоже становились менее репрезентативными.
При этом условия платформ требуют от исследователей удалять данные:
- Документ «TikTok Research Tools Terms» действует с 22 января 2026 года. Исследовательские данные нужно обновлять не реже чем раз в 30 дней. При каждом обновлении нужно удалять данные, которые больше недоступны. Проверенные исследователи по DSA могут объяснить в своей заявке, почему такие правила помешают их исследованию.
- Согласно «X Developer Policy», хранимый контент X должен соответствовать его текущему состоянию в X. Если контент в X меняется, обновите и сохранённую копию. Сделайте это, как только появится разумная возможность, либо не позднее чем через 24 часа после получения запроса. Академические исследователи могут передавать ID постов для некоммерческих исследований, письменно одобренных X, или для рецензирования.
- Правило 8 Reddit, процитированное выше, запрещает приложениям продолжать использовать удалённый публичный контент.
Возникает конфликт: для воспроизводимости нужна исходная выборка, а условия платформ и защита приватности требуют удаления.
Обзор 2026 года в Political Communication называет «ограничения на обмен данными для репликации» одной из первых проблем статьи 40. Рабочий подход: публикуйте список ID, параметры запросов, время сбора и агрегированную статистику. Полные тексты храните только в контролируемой среде и удаляйте так, как требуют условия. При каждом повторном сборе указывайте долю записей, которые ещё удаётся получить. Считайте долю удалений одним из результатов своей работы. Не подменяйте выборку незаметно.
Смещение выборки: исследовательские интерфейсы тоже показывают лишь часть
Многие считают, что собственный исследовательский интерфейс платформы отдаёт полные данные. Недавние аудиты этого не подтверждают:
- В работе arXiv:2601.12390 Бекавац и Майер полностью восстановили ленты двух контролируемых тестовых аккаунтов во время выборов. Они сравнили эти ленты с данными, которые TikTok Research API и Meta Content Library возвращают по тем же публикациям. Исследовательские интерфейсы не включали примерно до 50% контента, который видели пользователи, и удаляли примерно до 83% контекстных метаданных. Один из лимитов составлял всего около 1 000 запросов в неделю.
- На странице Meta Content Library указано ограничение для личных аккаунтов: их посты включаются, только если аккаунт верифицирован или у него 100 и более подписчиков. По правилам сервиса небольшие личные аккаунты в выборку не попадают.
- В работе WhichTok (arXiv:2608.09917), опубликованной 10 августа, сравнили три инструмента сбора данных TikTok: TikTok Research API и два веб-инструмента. Наибольшие расхождения дали поиск по хештегам и по ключевым словам. Согласованные результаты во всех трёх дал только эндпоинт пользователя.
- В 2025 году в исследовании arXiv:2506.09746 проверили видео из наборов данных, предоставленных пользователями. Примерно для каждого восьмого видео TikTok Research API не вернул метаданных, в том числе для собственных видео и рекламы TikTok.
- Проблема не нова. Morstatter и соавторы (2013) сравнили выборочный Streaming API Twitter с полным Firehose. В работе Pfeffer и соавторов (2023) 80 учёных собрали все 375 млн твитов за 24 часа начиная с 21 сентября 2022 года. Этот датасет служит эталоном для последующих исследований.
Поэтому для каждого способа получения данных записывайте, что он упускает. По возможности проверяйте часть выборки вторым, независимым способом. Наша проверка «поиск против сведений о записи» выше — недорогой пример такой проверки.
Временные окна: «недавнее» везде понимают по-разному
Временной диапазон поиска по ключевым словам часто выбираете не вы:
- Согласно каталогу, поиск по ключевым словам в Reddit охватывает последний месяц, и порядок сортировки этот диапазон не меняет.
- В нашем прогоне A в X использовался
latest, но 25 постов были опубликованы с августа 2024 по октябрь 2026 года (5 — в 2024, 11 — в 2025, 9 — в 2026). - 25 результатов YouTube в порядке релевантности опубликованы в 2020–2026 годах.
Для временного ряда не используйте поиск по релевантности как замену «всего обсуждения за период». Собирайте данные по сообществу, аккаунту или каналу и фильтруйте по posted_at. Или используйте собственный синтаксис дат платформы в ключевом запросе X (в примечании каталога к twitter/search перечислен синтаксис вроде since:). В разделе о методах укажите реальные даты начала и конца периода, который охватывают ваши данные.
Статья 40 DSA: как обстоят дела спустя год
Статья 40 Закона о цифровых услугах даёт исследователям два пути:
- Статья 40(12), публичные данные. VLOP и VLOSE обязаны «без неоправданной задержки» предоставлять доступ к данным, которые публично доступны в их интерфейсе, «в том числе, когда это технически возможно, к данным в реальном времени». Норма распространяется и на исследователей, «аффилированных с некоммерческими органами, организациями и объединениями». 5 декабря 2025 года Комиссия наложила на X первый штраф по DSA — €120 млн. Одно из нарушений — «непредоставление исследователям доступа к публичным данным». Tech Policy Press кратко излагает решение: X запрещала независимым исследователям доступ, в том числе через парсинг, а её квоты и сроки доступа были слишком ограниченными.
- Статья 40(4): непубличные данные. Проверенные исследователи подают заявки через координатора цифровых услуг (DSC) своей страны. Правила изложены в Делегированном регламенте (ЕС) 2025/2050, который применяется с 29 октября 2025 г. Заявки подаются через портал доступа к данным DSA. У DSC есть до 80 рабочих дней, чтобы направить обоснованный запрос. Платформы обязаны публиковать и обновлять каталоги данных. Полный текст опубликован на странице делегированного акта Еврокомиссии. Ирландский DSC опубликовал версию 2 своего руководства в мае 2026 г.
Текущее положение дел по свежим первоисточникам:
- Ирландский DSC отклонил запрос AlgorithmWatch через 80 рабочих дней после подачи. Причины: недостаточно подробностей о хранении данных и кибербезопасности, а также нет объяснения, почему объём данных соразмерен. После повторной подачи пришлось ждать ещё 80 рабочих дней. В рамках статьи 40(12) около 20 организаций запросили у шести платформ 1 000 самых просматриваемых публикаций в каждом государстве-члене каждые шесть часов. Переговоры начались в октябре 2025 г., и пока ни одна платформа не согласилась (DSA Observatory, 2 октября).
- В статье ICWSM 2026 «The Great Data Standoff» сформулирована ключевая проблема. Исследователи должны указать, какие данные им нужны. Но они не могут знать, какими данными располагают платформы. Taylor Annabell из Кардиффского университета анализирует опубликованные каталоги данных в Media, Technology and Governance (2026). По её мнению, платформы сужают понятие «данные» до заранее заданных агрегированных наборов.
- Smart Data Research UK профинансировала рабочую группу Social Platforms Data Access Taskforce. Её итоговый отчёт вышел 9 сентября, а 6 октября был размещён в репозитории. В нём собраны данные за год о барьерах, с которыми сталкиваются исследователи.
- У данных о прозрачности платформ тоже есть ограничения. Согласно arXiv:2610.26226 (19 октября), более 99,8% решений в DSA Transparency Database ссылаются на собственные правила платформы, а не на норму закона.
Что это значит для дизайна исследования: путь через статью 40 стоит пройти, но он занимает годы, а не недели. Пока вы ждёте, исследования на публичных данных должны ещё яснее описывать полноту выборки. Рецензенты спросят, насколько ваша выборка отличается от реальной ленты платформы.
Этика исследований и правила платформ
Это методические замечания, а не юридическая консультация:
- Сначала пройдите этическую экспертизу. В этой области принято опираться на «AoIR Internet Research Ethical Guidelines 3.0». Публичность данных не означает, что их можно свободно использовать. Оценивайте риски для авторов с учётом контекста, особенно когда речь идёт о здоровье, сексуальности и политических взглядах.
- Собирайте только необходимое. Храните только те поля, которые нужны для вашего исследовательского вопроса. Перед анализом заменяйте имена пользователей личных аккаунтов односторонними хешами. Не цитируйте фразы, по которым читатель сможет найти исходную публикацию поиском. В этой статье не упоминается ни один личный аккаунт.
- Удаляйте данные, когда этого требуют правила. Настройте регулярный повторный сбор и удаление и фиксируйте, сколько данных вы удалили.
- Проверяйте сферу действия каждого набора правил. Правила для исследователей ограничивают регион, цель и круг тех, кто может подать заявку. Оба пути по статье 40 DSA предназначены только для исследований системных рисков в ЕС. Укажите в разделе о методах, каким путём и по каким правилам вы получили данные.
- Публикуйте то, что другие смогут проверить. Обычно можно публиковать списки ID, параметры запросов, время сбора, агрегированные результаты и код. С полными текстами обращайтесь так, как требуют правила.
Чек-лист для выборки, которую смогут проверить другие


- Запишите критерии. До сбора задайте порог пересечения и максимальную долю нерелевантных записей. Решите, как вы будете сообщать об удалениях.
- Зафиксируйте параметры. Укажите ключевое слово, порядок сортировки, число записей, язык и регион в конфигурационном файле. Храните его в системе контроля версий.
- Сохраняйте сырые ответы. Храните полный JSON каждого вызова вместе с ID запроса. Добавляйте время получения с точностью до секунды и указывайте часовой пояс.
- Собирайте данные несколько раз. Выполняйте каждый запрос минимум дважды. Указывайте объединение, пересечение и коэффициент Жаккара. Для нестабильных эндпоинтов используйте в качестве выборки объединение.
- Проверяйте релевантность вручную. Разметьте 50–100 случайных записей и укажите долю нерелевантных. Перед сопоставлением текста нормализуйте хештеги.
- Удаляйте дубликаты. Используйте нормализованный текст, сходство шинглов, автора и временное окно. Указывайте размер выборки до и после.
- Сверяйте счётчики. Перепроверьте часть записей через эндпоинт для одной записи. Указывайте, из какого эндпоинта и на какой момент получен каждый счётчик.
- Собирайте повторно и удаляйте. Повторно собирайте данные с периодичностью, заданной правилами. Фиксируйте долю ещё доступного контента и удаляйте тот, что больше не виден.
Воспроизведите этот тест с помощью EveryInfra
Это запрос прогона A для X. Замените <API Key> своим ключом (см. Быстрый старт):
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer <API Key>" \
  -H "Content-Type: application/json" \
  -d '{"platform":"twitter","action":"search","params":{"keyword":"\"Digital Services Act\"","sort":"latest","limit":25}}'
На верхнем уровне ответа есть id (ID запроса), count, results и billing. Для теста на воспроизводимость полезны следующие поля результатов (названия полей сверяйте с каталогом возможностей):
id: ID записи на платформе. Используйте его для расчёта пересечения и дедупликации.url: ссылка на исходную публикацию для повторного сбора и ручной проверки.posted_at: время публикации (UTC). По нему можно понять, является ли новая запись новой публикацией.text,title: текст и заголовок (заголовки есть у Reddit и YouTube) для проверки релевантности и поиска почти дубликатов.hashtags: учитывайте их при проверке релевантности для TikTok и X.like_count,view_count,comment_count: счётчики. Всегда сохраняйте их вместе со временем получения.author_username: автор; поле нужно для дедупликации публикаций одного автора в заданном временном окне. Перед анализом хешируйте его.community: название сообщества Reddit, чтобы находить кросс-посты.search_rank: позиция в поиске YouTube для расчёта пересечения топ-10.
В ИИ-клиентах вроде Claude или Cursor те же данные можно подключить через MCP. Тогда ассистент сможет пройти чек-лист выше. Для других клиентов см. страницу удалённого MCP-сервера:
export EVERYINFRA_API_KEY="<API Key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user \
  --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
Затем вызовите everyinfra_call_api с теми же параметрами, что и в запросе curl. Через everyinfra_requests можно посмотреть списание по каждому ID запроса.
Ошибки и списания:
unauthorized: ключ не передан или недействителен. Без списания.unknown_paramили недопустимое значение: неверное имя параметра или значение enum. В ответе перечислены допустимые параметры и приведён пример. Без списания.- Пустой результат: например, ключевое слово в кавычках, по которому за этот месяц нет публикаций. Вы получаете пустой список, а предварительно списанная сумма возвращается.
- Возможность временно недоступна: об этом сообщается в ответе. Без списания.
Чтобы проверить возвраты средств по каждому запросу, см. сверку биллинга API. О том, почему возможности и параметры нужно сверять с живым каталогом, читайте в статье «Живой каталог возможностей».
Стоимость: месяц мониторинга стабильности
Согласно каталогу возможностей на 24 октября, reddit/search, twitter/search, youtube/search и tiktok/search стоят $0,000556 за вызов. Эндпоинты для одной записи youtube/video, tiktok/video и twitter/post тоже стоят $0,000556 за вызов (ориентируйтесь на страницу «Тарифы»):
- 4 платформы, 5 ключевых слов на платформу, один вызов каждые 6 часов, 25 записей за вызов, в течение 30 дней: 4 × 5 × 4 × 30 = 2 400 вызовов × $0.000556 = $1.33.
- Раз в неделю в течение 4 недель перепроверяйте счётчики 100 записей через эндпоинты для одной записи: 400 вызовов × $0,000556 = $0,22.
- Итого: около $1,56. Пустые результаты и неудачные вызовы не оплачиваются, поэтому реальная стоимость может быть только ниже.
Все реальные вызовы для этой статьи (три поисковых прогона, проверки отдельных записей, поиск по Reddit с кавычками и четыре веб-поиска, которые мы не использовали в тексте) в сумме стоили $0,015008 (26 вызовов).
Последние изменения (сентябрь–октябрь 2026 года)
- 30 сентября: Reddit публикует график закрытия публичного API данных (r/redditdev). Для исследователей: скрипты, использующие публичный API Reddit, нужно до марта 2027 года перевести на исследовательскую программу Reddit, коммерческое соглашение или путь через DSA. Задокументируйте имеющиеся выборки уже сейчас.
- 1 октября: Reddit обновляет страницу о DSA (Reddit Help). В первой половине 2026 года у Reddit было не более 57,2 млн среднемесячных активных получателей услуг в ЕС. Для исследователей: обязанности Reddit как VLOP вступают в силу в январе 2027 года, так что запрос по статье 40(12) можно готовить уже сейчас.
- **1 октября: Pote, Flammini и Menczer публикуют arXiv:2610.02591.** Они изучили метаданные приложений из 43 операций влияния, которые удалила X. API входят в инфраструктуру скоординированной манипуляции. Авторы также выяснили, что, удалив метаданные на уровне приложений, X лишила исследователей важного инструмента обнаружения. Для исследователей: когда платформа убирает одно поле, целое направление исследований может стать невоспроизводимым. Сохраняйте сырые ответы.
- **29 сентября: в arXiv:2609.38571 проводится аудит ИИ-маркировки на четырёх платформах.** Авторы собрали 10 722 публикации по ключевым словам, связанным с системными рисками и ИИ. Метка платформы была лишь у 33% дипфейков, выявленных экспертами. Для исследователей: это ещё одна доля, полученная из выборки по ключевым словам, поэтому знаменатель задаёт список ключевых слов.
- 2–6 октября: новые исследования на больших выборках с платформ. arXiv:2610.09082 отслеживает вред от ИИ по 5,7 млн сводок публикаций Reddit за 18 месяцев. Два ирландских исследования о наводнениях (arXiv:2610.03334, arXiv:2610.06330) используют запросы по ключевым словам в Meta Content Library. Для исследователей: чем подробнее описание выборки, тем надёжнее результаты.
- **21 октября: авторская колонка в Tech Policy Press.** Jen Rosiere Reynolds пишет, что исследования рисков ИИ теперь сталкиваются с той же проблемой доступа к данным, что и исследования соцсетей.
FAQ
Можно ли по-прежнему использовать API Reddit для академических исследований? (подсказка Google: «reddit api for academic research») В посте Reddit от 30 сентября названы две даты. Приём новых заявок на публичный API закрывается 31 октября 2026 года. Публичный доступ прекращается в марте 2027 года. В комментариях один разработчик советует тем, у кого нет доступа к API, проверить, подходят ли им Devvit или исследовательская программа. Reddit теперь VLOP, поэтому с января 2027 года обязан предоставлять исследователям доступ к данным по статье 40 DSA. Если у вас идёт проект, зафиксируйте описание выборки и журналы сбора уже сейчас.
Публикации из моего исследовательского датасета удалили. Что делать? (подсказка Google: «deleted tweets research dataset») Правила платформ обычно требуют удалить их и у себя. TikTok требует обновлять данные не реже чем раз в 30 дней и удалять недоступные. X требует удалить или обновить вашу копию вскоре после изменения. Для воспроизводимости публикуйте ID, параметры и агрегированную статистику, а при повторном сборе указывайте долю данных, которую ещё удаётся получить. Долю удалённого приводите как результат.
Кто может подать заявку по статье 40 DSA? (подсказка Google: «dsa article 40 researchers») Статья 40(4) предназначена для исследователей, которые работают в исследовательской организации и независимы от коммерческих интересов. Они должны соответствовать требованиям к безопасности и конфиденциальности данных. Заявки подаются через координатора цифровых услуг.
Статья 40(12) о публичных данных прямо распространяется на исследователей, связанных с некоммерческими учреждениями, организациями и объединениями. Оба пути предназначены только для исследований системных рисков в ЕС. По данным AlgorithmWatch, простой количественный запрос от НКО может пройти первичную проверку. Но нужно объяснить, почему объём данных соразмерен. Уточните в своей организации, соответствуете ли вы требованиям.
Читайте также
- Парсинг комментариев Reddit: MoreComments и replace_more в PRAW
- В API комментариев YouTube не хватает ответов: двухуровневая пагинация
- Страницы платформ: API для парсинга Reddit, API для парсинга X (Twitter), API для парсинга YouTube, API для парсинга TikTok
Источники
- «Moving Data API Apps to the Developer Platform: migration dates and next steps». Reddit (r/redditdev), 2026-09-30 (первичный источник). https://www.reddit.com/r/redditdev/comments/1wubcvf/moving_data_api_apps_to_the_developer_platform/
- «Reddit is killing RSS feeds, ending public API access because of AI bots». TechCrunch, 2026-09-30 (вторичный источник). https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/
- «Don't break the site (Rule 8)». Reddit Help, дата обращения: 2026-10-24 (первичный источник). https://support.reddithelp.com/hc/en-us/articles/360043512931-Don-t-break-the-site
- «Two Stories of DSA Data (Non)-Access from an NGO perspective». DSA Observatory (Oliver Marsh, AlgorithmWatch), 2026-10-02 (вторичный источник). https://dsa-observatory.eu/2026/10/02/two-stories-of-dsa-data-non-access-from-an-ngo-perspective/
- «Annual Report 2025». Coimisiún na Meán, 2026-10-07 (первичный источник). https://www.cnam.ie/app/uploads/Coimisiun-na-Mean-Annual-Report-2025.pdf
- «Commission designates ChatGPT, Reddit, Roblox under DSA» (IP/26/1772). Европейская комиссия, 2026-08-31 (первичный источник). https://ec.europa.eu/commission/presscorner/detail/en/ip_26_1772
- «Social data capability catalog». EveryInfra, дата обращения: 2026-10-24 (первичный источник). https://api.everyinfra.com/api/v1/social/catalog
- «Search: list» (YouTube Data API). Google for Developers, дата обращения: 2026-10-24 (первичный источник). https://developers.google.com/youtube/v3/docs/search/list
- «The Illinois Social Attitudes Aggregate Corpus (ISAAC)» (arXiv:2609.27059). Hemmatian и др., 2026-09-22 (первичный источник). https://arxiv.org/abs/2609.27059
- «PoliTok-DE: A Multimodal Dataset of Political TikToks and Deletions From Germany» (arXiv:2509.15860). Ruiz и др., 2025-09-19 (первичный источник). https://arxiv.org/abs/2509.15860
- «A longitudinal assessment of the persistence of Twitter datasets» (JASIST). Zubiaga, 2018 (первичный источник). https://doi.org/10.1002/asi.24026
- «TikTok Research Tools Terms of Service». TikTok, 2026-01-22 (первичный источник). https://www.tiktok.com/legal/page/global/terms-of-service-research-api/en
- «Developer Policy». X, дата обращения: 2026-10-24 (первичный источник). https://developer.x.com/en/developer-terms/policy
- «Finally, Access: How Article 40 DSA Changes Platform Research in Practice» (Political Communication). Taylor & Francis, 2026 (первичный источник). https://doi.org/10.1080/10584609.2026.2664157
- «Platforms' Research API Data Access: What Users See vs. What Researchers can Retrieve» (arXiv:2601.12390). Bekavac, Mayer, 2026-01-18 (первичный источник). https://arxiv.org/abs/2601.12390
- «Meta Content Library and API». Meta Transparency Center, дата обращения: 2026-10-24 (первичный источник). https://transparency.meta.com/researchtools/meta-content-library/
- «WhichTok? Comparing Three TikTok Data Acquisition Tools» (arXiv:2608.09917). Jeon и др., 2026-08-10 (первичный источник). https://arxiv.org/abs/2608.09917
- «TikTok's Research API: Problems Without Explanations» (arXiv:2506.09746). arXiv, 2025-06-11 (первичный источник). https://arxiv.org/abs/2506.09746
- «Is the Sample Good Enough? Comparing Data from Twitter's Streaming API with Twitter's Firehose» (arXiv:1306.5204). Morstatter и др., 2013-06-21 (первичный источник). https://arxiv.org/abs/1306.5204
- «Just Another Day on Twitter: A Complete 24 Hours of Twitter Data» (arXiv:2301.11429). Pfeffer, Matter, Jaidka и др., 2023-01-26 (первичный источник). https://arxiv.org/abs/2301.11429
- «Regulation (EU) 2022/2065 (Digital Services Act)». EUR-Lex, 2022-10-19 (первичный источник). https://eur-lex.europa.eu/eli/reg/2022/2065/oj
- «Commission fines X €120 million under the Digital Services Act». Европейская комиссия, 2025-12-05 (первичный источник). https://digital-strategy.ec.europa.eu/en/news/commission-fines-x-eu120-million-under-digital-services-act
- «What the X Fine Reveals About Data Access Under Article 40 of the Digital Services Act». Tech Policy Press, 2026-02-12 (вторичный источник). https://www.techpolicy.press/what-the-x-fine-reveals-about-data-access-under-article-40-of-the-digital-services-act/
- «Digital Services Act – sharing platform and search engine data with vetted researchers» (краткое изложение Делегированного регламента (ЕС) 2025/2050). EUR-Lex, 2026-01-28 (первичный источник). https://eur-lex.europa.eu/EN/legal-content/summary/digital-services-act-sharing-platform-and-search-engine-data-with-vetted-researchers.html
- «DSA data access portal». Европейская комиссия, дата обращения: 2026-10-24 (первичный источник). https://data-access.dsa.ec.europa.eu/
- «Delegated act on data access under the Digital Services Act (DSA)». Европейская комиссия, 2025-07-02 (первичный источник). https://digital-strategy.ec.europa.eu/en/library/delegated-act-data-access-under-digital-services-act-dsa
- «DSA Article 40(4)–(11) Data Access Guidance, V2». Coimisiún na Meán, 2026-05 (первичный источник). https://www.cnam.ie/app/uploads/2026/05/DSA-Article-40-4-11-Data-Access_Guidance_V2_-.pdf
- «The Great Data Standoff: Researchers vs. Platforms Under the Digital Services Act» (ICWSM 2026). Goanta и др., 2026 (первичный источник). https://ojs.aaai.org/index.php/ICWSM/article/view/42671
- «Regulating a Floating Signifier: Interpretations of „Data“ in the DSA Researcher Access Provision» (Media, Technology and Governance). Annabell, 2026 (первичный источник). https://doi.org/10.1177/29777984261486601
- «Social Platforms Data Access Taskforce: Final Report». Smart Data Research UK / University of Sheffield, 2026-09-09 (размещён в репозитории 2026-10-06) (первичный источник). https://eprints.whiterose.ac.uk/id/eprint/246345/
- «Towards More Granular Reasoning: Mapping the DSA Transparency Database Taxonomy to Platform Terms and Conditions» (arXiv:2610.26226). Ranucci, Leijten, Graus, 2026-10-19 (первичный источник). https://arxiv.org/abs/2610.26226
- «Internet Research: Ethical Guidelines 3.0». Association of Internet Researchers (AoIR), 2019 (первичный источник). https://aoir.org/reports/ethics3.pdf
- «Digital Services Act (DSA): Information for EU users». Reddit Help, 2026-10-01 (первичный источник). https://support.reddithelp.com/hc/en-us/articles/23595536875796-Digital-Services-Act-DSA-Information-for-EU-users
- «Information Operations Exploit APIs to Manipulate Social Media» (arXiv:2610.02591). Pote, Flammini, Menczer, 2026-10-01 (первичный источник). https://arxiv.org/abs/2610.02591
- «Drowning in AI Slop: How Social Media Platforms (Do Not) Label AI and Deepfake Content under EU law» (arXiv:2609.38571). Rijsbosch и др., 2026-09-29 (первичный источник). https://arxiv.org/abs/2609.38571
- «Move Fast and Mend Things: Keeping Up with Evolving AI Harms Using Social Media Commentary» (arXiv:2610.09082). Rowe и др., 2026-10-06 (первичный источник). https://arxiv.org/abs/2610.09082
- «A population-level assessment framework for flood-related wellbeing from public discourse in Ireland» (arXiv:2610.03334). Luo, Morrissey, 2026-10-02 (первичный источник). https://arxiv.org/abs/2610.03334
- «Assessing flood-related wellbeing from public discourse in Ireland using large language model as judge, 2012–2025» (arXiv:2610.06330). Luo, Morrissey, 2026-10-05 (первичный источник). https://arxiv.org/abs/2610.06330
- «You Can't Solve AI Risk Without Solving the AI Evidence Problem». Tech Policy Press (Jen Rosiere Reynolds), 2026-10-21 (вторичный источник). https://www.techpolicy.press/you-cant-solve-ai-risk-without-solving-the-ai-evidence-problem
Справка BL-33