Iterable MCP y datos sociales públicos para segmentar
Iterable lanzó un MCP alojado el 2026-11-12. Arma journeys en Claude y, en el mismo turno, usa everyinfra_* para traer publicaciones y comentarios públicos.
Iterable lanzó un servidor MCP alojado el 12 de noviembre de 2026, en su Winter Product Launch. Con él, los marketers pueden armar journeys, previsualizar correos y revisar el rendimiento de campañas desde Claude, ChatGPT y Cursor (página de producto de Iterable; nota de BusinessWire, 2026-11-12). Ese servidor trabaja sobre los datos de clientes de tu propia cuenta de Iterable; no trae datos sociales públicos. El 2026-11-17 a las 00:19 hora de Singapur añadimos las herramientas everyinfra_* de EveryInfra al mismo cliente. Una llamada a tiktok/search devolvió 10 videos de cuidado de piel de invierno por 0,000556 USD, y una a xiaohongshu/search devolvió 20 notas por 0,005556 USD. Alimentamos esas publicaciones y comentarios públicos a la segmentación y a los textos, en la misma conversación. Las seis llamadas reales de este artículo costaron 0,013558 USD en total.
Este artículo tiene un solo tema. En una ventana de chat, armas el journey por un lado y traes señal social pública por el otro. Lo desglosa en pasos que puedes seguir. Los pasos cubren cómo se reparten el trabajo los dos servidores, cómo añadir everyinfra_* a Claude, ChatGPT o Cursor, qué envía y devuelve una ida y vuelta real, cómo los comentarios se vuelven segmentos y textos, cuánto cuesta cada paso y qué no puede hacer. Cada función de Iterable está referenciada a las páginas oficiales con fecha. Cada número de EveryInfra viene de una llamada real y cuadra contra el campo billing.
Dos servidores MCP, dos tareas: tus datos de clientes y las publicaciones públicas de otros
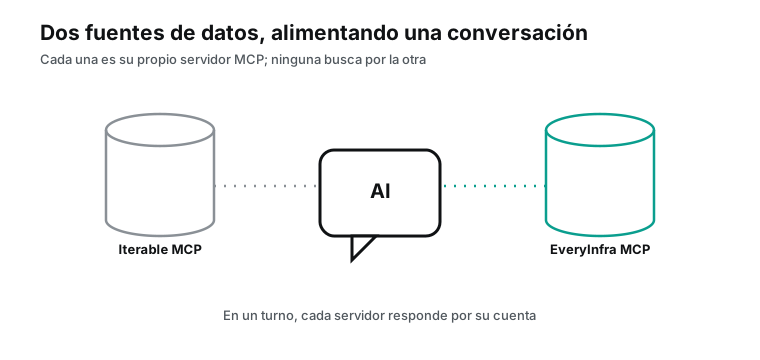
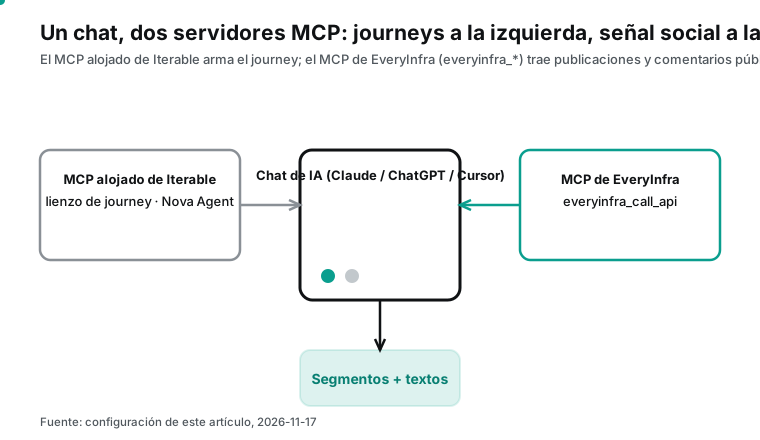
El reparto entre los dos servidores es la premisa de cada paso que sigue. El MCP alojado de Iterable se conecta a lo que vive en tu propia cuenta de Iterable: perfiles de usuario, listas, plantillas, journeys y rendimiento de campañas. Sus solicitudes pasan por el Nova Agent de Iterable. Así, cuando dices en Claude «lista mis campañas con peor rendimiento de la semana pasada», lee datos reales de tu cuenta (página de producto de Iterable). Ese servidor no rastreará una nota de Xiaohongshu ni un comentario de TikTok. No puede ver datos sociales públicos fuera de tu cuenta.
EveryInfra es un segundo MCP. Cubre la mitad que Iterable no alcanza: publicaciones, comentarios, productos y rankings públicos en plataformas. Expone 12 herramientas, con everyinfra_call_api en el centro. Detrás hay 106 plataformas y 574 capacidades de datos (catálogo de EveryInfra, leído el 2026-11-17). Ambos servidores hablan el Model Context Protocol, y ambos pueden añadirse al mismo cliente compatible con MCP. Pero cada uno usa su propia autenticación y devuelve sus propios datos, y ninguno busca por el otro. Los pones en una misma conversación por una razón: el marketing necesita ver a la vez quién está en tu lista y de qué habla la gente afuera. El catálogo abarca plataformas internacionales y chinas como Xiaohongshu y Douyin, lo que ayuda a las marcas transfronterizas, porque la misma preocupación se expresa distinto en cada plataforma.
Este es el escenario que el artículo reutiliza. Una marca de cuidado de piel directa al consumidor quiere un journey de recuperación de invierno. Quiere segmentar a los usuarios inactivos por preocupación de piel y luego escribir una apertura distinta para cada grupo. Tu historial de compra y aperturas vive en Iterable. Pero «qué le preocupa al usuario» vive en plataformas públicas. Algunos preguntan si la piel sensible puede usar el producto. Otros solo preguntan por el precio y el enlace. Lo primero lo lees con el MCP de Iterable, y lo segundo con xiaohongshu/comments y tiktok/comments, y ambas cosas coinciden en el mismo turno.
Un orden de prompts natural lo deja claro. Primero el modelo usa everyinfra_call_api para buscar un tema y traer comentarios, y los agrupa en tres a cinco preocupaciones. Luego convierte cada grupo en una condición de segmento y una apertura de correo. Después cambia a las herramientas de Iterable para armar la lista y dejar el journey en borrador según esas condiciones. El modelo pasa de «qué dice la gente afuera» a «cómo dividir y hablarle a mi propia lista» en un turno, sin cambiar de back office.
Esta combinación resuelve un problema viejo: de dónde salen las reglas de segmento. Segmentar por tasa de apertura o número de compras te da «activo contra inactivo». No te da «preocupado por qué». La preocupación solo vive en lo que la gente dice, y los comentarios públicos son la fuente de primera mano más barata para eso. EveryInfra trae esa capa de habla de forma estructurada. Iterable deposita los segmentos terminados en una lista real. Cada servidor hace la mitad en la que es bueno. El recorrido de abajo usa el escenario de invierno, y cada número viene de esta ronda de llamadas reales.
Pon «segmentar por conducta» y «segmentar por habla» lado a lado. Por conducta divides a los usuarios en abrieron en 30 días y no. Pero ambos montones tienen a quienes se quejan de sequedad y a quienes se quejan de grasa. El mismo correo de «cuidado de piel de invierno» rinde casi igual en ambos. Por habla primero aprendes las cinco preocupaciones de la categoría: hidratación, precio, acné, ingredientes y sensibilidad. Luego vuelves a tu cuenta y aproximas cada preocupación con campos que ya tienes, como «compró una crema» o «añadió al carrito sin pagar». Ahora cada apertura le habla a su propio dolor. La primera corta a la gente por estado. La segunda la corta por lo que quiere. Para recuperación, la segunda suele abrir y hacer clic mejor, porque la apertura toca la razón por la que la persona no compró. Los comentarios públicos aportan la capa de «qué quiere». Los campos de la cuenta aportan la capa de «esta persona califica». Necesitas ambas.
Este camino tiene un límite duro, que trata la sección de límites. La gente en los comentarios públicos no es la gente de tu lista. Así que los comentarios te dicen cuántas preocupaciones tiene una categoría y qué le importa a cada una. No te dicen a qué preocupación pertenece tu usuario concreto. Eso todavía depende de su conducta en tu cuenta. Confundir las dos cosas es el error más fácil de este método.
Qué lanzó Iterable el 2026-11-12: MCP alojado, SDK con IA, Integrations Hub
El Winter Product Launch tiene tres partes, todas con fecha del 12 de noviembre de 2026. El titular es el servidor MCP alojado. Las solicitudes de Claude, ChatGPT y Cursor pasan por Nova Agent, que puede armar y dejar en borrador journeys, previsualizar y probar correos, y revisar el rendimiento de campañas. El lienzo del journey y la vista previa del correo se muestran dentro del chat (página de producto de Iterable; nota de BusinessWire). La segunda parte son los SDK asistidos por IA, con guías por versión para iOS, Android y React Native. La tercera parte casi triplica el Integrations Hub, con HubSpot, Stripe, Chargebee, Recurly, BigCommerce, TikTok Ads y más (notas de versión 2026).
La parte del Integrations Hub es directamente relevante para segmentar. Stripe y Recharge traen suscripciones, cobros y renovaciones a los perfiles de usuario, así que un cobro fallido puede disparar al instante un journey de recuperación. Del lado de publicidad, nuevas sincronizaciones envían audiencias a Reddit Ads, Snapchat Ads, Microsoft Advertising y ChatGPT Ads, usando correos con hash, y el marketer puede sumar o excluir audiencias dentro de un journey (reporte de TechEdgeAI, según el anuncio de Iterable). Es decir, Iterable conecta cada vez más eventos dentro de la cuenta. Pero esos siguen siendo señales dentro de la cuenta. Cómo habla la gente fuera de tu cuenta todavía necesita un segundo servidor. El Winter release también añade una vista previa de resumen de correo por IA: antes de enviar, ves cómo una IA de bandeja podría resumir tu correo, y lo corriges si el mensaje principal queda enterrado. Eso subraya algo más: si un texto funciona depende cada vez más de cómo lo lee el otro, y los comentarios públicos son una muestra lista de cómo el otro lee este tipo de producto.
La parte del SDK con IA no trata directamente de traer datos públicos. Pero deja un punto útil para cualquier conexión por MCP. Trae guías por versión para iOS, Android y React Native, y en Claude Code, Cursor y Codex ayuda al desarrollador a llegar a un primer mensaje verificado en menos de una hora. Iterable subraya una cosa: que el código compile no es lo mismo que la integración funcione bien en un dispositivo real, así que la guía te lleva hasta un mensaje realmente enviado (reporte de TechEdgeAI). El mismo criterio aplica del lado de datos: una respuesta 200 no significa que el dato sea correcto, y por eso aquí cada paso lee billing y los campos de respuesta. Iterable también dice que el desarrollador aún revisa el código generado y hace a mano pasos sensibles como generar la API Key y registrar la app; una herramienta de IA acelera el control, no lo elimina.
La página de producto de Iterable cita a un cliente que vale la pena mencionar: un equipo con 40 millones de usuarios en 14 idiomas dice que localizar una campaña antes implicaba mandar el inglés a traductores y pegar las traducciones de vuelta en Iterable, lo que tomaba días; con Iterable MCP le piden a Claude que localice una campaña, y este trae el contenido de Iterable, localiza idioma por idioma, confirma la terminología y lo empuja de vuelta, en unos dos minutos (página de producto de Iterable). Ese tipo de trabajo es en lo que Iterable MCP es bueno: actúa sobre tus propios datos. La otra mitad —traer también en el mismo turno las preocupaciones de afuera desde plataformas públicas— es lo que aporta EveryInfra.
Alojado y autoalojado son dos cosas distintas, y eso cambia cómo conectas EveryInfra. Iterable primero lanzó un MCP autoalojado de código abierto el 2025-11-19, que corre en tu propia máquina con una API Key personal y llama a la API de Iterable directamente (README de Iterable/mcp-server). La versión alojada la opera Iterable, se instala desde el directorio de conectores de cada cliente, cada persona entra con su propia cuenta de Iterable incluido SSO corporativo, el agente queda limitado a los permisos de esa persona, y no hay claves compartidas que gestionar. Ambas siguen: los equipos usan la alojada por comodidad, los desarrolladores mantienen la autoalojada por el acceso directo a la API.
Ten clara la cronología. El anuncio es del 2026-11-12. Pero el Winter release completo llega a las cuentas alrededor del 2026-12-02, según la comunidad de producto de Iterable, y el MCP alojado está disponible antes como prueba a través de los representantes de cuenta (reporte de TechEdgeAI). Así que esto es un lanzamiento más un despliegue, no toda capacidad disponible ese día. La parte de «añadir EveryInfra» no depende de que el conector alojado de Iterable haya llegado a tu directorio: se sostiene con la versión autoalojada y con cualquier cliente compatible con MCP.
| Punto | MCP alojado de Iterable | MCP autoalojado de Iterable |
|---|---|---|
| Ingreso | Tu cuenta de Iterable, con SSO | API Key personal |
| Dónde corre | Operado por Iterable | Tu máquina, instalado desde GitHub |
| Las solicitudes pasan por | Nova Agent | Llamadas directas a la API |
| Instalación | Directorio de conectores de cada cliente | npx @iterable/mcp |
| Lanzamiento | Anuncio 2026-11-12 | Código abierto 2025-11-19 |
Los interruptores de permisos de la versión autoalojada están bien explicados, y eso importa para una cuenta de marketing. Es de solo lectura por defecto, sin datos personales (PII), sin escrituras y sin envíos. Habilitar escrituras y envíos requiere --advanced en la instalación, y el README avisa del riesgo: habilitarlos deja que el agente mande mensajes a usuarios reales y borre datos, así que debes revisar cada paso (README de Iterable/mcp-server, permisos). EveryInfra solo lee datos públicos, no toca a tus usuarios y no tiene ese riesgo. Pero el presupuesto lo controlas tú, como trata la sección de costos.
Añade everyinfra_* al mismo cliente: Claude, ChatGPT, Cursor
El endpoint del MCP remoto de EveryInfra es https://api.everyinfra.com/mcp, con autenticación Bearer y una API Key. No interfiere con el conector de Iterable: corre ambos en el mismo cliente, y la conversación puede llamar a las herramientas de Iterable y a everyinfra_*. Los tres clientes lo añaden de forma algo distinta, todos desde sus propios ajustes.
En Claude, abre Settings, luego Connectors, elige Add custom connector, ingresa un nombre y la URL del servidor, y completa la autenticación cuando se pida (doc de conectores de Claude). En ChatGPT, activa el developer mode en ajustes, y desde Connectors elige Add custom MCP server e ingresa nombre y URL (centro de ayuda de OpenAI). En Cursor, gestiona los servidores MCP desde la página Customize o el archivo de configuración (doc de MCP de Cursor). El Model Context Protocol también tiene una guía general para conectar servidores remotos (conectar a servidores MCP remotos).
| Cliente | Entrada | Añadir un MCP propio | Doc |
|---|---|---|---|
| Claude | Settings → Connectors | Add custom connector, ingresa URL, pasa la autenticación | support.claude.com |
| ChatGPT | Ajustes → developer mode → Connectors | Add custom MCP server, nombre y URL | help.openai.com |
| Cursor | Página Customize o archivo de config | Añade un servidor MCP, ingresa URL | cursor.com/docs/mcp |
| Clientes con mcpServers | Archivo de config | Escribe ambos servidores | modelcontextprotocol.io |
¿Tu cliente lee una configuración JSON mcpServers? Claude Desktop, Cursor y muchos clientes MCP lo hacen. Entonces escribe ambos servidores. Expande la clave desde una variable de entorno y mantenla fuera del archivo:
{
  "mcpServers": {
    "iterable": {
      "command": "npx",
      "args": ["-y", "@iterable/mcp"]
    },
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
En Claude Code, añade el MCP remoto con un comando de alcance de proyecto en una línea, para que un equipo comparta una configuración y cada quien guarde su propia clave:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
Después de eso, la conversación gana herramientas como everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job. Con ambos servidores presentes, el modelo decide a cuál llamar. «Cuántos usuarios llevan inactivos más de 60 días» va a Iterable; «de qué se queja la gente bajo el tema de piel seca de invierno» va a everyinfra_call_api. Pon ambas frases en un turno, y el modelo fija la regla de segmento con la señal pública y luego arma la lista en Iterable. Con muchas herramientas, el modelo a veces elige el servidor equivocado. Para una tarea de solo traer datos, en un cliente que admita una lista blanca de herramientas, dale a EveryInfra solo everyinfra_call_api y everyinfra_get_job. Eso ahorra espacio de conversación y quita una oportunidad de elegir mal. Los clientes difieren en cómo permitir herramientas MCP; para Claude Code, mira el doc de MCP y el doc de permisos.
Cómo se ve en un turno del chat
Pon este trabajo en un turno. Corre más o menos así, y cada paso corresponde a una llamada real. El marketer escribe una petición: «Hago cuidado de piel y quiero segmentar usuarios inactivos por preocupación de invierno. Primero mira de qué habla la gente bajo piel seca de invierno, agrúpalo, y escribe una apertura de recuperación por grupo.» El modelo primero llama a everyinfra_call_api para xiaohongshu/search, obtiene 20 notas, nota que la segunda no es la de más likes pero tiene 2.121 comentarios, y la elige para traer comentarios. Llama una vez a xiaohongshu/comments y obtiene 15, y ve líneas como «¿la piel sensible puede usarlo?» y «tengo piel seca y es muy hidratante» (traducidas del chino). Para no depender de una sola plataforma, también llama a tiktok/search y tiktok/comments, trae 20 comentarios del video más visto, y suma 35 en total.
El modelo luego agrupa en cinco preocupaciones los 14 comentarios claros de los 35 y reporta: seca/hidratación 5, precio 4, acné/grasa 2, ingredientes 2, sensible 1, cada una con una o dos líneas de ejemplo; los otros 21 —verificaciones de autenticidad, elogios genéricos y charla— quedan fuera. El marketer acepta y dice «escribe una apertura por grupo, con condiciones sobre campos que tengo en mi cuenta», y el modelo convierte cada preocupación en una condición de segmento más una línea de texto, que es la tabla de más abajo. Por último el marketer dice «cambia a Iterable, revisa el primer correo de recuperación según el grupo seca/hidratación, guarda como borrador, no lo envíes», y el modelo llama a las herramientas de Iterable para armar el segmento, editar la plantilla y detenerse antes de enviar. Todo sin salir de la ventana de chat, y cuando sort salió mal una vez, el modelo leyó el 422 did_you_mean y reenvió solo.
Las cuatro llamadas a EveryInfra de este recorrido son reales; los conteos de grupos y las citas vienen de respuestas reales. Las acciones del lado de Iterable siguen las páginas oficiales; esta máquina no conectó una cuenta de Iterable para correrlas en vivo, así que esos pasos son ejemplos de configuración, no mediciones.
Por qué pasar por MCP en vez de escribir scripts
Alguien preguntará algo razonable. ¿Por qué no escribir un script para traer comentarios y otro para llamar a la API de Iterable? Puedes. Pero dentro de una herramienta de IA para marketing, MCP sale más barato en dos puntos. Uno, el modelo decide a cuál llamar y qué parámetros poner. Le das una petición de dos partes en una frase, llama a everyinfra_call_api y a las herramientas de Iterable por separado, y divide el trabajo en pasos; cuando un parámetro sale mal, lo corrige desde el 422 did_you_mean. Un script no da esa flexibilidad. Dos, ambos servidores cuelgan del mismo cliente sobre el mismo protocolo, y la autenticación, el descubrimiento de herramientas y el formato de llamada siguen la especificación MCP, así que cambiar de cliente deja la configuración casi igual, sin pegamento por herramienta que reescribir. El 2026-11-14 revisamos la configuración de los tres clientes: las entradas difieren, pero cada una añade «una URL de servidor más una clave».
MCP no siempre es mejor que un script. Algunas tareas convienen a un script que llama a REST directamente: un lote grande y fijo, control preciso de concurrencia y reintentos, o escribir resultados en tu propia base de datos. Ahí everyinfra_call_api se apoya en el mismo POST /api/v1/social y la misma facturación que MCP, así que script y chat se mezclan libremente: explora y decide en el chat, corre el volumen en el script. Iterable también deja ambos caminos abiertos: el MCP alojado para marketers en el chat, y la versión autoalojada de código abierto y la API directa para desarrolladores (README de Iterable/mcp-server).
Una ida y vuelta real por MCP: qué envió el modelo, qué devolvió la API
Primero el handshake. El 2026-11-17 a las 00:20 hora de Singapur enviamos initialize al endpoint. Devolvió 200, versión de protocolo 2025-06-18 y serverInfo EveryInfra, sin cabecera Mcp-Session-Id, lo que significa que el servidor no exige un identificador de sesión. El resultado de initialize también traía instrucciones para el modelo: en resumen, cuando el objetivo es vago, que pregunte qué plataforma, qué buscar, cuántos resultados y el presupuesto, y luego recomiende de una a tres capacidades. Después enviamos notifications/initialized, que devolvió 202 con cuerpo vacío, y tools/list, que devolvió 200 y 12 herramientas. Estos pasos siguen el ciclo de vida de MCP y el transporte Streamable HTTP (especificación de ciclo de vida de MCP; especificación de transporte).
| Paso | Método | Estado | Nota |
|---|---|---|---|
| 1 | initialize | 200 | protocolo 2025-06-18, sin Mcp-Session-Id |
| 2 | notifications/initialized | 202 | cuerpo vacío |
| 3 | tools/list | 200 | 12 herramientas, 16.353 bytes |
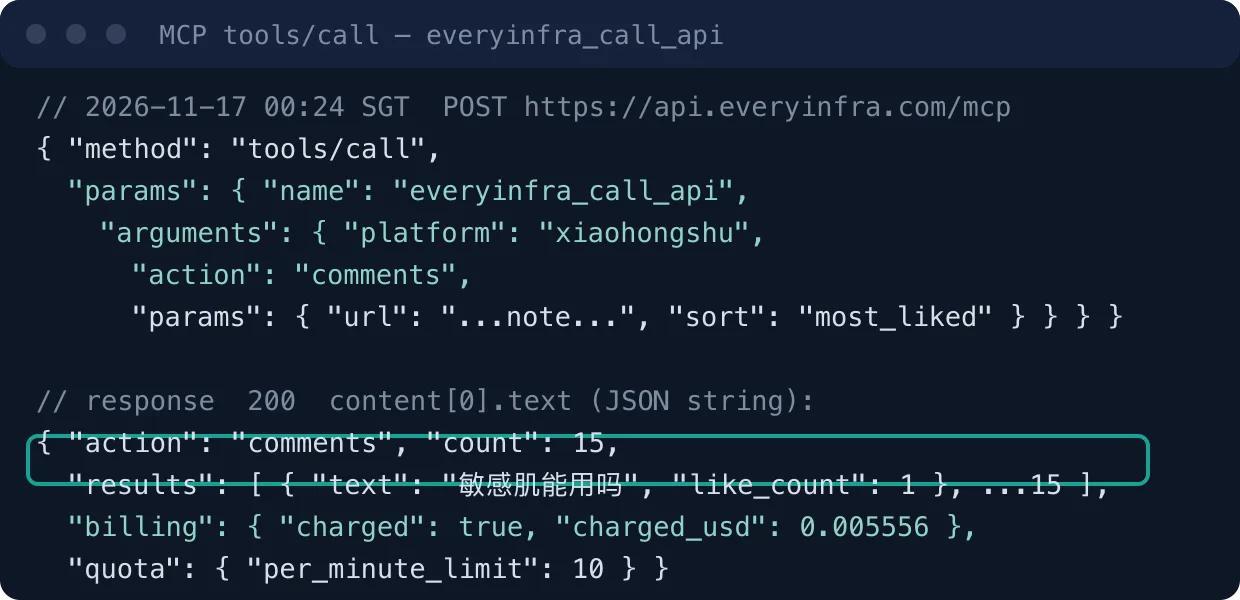
| 4 | tools/call (everyinfra_call_api) | 200 | 15 comentarios, cobro 0,005556 USD |
El 2026-11-17 a las 00:24 hora de Singapur usamos tools/call una vez, para los comentarios de una nota de Xiaohongshu, con sort en most_liked. Esa es la llamada que un modelo enviaría desde Claude. Devolvió 200, y el content[0].text era una cadena JSON que al parsear dio 15 comentarios con billing.charged_usd de 0,005556. Algunos comentarios preguntan si la piel sensible puede usarlo, otros dicen que quien escribe tiene piel seca y es muy hidratante, y otros piden directamente precio y enlace. Esas son las líneas textuales que se usan para fijar segmentos.
Estas 12 herramientas se agrupan en tres clases, que lista la tabla de abajo. Segmentar audiencias solo necesita las primeras dos o tres; el resto no se usa aquí, y por eso la sugerencia de lista blanca deja solo everyinfra_call_api y everyinfra_get_job. Los nombres everyinfra_* solo se suman, los viejos siguen llamables, así que escribirlos en scripts o prompts es seguro.
| Clase | Herramientas | Se usa aquí |
|---|---|---|
| Traer datos | everyinfra_call_api, everyinfra_get_job, everyinfra_list_capabilities, everyinfra_search | sí, las primeras dos o tres |
| Cuenta | everyinfra_get_account, everyinfra_list_requests, everyinfra_get_topup_link | no |
| CAPTCHA / tickets / chat | everyinfra_solve_captcha, everyinfra_list_captcha_types, everyinfra_create_ticket, everyinfra_get_ticket, everyinfra_chat | no |
La lista de herramientas también fija cuánto espacio de conversación ocupa el servidor. Todo el tools/list pesa 16.353 bytes, unos 4.088 tokens a razón de unos 4 bytes por token; una definición de everyinfra_call_api pesa 1.804 bytes, unos 451 tokens. Si tu cliente admite una lista blanca de herramientas por servidor, dejar solo las dos de traer datos ahorra las descripciones de las otras 10. La figura de abajo pone unos conteos de bytes lado a lado.
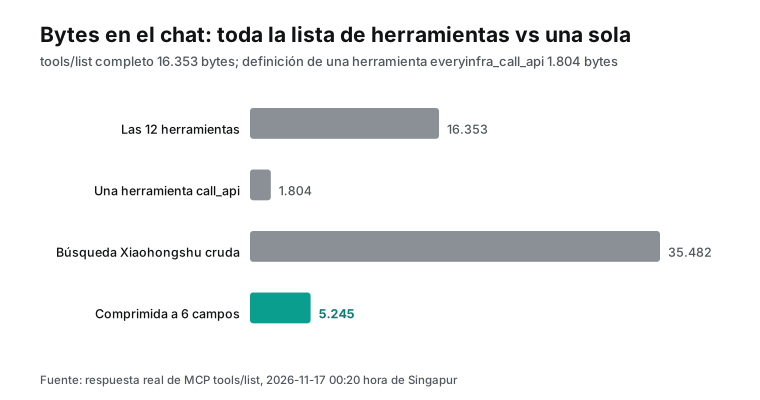
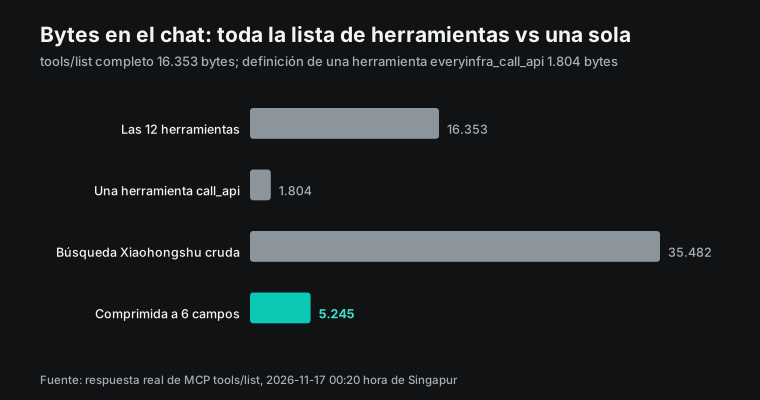
Una respuesta cruda de xiaohongshu/search pesa 35.482 bytes. Comprime cada nota a seis campos —título, likes, comentarios, guardados, URL y si es video— y baja a 5.245 bytes. El trabajo del modelo es fijar segmentos; no necesita la imagen de portada ni el avatar del autor, que son enlaces de CDN largos y firmados. Así que deja que la conversación tome solo el resumen comprimido, no la respuesta cruda, lo que ahorra la mayor parte del espacio, unas 6,8 veces. En la práctica, haz que la herramienta de búsqueda tome solo los campos que necesitas, o deja que una subtarea comprima la respuesta cruda antes de devolverla. El doc de costos de Claude Code explica por qué vale la pena: una sesión larga reenvía toda la conversación en cada solicitud, así que una vez que el dato crudo está en la conversación principal, el costo cae en cada solicitud posterior (doc de costos de Claude Code). Para contar tokens exacto, el endpoint oficial de conteo es gratis (doc de conteo de tokens).
Fija segmentos con señal pública: tres llamadas reales, de publicaciones a comentarios
La segmentación arranca con una búsqueda por palabra clave. El 2026-11-17 a las 00:19 hora de Singapur, xiaohongshu/search corrió una consulta de piel seca de invierno con sort en most_liked y devolvió 20 notas por 0,005556 USD. Mira las seis primeras por likes. La primera tiene 39.904 likes, 32.944 guardados y 628 comentarios. La segunda tiene 22.568 likes pero 2.121 comentarios. Muchos likes no implican muchos comentarios, y los dos números se leen distinto: muchos likes dicen que el contenido gusta, muchos comentarios dicen que la gente pregunta abajo, y las preguntas son donde están las pistas de segmento. Así que el segundo paso apunta a la nota con más comentarios, no a la de más likes. En el mismo minuto, tiktok/search corrió «winter skincare routine» con content_type en video y devolvió 10 videos por 0,000556 USD, el primero con 755.800 vistas y 692 comentarios.
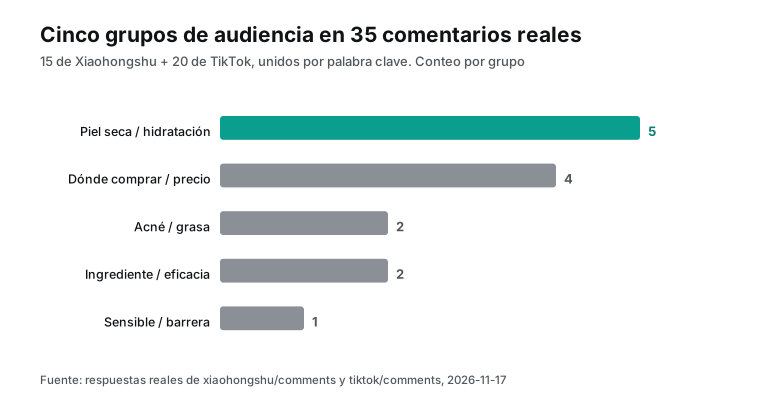
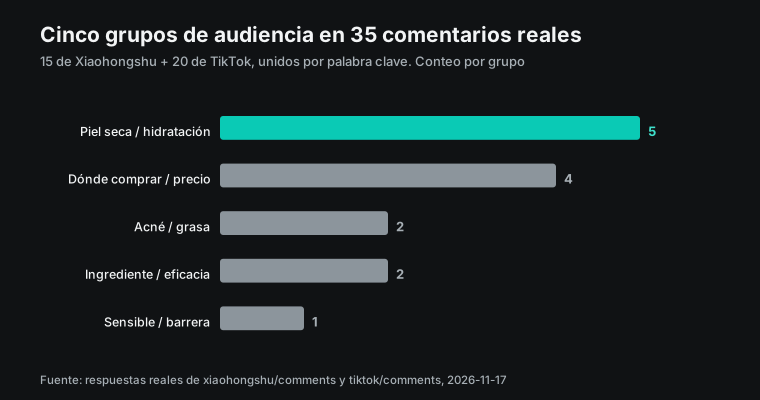
Los comentarios fijan los segmentos. El 2026-11-17 a las 00:24 hora de Singapur, xiaohongshu/comments trajo los comentarios de la nota con más comentarios y devolvió 15. El 2026-11-17 a las 00:26 hora de Singapur, tiktok/comments trajo los comentarios del video más visto y devolvió 20 por 0,000556 USD. Agrupa los 35 comentarios por palabra clave y 14 entran en cinco segmentos: 5 sobre piel seca e hidratación, 4 sobre dónde comprar y precio, 2 sobre acné, 2 sobre ingredientes y 1 sobre sensibilidad; los otros 21 son verificaciones de autenticidad, elogios genéricos o charla ajena al tema, y quedan fuera. El denominador es 35 y los que entran en los cinco grupos son 14, dos números que van separados. La muestra es de solo 35, de dos piezas de contenido, así que no es una cuota de mercado. Pero basta para mostrar algo: bajo el mismo tema se puede separar un grupo de hidratación de un grupo sensible al precio. Eso mapea a dos aperturas de journey: hidratación para el primero, precio de promoción para el segundo.
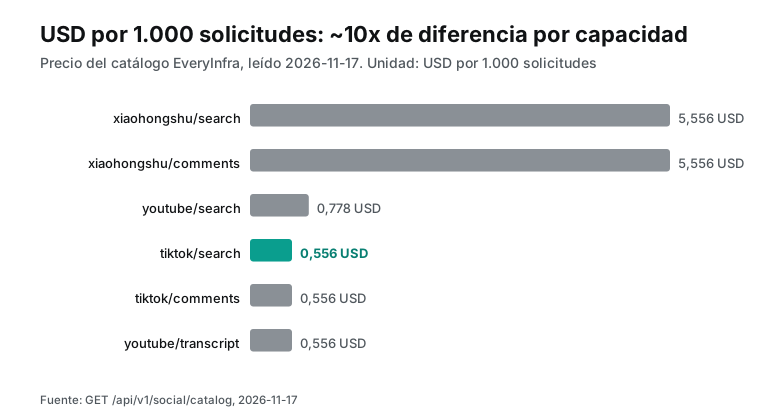
Mirar ambas plataformas también muestra una diferencia. Las notas top de Xiaohongshu para la consulta de piel seca son claramente guías de cuidado de piel, y los comentarios preguntan por ingredientes, piel sensible y precio, con un sesgo de «investigación». El video top de TikTok, con 755.800 vistas y 692 comentarios, tiene más «dónde compro esto», con un sesgo de «listo para comprar». La misma preocupación se lee distinto en las dos plataformas, así que la apertura del journey para cada mercado también debería diferir, y por eso mezclar las preocupaciones de un mercado con las de otro es un error. Los dos precios de búsqueda valen una nota: tiktok/search cuesta 0,000556 USD por llamada y xiaohongshu/search 0,005556 USD, unas 10 veces más, así que explorar en la plataforma barata primero y traer con precisión en la cara es el orden que ahorra.
| Plataforma | Precio de búsqueda por llamada | Pieza top | Sesgo de comentarios |
|---|---|---|---|
| Xiaohongshu (consulta de piel seca) | 0,005556 USD | nota: 39.904 likes, 32.944 guardados | ingredientes, piel sensible, precio |
| TikTok (winter skincare routine) | 0,000556 USD | video: 755.800 vistas, 692 comentarios | dónde comprar, qué productos |
Estas tres llamadas devuelven campos que coinciden con los response_fields del catálogo. xiaohongshu/search devuelve title, like_count, comment_count, collect_count, author_is_verified e is_video. xiaohongshu/comments devuelve text, like_count, ip_location y sub_comment_count. tiktok/comments devuelve text, like_count, reply_count e is_reply. Las páginas de capacidad son xiaohongshu/search, xiaohongshu/comments, tiktok/search y tiktok/comments. Los resúmenes de plataforma están en API de datos de Xiaohongshu y API de datos de TikTok. Para un recorrido más completo de búsqueda a nota a comentarios, mira recolección de datos de Xiaohongshu: búsqueda, notas, comentarios.
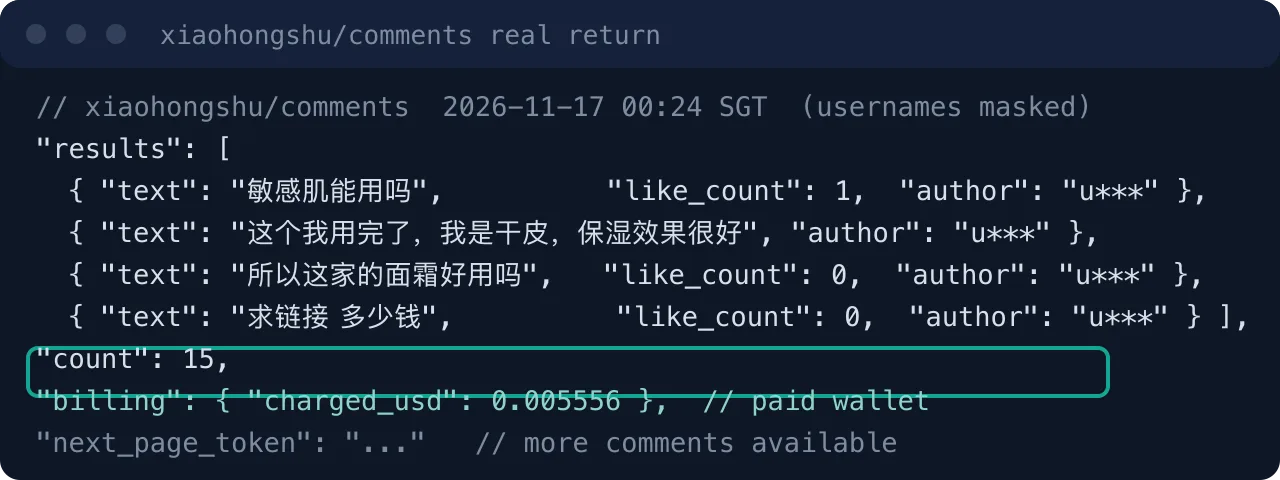
| Llamada | Hora (SGT) | Capacidad | Parámetros | Devolvió | Cobro |
|---|---|---|---|---|---|
| 1 | 00:19 | tiktok/search | keyword winter skincare routine, content_type video | 10 videos | 0,000556 USD |
| 2 | 00:19 | xiaohongshu/search | consulta de piel seca, sort most_liked | 20 notas | 0,005556 USD |
| 3 | 00:24 | xiaohongshu/comments | URL de una nota, sort most_liked (vía MCP tools/call) | 15 comentarios | 0,005556 USD |
| 4 | 00:26 | tiktok/comments | URL del video más visto | 20 comentarios | 0,000556 USD |
| 5 | 00:21 | youtube/search | keyword iterable mcp server | 10 videos | 0,000778 USD |
| 6 | 00:21 | youtube/transcript | video oficial de Iterable | transcripción (el promo es solo música) | 0,000556 USD |
Convierte comentarios en reglas de segmento y textos de apertura
Traducir este paso es donde juzga un humano, y la API no ayuda. Detrás de «¿la piel sensible puede usarlo?» hay un grupo cauto que no prueba productos nuevos a la ligera, así que la apertura debe bajar la barrera de probar. Detrás de «dónde comprar, cuánto» hay un grupo ya convencido pero trabado en el precio o la ruta de compra, así que la apertura debe dar certeza. Pon el mismo comentario en el grupo equivocado y el correo se lee al revés. Agrupar no es solo contar palabras clave: es leer dónde se trabó quien escribió. Por eso este paso pide un visto bueno humano, no un aplicar de un clic.
La tabla de abajo se arma con las 14 preocupaciones clasificadas de los 35 comentarios de esta ronda. Las condiciones de segmento aterrizan en Iterable sobre campos que ya tienes, y las aperturas se escriben al tono de la preocupación. Los grupos coinciden con los cinco de la figura de arriba.
| Grupo de audiencia (de comentarios) | Esta muestra | Condición de segmento (campos de la cuenta de Iterable) | Apertura del journey |
|---|---|---|---|
| Piel seca / hidratación | 5 | Compró crema o loción, sin abrir en 60 días | «¿Piel tirante por el frío? Primero fija la hidratación.» |
| Dónde comprar / precio | 4 | Añadió al carrito sin pagar, vio una página de promo | «La que viste tiene precio de promo esta semana.» |
| Acné / grasa | 2 | Compró limpiador o control de grasa | «¿Grasa aun en invierno? Hidrata ligero, dos pasos juntos.» |
| Ingrediente / eficacia | 2 | Vio una página de ingredientes o una guía larga | «Qué lleva y qué resuelve, en una lectura.» |
| Sensible / barrera | 1 | Compró la línea de piel sensible | «¿Barrera dañada? Deja los activos fuertes, repara suave.» |
Dos puntos aquí. Primero, los comentarios públicos fijan qué grupos y qué decirle a cada uno; aterrizar en la lista sigue usando los campos de tu cuenta. No puedes rellenar tu propia lista con usuarios públicos, que no son la misma gente. Segundo, sé honesto con la muestra. Son solo 35, y las aperturas de arriba son ejemplos al tono de esos 35, no textos validados por envío. Para tomarlo como base firme, amplía las palabras clave, trae decenas o cientos de comentarios y mira si la cuota de cada grupo se sostiene. El método y el costo están en la sección de costos. Para un enfoque completo que deja el dato crudo en una subtarea, mira subagentes de Claude Code en paralelo trayendo cuentas de marca.
Qué más dividen los campos: no solo la preocupación
La preocupación es la capa más directa. Pero algunos campos de respuesta ayudan a segmentar más fino. xiaohongshu/comments trae ip_location, la región de quien comenta. Para el cuidado de piel de invierno, los dolores del norte y del sur difieren, así que cuando una preocupación se concentra en una región, obtienes una apertura regional gratis. Los 15 comentarios de esta ronda tenían ip_location vacío, así que el campo no siempre está y no se puede dar por hecho, pero es una pista gratis cuando está. author_is_verified separa cuentas de marca de usuarios comunes; para fijar la preocupación quieres las palabras de usuarios comunes. Un comentario con sub_comment_count alto suele ser el que pegó, y seguir sus respuestas (xiaohongshu/sub_comments, pide el id del comentario) muestra una ristra de preguntas del mismo tipo.
| Campo | En | Qué divide |
|---|---|---|
ip_location | xiaohongshu/comments | región (vacío en los 15 de esta ronda) |
author_is_verified | búsqueda / comentarios | cuenta de marca contra usuario común |
sub_comment_count | xiaohongshu/comments | qué comentario pegó, sigue sus respuestas |
is_video | xiaohongshu/search | formato de contenido: texto con imagen contra video |
collect_count vs comment_count | xiaohongshu/search | «guardar para después» contra «discutir abajo» |
Los campos del lado de la nota también ayudan. El is_video de xiaohongshu/search separa texto con imagen de video; para copiar un formato, mira cuál junta más likes y guardados. Esta ronda las seis primeras fueron dos de texto con imagen y cuatro de video, y la primera, una nota de texto con imagen, tiene 32.944 guardados, muy por encima de sus 628 comentarios, así que es una guía que se guarda para hacer, y los comentarios bajo ese tipo tienden a «dónde comprar». La razón entre collect_count y comment_count muestra la naturaleza del contenido: guardados muy por encima de comentarios es «guardar para hacer», comentarios muy por encima de guardados es «discutir abajo», y este último tiene más pistas de segmento. Apila esto con la preocupación y pasas de cinco preocupaciones a un grupo más concreto, como «piel seca del norte que guarda para después». La muestra debe ser grande, y 35 no lo es.
Los errores se autocorrigen: 422 con did_you_mean y sin cobro
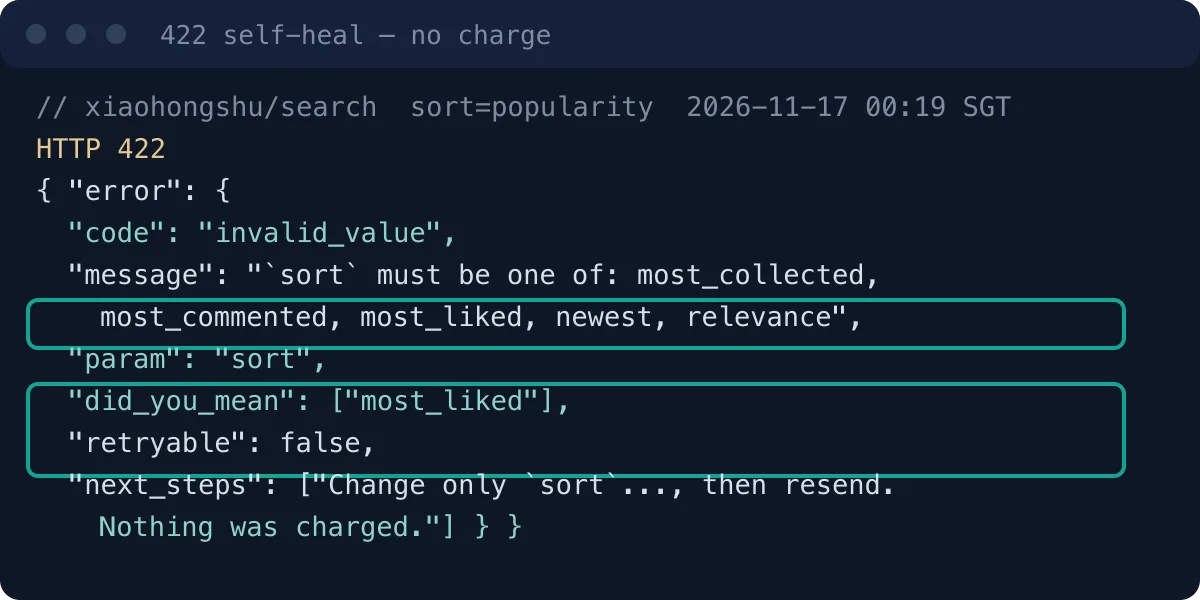
La primera búsqueda de Xiaohongshu tenía sort escrito como popularity, y la API devolvió 422 con code invalid_value, un message que listaba los cinco valores permitidos (most_collected, most_commented, most_liked, newest, relevance), un did_you_mean con most_liked, y un next_steps que decía cambiar solo sort y reenviar, y que no hubo cobro. Esa respuesta está escrita para el modelo: no solo dice que el parámetro está mal, sino que da un siguiente paso usable, y un cliente como Claude se autocorrige cambiando un valor. Lo cambiamos a most_liked, reenviamos y obtuvimos 200 con 20 resultados. Para un agente que corre en una conversación esto importa: no se traba ni gasta de más por un nombre de parámetro mal; lee did_you_mean, lo cambia una vez y sigue.
El límite de tasa es la otra respuesta a manejar. Esta clave de prueba está limitada a 10 solicitudes por minuto y varios clientes la comparten. El 2026-11-17 a las 00:20 hora de Singapur recibimos un 429, cuyo message indica 10 por minuto y reintentar en unos segundos. Un 429, igual que un 422 o un 401, ocurre antes de cualquier cobro, así que reintentar es seguro; espera los segundos indicados y reenvía, sin golpear en paralelo. La especificación HTTP define 429 como demasiadas solicitudes en un tiempo dado, con un Retry-After para decir cuánto esperar (RFC 6585; RFC 9110). Las notas de instalación están en instalación de MCP remoto, y los tres pasos REST en guía rápida.
Paginar y asíncrono: trae completos los comentarios de una nota
La llamada a xiaohongshu/comments de arriba devolvió solo 15 porque entrega una página a la vez. La respuesta trae next_page_token; ponlo en el page_token de la siguiente solicitud para seguir. La nota con más comentarios tiene 2.121 comentarios, así que traerla completa toma muchas páginas, cada página una llamada a 0,005556 USD, y por eso traer una nota popular completa no es barato, y por eso el consejo es traer solo las pocas más comentadas. Leer el catálogo el 2026-11-16 confirmó que los parámetros opcionales son page_token y sort, y que sort admite most_liked, most_commented, newest y dos más, igual que los valores permitidos en el 422.
Para traer mucho de una vez, usa asíncrono. Cualquier capacidad puede correr asíncrona: añade {"mode":"async"} al cuerpo del POST /api/v1/social, recibes un 202 y un job_id al instante, y luego consultas everyinfra_get_job (en REST GET /api/v1/jobs/{job_id}), y leer un job no se cobra. En el chat, el modelo puede enviar un lote de tareas lentas, juntar una ristra de job_id y leer los resultados uno a uno, sin esperar una respuesta de comentarios en particular. Aquí está el REST para la segunda página, con la clave leída solo desde una variable de entorno:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"comments","params":{"url":"...note...","page_token":"...","sort":"most_liked"}}'
Las cuentas: por número de llamadas, sin depender del modelo
El costo del lado de EveryInfra depende solo del número de llamadas, no de cuántas filas vuelven ni de qué modelo corre. La brecha de precio es sobre todo por plataforma: las capacidades de TikTok y YouTube son baratas, Xiaohongshu es unas 10 veces más cara. La figura de abajo es el precio por 1.000 de varias capacidades.
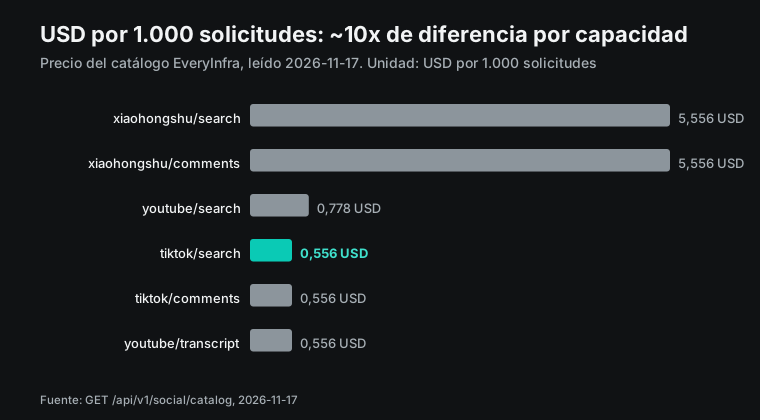
| Escala | Composición | Llamadas | Costo |
|---|---|---|---|
| Un estudio de segmentación (este artículo) | 2 búsquedas + 2 traídas de comentarios + 2 chequeos de YouTube | 6 | 0,013558 USD |
| Un tema, semanal, un mes | 6 llamadas cada vez | ~24 | ~0,054 USD |
| 10 temas, semanal, un mes | 6 llamadas cada vez | ~240 | ~0,543 USD |
| 100 notas, comentarios cada una (Xiaohongshu) | 100 xiaohongshu/comments | 100 | 0,5556 USD |
Esta tabla supone que traes solo las pocas que necesitas. Hay dos formas de ahorrar. Primero, usa una búsqueda para elegir las pocas notas más comentadas y luego trae comentarios de esas, no de cada nota encontrada. Segundo, mueve las tareas lentas o los limit grandes a asíncrono, con {"mode":"async"} para un job_id y everyinfra_get_job para leer, que no se cobra. Para el tema de invierno, si vigilas una palabra clave por semana y traes comentarios de las tres más comentadas, son 1 búsqueda más 3 traídas, unos 0,022 USD por corrida, menos de 0,09 USD al mes por cuatro corridas; vigila diez categorías y es cerca de medio dólar al mes. El MCP alojado de Iterable no publica un precio aparte, sigue tu plan de Iterable y los permisos de cada quien, y la versión autoalojada es gratis (reporte de TechEdgeAI, según el anuncio de Iterable); confirma los detalles con tu equipo de cuenta de Iterable. Nuestra propia clave gastó 0,013558 USD en total para este artículo, y el detalle cuadra contra el billing de cada respuesta; mira el catálogo del mercado y la página de precios.
Convierte un estudio en una vigilancia semanal
Más allá del estudio único, piensa una capa arriba: las reglas de segmento no se fijan una vez y quedan. El cambio de estación, los lanzamientos y la promoción de un competidor mueven lo que importa en una categoría. Un enfoque estable es fijar lo de arriba como una tarea semanal. Cada lunes, busca cada palabra clave que vigilas, trae comentarios de las dos o tres más comentadas, agrúpalos en los conteos de las cinco preocupaciones y compara con la semana pasada; la que subió te dice qué apertura ajustar. El gasto es poco como para dejarlo corriendo, con los números exactos en la sección de costos de abajo.
Esto puede correr aparte del journey mismo. La investigación de preocupaciones usa EveryInfra y produce una tablita con los conteos por preocupación de la semana y unas citas. El ajuste del journey usa el MCP alojado de Iterable, con el marketer sosteniendo esa tabla y diciendo en Claude «revisa la apertura del primer paso de recuperación según la preocupación que más subió esta semana». Alrededor del 2026-11-11 varios medios cubrieron el mismo giro: la IA de marketing pasa de «cómoda para una persona» a «un equipo y sus agentes compartiendo los mismos datos y permisos» (reporte de MarTechCube). Volver la investigación de señal pública en una tabla semanal es cómo pasa de oficio de una persona a entrada compartida.
Para volverlo una tarea programada sin supervisión, quedan unas cosas de ingeniería. Hay que deduplicar comentarios, porque el mismo comentario puede repetirse entre páginas (deduplica por id). Las palabras de agrupación cambian por categoría; «barrera» y «exfoliar» del cuidado de piel son otras palabras en otra categoría. Los números de cada semana deben aterrizar en una tabla comparable, no solo la semana en curso. Esto queda fuera del alcance aquí, pero todo se sigue de instalación de MCP remoto y de las notas de campos en las páginas de capacidad.
Límites: qué no puede obtener esta combinación
Esta combinación tiene varias cosas que no puede obtener. Primero, la muestra es chica. Los 35 comentarios aquí son de dos piezas de contenido, y solo muestran que los grupos son separables, no la cuota de cada grupo; estimar cuotas implica ampliar las palabras clave a decenas o cientos de notas, lo que escala el costo de la tabla de arriba. Segundo, los campos tienen límites. xiaohongshu/comments devuelve una página con un next_page_token, así que más comentarios implican paginar, cada página una llamada, y los comentarios de Xiaohongshu no garantizan un árbol de respuestas completo. Tercero, los datos públicos son datos públicos, no la gente de tu lista. EveryInfra trae las publicaciones públicas de cualquiera, Iterable tiene a tus propios usuarios, y no son la misma gente ni se pueden fusionar; la señal pública solo guía la regla de segmento. Cuarto, la línea de YouTube no aportó nada esta vez: el chequeo tuvo un video relevante, el promo oficial de MCP de Iterable del 2025-11-19, cuyo metraje es solo música, sin pasos de demo que escribir.
| Límite | Qué significa |
|---|---|
| Muestra chica | 35 comentarios muestran que hay grupos, no su cuota |
| Campos con tope | comentarios por página, sin árbol de respuestas completo |
| Público ≠ tu lista | guía la regla, no se fusiona con tus usuarios |
| YouTube sin aporte | un video relevante, solo música |
Un límite del lado de Iterable vale la pena recordar. Con el permiso de envío del MCP autoalojado activo, crear una campaña masiva la programa para entrega, siguiendo el comportamiento de la API de Iterable, y no hay concepto de «campaña en borrador»; para solo redactar contenido, deja el envío apagado y usa plantillas (README de Iterable/mcp-server). Alimentar la señal pública de EveryInfra a los textos es la mitad de solo lectura y segura; el paso que de verdad manda mensajes a usuarios mantiene sus permisos y revisión del lado de Iterable, y eso es cosa tuya. Un orden seguro ayuda: que el agente deje el journey en borrador y se detenga antes de enviar, revisa el lienzo en Iterable antes de publicar y trata las primeras dos semanas como una prueba.
Dos cosas más que conviene resolver de antemano. Una, haz coincidir plataforma e idioma. Xiaohongshu es un tema de cuidado de piel en chino, y sirve para segmentar un journey del mercado chino; para segmentar un journey del mercado inglés, busca términos en inglés en tiktok/search y trae comentarios en inglés, y no mapees las preocupaciones de un mercado sobre otro. Dos, el tiempo. Los comentarios son del momento y las reglas de segmento derivan, así que esto conviene correrlo periódicamente y reagrupar cada vez, no correrlo una vez y fijar una constante en un journey. EveryInfra da solo los datos públicos y sus campos; cómo agrupar, cada cuánto correr y en qué campos de cuenta aterrizar son tus decisiones.
Qué tres pasos probar primero
Para empezar no necesitas conectar Iterable de una vez. Puedes tomar solo EveryInfra por tres pasos para ver si vale la pena.
| Paso | Hacer | Costo |
|---|---|---|
| 1 | everyinfra_list_capabilities o leer el catálogo; confirma plataformas, nombres y precios | gratis |
| 2 | Busca una palabra clave, trae comentarios de las más comentadas, agrupa en preocupaciones | ~0,022 USD |
| 3 | Revisa a mano una apertura de recuperación con las líneas de un grupo; júzgala | gratis |
El paso uno confirma las plataformas, los nombres de capacidad y los precios que te importan. El paso dos busca una palabra clave que te importe, trae comentarios de las dos o tres más comentadas y las agrupa en preocupaciones, y entonces ves si los grupos te dan más que decir que tu corte por conducta. El paso tres toma unas líneas textuales de un grupo, revisas a mano una apertura de recuperación y la juzgas tú. Estos tres pasos cuestan menos de tres centavos por corrida, no tocan ninguna cuenta de Iterable, y luego decides si conectarlo al journey. Si los grupos no son mejores que tu corte por conducta, el habla pública de la categoría es pobre: cambia la palabra clave o la plataforma y prueba de nuevo. Si ves claramente dos o tres grupos que hablan distinto, vale la pena conectarlo y correrlo semanal. Los tres pasos REST están en guía rápida, y cómo adjuntar MCP en cada cliente en instalación de MCP remoto.
Notas del sector
- 2026-11-12, Iterable lanzó el servidor MCP alojado, los SDK con IA y un Integrations Hub triplicado (página de producto de Iterable). Para los equipos de marketing, armar journeys dentro de herramientas de IA pasa a ser una capacidad de equipo, no la destreza de una persona.
- 2026-11-12, la nota de Iterable indica que el MCP alojado usa el ingreso propio de cada persona incluido SSO, sin claves compartidas (nota de BusinessWire). Así, auditar permisos importa más, porque lo que un marketer puede hacer, su agente ahora lo hace más rápido.
- 2026-11-13, la cobertura de terceros nota que el Winter release tiene un despliegue, con el conjunto completo llegando a las cuentas alrededor del 2026-12-02 (reporte de TechEdgeAI). Así, no leas «lanzado» como «disponible»; confirma que tu cuenta lo tiene.
- 2026-10-20, el release de octubre de Iterable sumó integraciones de Stripe, Recharge y TikTok Ads y barandas de segmentación (notas de versión 2026). Así, eventos de cobro fallido y renovación pueden disparar journeys, y la señal pública puede ir después de esos eventos.
- 2026-11-07, terceros empezaron a documentar intermediarios para conectar Iterable a ChatGPT (blog de Truto). Así, las formas de conectar se multiplican, pero la autenticación y los límites de permisos aún hay que revisarlos uno por uno.
- La versión 2025-06-18 de la especificación MCP define el transporte Streamable HTTP y el ciclo de vida (especificación MCP). Así, el handshake de MCP remoto es estándar y se mantiene entre plataformas.
Preguntas frecuentes
¿El MCP de Iterable puede traer datos públicos de Xiaohongshu o TikTok directamente? No. El MCP alojado de Iterable se conecta a los datos de clientes de tu propia cuenta de Iterable y no rastrea datos sociales públicos fuera de ella (página de producto de Iterable). Para publicaciones y comentarios públicos, adjunta un MCP de datos como everyinfra_call_api de EveryInfra.
¿Un cliente puede correr Iterable y EveryInfra MCP a la vez? Sí. Ambos hablan el Model Context Protocol, cada uno con su autenticación y datos. En un cliente que admita mcpServers, escribe ambos; la sección «añade al mismo cliente» da la configuración.
¿Cuál es la dirección del servidor MCP de everyinfra y sus herramientas? La dirección es https://api.everyinfra.com/mcp con autenticación Bearer. tools/list devuelve 12 herramientas, las principales son everyinfra_call_api, everyinfra_get_job y everyinfra_list_capabilities, medido el 2026-11-17 00:20 hora de Singapur.
¿Cuánto cuesta traer comentarios públicos para segmentar? Por número de llamadas. tiktok/comments cuesta 0,000556 USD por llamada y xiaohongshu/comments 0,005556 USD (0,556 USD y 5,556 USD por 1.000). El estudio de este artículo, 6 llamadas, suma 0,013558 USD, y cuadra contra el billing de cada respuesta.
¿Cuándo está disponible el MCP alojado de Iterable y cuesta extra? El anuncio es del 2026-11-12; según la comunidad de Iterable, el Winter release completo llega a las cuentas alrededor del 2026-12-02, y el MCP alojado está antes como prueba por los representantes de cuenta. No hay precio aparte publicado; sigue tu plan de Iterable, y la versión autoalojada es gratis (reporte de TechEdgeAI).
¿Un parámetro mal escrito me cobrará de más? No. Un parámetro inválido devuelve 422 con did_you_mean y los valores permitidos, sin cobro; un límite de tasa devuelve 429 sin cobro. El 2026-11-17 a las 00:19 hora de Singapur escribimos sort mal, la respuesta dijo «nada fue cobrado», y cambiar un valor y reenviar funcionó.
¿Puedo rellenar mi lista de Iterable con usuarios públicos? No, y no deberías. EveryInfra trae las publicaciones públicas de cualquiera, que no son la misma gente que tus usuarios de Iterable. La señal pública fija solo cuántos grupos y qué le importa a cada uno; aterrizar en la lista sigue usando los campos de tu cuenta.
Referencias
- Iterable, «Explore Iterable's Latest Platform Innovations & Updates», iterable.com, 2026-11-12, <https://iterable.com/product/whats-new/>
- Iterable, «What's New at Iterable: Winter Product Launch 2026», events.iterable.com, 2026-11-12, <https://events.iterable.com/whats-new-at-iterable-winter-product-launch-2026/>
- BusinessWire / Yahoo Finance, «Iterable Opens Its Platform to Claude, ChatGPT, and Cursor With a Hosted MCP Server», 2026-11-12, <https://finance.yahoo.com/technology/ai/articles/iterable-opens-platform-claude-chatgpt-140000056.html>
- Iterable, «2026 Release Notes», support.iterable.com, 2026-10-20, <https://support.iterable.com/hc/en-us/articles/44900665796628-2026-Release-Notes>
- Iterable, mcp-server README, GitHub, <https://github.com/Iterable/mcp-server/blob/main/README.md>
- Iterable, repositorio mcp-server, GitHub, <https://github.com/Iterable/mcp-server>
- Iterable, integración Recharge, support.iterable.com, <https://support.iterable.com/hc/articles/54558473243540>
- Iterable, integración Stripe, support.iterable.com, <https://support.iterable.com/hc/articles/54550787663380>
- Iterable, integración TikTok Ads, support.iterable.com, <https://support.iterable.com/hc/articles/54559482036756>
- Iterable, integración Salesforce, support.iterable.com, <https://support.iterable.com/hc/articles/54760250284180>
- Iterable, Segmentation Reference, support.iterable.com, <https://support.iterable.com/hc/articles/29471638325524>
- TechEdgeAI, «Iterable Adds MCP Server for AI Marketing Teams», 2026-11-13, <https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/>
- MarTechCube, «Iterable Launches Hosted MCP Server for Claude, ChatGPT and Cursor», 2026-11-12, <https://www.martechcube.com/iterable-launches-hosted-mcp-server-for-claude-chatgpt-and-cursor/>
- Truto, «Connect Iterable to ChatGPT», 2026-11-07, <https://truto.one/blog/connect-iterable-to-chatgpt-manage-campaigns-and-user-profiles/>
- Anthropic, «Get started with custom connectors using remote MCP», support.claude.com, <https://support.claude.com/en/articles/11175166-get-started-with-custom-connectors-using-remote-mcp>
- Anthropic, doc de MCP de Claude Code, code.claude.com, <https://code.claude.com/docs/en/mcp>
- Anthropic, doc de subagentes de Claude Code, code.claude.com, <https://code.claude.com/docs/en/sub-agents>
- Anthropic, doc de costos de Claude Code, code.claude.com, <https://code.claude.com/docs/en/costs>
- Anthropic, doc de permisos de Claude Code, code.claude.com, <https://code.claude.com/docs/en/permissions>
- Anthropic, página de precios, platform.claude.com, <https://platform.claude.com/docs/en/about-claude/pricing>
- Anthropic, doc de conteo de tokens, platform.claude.com, <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- OpenAI, «Connecting custom MCP servers in ChatGPT», help.openai.com, <https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt>
- Cursor, doc de Model Context Protocol (MCP), cursor.com, <https://cursor.com/docs/mcp>
- Cursor, doc de MCP para CLI, cursor.com, <https://cursor.com/docs/cli/mcp>
- Model Context Protocol, especificación de transporte 2025-06-18, <https://modelcontextprotocol.io/specification/2025-06-18/basic/transports>
- Model Context Protocol, especificación de ciclo de vida 2025-06-18, <https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle>
- Model Context Protocol, «Connect to remote MCP Servers», <https://modelcontextprotocol.io/docs/2026-07-28/develop/connect-remote-servers>
- IETF, RFC 6585 (Additional HTTP Status Codes, 429), <https://www.rfc-editor.org/rfc/rfc6585>
- IETF, RFC 9110 (HTTP Semantics, Retry-After), <https://www.rfc-editor.org/rfc/rfc9110>
- EveryInfra, catálogo de capacidades de datos, api.everyinfra.com, 2026-11-17, <https://api.everyinfra.com/api/v1/social/catalog>
- EveryInfra, catálogo de capacidades de Xiaohongshu, api.everyinfra.com, <https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu>
- EveryInfra, catálogo de capacidades de TikTok, api.everyinfra.com, <https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok>
- EveryInfra, catálogo de capacidades de YouTube, api.everyinfra.com, <https://api.everyinfra.com/api/v1/social/catalog?platform=youtube>
- Iterable, «How Iterable's MCP Server Powers Smarter Agentic Marketing», iterable.com, 2026-09-11, <https://iterable.com/blog/introducing-open-source-model-context-protocol-mcp-server/>
- Iterable, blog del Winter 2026 Product Launch, iterable.com, 2026-11-12, <https://iterable.com/blog/winter-2026-product-launch/>
- Henry Moses Jr, publicación del Winter 2026 Release, LinkedIn, 2026-11-13, <https://www.linkedin.com/posts/henrymoses_martech-aiworkflows-productlaunch-activity-7526705822693871616-0jZr>
- BusinessWire, «Iterable Launches Model Context Protocol (MCP) Server», 2025-11-19, <https://www.businesswire.com/news/home/20251119094529/en/Iterable-Launches-Model-Context-Protocol-MCP-Server-Strengthening-Its-Dominance-in-AI-Marketing-Innovation>
- Composio, kit de herramientas Iterable MCP, composio.dev, <https://composio.dev/toolkits/iterable>
- OpenAI Agents SDK, doc de Model context protocol (MCP), <https://openai.github.io/openai-agents-python/mcp/>
- Python docs, concurrent.futures, docs.python.org, <https://docs.python.org/3/library/concurrent.futures.html>
- Improvado, resumen de Iterable MCP, improvado.io, <https://improvado.io/mcp/iterable>
- StackOne, Iterable MCP Server for AI Agents, stackone.com, <https://www.stackone.com/connectors/iterable/mcp/>
Referencia BL-171