Сколько прокси-трафика расходует одна страница Amazon?
Мы измерили объём трафика 40 запросов к страницам товаров Amazon и 6 полных загрузок в браузере, рассчитали его стоимость по прайс-листу IPFoxy за ГБ и сравнили цену 1 000 страниц с API данных. Итог зависит от способа загрузки, выбранного тарифа и доли успешных запросов.
Ротационные резидентные прокси продаются по гигабайтам. Поэтому стоимость прокси для страницы определяется тем, сколько байт она загружает. 24 октября 2026 года с 18:30 до 18:41 по сингапурскому времени мы измерили 40 запросов к страницам товаров Amazon US и 6 полных загрузок в браузере. При загрузке только HTML медианный размер страницы составил 0.44 МБ. При полной загрузке в headless-браузере медиана составила 7.96 МБ, в 18 раз больше. По прайс-листу ротационных резидентных прокси IPFoxy трафик на 1 000 страниц стоит от $0.88 до $47.71. Та же страница через API данных стоит $1.39 за 1 000 вызовов.
В этой статье стоимость прокси-трафика и стоимость API данных сведены к одной шкале. Что выйдет дешевле, зависит от способа загрузки, тарифа и доли успешных запросов. У каждой цифры ниже есть источник, а исходные данные можно скачать.
Почему сначала мы измеряем байты
IPFoxy продаёт ротационные резидентные прокси по объёму трафика. 24 октября на странице цен было шесть тарифов: 1 ГБ, 10 ГБ, 50 ГБ, 100 ГБ, 500 ГБ и 1000 ГБ. Цена за ГБ снижается с $5,99 до $1,99, а срок действия тарифов составляет от 30 до 180 дней. Свыше 1000 ГБ есть индивидуальный тариф «от $0,60/ГБ» (цены на ротационные резидентные прокси IPFoxy). Пул IP-адресов охватывает более 200 стран и регионов (локации IPFoxy). Для продукта с оплатой за трафик стоимость = загруженные байты × цена. Цена указана на сайте. Байты нужно измерить самостоятельно.
На вопрос «сколько весит страница» нет единого ответа. HTTP Archive Web Almanac 2025 определяет вес страницы как все байты, которые браузер загружает, чтобы её отобразить. Там же отмечено, что больше всего байт приходится на изображения (Web Almanac 2025: Page Weight). Но скрипт для сбора данных не всегда загружает изображения. Загрузка только HTML и полный прогон в браузере различаются на порядок. Поэтому мы измерили три распространённых способа.
Заранее заданные критерии успешного и неуспешного прохождения теста
До теста мы записали три правила:
- Единица сравнения — «данные одной страницы товара». Успешное прохождение: каждый способ позволяет получить не менее 3 реальных страниц товаров (заголовок содержит название товара, а не сообщение о блокировке).
- Мы считаем байты, переданные по сети, а не размер после распаковки, потому что прокси тарифицируют переданный трафик. Для HTML складываем
size_downloadиsize_headerиз curl (curl manual, --write-out; Everything curl: write-out variables). Для браузера складываемNetwork.loadingFinished.encodedDataLengthпо каждому запросу из Chrome DevTools Protocol (CDP Network domain). - Принимаем, что 1 ГБ = 10⁹ байт (NIST prefixes for binary multiples). Если провайдер считает 1 ГБ равным 2³⁰ байт, все приведённые ниже значения стоимости будут примерно на 7% ниже.
Итог: все три способа соответствуют правилу 1 (16 HTML-страниц и по 3 страницы для каждого из двух браузерных способов). Проверка по правилам 2 и 3 приведена ниже.
Тест 1: объём данных для каждого способа
Мы тестировали с домашнего широкополосного подключения в Сингапуре, без прокси. Товары взяты из одного поиска: API поиска Amazon по ключевым словам по запросу air fryer, первые 20 ASIN (18:30, 31,6 секунды, списано $0,001389).
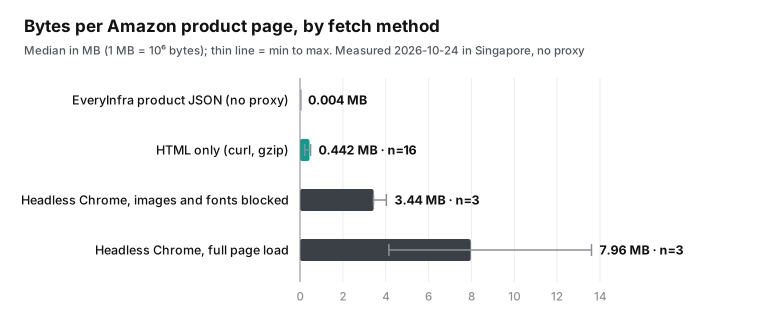
Только HTML. Мы дважды запросили по 20 адресов /dp/<ASIN> через curl с обычными браузерными заголовками и Accept-Encoding: gzip, deflate, br (MDN: Accept-Encoding), выдерживая между запросами интервал в 4 секунды. Amazon отдавал gzip (RFC 1952), а не Brotli (RFC 7932). Для 16 реальных страниц товаров медианный объём переданных данных составил 441 688 байт, минимальный — 213 178 байт, максимальный — 496 482 байта. В распакованном виде страницы занимали от 1,08 до 2,68 МБ.
Headless-браузер, полная загрузка. Мы открыли 3 страницы товаров в новом headless-режиме Chrome (Chrome headless docs) с отключённым кешем и ждали по 15 секунд на страницу. Три страницы заняли 13,60 МБ, 4,15 МБ и 7,96 МБ, на каждую пришлось от 224 до 270 запросов. На первой странице изображения заняли 7,03 МБ (52%), скрипты 3,02 МБ. В DevTools «transferred size» и «resource size» — разные величины; мы используем первую (Chrome DevTools network reference).
Headless-браузер с блокировкой изображений и шрифтов. Во многих скриптах блокируют загрузку изображений. Как это сделать, описано и в Playwright, и в Puppeteer (Playwright: Network; Puppeteer: request interception). При блокировке изображений и шрифтов через CDP Network.setBlockedURLs три страницы заняли 4,03 МБ, 3,44 МБ и 3,43 МБ. Большую часть остального объёма составили скрипты: около 3,0 МБ, или 87%.
| Метод | Выборка | Медианный объём переданных данных на страницу | Диапазон |
|---|---|---|---|
| Только HTML (curl, gzip) | 16 страниц | 0,442 МБ | 0,213–0,496 МБ |
| Headless-браузер Chrome, изображения и шрифты заблокированы | 3 страницы | 3,44 МБ | 3,43–4,03 МБ |
| Headless-браузер Chrome, полная загрузка страницы | 3 страницы | 7,96 МБ | 4,15–13,60 МБ |
| JSON с данными о товаре от EveryInfra (без прокси) | 1 вызов | 0,004 МБ | — |
В двух браузерных строках всего по 3 страницы. На двух страницах CDP записал основной документ как 0 байт. Поэтому значения в этих двух строках — нижние границы, а не точные величины.
Тест 2: какой магазин вы видите без прокси?
Те же запросы показали ещё одно: содержимое страницы зависит от выходного IP.
- Раунд 1, без cookies: 19 из 20 страниц товаров вернули HTTP 200, но в теле была страница размером 3 781 байт с текстом «Click the button below to continue shopping». Лишь 1 оказалась настоящей страницей товара. Все 3 страницы поиска (
/s?k=) вернули 503. - Раунд 2 начался с посещения главной страницы для получения cookies. Первые 5 ответов всё ещё были промежуточными страницами. Следующие 15 оказались настоящими страницами товаров. Из 40 запросов настоящую страницу вернули 16, то есть 40%.
- На всех 16 настоящих страницах местом доставки был указан Сингапур. На двух из них сообщалось, что товар нельзя доставить в это место.
- В браузере переход по адресу
amazon.com/s?k=air+fryerзавершился на странице с заголовком «Amazon.sg : air fryer» — в сингапурском магазине.
Значит, чтобы увидеть цены, условия доставки и результаты поиска, которые видит покупатель из США, запрос должен идти с американского IP. Для этого и нужны резидентные прокси. На странице решений IPFoxy основными сценариями названы электронная коммерция, сбор данных и проверка рекламы («IPFoxy solutions»). В блоге IPFoxy также есть руководство по сбору данных в электронной коммерции («IPFoxy: e-commerce data collection guide»). Сами страницы блокировки небольшие (4 206 байт вместе с заголовками). Они отнимают запросы и время, но почти не расходуют трафик.
Сколько стоят 1 000 страниц товаров
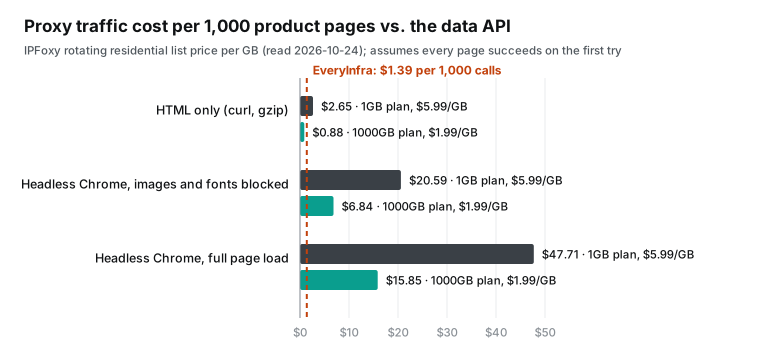
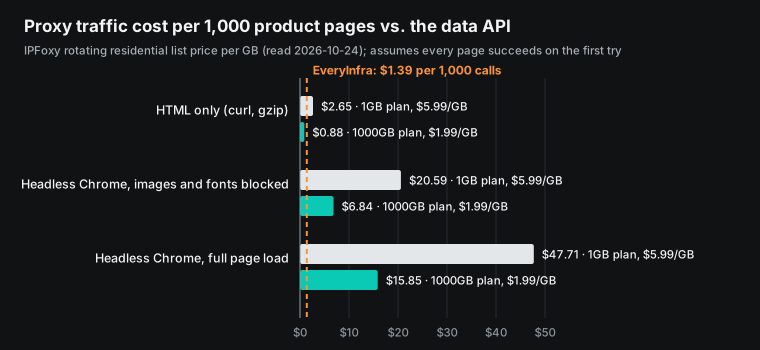
Мы умножаем медианы из теста 1 на 1 000 и на цену IPFoxy за ГБ для каждого тарифа. Предполагаем, что каждая страница загружается с первой попытки. Повторные попытки, установление туннеля к прокси и исходящий трафик не учитываем.
| Метод | Тариф 1 ГБ, $5,99/ГБ | Тариф 10 ГБ, $4,99/ГБ | Тариф 100 ГБ, $2,99/ГБ | Тариф 1000 ГБ, $1,99/ГБ |
|---|---|---|---|---|
| Только HTML | $2.65 | $2.20 | $1.32 | $0.88 |
| Браузер, изображения и шрифты заблокированы | $20.59 | $17.15 | $10.28 | $6.84 |
| Браузер, полная загрузка | $47.71 | $39.74 | $23.81 | $15.85 |
API сведений о товаре Amazon возвращает ту же страницу за $0.001389 за вызов, то есть $1.39 за 1 000 вызовов (каталог возможностей, данные на 18:29). Неудачные и пустые вызовы не оплачиваются. В 18:37 мы один раз вызвали его для B0CYJDVT31. Он вернул 20 полей за 9.1 секунды, размер тела JSON составил 3 569 байт. Если вам нужны только поля из списка (цена, рейтинг, число оценок, бренд), один поисковый вызов возвращает 20 товаров, так что 1 000 товаров обойдутся примерно в $0.07.
Какая доля успешных запросов нужна
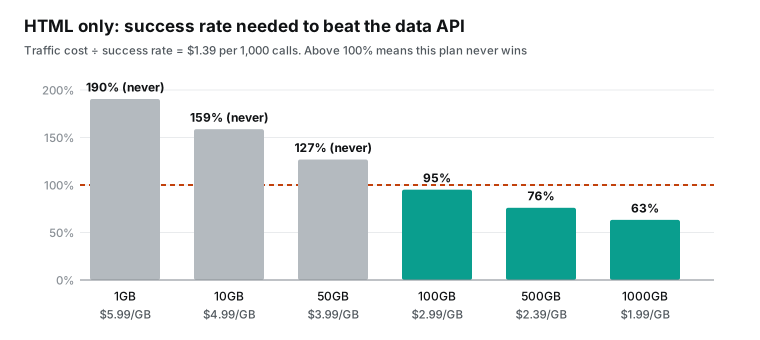
Таблица предполагает 100 % успешных запросов. В реальности запросы завершаются неудачей, и их приходится отправлять повторно. Если доля успешных запросов равна s, стоимость трафика на одну успешно загруженную страницу составляет примерно «стоимость трафика ÷ s» (неудачная загрузка передаёт всего около 4 КБ, поэтому её не учитываем). Чтобы при загрузке только HTML обходиться дешевле, чем API данных, доля успешных запросов должна быть не ниже:
- Тарифы на 1 ГБ, 10 ГБ и 50 ГБ: 190 %, 159 % и 127 %. На этих тарифах дешевле не выйдет никогда.
- Тариф на 100 ГБ: 95 %.
- Тариф на 500 ГБ: 76 %.
- Тариф на 1000 ГБ: 63 %.
Без прокси, при широкополосном подключении из Сингапура, мы получили полноценные страницы в 40 % запросов. При использовании резидентных IP-адресов США доля будет другой. У нас не было аккаунта IPFoxy, поэтому мы её не измеряли и цифру не приводим. Подставьте в формулу выше свою долю успешных запросов.
В этом расчёте не учтены трудозатраты. Когда вы собираете страницы сами, вы пишете парсеры, меняете код при изменении вёрстки, обрабатываете страницы с сообщением о блокировке и выполняете повторные попытки. API данных возвращает фиксированные названия полей, поэтому эта работа отпадает. Но API данных охватывает только платформы и поля из своего каталога. Остальные страницы всё равно приходится собирать самостоятельно.
Для каких задач использовать IPFoxy, а для каких — API данных
Исходя из этих цифр, мы рекомендуем:
- Используйте IPFoxy для страниц, которые нужно открыть как пользователь из определённой страны. Например: условия доставки и итоговая цена для покупателя из США, ваш собственный аккаунт продавца, локальные рекламные размещения. Он также подходит для сайтов, которых нет в каталоге API данных, и для страниц, которым нужен рендеринг в настоящем браузере. Статические резидентные IP-адреса подходят для длительной работы с одним магазином или аккаунтом; цена по прайс-листу начинается с $7,99 в месяц (цены на статические резидентные прокси IPFoxy).
- Используйте API данных для платформ и полей, которые уже есть в каталоге. Он лучше всего подходит для крупных задач с фиксированным набором полей, которые попадают в таблицу или базу данных. Для вызова API данных прокси не нужен. Прокси лишь добавит расход трафика.
Чтобы совместить оба подхода в одном скрипте, см. раздел «Использование с прокси IPFoxy» нашей документации. Пример на Python использует requests 2.34.2 (PyPI: requests). Ваш собственный запрос идёт через прокси. Запрос к EveryInfra идёт напрямую, с trust_env = False (Requests advanced usage: proxies; Requests API: Session.trust_env). Адрес прокси имеет вид username:password@host:port, а в справочном центре IPFoxy есть пример настройки для Python (IPFoxy: rotating proxy with Python). В нём используется стандартная библиотека urllib.request, которая по умолчанию тоже читает переменные окружения для прокси (Python urllib.request docs). В Scrapy задайте proxy в meta запроса (Scrapy: HttpProxyMiddleware).
У нас не было аккаунта IPFoxy, поэтому прокси-часть примера мы проверили на локальном прокси-имитаторе. Он открывает туннель методом HTTP CONNECT (RFC 9110, раздел 9.3.6; MDN: CONNECT) и проверяет данные для Basic-аутентификации в заголовке Proxy-Authorization (RFC 7617; MDN: Proxy-Authorization). С правильным паролем пример через прокси-имитатор обратился к ipinfo.io, а затем получил данные о товаре от EveryInfra. С неправильным паролем прокси-имитатор вернул 407 (MDN: 407), и пример остановился до вызова EveryInfra, поэтому списаний не было. Мы также указали прокси-имитатор в HTTPS_PROXY. В его журнале всё равно был только запрос к ipinfo.io: запрос к EveryInfra через него не шёл.
Как цитировать эти данные
- Исходные данные: amazon-page-weight-2026-10-24.csv (на GitHub: репозиторий примеров EveryInfra, amazon-page-weight-2026-10-24.csv; копия на этом сайте:
https://everyinfra.com/articles/proxy-traffic-cost-amazon-product-pages/amazon-page-weight-2026-10-24.csv), 51 запись. Каждая запись соответствует одному запросу или одной полной загрузке страницы. Столбцы: тип страницы, ASIN, метод, время, HTTP-статус, настоящая страница (да или нет), переданные байты, число запросов и примечание. - Время получения данных: 2026-10-24, 18:30–18:41 по сингапурскому времени (UTC+8). Цены IPFoxy проверены в тот же день.
- Как проверить: HTML — curl 8.7.1 с
--write-out '%{size_download} %{size_header}'; браузер — Chrome 155 в headless-режиме, управляемый через CDP из скрипта на Node.js 26 со встроеннымWebSocket(Node.js global objects). Скрипт проверки и скрипт построения диаграммы лежат в папке с примером на GitHub, ссылка на которую есть в /docs#with-proxy. - Рекомендуемая ссылка: EveryInfra, «Сколько прокси-трафика расходует одна страница Amazon?», 2026-10-24, https://everyinfra.com/ru/blog/proxy-traffic-cost-amazon-product-pages (данные получены 2026-10-24, 18:30–18:41 SGT).
Когда эти результаты неприменимы
- Выборка небольшая: 16 полноценных HTML-страниц и по 3 страницы для каждого браузерного способа, все из одной категории (аэрогрили). Более длинные страницы (больше отзывов, больше вариантов товара) весят больше. Ежемесячный отчёт HTTP Archive показывает, что вес страниц меняется со временем (HTTP Archive: Page Weight report). Повторите измерения через год.
- Прокси при измерениях не использовались: при работе через прокси заголовки, рукопожатие туннеля и редиректы добавляют немного байт, а доля успешных запросов меняется.
- Цены по прайс-листу: на сайте IPFoxy указаны скидки при регистрации (от 17 до 23 % для тарифов от 10 ГБ). Мы их не учитывали. Актуальную цену уточняйте на сайте IPFoxy.
- Вопросы соблюдения требований выходят за рамки статьи: мы измеряли только байты. robots.txt Amazon не закрывает страницы товаров
/dp/для обычных краулеров. Но для ряда поименованных краулеров, например Scrapy и GPTBot, он закрывает весь сайт (Amazon robots.txt). Условия использования Amazon (Conditions of Use, обновлены 2026-08-14) ограничивают интеллектуальный анализ данных и использование роботов в разделе «License and Access» (Amazon Conditions of Use). Прежде чем собирать данные с сайта, ознакомьтесь с его условиями.
Стоимость этого теста: 3 вызова API EveryInfra, всего $0,004167 (1 поиск, 2 запроса данных о товаре). Ещё три запроса вернули 429 из-за лимита запросов для того же API-ключа; плата за них не взималась. IPFoxy — наш партнёр. Ссылки на IPFoxy в этой статье не содержат реферальных параметров. Поэтому мы не помечаем их как реферальные (правила Google для платных и реферальных ссылок: Qualify your outbound links). Наша партнёрская страница: IPFoxy Global Proxy. Цифры приведены по данным двух сайтов на дату обращения.
Что почитать дальше
- Платформа: API для парсинга Amazon
- Возможности: API данных о товаре Amazon, API поиска Amazon по ключевым словам
- Документация: Использование с прокси IPFoxy, Тарифы
Источники
- «Rotating Residential Proxy pricing», IPFoxy, дата обращения 2026-10-24. https://www.ipfoxy.com/pricing/rotating/
- «Static Residential Proxy pricing», IPFoxy, дата обращения 2026-10-24. https://www.ipfoxy.net/pricing/residential/
- «How to use Rotating proxy through Python?», IPFoxy Help Center, 2025-11-18. https://www.ipfoxy.com/help/docs/bn3BDn
- «Solutions», IPFoxy, дата обращения 2026-10-24. https://www.ipfoxy.net/solution/
- «Proxy locations», IPFoxy, дата обращения 2026-10-24. https://www.ipfoxy.net/country/
- «E-commerce data collection guide» (на китайском), блог IPFoxy, дата обращения 2026-10-24. https://www.ipfoxy.net/blog/use-cases/6929
- «Network domain» (loadingFinished, setBlockedURLs), Chrome DevTools Protocol, дата обращения 2026-10-24. https://chromedevtools.github.io/devtools-protocol/tot/Network/
- «Chrome Headless mode», Chrome for Developers, дата обращения 2026-10-24. https://developer.chrome.com/docs/chromium/headless
- «Network features reference», Chrome for Developers, дата обращения 2026-10-24. https://developer.chrome.com/docs/devtools/network/reference
- «curl manual» (--write-out), проект curl, дата обращения 2026-10-24. https://curl.se/docs/manpage.html
- «Write out», Everything curl, дата обращения 2026-10-24. https://everything.curl.dev/usingcurl/verbose/writeout.html
- «Advanced Usage» (Proxies), документация Requests, дата обращения 2026-10-24. https://requests.readthedocs.io/en/latest/user/advanced/
- «Developer Interface» (Session.trust_env), документация Requests, дата обращения 2026-10-24. https://requests.readthedocs.io/en/latest/api/
- Версия requests 2.34.2, PyPI, выпущена 2026-05-14. https://pypi.org/project/requests/
- «urllib.request», документация Python, дата обращения 2026-10-24. https://docs.python.org/3/library/urllib.request.html
- RFC 9110, «HTTP Semantics», IETF, 2022-06. https://www.rfc-editor.org/rfc/rfc9110
- RFC 7617, «The 'Basic' HTTP Authentication Scheme», IETF, 2015-09. https://www.rfc-editor.org/rfc/rfc7617
- RFC 1952, «GZIP file format specification version 4.3», IETF, 1996-05. https://www.rfc-editor.org/rfc/rfc1952
- RFC 7932, «Brotli Compressed Data Format», IETF, 2016-07. https://www.rfc-editor.org/rfc/rfc7932
- «CONNECT request method», MDN, дата обращения 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Methods/CONNECT
- «Proxy-Authorization header», MDN, дата обращения 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Proxy-Authorization
- «407 Proxy Authentication Required», MDN, дата обращения 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/407
- «Accept-Encoding header», MDN, дата обращения 2026-10-24. https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Accept-Encoding
- «Web Almanac 2025: Page Weight», HTTP Archive, 2026-01-15. https://almanac.httparchive.org/en/2025/page-weight
- «Page Weight report», HTTP Archive, дата обращения 2026-10-24. https://httparchive.org/reports/page-weight
- «Network», документация Playwright, дата обращения 2026-10-24. https://playwright.dev/docs/network
- «Request Interception», документация Puppeteer, дата обращения 2026-10-24. https://pptr.dev/guides/network-interception
- «Downloader Middleware» (HttpProxyMiddleware), документация Scrapy, дата обращения 2026-10-24. https://docs.scrapy.org/en/latest/topics/downloader-middleware.html
- «Prefixes for binary multiples», NIST, дата обращения 2026-10-24. https://physics.nist.gov/cuu/Units/binary.html
- robots.txt, Amazon, дата обращения 2026-10-24. https://www.amazon.com/robots.txt
- «Conditions of Use», Amazon, обновлено 2026-08-14. https://www.amazon.com/gp/help/customer/display.html?nodeId=508088
- «Developers», IPinfo, дата обращения 2026-10-24. https://ipinfo.io/developers
- «Global objects» (WebSocket), документация Node.js, дата обращения 2026-10-24. https://nodejs.org/api/globals.html
- Каталог возможностей EveryInfra, GET /api/v1/social/catalog, дата обращения 2026-10-24 18:29. https://api.everyinfra.com/api/v1/social/catalog
- «Qualify your outbound links to Google», Google Search Central, дата обращения 2026-10-24. https://developers.google.com/search/docs/crawling-indexing/qualify-outbound-links
- Исходные данные amazon-page-weight-2026-10-24.csv, репозиторий примеров EveryInfra everyinfra-agent-plugins, 2026-10-24. https://github.com/everyinfra/everyinfra-agent-plugins/blob/main/examples/proxy-plus-data-api/data/amazon-page-weight-2026-10-24.csv
Справка BL-36