# Iterable MCP 接公开社媒数据做受众分组
> Iterable 2026-11-12 发布托管 MCP,在 Claude 里搭营销旅程;同一轮用 everyinfra_* 拉公开评论做受众分组。
- Canonical page: https://everyinfra.com/blog/iterable-mcp
- Published: 2026-11-17T02:05:00+08:00 · Fact-checked: 2026-11-17T01:05:00+08:00
Iterable 在 2026 年 11 月 12 日的 Winter Product Launch 上发布了托管版 MCP 服务器,marketer 可以在 Claude、ChatGPT、Cursor 里直接搭营销旅程、预览邮件、查活动表现([Iterable 产品页](https://iterable.com/product/whats-new/)、[BusinessWire 新闻稿,2026-11-12](https://finance.yahoo.com/technology/ai/articles/iterable-opens-platform-claude-chatgpt-140000056.html))。这台服务器管的是你自己账户里的客户数据,它不拉公开社媒。我们在 2026-11-17 00:19 新加坡时间把 EveryInfra 的 `everyinfra_*` 工具加进同一个客户端,用 `tiktok/search` 一次拿到 10 条冬季护肤视频、扣费 $0.000556,用 `xiaohongshu/search` 一次拿到 20 篇笔记、扣费 $0.005556,把这些公开帖子和评论喂给同一轮对话里的分组和文案;整篇 6 次真调合计扣费 $0.013558。
> **本文要点**
>
> - Iterable 托管 MCP(2026-11-12 发布)在 Claude、ChatGPT、Cursor 里搭旅程,用的是你账户里的客户数据,不拉公开社媒。
> - EveryInfra 是另一台 MCP:`everyinfra_*` 12 个工具,`everyinfra_call_api` 一个工具的定义 1,804 字节,整份 `tools/list` 16,353 字节。
> - 真调价差约 10 倍:`tiktok/search`、`tiktok/comments` 每千次 $0.556,`youtube/search` 每千次 $0.778,`xiaohongshu/search`、`xiaohongshu/comments` 每千次 $5.556。
> - 一次 MCP 往返(2026-11-17 00:24 新加坡时间)拿到 15 条小红书评论,扣费 $0.005556;35 条真实评论里有 14 条能明确归进五个受众组(「干皮/保湿」最多,5 条),其余 21 条是辨真假、泛泛好评和闲聊,不计入分组。
> - `sort` 写错返回 422、带 did_you_mean、没扣费;三语各跑 `article_gate.py` 全过。
在一个聊天窗里一边搭营销旅程、一边拉公开社媒信号,要理清几件事:两台 MCP 怎么分工、`everyinfra_*` 怎么加进 Claude/ChatGPT/Cursor、一次真实往返发了什么回了什么、公开评论怎么变成受众组和文案、每一步多少钱、哪些做不到。Iterable 一侧的功能全部来自官方发布页和新闻稿,写明日期;EveryInfra 一侧的每个数字来自真调的原始返回,能在每次响应的 `billing` 字段里对上。
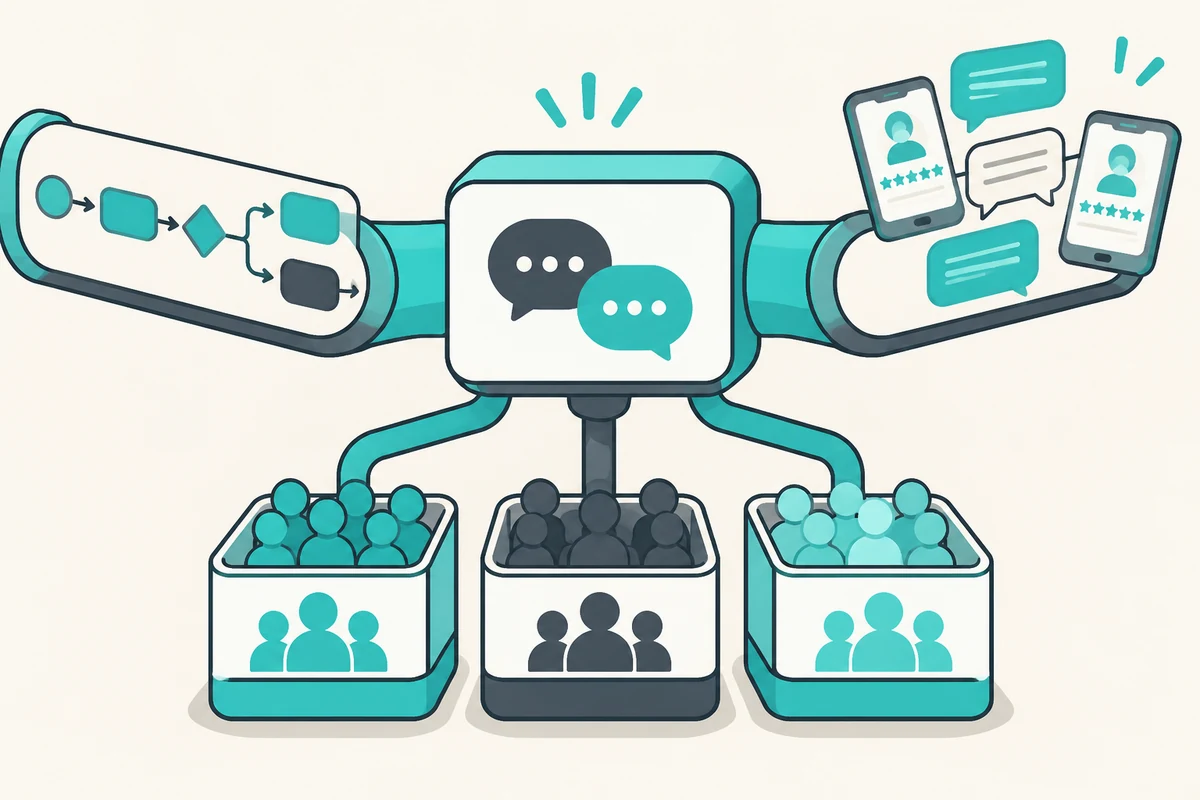
两台 MCP 服务接在同一个聊天窗:一台搭旅程,一台拉公开信号,对话把信号分成受众组。 | source: 本文示意图,不含真实数据
## 两台 MCP 各管一摊:你的客户数据和别人的公开帖子
两台 MCP 的分工,是后面每一步的前提。Iterable 的托管 MCP 连的是你自己 Iterable 账户里的东西:用户档案、名单、模板、旅程、活动表现。它的请求会经过 Iterable 的 Nova Agent,所以你在 Claude 里说「把上周表现最差的几个活动列出来」,它读的是你账户里的真实数据([Iterable 产品页](https://iterable.com/product/whats-new/))。这台服务器不会去抓小红书的笔记或 TikTok 的评论——它看不到你账户以外的公开社媒。
EveryInfra 是另一台 MCP,管的正好是 Iterable 够不着的那一半:公开平台上的帖子、评论、商品、榜单。它暴露 12 个工具,核心是 `everyinfra_call_api`,背后是 106 个平台、574 项数据能力([EveryInfra 目录](https://api.everyinfra.com/api/v1/social/catalog),2026-11-17 读)。这里面既有海外平台,也有小红书、抖音这类中文平台,对做跨境或双市场的品牌尤其有用:同一个护肤诉求,在中文平台和海外平台上的说法、关注点往往不同,两边各搜一轮就能看出差别。做分组时能两个平台对照,就比只盯一个平台分得准。两台服务都讲 Model Context Protocol,都能加进同一个支持 MCP 的客户端,但它们各自用自己的鉴权、各自回自己的数据,谁也不替谁拿数据。把它们放在一个对话里,是因为营销要同时看两样东西:自己名单里的人是谁,和外面的人正在聊什么。
举个会反复用到的场景。一个护肤 DTC 品牌要做冬季唤醒旅程,想按「皮肤诉求」把休眠用户分组,再给每组写不同的开头。自己账户里的购买和打开记录在 Iterable 里,但「用户到底在担心什么」在公开平台上:有人问敏感肌能不能用,有人只问价格和链接。前者用 Iterable MCP 读,后者用 `xiaohongshu/comments` 和 `tiktok/comments` 读,两边在同一轮对话里对上。一个顺手的提示顺序是这样:先让模型用 `everyinfra_call_api` 搜话题、拉评论,归纳出三到五个诉求组;再让它把每组写成一句分组条件和一句邮件开头;最后切到 Iterable 的工具,按这些条件在你账户里建名单、搭旅程草稿。模型在一轮对话里完成从「外面在聊什么」到「我账户里该怎么分、怎么说」的全过程,中间不用你在两个后台之间来回切。
分组标准从哪来,是这套组合要回答的。按打开率、购买次数这些账户内行为分组,分出来的是「活跃/沉默」,不是「在担心什么」。诉求这种东西只在人自己说的话里——公开评论就是最便宜的一手来源。EveryInfra 把这层说的话结构化地取回来,Iterable 把分好的组落到真实名单上,两台服务各做自己擅长的那一半。下面按冬季护肤这个场景一步步做,所有的数都按这次真调算。
按行为分组,你能把用户分成近 30 天打开过和没打开过两堆,但这两堆里都可能既有嫌干又有嫌油的人,给他们发同一封「冬季护肤上新」,打开率不会差太多。按诉求分组,你先从公开评论里知道这个品类的人分成保湿、价格、油痘、成分、敏感五类,再回到账户里,用「上次买过面霜」「加过购物车没付」「买过敏感肌系列」这些已有字段去逼近每一类,发出去的开头就各说各的痛点。做唤醒和挽回,按诉求分的打开和点击通常更好,因为开头那句正好戳中他当初没下单或没回来的原因。公开评论提供的是「想要什么」,账户字段提供的是「这个人符不符合」,两层缺一不可。
这条路也有它的边界:公开评论里的人和你账户里的人不是同一批,所以评论只能告诉你「这个品类的人大概分几类、每类在意什么」,不能直接告诉你「你的张三属于哪类」;判张三属于哪类,还得靠他在你账户里留下的行为。这两件事混为一谈,就会把公开信号错当成名单本身。
## Iterable 2026-11-12 发布了什么:托管 MCP、AI 辅助 SDK、整合中心
Winter Product Launch 分三块,日期都是 2026 年 11 月 12 日。头条是托管 MCP 服务器:来自 Claude、ChatGPT、Cursor 的请求经过 Nova Agent,可以搭旅程、预览邮件、发测试样、查活动表现,旅程画布和邮件预览直接显示在对话里([Iterable 产品页](https://iterable.com/product/whats-new/)、[BusinessWire 新闻稿](https://finance.yahoo.com/technology/ai/articles/iterable-opens-platform-claude-chatgpt-140000056.html))。第二块是 AI 辅助 SDK,给 iOS、Android、React Native 的接入带版本化指引,能在 Claude Code、Cursor、Codex 里把移动端从搭好到发出第一条可核验的消息压到一小时内。第三块是整合中心扩到约三倍,新增 HubSpot、Stripe、Chargebee、Recurly、BigCommerce、TikTok Ads 等接入([2026 发布说明](https://support.iterable.com/hc/en-us/articles/44900665796628-2026-Release-Notes))。
整合中心这一块对「分组」直接相关。新增的接入里,Stripe 和 Recharge 把订阅、扣款、续订带进用户档案,失败扣款可以当场触发挽回旅程;广告侧新增了往 Reddit Ads、Snapchat Ads、Microsoft Advertising、ChatGPT Ads 同步受众,用的是哈希后的邮箱,marketer 可以在旅程里把人加进或移出广告受众([TechEdgeAI 报道,据 Iterable 公告](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/))。换句话说,Iterable 把「账户内事件」接得越来越全,但这些都还是账户内信号;「账户外的人在公开平台上怎么说」仍然要另一台服务去取。Winter 发布还带了一个 AI 邮件摘要预览,发送前先看收件箱的 AI 会把你的邮件概括成什么样,主信息被淹没就改——这也说明一件事:文案好不好,越来越要按「别人怎么读」来判断,而公开评论正是「别人怎么读你这类产品」的现成样本。
第二块 AI 辅助 SDK 虽然和「拉公开数据做分组」不直接相关,但它点出一个对接 MCP 普遍有用的道理。它给 iOS、Android、React Native 的接入带版本化指引,在 Claude Code、Cursor、Codex 里帮开发者把移动端从搭好到发出第一条可核验的消息压到一小时内;Iterable 特意强调,代码能编译通过不等于接入在真机上跑得对,所以这套指引会带着你测到真发出一条消息为止([TechEdgeAI 报道](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/))。同样的判断用在数据侧:接口返回 200 不等于数据对了,所以本文每一步都看 `billing` 和返回字段,而不是只看状态码。Iterable 也说开发者仍要自己审生成的代码、自己做 API Key 生成和应用注册这些敏感步骤——把关的事,AI 工具能加速,不能替你免掉。
发布页上 Iterable 放了一段客户原话值得一提:一个有 4,000 万用户、支持 14 种语言的团队说,过去本地化一个活动要把英文发给译者、再把译文贴回 Iterable,要好几天;用了 Iterable MCP 以后,让 Claude 本地化一个活动,它从 Iterable 拉内容、逐语言本地化、确认术语、再推回去,约两分钟([Iterable 产品页](https://iterable.com/product/whats-new/))。这类活是 Iterable MCP 擅长的——它在你自己的数据上动。另一半——把外面公开平台的诉求在同一轮里也拉进来——就要靠 EveryInfra 这台。
托管版和自托管版是两回事,这一点影响你怎么配 EveryInfra。Iterable 在 2025-11-19 先发过一个开源的自托管 MCP,跑在你自己机器上,用一把个人 API Key,直接调 Iterable 的 API([Iterable/mcp-server README](https://github.com/Iterable/mcp-server/blob/main/README.md))。托管版由 Iterable 运营,从每个客户端的连接器目录里安装,每个人用自己的 Iterable 账号登录(含企业 SSO),agent 只能做这个人权限内的事,没有共享 Key 要管。两个版本都还在:团队用托管版省事,开发者想要直连 API 就留着自托管版。
时间点要分清楚:公告是 2026-11-12,但整套 Winter 发布按 Iterable 社区的说法要到 2026-12-02 才铺到客户账户,托管 MCP 先经客户代表以试用形式开放([TechEdgeAI 报道](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/))。所以这是一次发布加排期,不是每项能力当天就全量可用;本文讲的「加 EveryInfra」那部分,不依赖 Iterable 的托管连接器已经铺到你的目录,自托管版和任何支持 MCP 的客户端都成立。
| 对比项 | Iterable 托管 MCP | Iterable 自托管 MCP |
| --- | --- | --- |
| 登录 | 自己的 Iterable 账号,支持 SSO | 个人 API Key |
| 运行在哪 | Iterable 运营 | 自己机器,从 GitHub 装 |
| 请求经过 | Nova Agent | 直接调 Iterable API |
| 安装方式 | 各客户端连接器目录 | `npx @iterable/mcp` |
| 发布时间 | 2026-11-12 公告 | 2025-11-19 开源 |
自托管版的权限开关写得很明白,这对营销账户很要紧:默认只读,不开个人敏感信息(PII)、不写、不发;要写和发得在安装时加 `--advanced` 单独打开,README 里直接提醒开了写和发就能对真实用户发消息、能删数据,要自己审每一步([Iterable/mcp-server README 权限一节](https://github.com/Iterable/mcp-server/blob/main/README.md))。EveryInfra 这台只读公开数据,不碰你的用户,也就没有这层风险,但预算要你自己控——这是下面算账要讲的。
## 把 everyinfra_* 加进同一个客户端:Claude、ChatGPT、Cursor
EveryInfra 的远程 MCP 地址是 `https://api.everyinfra.com/mcp`,用一把 API Key 做 Bearer 鉴权。它和 Iterable 的连接器互不干扰:你在同一个客户端里同时挂两台,对话里既能叫 Iterable 的工具,也能叫 `everyinfra_*`。三个客户端的加法略有不同,入口都在各自的设置里。
Claude 从 Settings 的 Connectors 进,选 Add custom connector,填名字和服务器地址,再按提示过鉴权([Claude 自定义连接器文档](https://support.claude.com/en/articles/11175166-get-started-with-custom-connectors-using-remote-mcp))。ChatGPT 在设置里打开 developer mode,从 Connectors 里 Add custom MCP server,填名字和地址([OpenAI 帮助中心](https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt))。Cursor 从 Customize 页或配置文件里管 MCP 服务器,文档在 [Cursor MCP 文档](https://cursor.com/docs/mcp)。远程服务器怎么连,Model Context Protocol 官方也有一份通用说明([连接远程 MCP 服务器](https://modelcontextprotocol.io/docs/2026-07-28/develop/connect-remote-servers))。
| 客户端 | 入口 | 加自定义 MCP 的动作 | 文档 |
| --- | --- | --- | --- |
| Claude | Settings → Connectors | Add custom connector,填地址过鉴权 | support.claude.com |
| ChatGPT | 设置 → developer mode → Connectors | Add custom MCP server,填名字和地址 | help.openai.com |
| Cursor | Customize 页或配置文件 | 加 MCP 服务器,填地址 | cursor.com/docs/mcp |
| 读 mcpServers 的客户端 | 配置文件 | 直接写两台服务 | modelcontextprotocol.io |
如果你的客户端读 `mcpServers` 这种 JSON 配置(Claude Desktop、Cursor、很多 MCP 客户端通用),直接写两台服务就行。Key 用环境变量展开,不写进文件:
```text
{
"mcpServers": {
"iterable": {
"command": "npx",
"args": ["-y", "@iterable/mcp"]
},
"everyinfra": {
"type": "http",
"url": "https://api.everyinfra.com/mcp",
"headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
}
}
}
```
在 Claude Code 里,把远程 MCP 加成项目级的一行命令,团队共用一份配置、各放各的 Key:
```bash
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
--scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
```
加完之后对话里会多出 `everyinfra_list_capabilities`、`everyinfra_call_api`、`everyinfra_get_job` 这些工具。两台服务并存时,模型要自己判断什么时候叫哪一台:问「我账户里休眠超过 60 天的用户有多少」走 Iterable,问「冬天干皮这个话题下大家在抱怨什么」走 `everyinfra_call_api`。把这两句话放进同一轮,模型就能先用公开信号定出分组标准,再回头在 Iterable 里按标准建名单。工具多的时候,模型偶尔会选错服务;对只做取数的任务,可以在支持工具白名单的客户端里只给 EveryInfra 留 `everyinfra_call_api` 和 `everyinfra_get_job` 两个工具,既省对话空间,也少一个选错的机会。各客户端对 MCP 工具的权限放行写法不同,Claude Code 的在 [MCP 文档](https://code.claude.com/docs/en/mcp) 和 [权限文档](https://code.claude.com/docs/en/permissions)。
## 一次真实的 MCP 往返:模型发了什么,接口回了什么
先看 MCP 握手。2026-11-17 00:20 新加坡时间,我们对 `https://api.everyinfra.com/mcp` 发 `initialize`,返回 200、协议版本 `2025-06-18`、serverInfo 是 EveryInfra,响应头里没有 `Mcp-Session-Id`,说明这台服务器不要求会话 ID。`initialize` 的返回里还带了一段给模型看的使用说明,大意是:目标不清楚时先问清楚要哪个平台、查什么、要多少条、多新、预算多少、要原始行还是摘要,再推荐一到三项能力。再发 `notifications/initialized` 返回 202、空响应体;再发 `tools/list` 返回 200、12 个工具。这几步符合 MCP 规范里的生命周期和 Streamable HTTP 传输([MCP 生命周期规范](https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle)、[传输规范](https://modelcontextprotocol.io/specification/2025-06-18/basic/transports))。
2026-11-17 00:24 新加坡时间,我们用 `tools/call` 调了一次 `everyinfra_call_api`,参数是一篇小红书笔记的评论、`sort` 取 `most_liked`。这就是一个模型在 Claude 里会发出的那一次调用。返回 200,`content[0].text` 是一段 JSON 字符串,解析出来有 15 条评论,`billing.charged_usd` 是 0.005556。评论里有人问「敏感肌能用吗」,有人说「我是干皮,保湿效果很好」,有人直接问价格和链接——这些就是定分组要用的原话。
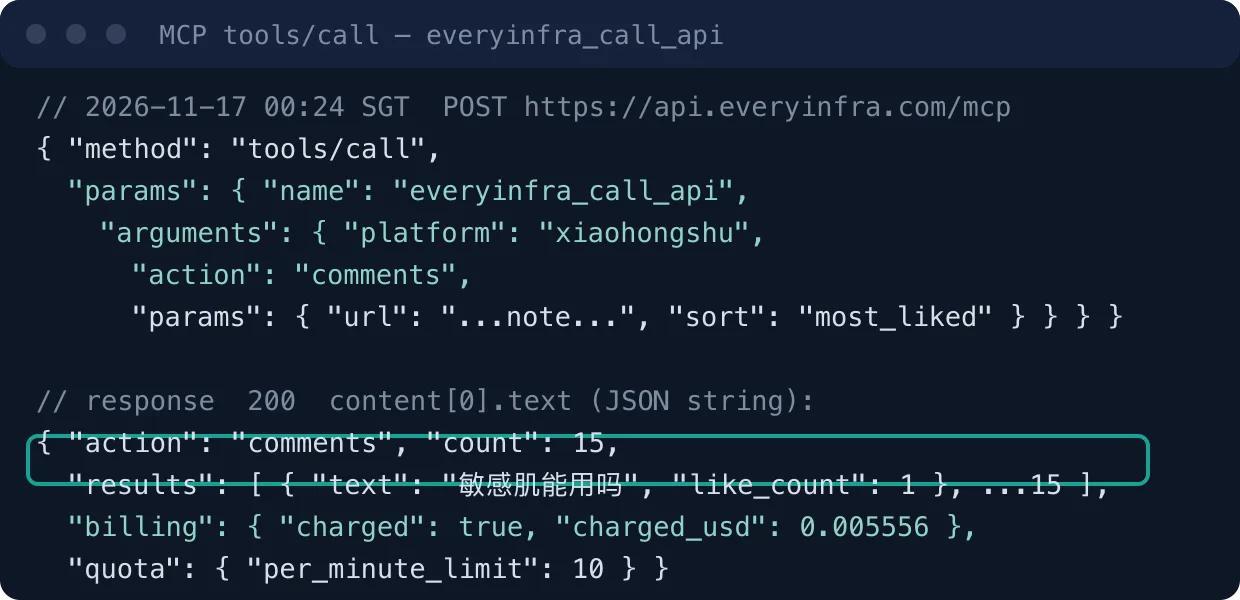
一次 MCP 往返的真实返回,评论正文和用户名已打码、余额字段已删。截于 2026 年 11 月 17 日新加坡时间。 [EveryInfra 接口真实返回,2026-11-17 00:24 SGT](https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu)
这 12 个工具分三类。取数一类:`everyinfra_call_api`(调任意数据能力)、`everyinfra_get_job`(读异步任务)、`everyinfra_list_capabilities`(列 106 个平台和能力)、`everyinfra_search`(搜索取源);账户一类:`everyinfra_get_account`(读账户,免费)、`everyinfra_list_requests`(调用记录)、`everyinfra_get_topup_link`(充值链接);还有验证码和工单几个(`everyinfra_solve_captcha`、`everyinfra_list_captcha_types`、`everyinfra_create_ticket`、`everyinfra_get_ticket`)和一个文本补全 `everyinfra_chat`。做受众分组用得上的是头两三个,其余在这件活里用不上,这也是为什么前面建议只给它留 `everyinfra_call_api` 和 `everyinfra_get_job`。工具名 `everyinfra_*` 只增不改,旧名长期可调,写进脚本或提示里不用担心改名。
同一台服务器的工具列表也直接决定了它占多少对话空间。整份 `tools/list` 返回 16,353 字节,按 4 字节约 1 token 估约 4,088 token;单个 `everyinfra_call_api` 的工具定义是 1,804 字节,约 451 token。如果你的客户端支持给某台 MCP 做工具白名单,只留 `everyinfra_call_api` 和 `everyinfra_get_job`,对话里省下的就是另外 10 个工具的说明。下面这张图把几个字节数放在一起看。
小红书 `search` 一次的原始返回有 35,482 字节,如果把每篇笔记压成「标题、点赞、评论、收藏、链接、是否视频」六个字段,只剩 5,245 字节。模型要做的是定分组,不需要每篇笔记的封面图、作者头像这些带签名参数的长链接,所以让对话只收压缩后的摘要,而不是原始返回,能省大部分空间,差约 6.8 倍。做法上,可以让搜索工具一次只取需要的字段,或者让一个取数的子任务先把原始返回压成摘要再交回主对话——Claude Code 的成本文档解释了为什么这件事值得:长会话每次请求都会把整段对话重发一遍,原始数据进了主对话,代价会摊在之后的每一次请求上,不止第一次([Claude Code 成本文档](https://code.claude.com/docs/en/costs))。要精确数 token 而不是按 4 字节估,可以用官方的 token 计数接口,它免费、只受每分钟请求数限制([Token 计数文档](https://platform.claude.com/docs/en/build-with-claude/token-counting))。
## 为什么走 MCP,而不是各自写脚本
有人会问:拉公开评论、调 Iterable API,各写一个脚本不也行吗?行,但放进 AI 工具里做营销时,MCP 有两处便宜。一是模型自己决定调哪个、填什么参数。你在 Claude 里说一句「看看冬天干皮这个话题下大家在抱怨什么、顺手把我账户里买过面霜但两个月没打开的人拉出来」,模型会分别叫 `everyinfra_call_api` 和 Iterable 的工具,自己拆成几步,中间参数错了还能按 422 的 `did_you_mean` 改——这是脚本给不了的灵活。二是两台服务用同一套协议挂在同一个客户端里,鉴权、工具发现、调用格式都走 MCP 规范,换个客户端(Claude 换成 Cursor)配置几乎一样,不用为每个工具各写一遍胶水。2026-11-14 核对 Cursor、Claude、ChatGPT 三家的接法,入口不同,但加的都是「一个服务器地址加一把 Key」这件事。
当然,MCP 不是什么都比脚本强。要跑固定的大批量、要精确控制并发和重试、要把结果落进自己的数据库,写脚本直调 REST 更顺手——这时候 `everyinfra_call_api` 背后的 `POST /api/v1/social` 和 MCP 是同一套能力、同一套计费,脚本和对话可以混着用:对话里探路、定方案,脚本里跑量。Iterable 自己也是两条路都留:托管 MCP 给 marketer 在对话里用,开源自托管版和直接的 API 给开发者([Iterable/mcp-server README](https://github.com/Iterable/mcp-server/blob/main/README.md))。
## 对话里一步步长什么样
把这件活放进一轮对话,大致是这样几步,每一步对应一次真实调用。marketer 打一句:「我做护肤,想按冬季诉求把休眠用户分组。先看看『冬天干皮护肤』这个话题下大家在聊什么、抱怨什么,归成几类,再给每类写一句挽回邮件的开头。」模型先叫 `everyinfra_call_api` 搜 `xiaohongshu/search`,拿回 20 篇笔记,发现第二篇虽然不是点赞最高,但有 2,121 条评论,于是选它去拉评论;再叫一次 `xiaohongshu/comments`,拿回 15 条,看到「敏感肌能用吗」「我是干皮,保湿效果很好」「求链接多少钱」这些原话。为了不只听小红书一个平台,它再叫 `tiktok/search` 和 `tiktok/comments` 搜「winter skincare routine」、拉播放最高那条视频的 20 条评论,两边凑够 35 条。
接着模型把这 35 条里能明确归类的 14 条分成五类,报给 marketer:干皮保湿 5 条、价格 4 条、油痘 2 条、成分 2 条、敏感 1 条,每类附一两句代表原话;剩下 21 条不进分组——有辨真假的(「是不是伪澳货各位」)、泛泛好评的(「真的超级好用」)、问促销闲聊的(「薇娅直播间 238 送好多赠品」),这些对定诉求没帮助,诚实地留在组外、不硬塞。marketer 点头后说「按这五类各写一句开头,分组条件用我账户里能判的字段」,模型就把每类翻成一条分段条件加一句文案(就是后面那张表)。最后 marketer 说「切到 Iterable,把挽回旅程的第一封,按『干皮保湿』这组改一版,先存草稿别发」,模型改叫 Iterable 的工具去建分段、改模板、停在发送前。整件事没离开过聊天窗,中间 `sort` 写错过一次,模型读了 422 的 `did_you_mean` 自己改了重发。
这段演示里 EveryInfra 一侧的四次调用都是真调,归类的条数、原话都来自真实返回;Iterable 一侧的动作按官方发布页描述写,本机没有接 Iterable 账户去实跑,所以那几步是配置示例,不是实测。
## 用公开信号定受众分组:三次真调,从帖子到评论
分组从一次关键词搜索起步。2026-11-17 00:19 新加坡时间,`xiaohongshu/search` 搜「冬天干皮护肤」、`sort` 取 `most_liked`,一次返回 20 篇笔记、扣费 $0.005556。前六篇按点赞排,第一篇 39,904 赞、32,944 收藏、628 评论,第二篇 22,568 赞但有 2,121 评论。点赞高的未必评论多,这两个数要分开看:点赞高说明内容被认可,评论多说明有人在底下追问,追问里才有分组线索。所以第二步要盯的是评论最多那篇,点赞最高那篇未必追问多。同一分钟,`tiktok/search` 搜「winter skincare routine」、`content_type` 取 `video`,返回 10 条视频、扣费 $0.000556,最高一条 755,800 播放、692 评论。
定分组靠的是评论。2026-11-17 00:24 新加坡时间,`xiaohongshu/comments` 拉了评论最多那篇笔记的评论,返回 15 条;2026-11-17 00:26 新加坡时间,`tiktok/comments` 拉了播放最高那条视频的评论,返回 20 条、扣费 $0.000556。把这 35 条评论按关键词过一遍,有 14 条能明确归进五个受众诉求组:问干皮和保湿的 5 条、问去哪买和价格的 4 条、问油痘的 2 条、问成分和功效的 2 条、问敏感和屏障的 1 条;剩下 21 条是辨真假、泛泛好评或与护肤诉求无关的闲聊,不计入分组。分母是 35、落进五类的是 14,这两个数要分开写,不能把 21 条无关评论硬算进五组里凑数。样本只有 35 条、来自两篇内容,不能当市场占比,但足以说明一件事:同一个「冬季护肤」话题下,至少分得出「保湿诉求」和「价格敏感」两类人,对应到旅程里就是两个开头——给前者讲补水,给后者讲活动价。
两个平台一起看,还能对出内容和人群的差别。小红书「冬天干皮护肤」前几篇是明确的护肤干货,评论里追问成分、敏感肌、价格,偏「研究型」;TikTok「winter skincare routine」最高一条 755,800 播放、692 评论,评论里更多是「这个在哪买」「你同时用这两款吗」,偏「跟买型」。同一诉求在两个平台的说法不一样,给中文市场和英文市场的旅程开头也就该不一样——这正是为什么前面强调别拿一个市场的诉求去套另一个市场。两个平台的搜索价差也值得记一笔:`tiktok/search` 一次 $0.000556,`xiaohongshu/search` 一次 $0.005556,差约 10 倍,所以先在便宜的平台上多搜几轮探路、再到贵的平台上精拉,是省钱的顺序。
这三次调用的返回字段都和目录里的 `response_fields` 对得上。`xiaohongshu/search` 返回 `title`、`like_count`、`comment_count`、`collect_count`、`author_is_verified`、`is_video` 等;`xiaohongshu/comments` 返回 `text`、`like_count`、`ip_location`、`sub_comment_count` 等;`tiktok/comments` 返回 `text`、`like_count`、`reply_count`、`is_reply` 等。能力页在 [xiaohongshu/search](/xiaohongshu-api/search)、[xiaohongshu/comments](/xiaohongshu-api/comments)、[tiktok/search](/tiktok-api/search)、[tiktok/comments](/tiktok-api/comments),平台总览在 [小红书数据接口](/xiaohongshu-api)、[TikTok 数据接口](/tiktok-api)。要更系统地从搜索到笔记再到评论走一遍,可参考 [小红书数据采集:搜索、笔记、评论](/blog/xiaohongshu-data-collection-search-notes-comments)。
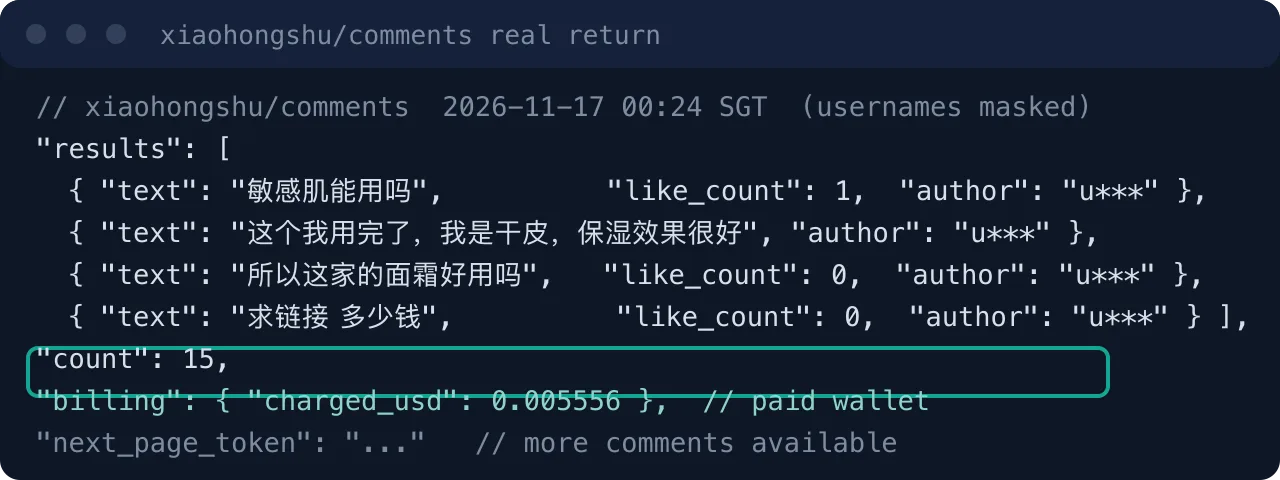
小红书评论的真实返回,用户名已打码。这些原话就是定受众组的依据。截于 2026 年 11 月 17 日 00:24 新加坡时间。 [EveryInfra 接口真实返回,2026-11-17 00:24 SGT](https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu)
| 真调 | 时间(SGT) | 能力 | 参数 | 返回 | 扣费 |
| --- | --- | --- | --- | --- | --- |
| 1 | 00:19 | `tiktok/search` | keyword=winter skincare routine, content_type=video | 10 条视频 | $0.000556 |
| 2 | 00:19 | `xiaohongshu/search` | keyword=冬天干皮护肤, sort=most_liked | 20 篇笔记 | $0.005556 |
| 3 | 00:24 | `xiaohongshu/comments` | url=一篇笔记, sort=most_liked(经 MCP tools/call) | 15 条评论 | $0.005556 |
| 4 | 00:26 | `tiktok/comments` | url=播放最高视频 | 20 条评论 | $0.000556 |
| 5 | 00:21 | `youtube/search` | keyword=iterable mcp server | 10 条视频 | $0.000778 |
| 6 | 00:21 | `youtube/transcript` | url=Iterable 官方视频 | 字幕(正片只有音乐) | $0.000556 |
## 翻页和异步:把一篇笔记的评论拉全
上面 `xiaohongshu/comments` 一次只返回了 15 条,是因为它一次只给一页。返回里有 `next_page_token`,把它放进下一次请求的 `page_token`,就能接着往下拉;评论多的那篇笔记有 2,121 条评论,要拉全得翻很多页,每翻一页算一次调用,按 $0.005556 一次累加,所以拉全一篇热门笔记的评论不便宜,这也是上面建议「先挑评论最多的少数几篇、别对每篇都拉全」的原因。2026-11-16 读目录时确认,`xiaohongshu/comments` 的可选参数是 `page_token` 和 `sort`,`sort` 支持 `most_liked`、`most_commented`、`newest` 等五个值,和 422 返回里列的允许值一致。
要一次拉很多、又不想卡在同步请求的 85 秒预算里,就用异步。任何能力都能异步跑:`POST /api/v1/social` 的 body 里加 `{"mode":"async"}`,立刻返回 202 和 `job_id`,再用 `everyinfra_get_job`(REST 是 `GET /api/v1/jobs/{job_id}`)轮询,读任务不另外计费。在对话里,这意味着模型可以先把一批慢任务都提交出去,拿到一串 `job_id`,再回头一个个读结果,不必干等某一次评论返回。下面是翻第二页的 REST 写法,Key 只从环境变量读:
```bash
curl -s https://api.everyinfra.com/api/v1/social \
-H "Authorization: Bearer $EVERYINFRA_API_KEY" \
-H "Content-Type: application/json" \
-d '{"platform":"xiaohongshu","action":"comments","params":{"url":"...note...","page_token":"...","sort":"most_liked"}}'
```
## 把评论写成分组标准和开头文案
拉回来的评论要变成 Iterable 里用得上的东西,中间有一步翻译:把一句原话翻成一条分组条件加一句开头。下面这张表是按本次 35 条评论里归出的 14 条诉求做的,分组条件写成 Iterable 分段里能落地的样子(按账户内已有字段判,比如上次购买品类、是否点过活动页),开头文案按诉求的语气写。表里的组和上一节图里的五个组一一对应。
| 受众组(来自评论) | 本次样本条数 | 分组条件(在 Iterable 里按账户字段落地) | 旅程开头一句 |
| --- | --- | --- | --- |
| 干皮/保湿 | 5 | 买过面霜或水乳、近 60 天未打开 | 「换季脸紧绷?先把补水这步做扎实」 |
| 求链接/价格 | 4 | 加过购物车未付、点过活动页 | 「你看中的那支,这周有活动价」 |
| 油痘 | 2 | 买过清洁或控油品类 | 「冬天也出油?清爽补水两件事一起做」 |
| 成分/功效 | 2 | 浏览过成分页、看过长图文 | 「这支里有什么、解决什么,一次说清」 |
| 敏感/屏障 | 1 | 买过敏感肌系列 | 「屏障受损先别上猛料,温和修护两周看」 |
翻译这一步接口帮不上,得人来判断。一句「敏感肌能用吗」背后,是一群对刺激性敏感、不敢乱试新品的人,对应的开头要降低尝试门槛(温和、修护、小样);一句「求链接多少钱」背后,是已经动心但卡在价格或购买路径上的人,对应的开头要给确定性(活动价、现货、直达链接)。同样一条评论,放错组就会把挽回邮件写反——给价格敏感的人讲成分科普,给敏感肌的人直接甩活动价,都不会有好的打开。所以归类不只是数关键词,还要读懂这句话的人当初卡在哪一步,这也是为什么这一步要人点头、而不是让模型一键落地。
这一步有两个要点。第一,公开评论定的是「分什么组、每组说什么」,落地到名单用的仍是你账户里的字段——你不可能也不应该拿公开用户去充自己的名单,两边不是同一批人。第二,样本要诚实。本次只有 35 条,上表的开头文案是按这 35 条的语气写的示例,不是经过投放验证的最优文案;要把它当稳的分组依据,得把关键词铺开、拉几十上百篇评论,再看各组的比例稳不稳。做法和成本在下面「算账」一节;要看一个多账号、把原始数据留在子任务、只把摘要交回主对话的完整做法,可参考 [Claude Code 子代理并行拉品牌号](/blog/claude-code-subagents-tiktok-accounts)。
## 把一次分组调研做成每周自动盯一次
单次调研讲完,值得多想一层:分组标准不是定一次就不变的。换季、上新、竞品搞活动,这个品类的人在意什么会漂。一个稳妥的做法是把上面这套固定成每周一次的小任务:每周一早上,对你盯的几个关键词各搜一次、挑评论最多的两三篇各拉一次评论,把结果归并成五类诉求的条数,和上周比一比——哪一类涨了,就知道该调哪组的开头。这件事的花费小到可以一直开着,具体数在下面算账一节。
这件事和旅程本身可以分开跑:诉求调研用 EveryInfra 这台,产出一张「这周各诉求组的条数和几句代表原话」的小表;旅程调整用 Iterable 托管 MCP,marketer 拿着这张小表,在 Claude 里说「把挽回旅程第一步的开头,按这周涨得最多的那组诉求改一版,先存草稿」。2026-11-11 前后多家媒体都在讲同一件事:营销 AI 正从「个人用得顺手」往「团队和 agent 共用同一套数据和权限」走([MarTechCube 报道](https://www.martechcube.com/iterable-launches-hosted-mcp-server-for-claude-chatgpt-and-cursor/))。把公开信号调研做成一张每周都在更新的小表,正是让「外面在聊什么」这件事从某个人的手艺,变成全组都能拿来调旅程的共用输入。
要把这套做成无人值守的定时任务,还得解决几件工程上的事:评论要去重(同一条评论翻页时可能重复出现,按 `id` 去重)、归并关键词要随品类调(护肤的「屏障」「刷酸」换成别的品类就是别的词)、每周的数要落进一张能对比的表而不是只看当周。这些不在本文范围,但都能照 [远程 MCP 接入](/build/remote-mcp-setup) 和能力页里的字段说明接着做。
## 字段里还能分出什么:不止诉求
诉求是最直接的一层,但返回字段里还有几样能帮你把分组做细。`xiaohongshu/comments` 带 `ip_location`,是评论者的归属地——冬季护肤这件事,北方和南方的痛点不一样,北方干冷、南方湿冷,如果同一诉求下地域集中,就能顺手分出地域版的开头。本次 15 条评论的 `ip_location` 全为空,说明这个字段不是每条都有,不能当必然有的维度,但有的时候是白得的分组线索。`author_is_verified` 能把品牌号和素人分开:定诉求时要听素人的原话,品牌号底下的评论常是自家互动,参考价值低。`sub_comment_count` 大的评论,往往是戳中大家的那条,顺着它的回复往下拉(`xiaohongshu/sub_comments`,要评论 `id`)能看到一串同类追问,比平铺的顶层评论更密。
笔记一侧的字段同样有用。`xiaohongshu/search` 的 `is_video` 区分图文和视频:想抄内容形式就看哪种点赞收藏更高,本次前六篇里两篇图文、四篇视频,第一篇图文 32,944 收藏远高于它的 628 评论,说明它是被当工具贴收藏的干货,这类内容底下的评论更可能是「求链接」而不是「求科普」。`collect_count` 和 `comment_count` 的比值也能看出内容性质:收藏远大于评论的是「存着照做」,评论远大于收藏的是「在底下吵」,后者的评论区分组线索更多。把这些字段和诉求叠起来,就能从「五类诉求」细化到「北方干皮、存着照做的那群人」这种更具体的组——前提仍是样本够大,不是本次 35 条能支撑的。
## 报错会自愈:422 带 did_you_mean,不扣费
第一次搜小红书时我们把 `sort` 写成了 `popularity`,接口返回 422,`code` 是 `invalid_value`,`message` 把允许的五个值列全(`most_collected`、`most_commented`、`most_liked`、`newest`、`relevance`),`did_you_mean` 直接给了 `most_liked`,`next_steps` 写着「只改 `sort`、其余不动,重发即可,没有扣费」。这条返回是写给模型看的:它不只说参数错,还给了能直接用的下一步,Claude 这类客户端照着改一个值就能自愈。我们改成 `most_liked` 重发,立刻返回 200、拿到 20 条。对一个在对话里跑的 agent,这一点很要紧:它不会因为一个参数名写错就卡住或乱花钱,而是读 `did_you_mean` 改一次就继续。
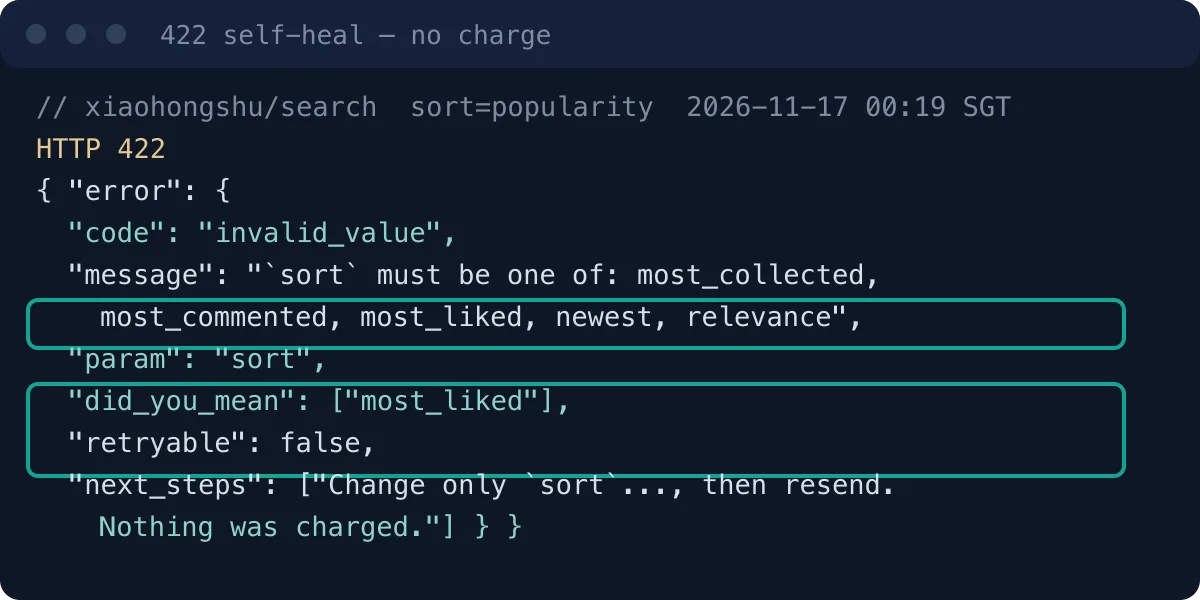
参数写错时的真实返回,带 did_you_mean 和「没有扣费」。截于 2026 年 11 月 17 日 00:19 新加坡时间。 [EveryInfra 接口真实返回,2026-11-17 00:19 SGT](https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu)
限速是另一种要处理的返回。这把测试 Key 被单独限到每分钟 10 次请求,多个客户端共用,我们在 2026-11-17 00:20 新加坡时间碰到一次 429,`message` 写明每分钟 10 次、几秒后重试。429 和 422、401 一样都发生在扣费之前,可以放心重试;等够秒数再发,不要并发猛打。HTTP 规范对 429 的定义是客户端在给定时间内发了太多请求,响应可以带 Retry-After 告诉等多久([RFC 6585](https://www.rfc-editor.org/rfc/rfc6585)、[RFC 9110](https://www.rfc-editor.org/rfc/rfc9110))。接入说明在 [远程 MCP 接入](/build/remote-mcp-setup),REST 的三步在 [快速上手](/docs#quickstart)。
## 算一笔账:按调用次数算,和模型无关
EveryInfra 这一侧的钱只和调用次数有关,和返回多少行、跑在哪个模型上都无关。价差主要在平台:TikTok 和 YouTube 的能力便宜,小红书贵约 10 倍。下面这张图是几项能力的每千次美元价。
| 规模 | 组成 | 调用次数 | 费用 |
| --- | --- | --- | --- |
| 一次分组调研(本文) | 2 次搜索 + 2 次评论 + YouTube 缺口核查 2 次 | 6 | $0.013558 |
| 一个话题,每周一次,一个月 | 每次 6 次调用 | 约 24 | 约 $0.054 |
| 10 个话题,每周一次,一个月 | 每次 6 次调用 | 约 240 | 约 $0.543 |
| 100 篇笔记逐篇拉评论(小红书) | 100 次 `xiaohongshu/comments` | 100 | $0.5556 |
这张表假设你只拉需要的那几条。想省钱有两个办法:一是先用一次搜索挑出评论最多的少数几篇,再逐篇拉评论,而不是对搜到的每一篇都拉;二是把慢任务或大 `limit` 改成异步,`POST` 里加 `{"mode":"async"}` 拿 `job_id`,再用 `everyinfra_get_job` 读,读任务不另外计费。拿冬季护肤这个话题算,如果每周只盯一个关键词、每次先搜一次再拉评论最多的三篇,一次就是 1 次搜索加 3 次评论共约 $0.022,一个月四次不到 $0.09;要同时盯十个品类,一个月也就半美元上下。Iterable 托管 MCP 一侧没有单独公布价格,按你现有的 Iterable 套餐和每个人的权限走,自托管版免费([TechEdgeAI 报道,据 Iterable 公告](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/)),具体以你的 Iterable 客户团队为准。我们自己这把 Key 本文合计只花了 $0.013558,价格明细能在每次返回的 `billing` 里对上,详见 [市场目录](/market) 和 [价格页](/pricing)。
## 边界:这套组合拿不到什么
这套组合有几处拿不到的东西,上手前先摆明。第一,样本小。本文 35 条评论来自两篇内容,只能说明「分得出组」,不能说明每组占多大比例;要估比例得按关键词铺开拉几十上百篇,成本按上面那张表翻倍。第二,字段有上限。`xiaohongshu/comments` 一次返回一页,带 `next_page_token`,要更多评论得翻页,每翻一页算一次调用;小红书评论不保证完整的回复树。第三,公开数据是公开数据,不等于你账户里的人。EveryInfra 拉到的是平台上任何人的公开帖子,Iterable 管的是你自己的用户,两边不是同一批人,不能直接合并,只能用公开信号去指导分组标准,再回 Iterable 按标准建名单。第四,YouTube 这条线这次没补到料:缺口核查里只有一个相关视频,是 Iterable 官方 2025-11-19 发的 MCP 宣传片,正片只有音乐,没有可写的演示步骤。
还有一处 Iterable 侧的边界值得记住。自托管 MCP 开了「发」的权限后,建一个 blast 活动就会按 Iterable API 的行为直接排期发送,没有「草稿活动」这一说;只想拟内容就别开发信权限、改用模板([Iterable/mcp-server README](https://github.com/Iterable/mcp-server/blob/main/README.md))。把 EveryInfra 的公开信号喂进去做文案是只读的、安全的那一半;要对用户发消息的那一步,权限和复核都在 Iterable 一侧,要自己把好。一个稳妥的次序是:先让 agent 把旅程搭成草稿、停在发送前,人在 Iterable 的画布里看一遍再上线,头两周当试运行期。
还有两件要提前想清楚的事。一是平台和语种的匹配:小红书上是中文护肤话题,适合给中文市场的旅程定分组;要给英文市场定分组,就该搜 `tiktok/search` 的英文词、拉英文评论,别拿一个市场的诉求去套另一个市场。二是时效:评论是当下的,分组标准会随时间漂,所以这套更适合周期性地跑一遍、每次重新归并,而不是跑一次就当常量写死进旅程。EveryInfra 这边只给公开数据和它的字段,怎么归类、多久跑一次、落到哪些账户字段,都是你这边的判断,接口不替你做。
## 先跑哪三步试一下
想先上手,不必一上来就接 Iterable。可以只拿 EveryInfra 这台跑三步看看值不值:第一步,用 `everyinfra_list_capabilities` 或读 [能力目录](https://api.everyinfra.com/api/v1/social/catalog) 确认你关心的平台和能力名、价格;第二步,对一个你最在意的关键词搜一次、挑评论最多的两三篇各拉一次评论,把评论归成几类诉求,看看分出来的组是否比你现在按行为分的更有话可说;第三步,拿其中一组的几句原话,手动改一版挽回邮件的开头,自己判断这版比原来的泛泛开头是否更可能被打开。这三步一次花不到三美分,不碰你的 Iterable 账户,判完再决定要不要把它接进旅程。如果分出来的组还不如你现在按行为分的有用,那就说明这个品类的公开讨论还不够密,换个关键词或平台再试;如果一眼就看出两三类说法明显不同的人,那就值得接进旅程、按周跑起来。REST 的三步在 [快速上手](/docs#quickstart),各客户端怎么挂 MCP 在 [远程 MCP 接入](/build/remote-mcp-setup)。
## 行业动向
- 2026-11-12,Iterable 发布托管 MCP 服务器、AI 辅助 SDK、整合中心扩三倍([Iterable 产品页](https://iterable.com/product/whats-new/))。对营销团队的意思:AI 工具里直接搭旅程成了团队能力,不再只是个别人的本事。
- 2026-11-12,Iterable 新闻稿写明托管 MCP 用每人自己的 Iterable 账号登录、含 SSO,agent 在各人权限内操作,没有共享 Key([BusinessWire 新闻稿](https://finance.yahoo.com/technology/ai/articles/iterable-opens-platform-claude-chatgpt-140000056.html))。意思是:权限审计比以前更重要,marketer 能做什么,他的 agent 现在也能更快地做。
- 2026-11-13,第三方媒体提醒 Winter 发布有排期,整套能力据 Iterable 社区转述要到 2026-12-02 才铺到账户,托管 MCP 先以试用形式经客户代表开放([TechEdgeAI 报道](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/))。意思是:别把「已发布」当「已能用」,接入前先确认你的账户拿到了。
- 2026-10-20,Iterable 十月发布加了 Stripe、Recharge、TikTok Ads 等接入和分段护栏([2026 发布说明](https://support.iterable.com/hc/en-us/articles/44900665796628-2026-Release-Notes))。意思是:失败扣款、续订这类事件能直接触发旅程,公开信号可以接在这些事件后面补内容。
- 2026-11-07,第三方开始写怎么用中间层把 Iterable 接进 ChatGPT([Truto 博客](https://truto.one/blog/connect-iterable-to-chatgpt-manage-campaigns-and-user-profiles/))。意思是:接法在变多,但鉴权和权限边界仍要逐个核。
- MCP 规范在 2025-06-18 版定义了 Streamable HTTP 传输和生命周期([MCP 规范](https://modelcontextprotocol.io/specification/2025-06-18/basic/transports))。意思是:远程 MCP 的握手是标准的,换平台也一样。
## 常见问题
**Iterable 的 MCP 能直接拉小红书或 TikTok 的公开数据吗?** 不能。Iterable 托管 MCP 连的是你自己 Iterable 账户里的客户数据,不抓账户以外的公开社媒([Iterable 产品页](https://iterable.com/product/whats-new/))。要公开帖子和评论,得另挂一台数据类 MCP,比如 EveryInfra 的 `everyinfra_call_api`。
**同一个客户端里能同时挂 Iterable 和 EveryInfra 两台 MCP 吗?** 能。两台都讲 Model Context Protocol,各自鉴权、各自回数据。在支持 `mcpServers` 配置的客户端里把两台都写上即可,本文「加进同一个客户端」一节给了配置片段。
**everyinfra mcp server 的地址和工具是什么?** 地址是 `https://api.everyinfra.com/mcp`,Bearer 鉴权。`tools/list` 返回 12 个工具,核心是 `everyinfra_call_api`(调任意数据能力)、`everyinfra_get_job`(读异步任务)、`everyinfra_list_capabilities`(列平台和能力),2026-11-17 00:20 新加坡时间实测。
**拉公开评论做受众分组要花多少钱?** 按调用次数算。`tiktok/comments` 每次 $0.000556,`xiaohongshu/comments` 每次 $0.005556(每千次分别 $0.556 和 $5.556)。本文一次分组调研 6 次调用合计 $0.013558,数字在每次返回的 `billing` 里对得上。
**iterable hosted mcp 什么时候能用、要加钱吗?** 公告是 2026-11-12,整套 Winter 发布据 Iterable 社区转述要到 2026-12-02 铺到账户,托管 MCP 先以试用形式经客户代表开放;没单独公布价格,按现有 Iterable 套餐和权限走,自托管版免费([TechEdgeAI 报道](https://techedgeai.com/iterable-adds-hosted-mcp-server-to-scale-marketing-ai/))。
**参数写错了会乱扣费吗?** 不会。参数非法返回 422、带 `did_you_mean` 和允许值、没扣费;超速返回 429、没扣费。我们 2026-11-17 00:19 新加坡时间把 `sort` 写错,返回里明确写「没有扣费」,照提示改一个值重发就成功了。
**一篇笔记的评论拉不全怎么办?** `xiaohongshu/comments` 一次返回一页,带 `next_page_token`,把它放进下一次的 `page_token` 就能接着拉,每页算一次调用;要一次拉很多就加 `{"mode":"async"}` 拿 `job_id`、用 `everyinfra_get_job` 读,读任务不计费。热门笔记评论上千条,拉全成本高,建议只对评论最多的少数几篇拉。
**能直接拿公开用户去充 Iterable 名单吗?** 不能,也不该。EveryInfra 拉到的是平台上任何人的公开帖子,和你 Iterable 账户里的用户不是同一批人。公开信号只用来定「这个品类分几类、每类在意什么」,落到名单仍按你账户里的字段(买过什么、点过什么)去判,两件事不能混。
## 参考资料
1. Iterable,《Explore Iterable's Latest Platform Innovations & Updates》,iterable.com,2026-11-12,
1. Iterable,《What's New at Iterable: Winter Product Launch 2026》,events.iterable.com,2026-11-12,
1. BusinessWire/Yahoo Finance,《Iterable Opens Its Platform to Claude, ChatGPT, and Cursor With a Hosted MCP Server》,2026-11-12,
1. Iterable,《2026 Release Notes》,support.iterable.com,2026-10-20,
1. Iterable,mcp-server README,GitHub,
1. Iterable,mcp-server 仓库,GitHub,
1. Iterable,Recharge 整合说明,support.iterable.com,
1. Iterable,Stripe 整合说明,support.iterable.com,
1. Iterable,TikTok Ads 整合说明,support.iterable.com,
1. Iterable,Salesforce 整合说明,support.iterable.com,
1. Iterable,Segmentation Reference,support.iterable.com,
1. TechEdgeAI,《Iterable Adds MCP Server for AI Marketing Teams》,2026-11-13,
1. MarTechCube,《Iterable Launches Hosted MCP Server for Claude, ChatGPT and Cursor》,2026-11-12,
1. Truto,《Connect Iterable to ChatGPT》,2026-11-07,
1. Anthropic,《Get started with custom connectors using remote MCP》,support.claude.com,
1. Anthropic,Claude Code MCP 文档,code.claude.com,
1. Anthropic,Claude Code 子代理文档,code.claude.com,
1. Anthropic,Claude Code 成本文档,code.claude.com,
1. Anthropic,Claude Code 权限文档,code.claude.com,
1. Anthropic,定价页,platform.claude.com,
1. Anthropic,Token 计数文档,platform.claude.com,
1. OpenAI,《Connecting custom MCP servers in ChatGPT》,help.openai.com,
1. Cursor,Model Context Protocol (MCP) 文档,cursor.com,
1. Cursor,CLI MCP 文档,cursor.com,
1. Model Context Protocol,传输规范 2025-06-18,
1. Model Context Protocol,生命周期规范 2025-06-18,
1. Model Context Protocol,《Connect to remote MCP Servers》,
1. IETF,RFC 6585(Additional HTTP Status Codes,429),
1. IETF,RFC 9110(HTTP Semantics,Retry-After),
1. EveryInfra,数据能力目录,api.everyinfra.com,2026-11-17,
1. EveryInfra,小红书能力目录,api.everyinfra.com,
1. EveryInfra,TikTok 能力目录,api.everyinfra.com,
1. EveryInfra,YouTube 能力目录,api.everyinfra.com,
1. Iterable,《How Iterable's MCP Server Powers Smarter Agentic Marketing》,iterable.com,2026-09-11,
1. Iterable,Winter 2026 Product Launch 博客,iterable.com,2026-11-12,
1. Henry Moses Jr,Winter 2026 Release 帖,LinkedIn,2026-11-13,
1. BusinessWire,《Iterable Launches Model Context Protocol (MCP) Server》,2025-11-19,
1. Composio,Iterable MCP 工具箱,composio.dev,
1. OpenAI Agents SDK,Model context protocol (MCP) 文档,
1. Python 文档,concurrent.futures,docs.python.org,
1. Improvado,Iterable MCP 说明,improvado.io,
1. StackOne,Iterable MCP Server for AI Agents,stackone.com,